 7
Содержание
- Что такое чекпоинтинг
- Архитектура и ключевые компоненты Checkpointing
- Принцип работы под капотом
- Chandy-Lamport и барьеры в Flink
- Супершаги и StateSnapshot в LangGraph
- Checkpoint vs Savepoint
- Как изменился смысл термина от страховки к API памяти агента
- Сценарии использования и отличительные черты
- Чекпоинтер LangGraph на практике
- Заключение
- Референсные ссылки
Checkpointing (чекпоинтинг) это сохранение согласованного снимка состояния системы в определённый момент времени на надёжное хранилище, чтобы после сбоя или паузы работа продолжилась с этой точки, а не с нуля. Термин пришёл из классической отказоустойчивости распределённых систем и до сих пор держит это значение в потоковой обработке данных. Но у него появилась вторая жизнь в оркестрации ИИ-агентов, где чекпоинт стал не только страховкой от падения, но и инструментом для памяти диалога, паузы перед решением человека и отката состояния назад во времени. Ниже механизм разобран на двух системах, Apache Flink для потоковой обработки и LangGraph для агентных графов, чтобы увидеть, как один паттерн решает разные задачи.
Что такое чекпоинтинг
Идея заимствована из классических распределённых систем, где долгоживущий процесс не начинает вычисления заново после каждого сбоя. Чекпоинт делается автоматически и охватывает не отдельную переменную, а согласованное состояние всей системы целиком, включая позицию во входном потоке или в истории выполнения. Это отличает его от простого резервного копирования файла, чекпоинт создаётся системой на лету, во время работы, и восстановление из него возвращает не только данные, но и точку выполнения, с которой всё продолжится.
У обеих систем общий фундамент, но разное назначение снимка. Flink чекпоинтит, чтобы стриминговое приложение пережило падение узла кластера без потери и задвоения событий на выходе. LangGraph чекпоинтит, чтобы граф агента можно было приостановить на неопределённое время и продолжить выполнение с того же места.
Архитектура и ключевые компоненты Checkpointing
Компоненты каждой системы называются по-своему, но роли похожи, ведь обе решают задачу распределённого снимка. У Apache Flink состав такой.
- JobManager. Координирует запуск чекпоинта и хранит его метаданные.
- TaskManager. Выполняет задачи потокового графа и участвует в прохождении барьера чекпоинта.
- Checkpoint Coordinator. Управляет жизненным циклом одного чекпоинта, от запуска до подтверждения.
- State Backend. Хранилище рабочего состояния оператора, JVM-память или встроенный RocksDB; куда физически пишется сам снимок, определяет отдельный параметр checkpoint storage, память JobManager или файловая система.
- Checkpoint Barrier. Служебная запись, которая идёт по графу операторов вместе с обычными данными и не может быть ими обогнана.
Эти пять элементов превращают чекпоинт из разовой команды в управляемый процесс с координатором, хранилищем и механизмом согласования между параллельными операторами.
У LangGraph набор ролей компактнее, потому что граф агента исполняется не распределённо по кластеру, а в одном процессе.
- Checkpointer. Компонент, который сохраняет состояние графа, StateSnapshot, на каждом шаге выполнения.
- Thread (thread_id). Первичный ключ, по которому чекпоинты привязываются к конкретному диалогу или сессии агента.
- StateSnapshot. Сам снимок, значения каналов состояния (values), список узлов к выполнению (next), конфигурация (config) с thread_id и checkpoint_id, метаданные шага (metadata) и незавершённые задачи (tasks).
Без thread_id чекпоинтер не может ни сохранить состояние, ни найти его при возобновлении, поэтому это поле обязательно в конфигурации любого вызова графа.
Принцип работы под капотом
Chandy-Lamport и барьеры в Flink
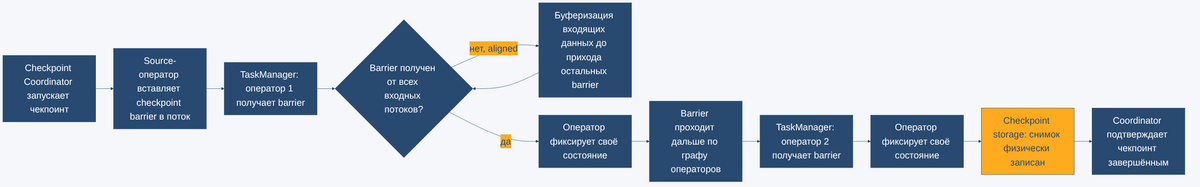
В основе механизма Flink лежит алгоритм распределённых снимков Chandy-Lamport (Чанди-Лампорт), предложенный K. Mani Chandy и Leslie Lamport в 1985 году. Его смысл в том, чтобы получить согласованный снимок состояния распределённой системы, не останавливая обработку целиком, часть операторов продолжает работать с данными, пока другие фиксируют своё состояние. Практически это устроено через checkpoint barrier, служебную запись, которую source-операторы вставляют в обычный поток данных, и которая, как и watermark, не может быть обогнана другими записями.
По умолчанию Flink использует выровненные чекпоинты (aligned checkpoints), оператор дожидается барьера от всех входящих потоков, прежде чем зафиксировать состояние. Невыровненный режим (unaligned checkpoints) разрешает барьеру обгонять буферизованные данные, из-за чего длительность чекпоинта перестаёт зависеть от пропускной способности и заметно падает под бэкпрешером. С этим связана и гарантия консистентности, по умолчанию exactly-once, а для сверхнизкой задержки можно переключиться на at-least-once, с риском повторной обработки части записей.
Официальная документация Apache Flink по чекпоинтингу задаёт и операционные лимиты. Checkpoint Timeout по умолчанию 10 минут, Max Concurrent Checkpoints по умолчанию 1, а Tolerable Checkpoint Failures по умолчанию 0, то есть любая единичная неудача чекпоинта роняет джоб, если явно не разрешить иначе.
Потоковая обработка данных с помощью Apache Flink
Код курса
FLINK
Ближайшая дата курса
29 сентября, 2026
Продолжительность
16 ак.часов
Стоимость обучения
51 200
Супершаги и StateSnapshot в LangGraph
У LangGraph нет распределённого кластера операторов, поэтому алгоритм устроен проще. Выполнение графа делится на супершаги (superstep), один супершаг это единый тик, в рамках которого выполняются все запланированные на этот момент узлы, при необходимости параллельно, и чекпоинтер создаёт снимок на границе каждого такого тика. Дополнительно LangGraph сохраняет результаты отдельных узлов уже внутри супершага, поэтому, если один узел упал, а остальные успели отработать, их результат не теряется при восстановлении.
Насколько надёжно эта запись доходит до диска, определяет параметр durability при вызове графа. У него три режима, exit пишет изменения только при завершении графа, async пишет асинхронно, пока выполняется следующий шаг, это значение по умолчанию, а sync пишет синхронно, до перехода к следующему узлу. Разница между async и sync критична именно при реальном падении процесса, потому что async оставляет короткое окно, в котором последний чекпоинт ещё не долетел до диска.
Checkpoint vs Savepoint
Оба термина в Flink описывают один и тот же механизм под капотом, снимок по алгоритму Chandy-Lamport, но с разным назначением, и путать их на проде дорого. Checkpoint создаётся автоматически по расписанию ради одной цели, восстановления после сбоя. Savepoint пользователь запускает вручную, и он всегда полный, независимо от того, поддерживает ли State Backend инкрементальные снимки. Разница в назначении определяет и типовые сценарии, документация выделяет savepoint для плановых операций, смены параллелизма приложения, переноса на другой кластер или дата-центр и миграции на новую версию Flink.
| Критерий | Checkpoint | Savepoint |
|---|---|---|
| Кто запускает | Flink автоматически, по расписанию | Пользователь вручную, по команде |
| Назначение | Восстановление после сбоя (failover) | Плановые операции, смена параллелизма, миграция на другой кластер или версию Flink |
| Формат снимка | Может быть инкрементальным, зависит от State Backend | Всегда полный |
| Время жизни | Хранится по политике retention, старые снимки удаляются автоматически | Хранится, пока пользователь не удалит вручную |
| Алгоритм под капотом | Chandy-Lamport | Chandy-Lamport |
Разбор назначения, реализации и жизненного цикла обоих механизмов есть в статье блога Savepoint vs Checkpoint в Apache Flink.
Как изменился смысл термина от страховки к API памяти агента
В потоковой обработке чекпоинт остаётся тем, чем был всегда, механизмом восстановления после сбоя, прозрачным для пользователя. В оркестрации агентов смысл сместился заметно дальше. Раз чекпоинтер сохраняет полное состояние графа на каждом супершаге, это состояние можно не только восстанавливать после падения, но и разглядывать, редактировать и перематывать.
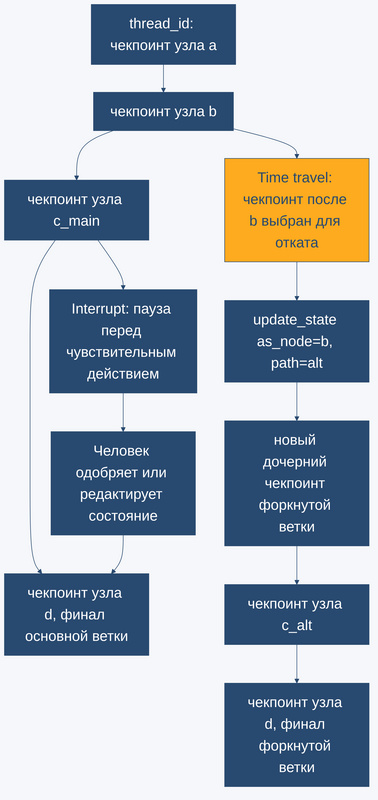
Time travel в LangGraph означает буквально это. Разработчик берёт checkpoint_id из истории треда и запускает выполнение заново от этой точки, с изменённым состоянием. Через update_state создаётся новый дочерний чекпоинт у выбранной точки, не затрагивая исходную цепочку, поэтому у одного thread_id может быть сразу несколько независимых финальных состояний.
Human-in-the-loop работает на том же фундаменте. Interrupt останавливает граф перед чувствительным действием, и, поскольку состояние уже зафиксировано, граф может простоять на паузе часы или дни, а после возобновления продолжит выполнение так, будто прошли миллисекунды. Ни один из этих сценариев не имеет отношения к отказоустойчивости в привычном смысле, но опирается ровно на тот же механизм сохранения снимка.
Сценарии использования и отличительные черты
Область применения каждой реализации подсказывает архитектура, которая под ней стоит.
- Стейтфул потоковая обработка. Агрегации по окну, join нескольких потоков, любое приложение, где промежуточный результат нельзя пересчитать заново за разумное время. Здесь важна автоматика и гарантия exactly-once.
- Операционное обслуживание кластера. Смена параллелизма под новую нагрузку, миграция на другую версию Flink, перенос джоба на другой кластер. Для этого нужен savepoint, а не checkpoint.
- Долгие многошаговые агентные сценарии. Диалоговый ассистент, который должен помнить контекст между сессиями, или агент, работающий над задачей часы и дни с паузами.
- Human-in-the-loop подтверждение. Отправка письма, списание средств, слияние кода, любое действие, где нужна пауза и решение человека перед продолжением.
- Отладка и разбор поведения агента. Time travel позволяет пройти историю решений графа шаг за шагом и понять, где агент свернул не туда.
Общее правило простое, чем дороже потерять прогресс и чем дольше живёт процесс, тем весомее аргумент в пользу чекпоинтинга. Практики эксплуатации агентных сценариев, включая паузы для человека и работу с состоянием в проде, разбираются на курсе «ИИ-агенты для оптимизации бизнес-процессов».
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Чекпоинтер LangGraph на практике
Дальше на реальном прогоне видно, как чекпоинтер ведёт себя за пределами общих слов про time travel и восстановление после сбоя. Весь код статьи выложен на наш GitHub репозиторий.
Первое демо, checkpointing_langgraph_crash_resume.py, аварийно убивает процесс посреди графа и восстанавливает его тем же thread_id. Главный процесс дважды запускает себя вторым процессом, первый запуск падает по-настоящему через os._exit внутри узла, как убитый снаружи процесс, а не пойманное исключение.
# langgraph 1.2.11, langgraph-checkpoint 4.2.0, langgraph-checkpoint-sqlite 3.1.1
# прогнано на стенде 2026-09-03
"""
Демо: аварийное прерывание процесса посередине графа LangGraph и восстановление
по одному и тому же thread_id из SQLite-чекпоинтера.

Идея: главный процесс дважды запускает себя же отдельным процессом (subprocess) в
режиме --worker. Первый запуск падает по-настоящему (os._exit внутри узла графа,
как убитый процесс, а не пойманное исключение). Второй запуск с тем же thread_id
продолжает граф с последнего сохранённого чекпоинта.
"""
import os
import subprocess
import sys
from pathlib import Path
from typing import TypedDict

from langgraph.graph import END, START, StateGraph
from langgraph.checkpoint.sqlite import SqliteSaver

WORKDIR = Path(__file__).resolve().parent
DB_PATH = WORKDIR / "checkpoint_demo.db"
EFFECT_LOG = WORKDIR / "external_effect.log"
THREAD_ID = "checkpointing-demo"


class State(TypedDict):
    steps: list[str]


def build_graph(checkpointer):
    def step1(state: State) -> State:
        return {"steps": state["steps"] + ["step1"]}

    def step2(state: State) -> State:
        return {"steps": state["steps"] + ["step2"]}

    def step3_external_call(state: State) -> State:
        # имитация вызова внешнего сервиса с side effect (например, отправка письма).
        # Пишем в лог ДО того, как узел успеет отдать результат обратно графу.
        # Номер попытки считаем по числу уже записанных строк, а не по состоянию
        # графа: state["steps"] между попытками не меняется (обе попытки читают
        # чекпоинт после step2), а лог должен показать реальное число вызовов.
        attempt_number = 1
        if EFFECT_LOG.exists():
            attempt_number = len(EFFECT_LOG.read_text().splitlines()) + 1
        with open(EFFECT_LOG, "a") as f:
            f.write(f"внешний вызов из step3, попытка №{attempt_number}\n")
        if os.environ.get("CRASH_HERE") == "1":
            # реальное убийство процесса (аналог kill -9), а не Python-исключение:
            # LangGraph не успевает получить возврат узла и зафиксировать чекпоинт
            os._exit(137)
        return {"steps": state["steps"] + ["step3"]}

    def step4(state: State) -> State:
        return {"steps": state["steps"] + ["step4"]}

    graph = StateGraph(State)
    graph.add_node("step1", step1)
    graph.add_node("step2", step2)
    graph.add_node("step3", step3_external_call)
    graph.add_node("step4", step4)
    graph.add_edge(START, "step1")
    graph.add_edge("step1", "step2")
    graph.add_edge("step2", "step3")
    graph.add_edge("step3", "step4")
    graph.add_edge("step4", END)
    return graph.compile(checkpointer=checkpointer)


def run_worker(crash: bool) -> None:
    with SqliteSaver.from_conn_string(str(DB_PATH)) as checkpointer:
        app = build_graph(checkpointer)
        config = {"configurable": {"thread_id": THREAD_ID}}
        if crash:
            os.environ["CRASH_HERE"] = "1"
        state_before = app.get_state(config)
        # пустое состояние треда - первый запуск, иначе - продолжение с чекпоинта
        input_data = {"steps": []} if not state_before.values else None
        # durability="sync" - чекпоинт каждого шага пишется на диск синхронно,
        # до перехода к следующему узлу. Без явного durability действует
        # значение по умолчанию "async": запись уходит в фон, и при таком же
        # os._exit чекпоинт после step2 рискует не успеть долететь до диска.
        app.invoke(input_data, config, durability="sync")
        print("узел step4 отработал, процесс завершается штатно")


if __name__ == "__main__":
    if len(sys.argv) > 1 and sys.argv[1] == "--worker":
        run_worker(crash="--crash" in sys.argv)
        sys.exit(0)

    for path in (DB_PATH, EFFECT_LOG):
        path.unlink(missing_ok=True)

    print("=== Попытка 1: запускаем граф, step3 аварийно убьёт процесс ===")
    # sys.stdout.flush() перед subprocess.run обязателен: при редиректе stdout
    # в файл, а не в терминал, вывод родителя буферизуется блочно, а не
    # построчно. Без явного flush дочерний процесс успевает записать и
    # сбросить свой вывод раньше, чем накопленный буфер родителя, и в
    # run_output.txt строки появляются не в хронологическом порядке.
    sys.stdout.flush()
    result = subprocess.run([sys.executable, __file__, "--worker", "--crash"])
    print(f"процесс упал с кодом {result.returncode} (137 = убит сигналом, не поймано)")

    print("\n=== Что реально сохранилось в чекпоинтере после падения ===")
    with SqliteSaver.from_conn_string(str(DB_PATH)) as checkpointer:
        app = build_graph(checkpointer)
        config = {"configurable": {"thread_id": THREAD_ID}}
        snapshot = app.get_state(config)
        print("сохранённые шаги:", snapshot.values["steps"])
        print("следующий узел к выполнению:", snapshot.next)

    print("\n=== Попытка 2: новый процесс, тот же thread_id ===")
    sys.stdout.flush()
    result = subprocess.run([sys.executable, __file__, "--worker"])
    print(f"процесс завершился кодом {result.returncode}")

    print("\n=== Итоговое состояние после resume ===")
    with SqliteSaver.from_conn_string(str(DB_PATH)) as checkpointer:
        app = build_graph(checkpointer)
        config = {"configurable": {"thread_id": THREAD_ID}}
        snapshot = app.get_state(config)
        print("шаги:", snapshot.values["steps"])

    print("\n=== Лог внешнего эффекта step3 (побочный эффект не под чекпоинтом) ===")
    print(EFFECT_LOG.read_text().rstrip())
Вывод прогона, дословно из run_output.txt.
=== Попытка 1: запускаем граф, step3 аварийно убьёт процесс ===
процесс упал с кодом 137 (137 = убит сигналом, не поймано)

=== Что реально сохранилось в чекпоинтере после падения ===
сохранённые шаги: ['step1', 'step2']
следующий узел к выполнению: ('step3',)

=== Попытка 2: новый процесс, тот же thread_id ===
узел step4 отработал, процесс завершается штатно
процесс завершился кодом 0

=== Итоговое состояние после resume ===
шаги: ['step1', 'step2', 'step3', 'step4']

=== Лог внешнего эффекта step3 (побочный эффект не под чекпоинтом) ===
внешний вызов из step3, попытка №1
внешний вызов из step3, попытка №2
После падения чекпоинтер помнит ровно два выполненных шага, step1 и step2, а следующим к выполнению значится step3, узел, который не успел вернуть результат. После resume с тем же thread_id граф не начал сначала, а доработал step3 и step4. Важная оговорка в логе внешнего эффекта, строк там две, а не одна, узел step3 физически выполнился дважды, хотя итоговое состояние выглядит так, будто сбоя не было. Чекпоинтинг гарантирует консистентное состояние графа, но не идемпотентность побочных эффектов внутри узла. Это и причина, по которой в app.invoke(…) явно указан durability=»sync», иначе при os._exit сразу после step2 есть риск потерять последнюю запись до диска.
Второе демо, checkpointing_langgraph_time_travel.py, строит граф a-b-(c_main или c_alt)-d, где ветвление после узла b зависит от поля path.
# langgraph 1.2.11, langgraph-checkpoint 4.2.0, langgraph-checkpoint-sqlite 3.1.1
# прогнано на стенде 2026-09-03
"""
Демо: time travel в LangGraph - просмотр истории чекпоинтов треда и форк
выполнения от более раннего чекпоинта по настоящей другой ветке графа
(условный переход, а не просто другое значение в том же узле).
"""
from pathlib import Path
from typing import Literal, TypedDict

from langgraph.graph import END, START, StateGraph
from langgraph.checkpoint.sqlite import SqliteSaver

WORKDIR = Path(__file__).resolve().parent
DB_PATH = WORKDIR / "time_travel_demo.db"
THREAD_ID = "time-travel-demo"


class State(TypedDict):
    log: list[str]
    path: Literal["main", "alt"]


def make_node(label: str):
    def node(state: State) -> State:
        return {"log": state["log"] + [label]}

    return node


def route_after_b(state: State) -> str:
    # выбор ветки читает state, записанный в чекпоинт - именно это поле
    # форк будет подменять, чтобы увести выполнение на другую ветку
    return "c_alt" if state["path"] == "alt" else "c_main"


def build_graph(checkpointer):
    graph = StateGraph(State)
    graph.add_node("a", make_node("a"))
    graph.add_node("b", make_node("b"))
    graph.add_node("c_main", make_node("c_main"))
    graph.add_node("c_alt", make_node("c_alt"))
    graph.add_node("d", make_node("d"))
    graph.add_edge(START, "a")
    graph.add_edge("a", "b")
    graph.add_conditional_edges("b", route_after_b, {"c_main": "c_main", "c_alt": "c_alt"})
    graph.add_edge("c_main", "d")
    graph.add_edge("c_alt", "d")
    graph.add_edge("d", END)
    return graph.compile(checkpointer=checkpointer)


if __name__ == "__main__":
    DB_PATH.unlink(missing_ok=True)

    with SqliteSaver.from_conn_string(str(DB_PATH)) as checkpointer:
        app = build_graph(checkpointer)
        config = {"configurable": {"thread_id": THREAD_ID}}

        print("=== Основной прогон: a -> b -> c_main -> d ===")
        final_state = app.invoke({"log": [], "path": "main"}, config)
        print("финальный лог основной ветки:", final_state["log"])
        original_final_checkpoint_id = app.get_state(config).config["configurable"]["checkpoint_id"]

        print("\n=== История чекпоинтов треда, от новых к старым ===")
        history = list(app.get_state_history(config))
        for snap in history:
            cid = snap.config["configurable"]["checkpoint_id"]
            print(f"checkpoint_id={cid[:8]}...  log={snap.values.get('log')}  next={snap.next}")

        # чекпоинт сразу после узла "b", до ветвления на c_main/c_alt
        checkpoint_after_b = next(s for s in history if s.values.get("log") == ["a", "b"])
        cid_after_b = checkpoint_after_b.config["configurable"]["checkpoint_id"]
        print(f"\nвыбран чекпоинт после узла 'b' для отката: {cid_after_b[:8]}...")

        print("\n=== Форк: та же точка отката, другая ветка через смену 'path' ===")
        # update_state с as_node="b" создаёт НОВЫЙ дочерний чекпоинт у checkpoint_after_b
        # и не трогает цепочку основной ветки (c_main, d) - у неё свой checkpoint_id.
        # Условный переход после "b" читает уже новое значение path и уводит на c_alt.
        fork_config = app.update_state(
            checkpoint_after_b.config,
            {"log": checkpoint_after_b.values["log"], "path": "alt"},
            as_node="b",
        )
        forked_state = app.invoke(None, fork_config)
        print("финальный лог форкнутой ветки:", forked_state["log"])

        print("\n=== Исходная ветка осталась доступна по своему checkpoint_id ===")
        original_snapshot = app.get_state(
            {"configurable": {"thread_id": THREAD_ID, "checkpoint_id": original_final_checkpoint_id}}
        )
        print("лог исходного финального чекпоинта:", original_snapshot.values["log"])

        print("\n=== У треда теперь два независимых финальных чекпоинта ===")
        all_ids_short = {snap.config["configurable"]["checkpoint_id"][:8] for snap in app.get_state_history(config)}
        print("исходный конечный checkpoint_id всё ещё в истории:", original_final_checkpoint_id[:8] in all_ids_short)
Ключевые строки run_output.txt, промежуточный вывод истории чекпоинтов между ними опущен.
=== Основной прогон: a -> b -> c_main -> d ===
финальный лог основной ветки: ['a', 'b', 'c_main', 'd']

=== Форк: та же точка отката, другая ветка через смену 'path' ===
финальный лог форкнутой ветки: ['a', 'b', 'c_alt', 'd']

=== Исходная ветка осталась доступна по своему checkpoint_id ===
лог исходного финального чекпоинта: ['a', 'b', 'c_main', 'd']

=== У треда теперь два независимых финальных чекпоинта ===
исходный конечный checkpoint_id всё ещё в истории: True
Форкнутая ветка прошла через c_alt вместо c_main, а запрос состояния по исходному checkpoint_id по-прежнему отдаёт c_main, форк не переписал историю, а добавил новую независимую ветку. Здесь есть неочевидный момент, вызов update_state(…, as_node=»b») сам по себе не переключает ветку, он лишь создаёт дочерний чекпоинт с новым значением поля path у указанного узла. Чтобы форк реально пошёл по другой ветке, в графе должен быть условный переход, который читает это поле, в демо это route_after_b и add_conditional_edges. Без ветвления форк просто выполнил бы тот же узел c_main поверх нового значения.
Заключение
Чекпоинтинг в обеих системах решает одну задачу, сохранить согласованный снимок состояния, чтобы работа продолжилась без потери прогресса. Flink делает это автоматически, обеспечивая exactly-once поверх алгоритма Chandy-Lamport, а savepoint остаётся ручным инструментом для миграции и масштабирования. LangGraph превратил тот же принцип в API, доступный разработчику напрямую, память диалога, time travel и паузу human-in-the-loop даёт один и тот же checkpointer. Демо на прогоне показало и цену этой гибкости, чекпоинт гарантирует консистентное состояние графа, но не идемпотентность побочных эффектов внутри узла, и не переключает ветку выполнения сам по себе без условного перехода в графе.