
 15

Содержание
- Что такое семантический слой
- Архитектура и ключевые компоненты
- Принцип работы семантического слоя
- От модели внутри BI-инструмента к headless-слою
- Ограничения и подводные камни dbt Semantic Layer
- Когда использовать семантический слой, а когда не стоит
- Практика. Локальный запуск MetricFlow поверх Postgres
- Заключение
- Референсные ссылки
Семантический слой (semantic layer) — это набор определений бизнес-метрик, измерений и связей между таблицами, который существует отдельно от конкретного хранилища данных и BI-инструмента. Он превращает сырые таблицы вроде orders и customers в понятные бизнесу сущности, такие как «выручка» или «завершённый заказ», и одно и то же определение метрики работает одинаково в любом инструменте, который к этому слою обращается.
Что такое семантический слой
По классу решений семантический слой относится к слою метаданных поверх аналитического хранилища данных (data warehouse, DWH). Задача, которую он закрывает, звучит просто, а на практике болезненна. Без общего слоя каждая команда, которая считает метрику «выручка», пишет собственный SQL-запрос, и через полгода в компании существуют три версии выручки с разными фильтрами по статусу заказа, разной обработкой возвратов и разным часовым поясом для дат.
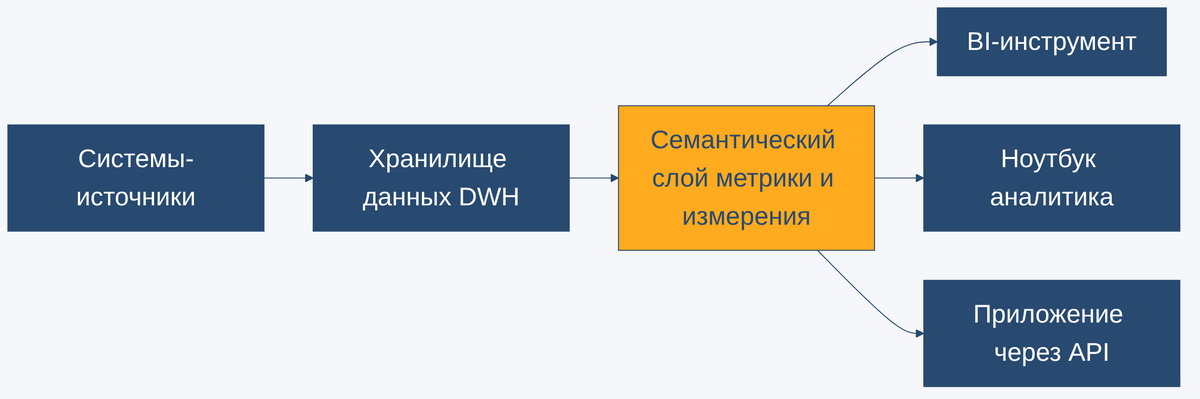
Семантический слой убирает эту развилку, вынося логику расчёта метрики из отчётов и дашбордов в единое место. Аналитик, который строит отчёт в BI-инструменте, не пишет агрегацию заново, а запрашивает готовую метрику по имени. Формула метрики меняется один раз в определении семантического слоя и сразу применяется везде, где эта метрика используется, от корпоративного дашборда до Python-ноутбука аналитика.
Архитектура и ключевые компоненты
Дальше в статье разбирается dbt Semantic Layer, одна из активно развивающихся реализаций этого подхода, построенная поверх открытого движка MetricFlow. Движком владеет dbt Labs, компания-разработчик одноимённого инструмента трансформации данных dbt (data build tool). У архитектуры четыре обязательные части.
- Семантическая модель. Описание одной сущности хранилища, например заказов, через её ключ (entity), измерения (dimensions) и агрегируемые поля (measures).
- Метрики. Формулы поверх measures, от простой суммы до отношения двух других метрик.
- Semantic Manifest. Артефакт, скомпилированный из YAML-файлов проекта, который движок читает при каждом запросе.
- Слой доступа. CLI, API или JDBC-подключение, через которое BI-инструмент, ноутбук или приложение запрашивает метрику по имени, а не пишет SQL самостоятельно.
Ниже семантическая модель заказов интернет-магазина из демо-проекта статьи. Сущность order_id объявлена первичным ключом, customer_id внешним, а среди measures есть заготовка для будущей ratio-метрики.
# MetricFlow 0.212.0 (dbt-metricflow 0.14.0), синтаксис по документации dbt Semantic Layer, прогнано на стенде 2026-08-26
version: 2

semantic_models:
  - name: orders
    description: "Заказы интернет-магазина, одна строка это один заказ."
    model: ref('stg_orders')
    defaults:
      agg_time_dimension: order_date
    entities:
      - name: order_id
        type: primary
      - name: customer_id
        type: foreign
    dimensions:
      - name: order_date
        type: time
        type_params:
          time_granularity: day
      - name: region
        type: categorical
      - name: status
        type: categorical
    measures:
      - name: order_amount
        agg: sum
        expr: amount
      - name: order_count
        agg: count
        expr: order_id
      - name: completed_order_count
        agg: sum
        expr: "case when is_completed then 1 else 0 end"
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Принцип работы семантического слоя
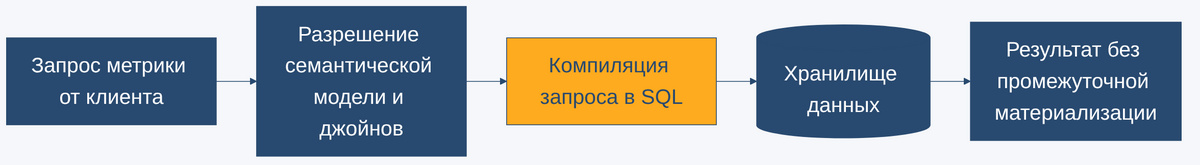
Ключевое отличие семантического слоя от материализованного представления или витрины в том, что он ничего не хранит. Каждый запрос метрики компилируется в SQL заново, в момент обращения, а не читается из заранее посчитанной таблицы. Фильтры и группировки из запроса при этом сразу попадают в сгенерированный SQL, такой приём называется predicate pushdown, и он позволяет хранилищу не сканировать всю таблицу целиком.
Практическое следствие видно на ratio-метрике, у которой числитель и знаменатель это две разные агрегации. В демо-проекте статьи метрика completion_rate делит количество завершённых заказов на общее количество заказов по региону. Команда mf query с флагом —explain не выполняет запрос, а печатает SQL, который движок собрал под конкретный вопрос.
# dbt-metricflow 0.14.0 (MetricFlow 0.212.0), прогнано на стенде 2026-08-26
mf query --metrics completion_rate --group-by order_id__region --explain
-- сгенерировано MetricFlow 0.212.0 локально на стенде 2026-08-26, вывод run_output.txt
SELECT
  order_id__region
  , CAST(completed_orders AS DOUBLE PRECISION) / CAST(NULLIF(order_count, 0) AS DOUBLE PRECISION) AS completion_rate
FROM (
  SELECT
    order_id__region
    , SUM(__completed_orders) AS completed_orders
    , SUM(__order_count) AS order_count
  FROM (
    SELECT
      region AS order_id__region
      , CASE WHEN order_id IS NOT NULL THEN 1 ELSE 0 END AS __order_count
      , case when is_completed then 1 else 0 end AS __completed_orders
    FROM "semantic_layer_demo"."public"."stg_orders" orders_src_10000
  ) subq_3
  GROUP BY
    order_id__region
) subq_5
Три вложенных SELECT честно показывают механизм. Внутренний уровень считает по каждой строке заказа два флага, средний уровень суммирует их по региону, а внешний делит одну сумму на другую. На демо-базе из 2000 заказов такой запрос, уже без —explain, выполняется за 0.05 секунды, что укладывается в заявленную документацией dbt латентность порядка миллисекунд для типовых объёмов.
От модели внутри BI-инструмента к headless-слою
Классическое понимание семантического слоя сложилось в эпоху BI-инструментов с собственным моделирующим языком. LookML в облачном сервисе Looker (сейчас часть Google Cloud) описывал измерения и меры прямо внутри Looker, и этим описанием мог пользоваться только сам Looker. Похожая идея «universe», собственного словаря бизнес-понятий поверх таблиц, применялась в BusinessObjects, ещё одной BI-платформе того поколения, которая сейчас входит в состав SAP. Модель была мощной, но привязанной к одному продукту.
dbt Semantic Layer устроен иначе. Метрики определяются в dbt-проекте, компилируются MetricFlow и становятся доступны не одному инструменту, а любому, кто умеет подключиться по CLI, API или JDBC. Дашборд в Tableau, ноутбук аналитика и скрипт в Python могут запросить одну и ту же метрику total_revenue и получить одинаковое число, потому что любое из этих обращений проходит через одно и то же определение, а не через собственный, постепенно расходящийся SQL-запрос. Такой слой принято называть headless, безголовым, потому что у него нет собственного интерфейса отчётности, только API.
Ограничения и подводные камни dbt Semantic Layer
Документация dbt честно перечисляет границы, за которые слой не заходит, и часть из них стоит знать до того, как проектировать демо на его основе.
- API доступен не всем. Полноценный доступ к Semantic Layer через API и готовые интеграции с BI открыт только на платных планах dbt Cloud, Starter, Enterprise и Enterprise+. Пользователи dbt Core получают сам движок MetricFlow бесплатно, но только как локальный CLI, без API.
- Нет кастомных агрегаций. Measures поддерживают фиксированный набор типов, sum, count, average и подобные, а произвольную агрегацию на уровне measure добавить нельзя.
- Кросс-проектные ссылки ограничены. Ссылка на модель из другого dbt-проекта через ref с указанием имени проекта работает только в устаревшей YAML-спецификации, в новой семантические модели такой связи пока не поддерживают.
- Поддерживаются не все хранилища. Список ограничен Snowflake, BigQuery, Databricks, Redshift, Postgres и Trino, для остальных платформ доступа к Semantic Layer нет.
Ещё две границы обнаружились уже при сборке демо для этой статьи, и документация формулирует их не так явно. Ratio-метрика ссылается в numerator и denominator на имена других метрик, а не на measures напрямую, поэтому под каждый measure, участвующий в отношении, нужна отдельная простая метрика. А сам проект не запускается без модели с конфигом time_spine и гранулярностью не крупнее дня, потому что MetricFlow опирается на неё при агрегации по времени.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Когда использовать семантический слой, а когда не стоит
Слой окупается, когда несколько команд или несколько BI-инструментов должны видеть одни и те же метрики без риска разойтись в определениях. Он же полезен, когда метрики часто меняются, потому что правку формулы не нужно синхронно катить в десяток дашбордов.
- Стоит внедрять. Компания растёт из одного BI-инструмента в несколько, и уже была история с разными числами выручки в разных отчётах.
- Стоит внедрять. Метрики меняются часто, а изменение формулы вручную разносится по отчётам с задержкой и ошибками.
- Не стоит внедрять. В компании один аналитик и один BI-инструмент, а метрик десяток, накладные расходы на поддержку семантического слоя не окупятся.
- Не стоит внедрять как есть. Нужна метрика с нестандартной агрегацией или BI-инструмент вне официального списка интеграций, в этом случае живой запрос придётся заменить на периодическую выгрузку в таблицу.
Граница в каждом случае одна и та же, семантический слой оправдан, когда цена рассинхронизации метрик выше цены поддержки самого слоя.
Практика. Локальный запуск MetricFlow поверх Postgres
Полноценный dbt Semantic Layer с API живёт в dbt Cloud, но сам движок MetricFlow ставится из PyPI и запускается локально, без подписки, прямо из dbt Core. Демо для статьи собрано именно так, локальный PostgreSQL 18.4, dbt-core 1.12.3 и dbt-metricflow 0.14.0, без Docker и без внешних сервисов. Курс «Data Build Tool для инженеров данных» закрывает эту тему инструментально, от первого dbt-проекта до продвинутых моделей.
Метрики демо-проекта заданы в отдельном файле. total_revenue и order_count это простые метрики поверх соответствующих measures, а completion_rate это уже знакомое из предыдущего раздела отношение двух других метрик.
# MetricFlow 0.212.0 (dbt-metricflow 0.14.0), синтаксис по документации dbt Semantic Layer, прогнано на стенде 2026-08-26
version: 2

metrics:
  - name: total_revenue
    description: "Суммарная выручка по заказам."
    type: simple
    type_params:
      measure: order_amount

  - name: order_count
    description: "Количество заказов."
    type: simple
    type_params:
      measure: order_count

  - name: completed_orders
    description: "Количество завершённых заказов."
    type: simple
    type_params:
      measure: completed_order_count

  - name: completion_rate
    description: "Доля завершённых заказов от общего числа."
    type: ratio
    type_params:
      numerator: completed_orders
      denominator: order_count
После dbt build, который материализует staging-модель и календарную time spine модель, метрику можно запросить одной командой.
# dbt-metricflow 0.14.0 (MetricFlow 0.212.0), прогнано на стенде 2026-08-26
mf query --metrics total_revenue --group-by metric_time__month
На демо-базе с 2000 заказами полный прогон, пересоздание базы, dbt build и три запроса метрик, занимает около 10 секунд, а одиночный запрос выполняется за 0.03-0.05 секунды на стороне сервера. Была и нестыковка с ходу, MetricFlow отказался парсить проект без модели time spine, а сообщение об ошибке про несуществующее измерение подсказывает точное имя с префиксом сущности вместо голого имени колонки. Обе детали разобраны в RUNBOOK.md репозитория с кодом, а более широкий взгляд на путь от хранилища данных к бизнес-инсайтам дан в статье блога Data Warehousing and Business Intelligence.
Заключение
Семантический слой переносит определение бизнес-метрики из головы аналитика и текста SQL-запроса в код, который читает и человек, и BI-инструмент, и любое другое приложение. Он не заменяет хранилище данных и не ускоряет запросы сам по себе, а убирает дублирование логики между отчётами. Открытый движок MetricFlow показывает, что для этой задачи не обязательно платить за полноценную платформу, локальный запуск поверх любого поддерживаемого хранилища уже даёт рабочую модель метрик и честный SQL под капотом, который можно увидеть флагом —explain.