 37
Содержание
- Что такое ReAct и какую задачу решает
- Архитектура цикла из трёх компонентов
- Формат Thought, Action и Observation
- Принцип работы под капотом
- ReAct против Act-only и Chain-of-Thought по цифрам эксперимента
- Судьба паттерна в LangChain и LangGraph после ухода от create_react_agent
- Сценарии использования и когда ReAct не подходит
- Практика применения ReAct на LangGraph и локальной модели qwen2.5 7b
- Код и трейс реального прогона
- Заключение
- Референсные ссылки
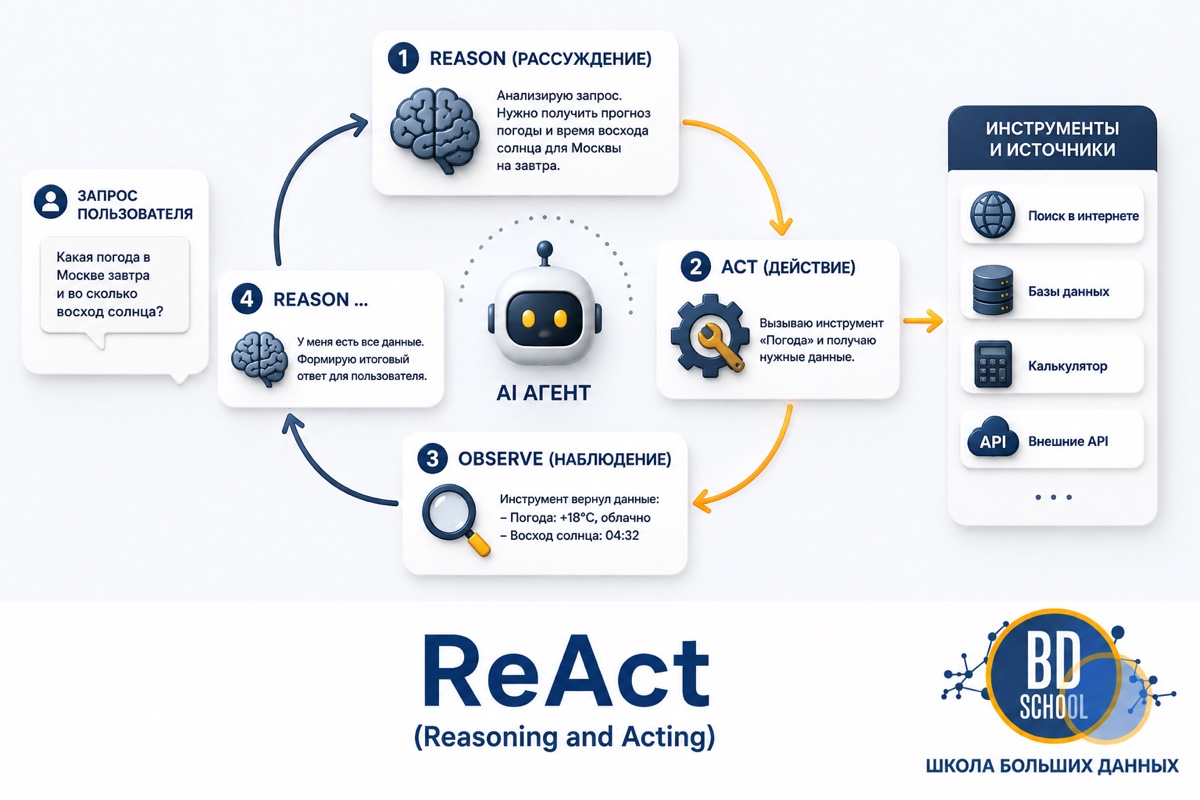
ReAct (Reasoning and Acting) это паттерн работы LLM-агента, в котором модель на каждом шаге чередует словесное рассуждение (Thought) и обращение к внешнему инструменту (Action), а результат вызова (Observation) возвращается в контекст и запускает следующий шаг. Паттерн предложили в статье 2022 года Shunyu Yao (Шуньюй Яо), на тот момент исследователь Принстонского университета, работавший над статьёй во время стажировки в Google, и соавторы, и с тех пор он стал одним из базовых строительных блоков для агентов на LLM.
Что такое ReAct и какую задачу решает
До ReAct у языковых моделей были два независимых режима. Первый это цепочка рассуждений (chain-of-thought, CoT), где модель размышляет текстом, но не может свериться с внешним миром и потому иногда уверенно выдаёт неверный факт. Второй это прямое выполнение действий без промежуточных рассуждений, из-за чего модель теряет план на длинной задаче. ReAct убирает разрыв между этими режимами через один цикл. Рассуждение подсказывает, какое действие нужно дальше, а результат действия поправляет рассуждение, если оно опиралось на неверную догадку.
Для практики это значит, что модель не пытается вспомнить факт или посчитать что-то в уме там, где дешевле и надёжнее один раз вызвать инструмент. Именно поэтому паттерн лежит в основе большинства современных фреймворков для LLM-агентов, от LangGraph до кастомных реализаций поверх tool calling.
Архитектура цикла из трёх компонентов
Оригинальная статья описывает ReAct через три элемента, которые встречаются в любой реализации паттерна независимо от фреймворка.
- Модель как политика. Языковая модель на каждом шаге решает, что делать дальше, опираясь на всю историю мыслей, действий и наблюдений с начала задачи.
- Инструменты и среда. Внешний источник, к которому обращается действие. В статье это API Википедии для вопросно-ответных задач и интерактивные окружения ALFWorld и WebShop для принятия решений, в прикладных агентах это любые функции и API, оформленные как tool.
- Наблюдение. Результат вызова, который добавляется обратно в контекст модели и становится основой для следующего шага рассуждения.
Все три компонента работают в связке, и конкретная форма каждого из них зависит от реализации, а не от паттерна.
Формат Thought, Action и Observation
В оригинальной статье эти три роли были буквальным текстовым форматом, который модель печатала строка за строкой, а фреймворк парсил регулярными выражениями. Thought это короткая мысль о том, зачем нужен следующий шаг. Action это вызов конкретного инструмента с аргументами. Observation это то, что инструмент вернул. Цикл повторяется, пока модель не решит, что данных достаточно для финального ответа.
Принцип работы под капотом
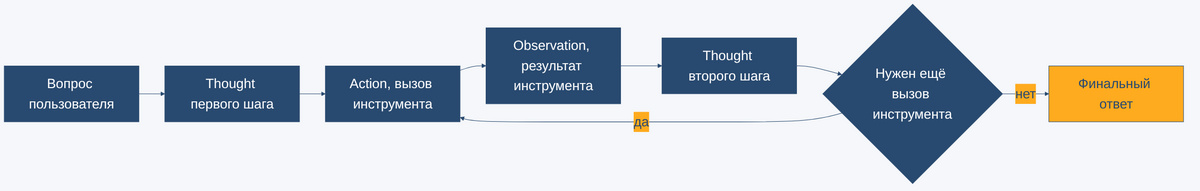
Механика цикла простая. Модель получает вопрос и историю сообщений, генерирует мысль о том, что нужно сделать, и следом действие с параметрами. Действие исполняется вне модели, а его результат приходит обратно уже в виде отдельного сообщения-наблюдения. Дальше модель видит и вопрос, и всю цепочку прошлых шагов, поэтому может опираться на реальные данные, а не на догадку. Цикл завершается, когда модель решает, что для ответа достаточно информации, и вместо очередного действия печатает финальный текст.
Ключевой эффект, который отмечают авторы, в том, что чередование рассуждения и действия снижает галлюцинации по сравнению с чистым CoT без обращения к внешним данным, а сама траектория решения становится интерпретируемой. Читая лог шагов, легко увидеть, где именно модель приняла неверное решение, а не только то, что итоговый ответ ошибочен.
ReAct против Act-only и Chain-of-Thought по цифрам эксперимента
Авторы статьи сравнили ReAct с рассуждением без действий (CoT) и действиями без рассуждения (Act-only) на модели PaLM-540B, языковой модели Google на 540 миллиардов параметров, в режиме few-shot промптинга, без дообучения. На вопросно-ответном бенчмарке HotpotQA сам по себе ReAct обошёл Act-only, но уступил CoT с self-consistency, зато комбинация ReAct с последующим CoT-SC дала лучший результат среди всех вариантов. На интерактивном ALFWorld разрыв в пользу ReAct гораздо больше, потому что там нужно не столько знание фактов, сколько план из нескольких шагов с проверкой промежуточного состояния.
| Метод | HotpotQA, EM % | ALFWorld, успех % |
|---|---|---|
| Act-only | 25.7 | 45 (лучший из 6 прогонов) |
| CoT / CoT-SC | 29.4 / 33.4 | н/д |
| ReAct | 27.4 | 57 в среднем, 71 лучший из 6 |
| ReAct → CoT-SC (комбинация) | 35.1 | н/д |
| BUTLER, имитационное обучение | н/д | 37 (лучший из 8) |
Отсюда вывод, который авторы формулируют в самой статье. На ALFWorld и WebShop, задачах интерактивного принятия решений, ReAct превосходит методы имитационного и обучения с подкреплением на 34 и 10 процентных пунктов абсолютного успеха соответственно, используя лишь один-два примера в контексте. На чисто вопросно-ответных задачах чистый ReAct не всегда сильнее развитого CoT, зато их комбинация устойчиво лучше любого варианта по отдельности.
Судьба паттерна в LangChain и LangGraph после ухода от create_react_agent
Несколько лет прикладным входом в ReAct в экосистеме LangChain была функция create_react_agent из пакета langgraph.prebuilt. Она собирала граф из узла модели и узла инструментов и скрывала ручную сборку StateGraph под паттерн. По официальным релиз-нотам LangGraph v1 эта функция признана устаревшей в пользу create_agent из пакета langchain.agents, который добавляет слой middleware для кастомизации поведения агента.
На установленной на стенде LangGraph 1.2.11 вызов старой функции реально бросает предупреждение об устаревании, а не просто числится устаревшим в документации. Вот дословный текст, снятый прогоном.
# langgraph 1.2.11, прогнано на стенде 2026-08-27
категория: LangGraphDeprecatedSinceV10
текст: create_react_agent has been moved to `langchain.agents`. Please update your import to `from langchain.agents import create_agent`. Deprecated in LangGraph V1.0 to be removed in V2.0.
Важная деталь для тех, кто искал в статье классический текстовый формат Thought, Action, Observation прямо в выводе агента. Современный create_agent работает через нативный tool calling модели, то есть структурированные вызовы инструментов и отдельные сообщения-результаты, а не через парсинг текста по регулярным выражениям. Меняется форма трассировки, а не сам цикл рассуждения и действия, который остался тем же самым.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Сценарии использования и когда ReAct не подходит
ReAct уместен, когда задачу нельзя решить одним вызовом модели без обращения к внешнему миру, а несколько последовательных обращений нужны с проверкой промежуточного результата. Типичные примеры это вопросно-ответные системы поверх собственной базы знаний, агенты для работы с API и файловой системой, интерактивные окружения вроде тестирования UI или прохождения многошаговых форм. Подробнее о том, где на общей карте агентных паттернов стоит ReAct, рассказано в статье про эволюцию чат-ботов и шаблоны рабочих процессов.
Паттерн избыточен для задач, которые модель решает и без инструментов, например пересказ текста или перевод. Он же плохо подходит, когда цепочка шагов заранее известна и не зависит от промежуточных наблюдений, потому что тогда дешевле собрать детерминированный пайплайн без затрат на решение модели на каждом шаге. Наконец, эксперимент авторов на HotpotQA показывает практическую границу. Там, где нужен в первую очередь точный факт из памяти модели, а не многошаговый план, чистый ReAct не гарантированно лучше сильного CoT, и разработчику стоит проверить оба варианта, а не считать ReAct универсальным улучшением по умолчанию.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Практика применения ReAct на LangGraph и локальной модели qwen2.5 7b
Демо строит агента на текущем create_agent поверх локальной модели qwen2.5:7b через langchain-ollama и одном инструменте, который считает точное число символов в слове. Задача подобрана так, чтобы модель не могла ответить без вызова инструмента, посимвольное сравнение двух слов не тривиально для LLM. Стек прогона по факту на стенде это langchain 1.3.15, langchain-core 1.5.4, langchain-ollama 1.1.0 и langgraph 1.2.11.
Пилотный вызов модели без агента занял 7.7 секунды (без загрузки модели, она уже тёплая на стенде). Полный цикл с двумя обращениями к инструменту и двумя обращениями к модели укладывается в 18-27 секунд общего времени процесса, разброс дают импорт LangChain и LangGraph и разогрев модели, которые на пилотном замере не учтены. Полезный курс по построению таких агентов на LangGraph и LangChain это AGENT.
Код и трейс реального прогона
Системный промпт явно просит модель проговаривать мысль перед вызовом инструмента, потому что без этой инструкции содержимое сообщения на шаге вызова у qwen2.5:7b обычно пустое, а структурированный tool_calls формируется в любом случае.
# langchain 1.3.15, langchain-ollama 1.1.0, langgraph 1.2.11, qwen2.5:7b, прогнано на стенде 2026-08-27
"""Цикл ReAct (Thought -> Action -> Observation) на текущем API create_agent
из langchain.agents. Модель не может ответить на вопрос без инструмента:
сравнение длины двух слов не тривиально для LLM посимвольно, поэтому она
вызывает инструмент word_length дважды и только потом формулирует ответ.
"""

from langchain.agents import create_agent
from langchain_core.tools import tool
from langchain_ollama import ChatOllama


@tool
def word_length(word: str) -> int:
    """Возвращает точное число символов в слове."""
    return len(word)


def run() -> None:
    llm = ChatOllama(model="qwen2.5:7b", temperature=0)
    agent = create_agent(
        model=llm,
        tools=[word_length],
        system_prompt=(
            "Ты решаешь задачу пошагово. Перед каждым вызовом инструмента "
            "коротко объясни в тексте, зачем он тебе нужен (это твоя мысль, "
            "Thought). После получения результата инструмента (Observation) "
            "либо вызови инструмент ещё раз, либо дай финальный ответ."
        ),
    )

    question = (
        "Какое из двух слов длиннее: 'наблюдаемость' или 'архитектура'? "
        "Ответь названием более длинного слова и разницей в символах."
    )

    result = agent.invoke({"messages": [{"role": "user", "content": question}]})

    print("=== Полный трейс цикла ReAct ===")
    for i, msg in enumerate(result["messages"]):
        role = msg.__class__.__name__
        tool_calls = getattr(msg, "tool_calls", None)
        if role == "AIMessage" and tool_calls:
            print(f"[{i}] {role} (Thought, если есть, в content) -> Action:")
            if msg.content:
                print(f"    Thought: {msg.content}")
            for call in tool_calls:
                print(f"    Action: {call['name']}({call['args']})")
        elif role == "ToolMessage":
            print(f"[{i}] {role} -> Observation: {msg.content}")
        else:
            print(f"[{i}] {role}: {msg.content}")

    print("\n=== Финальный ответ ===")
    print(result["messages"][-1].content)


if __name__ == "__main__":
    run()
Реальный вывод этого скрипта показывает цикл целиком, включая обе мысли модели перед вызовами инструмента.
# langchain 1.3.15, langchain-ollama 1.1.0, langgraph 1.2.11, qwen2.5:7b, прогнано на стенде 2026-08-27
=== Полный трейс цикла ReAct ===
[0] HumanMessage: Какое из двух слов длиннее: 'наблюдаемость' или 'архитектура'? Ответь названием более длинного слова и разницей в символах.
[1] AIMessage (Thought, если есть, в content) -> Action:
    Thought: Для того чтобы определить, какое из слов длиннее, я воспользуюсь функцией word_length, которая вернет количество символов в каждом слове.
    Action: word_length({'word': 'наблюдаемость'})
[2] ToolMessage -> Observation: 13
[3] AIMessage (Thought, если есть, в content) -> Action:
    Thought: Длина слова 'наблюдаемость' составляет 13 символов. Теперь я проверю длину слова 'архитектура'.
    Action: word_length({'word': 'архитектура'})
[4] ToolMessage -> Observation: 11
[5] AIMessage: Слово 'архитектура' состоит из 11 символов. Следовательно, слово 'наблюдаемость' длиннее на 2 символа.

=== Финальный ответ ===
Слово 'архитектура' состоит из 11 символов. Следовательно, слово 'наблюдаемость' длиннее на 2 символа.
Модель дважды вызвала инструмент вместо того, чтобы посчитать символы в уме, и получила верный ответ с разницей в 2 символа. Это и есть цикл ReAct на практике, только его форма это структурированный tool calling, а не текстовый парсинг из оригинальной статьи 2022 года.
Заключение
ReAct остаётся рабочим описанием того, как устроен цикл LLM-агента, даже когда конкретная реализация давно ушла от текстового формата Thought и Action к нативному вызову инструментов. Понимание этого цикла помогает читать трейс любого агента на LangGraph, LangChain или собственном коде поверх tool calling, потому что за разными названиями функций скрывается одна и та же идея. Рассуждение направляет действие, а результат действия поправляет следующее рассуждение.
Референсные ссылки
- Yao et al., «ReAct: Synergizing Reasoning and Acting in Language Models», arXiv:2210.03629, первоисточник паттерна, архитектура цикла и результаты экспериментов на PaLM-540B.
- LangGraph v1, официальные релиз-ноты, статус устаревания create_react_agent и переход на create_agent.
- Референсная документация create_react_agent, официальное описание устаревающей реализации и её параметров.