 14
Содержание
- Что такое Modern Data Stack
- Шесть слоёв архитектуры Modern Data Stack
- Ingestion, приём данных
- Storage, облачное хранилище и lakehouse
- Transformation, dbt и ELT-трансформации
- Business Intelligence и визуализация
- Data Governance
- Orchestration
- ELT вместо ETL как принцип работы
- Эволюция подхода от BI-дашбордов к AI-ready данным
- Ограничения и подводные камни
- Когда стоит и когда не стоит применять Modern Data Stack
- Пример трансформации данных на dbt
- Заключение
- Референсные ссылки
Modern Data Stack (MDS) это архитектурный паттерн современной data-инфраструктуры, набор облачных инструментов для сбора, хранения, трансформации и анализа данных, каждый из которых закрывает одну узкую функцию. Термин обозначает не продукт одного вендора, а способ собирать инфраструктуру данных из специализированных SaaS-сервисов вместо построения монолитного on-premise стека вокруг Hadoop.
Что такое Modern Data Stack
Термин зафиксировала статья «Emerging Architectures for Modern Data Infrastructure», которую 15 октября 2020 года опубликовал венчурный фонд Andreessen Horowitz (a16z). Авторы, партнёры фонда Matt Bornstein, Martin Casado и Jennifer Li, описали сдвиг индустрии от собственных дата-центров к облачным хранилищам с разделением хранения и вычислений, прежде всего к Amazon Redshift и Snowflake. После публикации формулировка быстро стала общеупотребимой в индустрии data engineering, а в 2023 году a16z выпустил обновлённую версию статьи с той же базовой архитектурой, но актуализированным набором инструментов.
Идея простая. Вместо одной большой платформы под управлением одного вендора команда собирает стек из лучших в своём классе (best-of-breed) облачных сервисов, каждый из которых отвечает за свой слой обработки данных. Подробнее о том, как устроено хранилище и BI-часть такого стека, рассказано в материале про data warehousing и business intelligence.
Шесть слоёв архитектуры Modern Data Stack
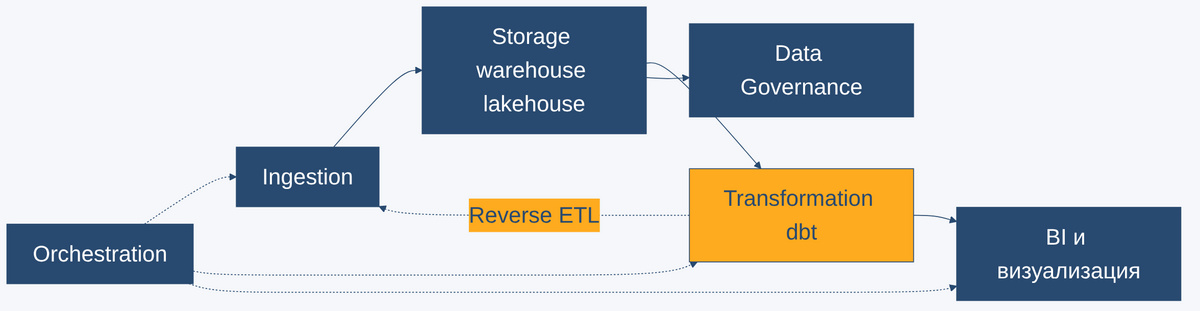
По данным разбора Fivetran, платформы для автоматизированной ELT-загрузки данных, MDS собирается из шести слоёв, каждый из которых закрывает одну функцию и обычно реализован отдельным инструментом.
Ingestion, приём данных
Ingestion-слой извлекает данные из источников (SaaS-приложений, баз данных, потоков событий) и загружает их в центральное хранилище без промежуточной трансформации. Типовые инструменты слоя это Fivetran, Airbyte, Stitch и Hevo, они автоматизируют коннекторы к десяткам источников и снимают с команды разработку собственных ETL-скриптов под каждый API.
Storage, облачное хранилище и lakehouse
Ядро стека это облачное хранилище (data warehouse) или lakehouse, например Snowflake, Databricks или BigQuery. Такие платформы разделяют хранение и вычисления, поэтому объём данных и нагрузка на запросы масштабируются независимо друг от друга, а плата идёт за фактическое использование, а не за зарезервированную ёмкость сервера. Подробнее о проектировании такой архитектуры и о смежных подходах Data Mesh и Data Fabric можно прочитать в материале про проектирование архитектуры данных.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Transformation, dbt и ELT-трансформации
Трансформация происходит уже внутри хранилища, силами его же вычислительных ресурсов. Ключевой инструмент слоя это dbt (data build tool), он превращает SQL-запросы в управляемые модели с версионированием, тестами и графом зависимостей.
Business Intelligence и визуализация
BI-слой превращает трансформированные таблицы в дашборды и отчёты для бизнес-пользователей. Инструменты вроде Looker и его аналогов подключаются напрямую к хранилищу и не требуют отдельного копирования данных в собственную базу. Поверх BI-инструментов стек всё чаще держит отдельный metric layer, то есть единый слой определений бизнес-метрик, чтобы «выручка» или «активный пользователь» считались одинаково в дашборде, в отчёте для инвесторов и в модели, которую использует AI-агент.
Data Governance
Governance-слой отвечает за контроль доступа, lineage (происхождение данных) и проверки качества. Часть этой задачи закрывают встроенные тесты dbt, которые проверяют модели на уникальность значений, отсутствие пропусков и ссылочную целостность прямо в пайплайне трансформации. При росте числа инструментов в стеке именно этот слой требует целенаправленных инвестиций, потому что одни и те же данные проходят через несколько систем одновременно, и без единого контроля прозрачность их обработки теряется.
Orchestration
Оркестрация управляет порядком запуска пайплайнов, зависимостями между задачами и мониторингом сбоев. Типовой инструмент слоя это Apache Airflow, который описывает пайплайн как граф задач (DAG) и перезапускает упавшие шаги по расписанию.
Apache Airflow для инженеров данных
Код курса
AIRF
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
ELT вместо ETL как принцип работы
Поток данных в MDS выглядит так. Сырые данные проходят ingestion (extract & load) без трансформации и попадают в центральное хранилище, а трансформируются они уже там. Опционально результат возвращается обратно в операционные системы через Reverse ETL, например в CRM или маркетинговую платформу. Ключевое отличие от классического ETL-стека в том, что трансформация идёт после загрузки, а не до неё.
В классическом ETL-стеке transformation выполнял отдельный движок до попадания данных в хранилище, поэтому вычислительная мощность под трансформацию закупалась и обслуживалась отдельно от самого хранилища. Дешёвые вычисления облачных warehouse сделали такую отдельную инфраструктуру ненужной.
| Параметр | Классический ETL on-premise | Modern Data Stack (ELT) |
|---|---|---|
| Где трансформация | Отдельный ETL-движок до загрузки | Внутри облачного хранилища после загрузки |
| Инфраструктура | Собственные серверы и Hadoop-кластер | Управляемые облачные SaaS-сервисы |
| Масштабирование | Хранение и вычисления связаны | Хранение и вычисления разделены |
| Состав инструментов | Монолитная платформа одного вендора | Набор специализированных best-of-breed сервисов |
Эволюция подхода от BI-дашбордов к AI-ready данным
В 2019-2022 годах, в «золотую эру» подхода, MDS решал в основном задачи BI. Инструменты закрывали путь от сырых данных к дашбордам, а конкуренция шла за лучший инструмент внутри каждого слоя. Согласно обзорам рынка MDS 2026 года, акцент сместился с дашбордов на подготовку данных для AI-агентов. Стек описывают как расширенный AI data layer, а вместо отдельных таблиц и дашбордов появилось понятие data products, то есть данных, упакованных и документированных как самостоятельный продукт для внутреннего или внешнего потребителя. Reverse ETL закрывает цикл, возвращая результаты анализа обратно в операционные системы, а не только показывая их в отчётах.
Ограничения и подводные камни
У подхода нет единого владельца и единой спецификации, поэтому числовых лимитов у MDS тоже нет. Вместо технических ограничений индустрия фиксирует системные проблемы самого подхода.
- Эскалация стоимости. При накоплении множества специализированных SaaS-инструментов операционные расходы стека перестают быть предсказуемыми, индустрия называет это «Modern Data Stack High-Speed Tax».
- Проблемы интеграции. Конкурирующие платформы борются за роль «control plane» стека, из-за чего совместимость между инструментами страдает, а кастомные интеграции обходятся дорого. Обновление версии API одного сервиса способно сломать цепочку, в которую входят ещё три-четыре инструмента от разных вендоров, и чинить такую цепочку приходится вручную.
- Требования к экспертизе. Несмотря на маркетинг о демократизации данных, стек по-прежнему требует квалифицированных data-инженеров для настройки и поддержки.
Ни одна из этих проблем не отменяет пользы подхода, но каждая требует отдельного бюджета и отдельного плана, а не решается сама собой вместе с покупкой очередного SaaS-инструмента.
Когда стоит и когда не стоит применять Modern Data Stack
Подход укладывается в задачу, если команда уже работает с облаком и готова платить за скорость и гибкость, а объём и разнообразие источников данных растут быстрее, чем штат data-инженеров, способный обслуживать их вручную.
- Нужна масштабируемость. Разделение хранения и вычислений снимает вопрос роста объёма данных с повестки.
- Важна автоматизация. Команда хочет снизить ручное обслуживание инфраструктуры и не держать отдельный штат под администрирование серверов.
- Нужна централизованная видимость. Организации важно соответствие compliance-требованиям и единая картина данных.
- Важна гибкость. Стек должен расти новыми инструментами и источниками данных по мере роста бизнеса.
Подход подводит там, где бюджет ограничен, а команда не готова содержать выделенную data-инженерную экспертизу. Стек не является no-code решением, несмотря на маркетинг о демократизации данных, а там, где критична открытая интероперабельность между системами, конкуренция вендоров за роль «control plane» превращается в дополнительный риск.
Пример трансформации данных на dbt
Ниже фрагмент dbt-модели, синтаксис актуален для dbt Core, полная спецификация в официальной документации. Модель собирает витрину заказов из двух staging-таблиц.
-- пример dbt-модели, синтаксис dbt Core 1.12.x, источник docs.getdbt.com
-- config задаёт материализацию модели как физическую таблицу
{{ config(materialized='table') }}

with orders as (
    -- берём уже очищенную staging-модель заказов
    select * from {{ ref('stg_orders') }}
),

customers as (
    -- и staging-модель клиентов
    select * from {{ ref('stg_customers') }}
)

-- финальный select собирает витрину заказов вместе с данными клиента
select
    orders.order_id,
    customers.customer_id,
    customers.customer_name,
    orders.order_date,
    orders.amount
from orders
left join customers
    on orders.customer_id = customers.customer_id
Функция ref() связывает модели друг с другом и достраивает граф зависимостей автоматически, поэтому dbt сам знает, в каком порядке запускать трансформации. Параметр materialized в config задаёт, сохранится модель как таблица, представление или инкрементальная загрузка. Полный синтаксис и список параметров описаны в документации dbt, ссылка в референсах ниже. Освоить инструмент подробнее можно на курсе dbt для инженера данных.
Заключение
Modern Data Stack не софт и не продукт с версией, а способ собрать инфраструктуру данных из специализированных облачных сервисов вместо монолитной on-premise платформы. Подход снял с команд задачу администрирования серверов и дал гибкость выбора лучшего инструмента под каждый слой, но взамен принёс новую статью расходов и новую точку сложности на стыке этих инструментов. Термину почти шесть лет, а его содержание уже поменялось: там, где раньше стек собирали ради дашбордов, сегодня его собирают ради данных, готовых к потреблению AI-агентами.