 6
Содержание
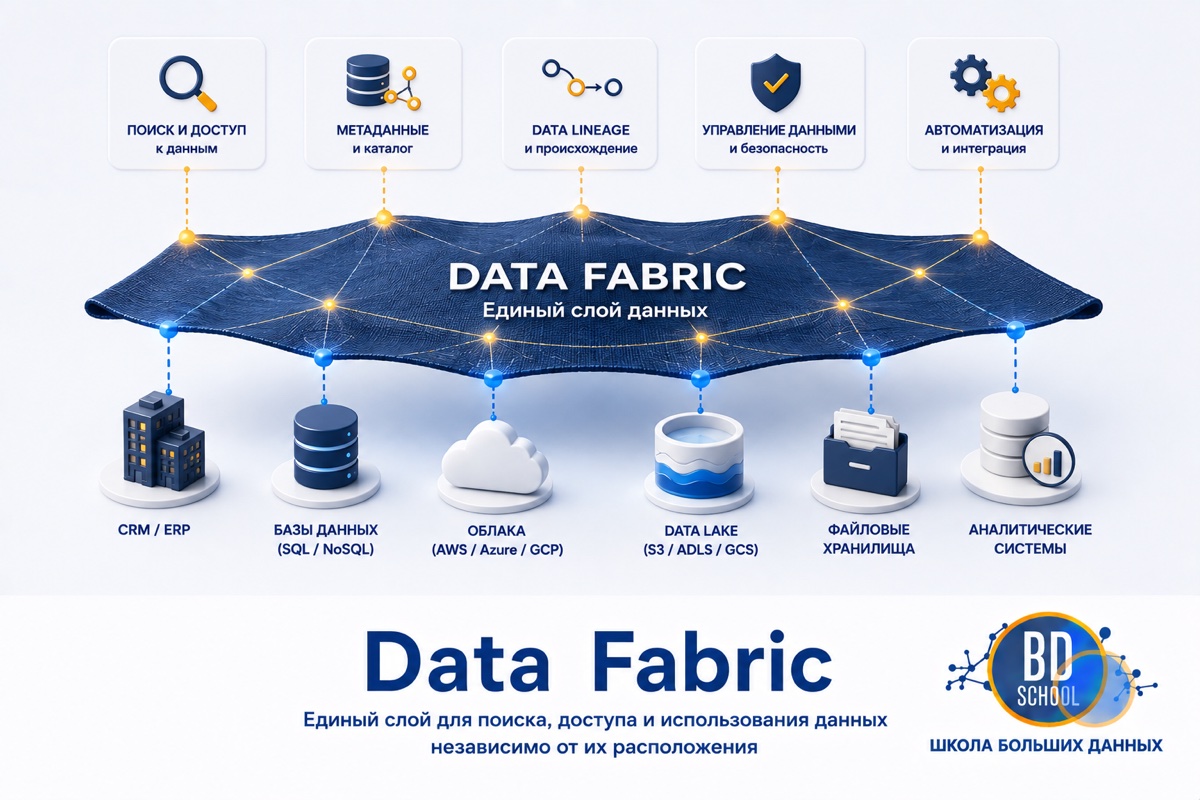
Data Fabric (data fabric) это архитектурная концепция управления данными, которую как отдельную категорию ввела аналитическая компания Gartner. Концепция описывает архитектуру, где непрерывно
собираемый и анализируемый слой активных метаданных (active metadata) автоматически связывает разрозненные источники данных в гибридных, мультиоблачных и edge-средах, не перемещая сами данные физически в единое хранилище.
Что такое Data Fabric
По определению Gartner, data fabric это развивающийся дизайн управления данными, который использует метаданные дляавтоматизации задач интеграции и устраняет ручную сборку данных из разных источников. Ключевое свойство здесь «composable»: фабрика данных собирается из взаимозаменяемых технологий, а не поставляется единым продуктом с номером версии. Именно поэтому у Data Fabric нет «релиза» в привычном смысле. Конкретные вендоры, среди них IBM, Informatica, Denodo и K2view, реализуют паттерн по-разному и добавляют собственные инструменты каталогизации, управления данными (governance) и виртуализации данных.
Актуальная трактовка термина на 2025-2026 годы явно смещена в сторону подготовки данных для искусственного интеллекта. Gartner формулирует это и в общем определении термина, и в пресс-релизе от 14 октября 2025 года про масштабирование ИИ в цепочках поставок. Фабрика данных должна обеспечивать доступ к «AI-ready data», то есть данным, готовым к использованию в моделях машинного обучения без долгой ручной подготовки. Подробнее о том, как устроен этот подход в контексте аналитики больших данных, рассказано в статье Облачный конвейер аналитики Big Data: что такое Data Fabric.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
28 сентября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Архитектура и ключевые компоненты Data Fabric
Референсная архитектура IBM для data fabric построена вокруг пяти модулей, идущих один за другим. Импорт метаданных (metadata import) собирает информацию о структуре, расположении и владельцах данных из подключённых источников. Обогащение метаданных (metadata enrichment) дополняет эту информацию бизнес-контекстом, классификациями и связями между сущностями.
Каталогизация метаданных (metadata cataloging) сводит обогащённые метаданные в единый доступный каталог, по которому можно искать данные независимо от того, где они физически хранятся.
Дальше в дело вступает курирование и трансформация данных (data curation and transformation). На основе каталога проверяется качество данных, применяются правила governance и выполняются нужные преобразования. Завершает цепочку потребление данных (data consumption), слой, через который бизнес-пользователи, аналитические инструменты и приложения обращаются к данным так, будто те лежат в одном месте, хотя физически они остаются в исходных гибридных, мультиоблачных или edge-системах.

Как работает слой активных метаданных
Ядро data fabric это не хранилище, а непрерывный процесс работы с метаданными. Система постоянно собирает метаданные о данных, их происхождении, схеме, использовании, качестве и связях, и на основе этого автоматически предлагает или выполняет типовые задачи интеграции. Именно это называется «активными метаданными» (active metadata) в отличие от статичного технического описания, которое просто лежит в документации и устаревает.
По документации IBM жизненный цикл данных внутри фабрики проходит через обнаружение, governance, проверку качества, классификацию, связывание с бизнес-контекстом, отслеживание происхождения (data lineage), самообслуживание и операционализацию. Data fabric не консолидирует данные физически. Она оставляет их там, где они лежат, будь то локальный дата-центр, публичное облако или edge-устройство, и строит поверх источников связывающий слой метаданных и governance.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
14 сентября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Чем отличаются Data Fabric, Data Mesh и Data Lakehouse
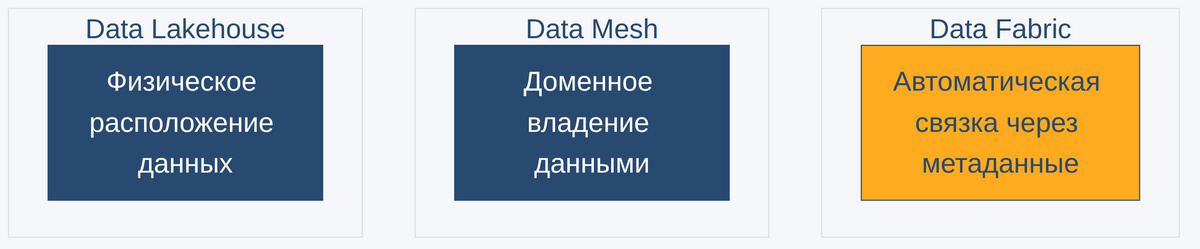
Три термина часто путают, потому что все они отвечают на вопрос, как организовать доступ к разрозненным данным. Data Fabric это архитектурный подход, технологический слой метаданных, который связывает источники данных автоматически и не требует физического перемещения данных. Data Mesh это организационная модель, а не технология. Она передаёт владение данными доменным командам и требует, чтобы каждая команда публиковала свои данные как продукт. Data Lakehouse это тип физического хранилища, который объединяет гибкость озера данных (data lake) и структуру хранилища данных (data warehouse) поверх одного набора файлов.
Разница видна на практике. В Data Fabric автоматизацию берёт на себя слой метаданных, поэтому для конечного пользователя разрозненные источники выглядят как одна система. В Data Mesh за интеграцию и качество данных отвечают конкретные доменные команды, а не централизованная платформа. В Data Lakehouse данные физически лежат в одном месте, обычно в объектном хранилище с открытым табличным форматом. Подробное сопоставление по критериям владения и автоматизации разобрано в статье Data Fabric vs Data Mesh.
| Критерий | Data Fabric | Data Mesh | Data Lakehouse |
|---|---|---|---|
| Что это | Архитектурный паттерн на основе метаданных | Организационная и социотехническая модель | Тип физического хранилища данных |
| Владение данными | Централизованный слой метаданных и governance | Доменные команды, данные как продукт | Обычно централизованная платформенная команда |
| Расположение данных | Остаётся в исходных источниках | Может оставаться распределённым по доменам | Физически консолидируется в одном хранилище |
| Роль метаданных | Ядро подхода, активные метаданные | Вспомогательная, через каталог продуктов данных | Табличный формат и метаданные схемы |
На практике эти подходы не исключают друг друга. Организация может выстроить Data Mesh как
операционную модель поверх Data Lakehouse, а Data Fabric использовать как технологический слой,
который автоматически связывает домены между собой.
Что осталось непроверенным
Часть данных о Data Fabric в этой статье получена из фрагментов поисковой выдачи, а не из полного текста первоисточников: прямой доступ к некоторым страницам Gartner и IBM оказался ограничен. Ниже перечислено, что осталось не проверено напрямую и требует отдельной проверки перед принятием решений.
- Детальный механизм активных метаданных. Конкретные алгоритмы, которыми дополненный интеллект (augmented intelligence) автоматизирует задачи интеграции, в найденных источниках не раскрыты.
- Числовые лимиты и ограничения. У архитектурной концепции без привязки к вендору формальных лимитов, судя по всему, нет, но это не подтверждено напрямую, а лимиты конкретных продуктов (IBM Cloud Pak for Data, Informatica, Denodo) не исследовались.
- Как изменилось определение термина за последние годы. Источники подтверждают текущий AI-ориентированный акцент 2025-2026 годов, но прямой цитаты прежней формулировки для сравнения не нашлось.
- Сценарии, где Data Fabric прямо не рекомендован. Явных отрицательных рекомендаций в собранных источниках не встретилось.
- Технологии внутри модулей референсной архитектуры IBM. Состав и порядок пяти модулей известны из сниппета поисковой выдачи, а вот конкретные продуктовые названия и инструменты, которыми IBM реализует переход между ними, не подтверждены, поскольку сама страница гайда не
открылась.
Все пробелы связаны с одним и тем же ограничением доступа к первоисточникам, а не с отсутствием информации в принципе.
Сценарии использования и когда Data Fabric не подходит
Data Fabric имеет смысл для организаций, у которых данные уже разбросаны по гибридным, мультиоблачным и edge-средам, и нужен единый слой доступа без переноса всего в одно хранилище.
Отдельно Gartner выделяет сценарий подготовки данных для AI. В пресс-релизе от 14 октября 2025 года аналитики компании прямо рекомендуют архитектуру data fabric директорам по цепочкам поставок (chief
supply chain officer) как способ масштабировать применение искусственного интеллекта поверх разрозненных систем планирования и логистики.
Подход теряет смысл там, где данных мало, а источники и так однородны, потому что слой метаданных,
governance и каталогизации в такой ситуации создаёт больше архитектурных издержек, чем экономит.
Формальных антипаттернов от Gartner найти не удалось, поэтому это скорее общий инженерный вывод из
описания подхода, чем задокументированная рекомендация. Эта оговорка уже сделана выше, в разделе про
непроверенное.
Практика и иллюстрация подхода
Эталонной открытой реализации у data fabric нет, поэтому раздел не содержит запускаемого кода, демо-стенда или файлов для повторения. Но принцип легко проиллюстрировать на типовой задаче.
Представьте компанию, у которой данные о клиентах лежат в PostgreSQL внутри собственного дата-центра, события с сайта пишутся в Kafka в облаке, а исторические заказы архивированы в S3-совместимом хранилище. Без data fabric аналитику приходится вручную сводить эти три источника под каждую новую задачу.
С подходом data fabric поверх всех трёх источников разворачивается слой каталогизации и активных метаданных. Он один раз описывает схему, владельца, качество и связи данных в PostgreSQL, Kafka и S3, а дальше сам предлагает готовые связки для новых запросов, например цепочку «клиент, событие на сайте, заказ», без ручной интеграции каждый раз заново. Данные при этом физически остаются на месте. PostgreSQL не переезжает, Kafka не переезжает, S3 не переезжает.
Такой подход к проектированию архитектуры данных детально разбирается на курсе Практическая архитектура
данных, где паттерн Data Fabric упомянут в одном ряду с Data Lakehouse, Data Mesh и Data Cloud.
Заключение
Data Fabric это не продукт и не хранилище, а архитектурный принцип, при котором слой активных метаданных берёт на себя автоматическую связку разрозненных источников данных. От Data Mesh его отличает то, что автоматизацию выполняет технология, а не доменные команды. От Data Lakehouse его отличает то, что данные не переезжают в единое хранилище. Для организаций с гибридным, мультиоблачным или edge-ландшафтом данных, и особенно для подготовки данных к использованию в AI, это рабочий способ сократить ручную интеграцию при условии, что архитектурная сложность решения оправдана масштабом данных.
Референсные ссылки
- Gartner. What is Data Fabric? Uses, Definition & Trends
- Gartner. Chief Supply Chain Officers Can Scale AI With Data Fabric Architecture
- IBM. An IBM Architecture Guide to Data Fabric
- Dehghani, Z. How to Move Beyond a Monolithic Data Lake to a Distributed Data Mesh
- Databricks. What is a Data Lakehouse?