 64
Содержание
- Что такое ChromaDB и какую задачу он закрывает
- Архитектура ChromaDB и три режима развёртывания
- Local, single-node и distributed
- Пять компонентов под капотом
- Как работает поиск от документа до ближайших соседей
- Фильтры по метаданным и полнотекстовый поиск
- Потолок одного узла и сколько записей влезает в память
- Ядро на Rust и что дала версия 1.0
- Когда применять ChromaDB, а когда не стоит
- Практика с локальными эмбеддингами через Ollama
- Заключение
- Референсные ссылки
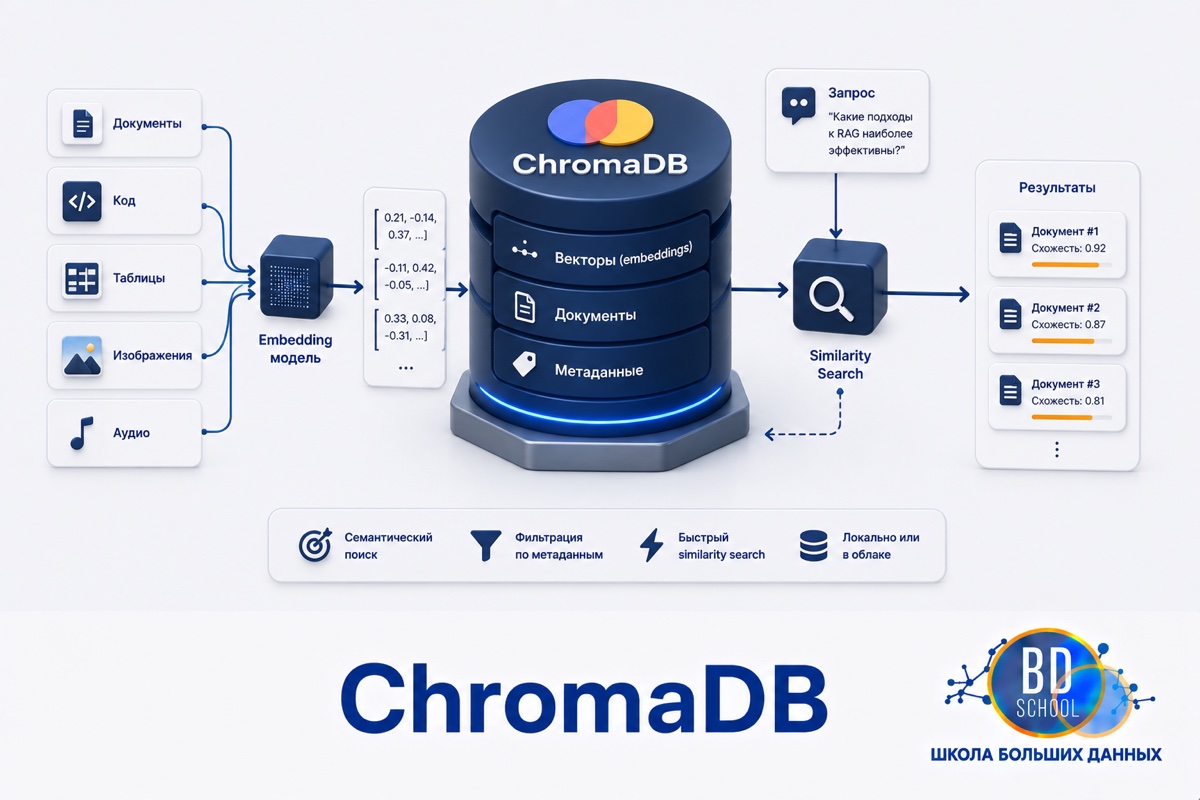
ChromaDB (Chroma) это открытая векторная база данных для поиска по смыслу, которая запускается прямо внутри процесса приложения и не требует отдельного сервера. Проект развивает компания Chroma, лицензия Apache 2.0, актуальная версия питоновского пакета 1.5.9 от 5 мая 2026 года. Chroma хранит документы вместе с их эмбеддингами и метаданными, а на запрос возвращает не точные совпадения, а ближайших соседей в векторном пространстве. Именно поэтому её чаще всего ставят под RAG-конвейеры и память ИИ-агентов, где нужно быстро достать пару релевантных фрагментов текста и подмешать их в промпт языковой модели.
Что такое ChromaDB и какую задачу он закрывает
Обычная СУБД отвечает на вопрос «найди строки, где поле равно значению». Векторная база отвечает на другой вопрос, а именно «найди записи, смысл которых ближе всего к моему запросу». Разница в механике поиска подробно разобрана в статье ИИ и векторные базы данных: как это работает?, здесь важно другое. ChromaDB отличается от коллег по цеху не алгоритмом, а порогом входа.
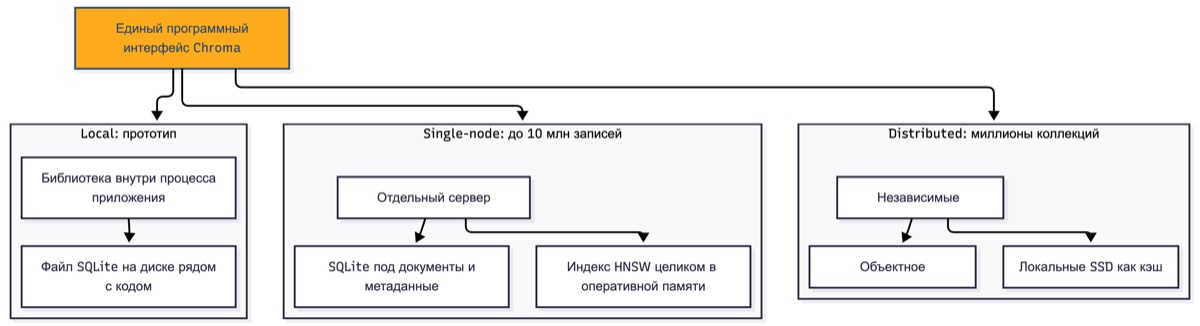
Большинство векторных хранилищ начинается с поднятия сервера или кластера. Chroma начинается со строчки pip install chromadb и объекта клиента в том же процессе, где живёт приложение. Данные при этом никуда не исчезают после перезапуска, потому что постоянный клиент пишет их на диск в файл SQLite рядом с кодом. Отдельного демона, конфигурации и портов на этом этапе нет вообще.
Второй важный момент касается эмбеддингов. Функция векторизации задаётся один раз на уровне коллекции, после чего Chroma сама вызывает её и при вставке документов, и при запросе. Разработчику не приходится вручную считать вектор запроса и следить, чтобы модель на записи и на чтении совпадала. Поддерживаются OpenAI, Cohere, Hugging Face, sentence-transformers, Ollama и десяток других провайдеров.
Архитектура ChromaDB и три режима развёртывания
Chroma сознательно отдаёт всё, что можно отдать, проверенным подсистемам. Долговечное хранение лежит на SQLite и облачном объектном хранилище, а собственный код занимается управлением данными и поиском. Такой подход даёт одинаковый программный интерфейс во всех режимах работы.
Local, single-node и distributed
Локальный режим это встроенная библиотека для прототипов и экспериментов, когда база живёт внутри приложения. Одноузловой режим поднимает отдельный сервер и рассчитан на нагрузки до десяти миллионов записей в нескольких коллекциях. Распределённый режим разносит компоненты по независимым сервисам и держит миллионы коллекций, его управляемый вариант называется Chroma Cloud. Код приложения при переходе между режимами меняется в одной строке, там где создаётся клиент.
Данные внутри любого режима разложены по трёхуровневой модели. Коллекция (collection) это базовая единица хранения и поиска, где каждая запись несёт идентификатор, вектор, необязательные метаданные и сам документ. Коллекции группируются в базы данных (databases), которые задают логическое пространство имён под окружение или приложение. На вершине стоит арендатор (tenant), обеспечивающий полную изоляцию доступа, квот и биллинга.
Пять компонентов под капотом
Независимо от режима Chroma состоит из пяти частей, и понимание их ролей объясняет, почему запись подтверждается быстрее, чем строится индекс.

- Шлюз (gateway). Точка входа для клиентского трафика, отвечает за аутентификацию, лимиты, квоты и валидацию запроса, после чего маршрутизирует его дальше.
- Журнал записи (log). Журнал упреждающей записи, куда операции попадают до подтверждения клиенту. Он же обеспечивает атомарность многозаписных операций и возможность воспроизведения.
- Исполнитель запросов (query executor). Отвечает за все чтения, держит смесь индексов в памяти и на диске, сверяется с журналом ради консистентного ответа.
- Компактор (compactor). Периодически читает журнал и строит новые версии векторных, полнотекстовых и метаданных индексов.
- Системная база (system database). Внутренний каталог арендаторов, баз, коллекций и версий индексов, работает поверх реляционной СУБД.
Ключевое следствие такой схемы в том, что запись подтверждается сразу после попадания в журнал, а индексы строятся асинхронно компактором. Поэтому вставка данных стоит дёшево, а тяжёлая работа откладывается на фоновый процесс.
Как работает поиск от документа до ближайших соседей
Полный цикл выглядит так. Текст документа уходит в функцию эмбеддинга и превращается в плотный числовой вектор фиксированной длины. Вектор вместе с идентификатором, метаданными и исходным текстом ложится в коллекцию. На запросе строка пользователя проходит через ту же функцию, а дальше исполнитель ищет в индексе k ближайших векторов по выбранной метрике расстояния.
Метрика задаётся только в момент создания коллекции. По умолчанию используется квадрат евклидова расстояния, а косинусную близость надо запросить явно параметром конфигурации. У существующей коллекции метрику поменять нельзя, придётся пересоздавать, и об этот угол спотыкаются регулярно.
Фильтры по метаданным и полнотекстовый поиск
Векторный поиск редко работает в одиночку. Chroma умеет отсекать записи по метаданным до того, как начнёт искать соседей, поддерживая операторы сравнения, вхождения в список и логические связки. Отдельно работает фильтрация по телу документа, где эмбеддинги не участвуют вообще, а идёт поиск подстроки или регулярного выражения. В ветке 1.5 к этому добавились массивы в метаданных с операторами вхождения, группировка результатов и гибридный поиск с объединением рангов по методу Reciprocal Rank Fusion.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Потолок одного узла и сколько записей влезает в память
Здесь начинается самое практичное. Chroma индексирует векторы форком библиотеки hnswlib, а алгоритм HNSW требует, чтобы индекс целиком лежал в оперативной памяти как для поиска, так и для обновления. Как только коллекция перерастает доступную память, операционная система начинает свопить, задержки вставки и запроса взлетают, и система быстро становится нерабочей. Раскладка индекса в памяти к свопу не приспособлена.
Разработчики Chroma замерили этот потолок на разных инстансах EC2, вставляя эмбеддинги до полного отказа системы. Для типовой нагрузки из векторов размерностью 1024, коротких документов и трёх полей метаданных зависимость оказалась линейной и описывается формулой N = R * 0.245, где N это максимальный размер коллекции в миллионах записей, а R это объём оперативной памяти в гигабайтах. Часть замеров из руководства по производительности одного узла сведена в таблицу.
| Инстанс | Память, ГБ | Примерный потолок коллекции | Средняя задержка запроса |
|---|---|---|---|
| r7i.2xlarge | 64 | 15 000 000 | 5 мс |
| t3.2xlarge | 32 | 7 500 000 | 5 мс |
| t3.xlarge | 16 | 3 600 000 | 4 мс |
| t3.large | 8 | 1 700 000 | 4 мс |
| t3.medium | 4 | 700 000 | 5 мс |
| t3.small | 2 | 250 000 | 8 мс |
Разворачивать Chroma на машине с памятью меньше двух гигабайт не рекомендуется вовсе. Дисковое пространство при этом почти никогда не становится узким местом, потому что база метаданных на SQLite спокойно уходит в терабайты и умеет страничную подкачку. Ограничителем становится именно индекс в памяти. Дробить одну большую коллекцию на несколько мелких смысла нет, поскольку производительность определяется суммарным числом эмбеддингов, а не их распределением по коллекциям.
Для массовой загрузки данных документация советует пачки размером от 50 до 250 записей. Пропускная способность растёт с размером пачки примерно до насыщения процессора около 150 записей, дальше выходит на плато, а вот вероятность таймаута на крупных пачках увеличивается.
Архитектура ML-систем
Код курса
ARML
Ближайшая дата курса
12 октября, 2026
Продолжительность
24/32 ак.часов
Стоимость обучения
76 800
Ядро на Rust и что дала версия 1.0
До апреля 2025 года Chroma была питоновской библиотекой со всеми вытекающими ограничениями. В версии 1.0 команда переписала ядро на Rust, сохранив полную совместимость программного интерфейса с предыдущими выпусками. Заявленный выигрыш составил трёх-пятикратное ускорение записи и запросов на наборе из миллиона эмбеддингов OpenAI размерностью 1536. Дополнительно исчезла блокировка глобального интерпретатора, поэтому обращаться к базе можно из любого числа питоновских потоков.
Практическое следствие видно уже при установке. Колесо пакета для macOS на ARM весит около 22 МБ и собрано инструментом maturin, то есть внутрь приезжает скомпилированный бинарник, а не питоновский исходник. Общее ядро между локальным и распределённым режимами дало ещё один эффект, а именно клиенты для JavaScript, Rust, Kotlin и Swift поверх одной и той же реализации.
Когда применять ChromaDB, а когда не стоит
Chroma хорошо ложится на прототипы RAG-систем, локальную разработку без внешних сервисов, память ИИ-агентов между запусками и небольшие продуктовые нагрузки, укладывающиеся в память одной машины. Отдельный плюс в том, что путь от ноутбука до облака не требует переписывания кода.
Отказаться стоит в нескольких ситуациях. Если корпус заведомо перерастает десятки миллионов векторов, а горизонтальное масштабирование нужно уже сейчас, разумнее сразу смотреть на распределённые решения. Если вектор это лишь одна колонка рядом с транзакционными данными, дешевле обойтись расширением pgvector для PostgreSQL и не заводить вторую систему хранения. Если требуются строгие транзакции и сложные соединения таблиц, векторная база тут вообще не помощник, потому что она про близость, а не про целостность.
Практика с локальными эмбеддингами через Ollama
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Соберём постоянную коллекцию с двенадцатью короткими документами о технологиях больших данных. Векторизацию выполняет локальная Ollama моделью nomic-embed-text, поэтому ключи и платные API не нужны.
# chromadb 1.5.9, ollama 0.32.13, модель nomic-embed-text (768 измерений).
# Прогнано на стенде 2026-08-24, Python 3.12.13, macOS 26.5.2 arm64.
import shutil
import time
from pathlib import Path

import chromadb
from chromadb.utils.embedding_functions import OllamaEmbeddingFunction

DB_PATH = Path(__file__).parent / "chroma_data"

# Чистим прошлый прогон, чтобы цифры вставки были честными, а не поверх старой коллекции.
if DB_PATH.exists():
    shutil.rmtree(DB_PATH)

# PersistentClient пишет на диск: SQLite под документы и метаданные, отдельный файл под индекс.
client = chromadb.PersistentClient(path=str(DB_PATH))

# Функция эмбеддинга живёт на уровне коллекции, Chroma вызовет её и на вставке, и на запросе.
ollama_ef = OllamaEmbeddingFunction(
    url="http://localhost:11434", model_name="nomic-embed-text"
)

# Имя коллекции проверяется строго, 3-512 символов из [a-zA-Z0-9._-].
collection = client.create_collection(
    name="bigdata_terms",
    embedding_function=ollama_ef,
    configuration={"hnsw": {"space": "cosine"}},  # по умолчанию используется l2
)

documents = [
    "Apache Kafka это распределённый лог сообщений с разбиением топиков на партиции.",
    "Apache Flink обрабатывает неограниченные потоки событий с состоянием и точным временем.",
    "Apache Airflow оркестрирует пакетные конвейеры данных в виде направленного ациклического графа.",
    "Apache Spark выполняет распределённые вычисления над датафреймами в памяти кластера.",
    "ClickHouse это колоночная СУБД для аналитических запросов по миллиардам строк.",
    "Greenplum это массивно-параллельная аналитическая база на основе PostgreSQL.",
    "Векторная база данных ищет ближайших соседей по косинусной близости эмбеддингов.",
    "HNSW строит многослойный граф соседей и даёт приближённый поиск за логарифмическое время.",
    "RAG подмешивает найденные фрагменты документов в промпт языковой модели.",
    "Эмбеддинг это плотный числовой вектор, который кодирует смысл текста.",
    "Debezium читает журнал транзакций базы и превращает изменения строк в поток событий.",
    "Iceberg хранит снимки таблицы в метаданных и даёт атомарные коммиты поверх озера данных.",
]

metadatas = [
    {"category": "streaming", "year": 2011, "level": "middle"},
    {"category": "streaming", "year": 2014, "level": "senior"},
    {"category": "orchestration", "year": 2014, "level": "junior"},
    {"category": "batch", "year": 2010, "level": "middle"},
    {"category": "olap", "year": 2016, "level": "middle"},
    {"category": "olap", "year": 2005, "level": "senior"},
    {"category": "ai", "year": 2019, "level": "junior"},
    {"category": "ai", "year": 2016, "level": "senior"},
    {"category": "ai", "year": 2020, "level": "middle"},
    {"category": "ai", "year": 2013, "level": "junior"},
    {"category": "cdc", "year": 2016, "level": "middle"},
    {"category": "lakehouse", "year": 2018, "level": "senior"},
]

ids = [f"doc_{i:02d}" for i in range(len(documents))]

# Вставка одной пачкой, документы уходят в журнал записи, эмбеддинги считает Ollama.
start = time.time()
collection.add(ids=ids, documents=documents, metadatas=metadatas)
insert_seconds = time.time() - start

print(f"документов в коллекции: {collection.count()}")
print(f"вставка {len(documents)} документов: {insert_seconds:.2f} с")
print(f"на документ: {insert_seconds / len(documents):.2f} с")

# Запрос текстом, Chroma сама векторизует строку той же функцией эмбеддинга.
start = time.time()
result = collection.query(
    query_texts=["как искать похожие тексты по смыслу"],
    n_results=3,
    include=["documents", "metadatas", "distances"],
)
query_seconds = time.time() - start

print(f"запрос выполнен за {query_seconds * 1000:.1f} мс")
for doc, meta, dist in zip(
    result["documents"][0], result["metadatas"][0], result["distances"][0]
):
    print(f"  {dist:.4f}  [{meta['category']}]  {doc}")

# Размерность вектора берём из самой коллекции, а не из головы.
peek = collection.get(ids=["doc_00"], include=["embeddings"])
print(f"размерность вектора: {len(peek['embeddings'][0])}")
Реальный вывод прогона выглядит следующим образом.
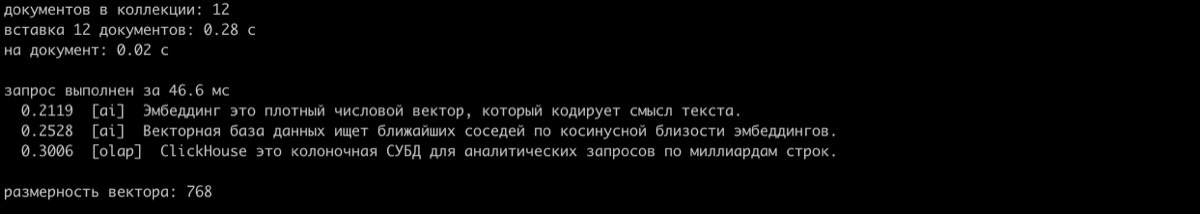
Третий результат заслуживает отдельного разговора. ClickHouse к запросу о смысловом поиске отношения не имеет, но всё равно попал в выдачу с расстоянием 0.3006. Приближённый поиск возвращает ровно k ближайших векторов и порога релевантности у него нет, поэтому отсекать мусор по значению расстояния приходится самому приложению. Вся база после прогона заняла на диске 568 КБ, из них 244 КБ пришлось на файл SQLite.
Второй скрипт открывает ту же папку заново и показывает три вида фильтрации, каждый из которых работает поверх уже готовой коллекции.
# chromadb 1.5.9, прогнано на стенде 2026-08-24.
# Коллекция bigdata_terms уже создана предыдущим скриптом и лежит на диске.
from pathlib import Path

import chromadb
from chromadb.utils.embedding_functions import OllamaEmbeddingFunction

client = chromadb.PersistentClient(path=str(Path(__file__).parent / "chroma_data"))
ollama_ef = OllamaEmbeddingFunction(
    url="http://localhost:11434", model_name="nomic-embed-text"
)
collection = client.get_collection(name="bigdata_terms", embedding_function=ollama_ef)
print(f"коллекция открыта заново, документов: {collection.count()}")

# Векторный поиск с предфильтром, Chroma сначала отсекает по where, потом ищет соседей.
res = collection.query(
    query_texts=["распределённая обработка данных"],
    n_results=3,
    where={"category": "ai"},
    include=["documents", "metadatas", "distances"],
)
for doc, meta, dist in zip(res["documents"][0], res["metadatas"][0], res["distances"][0]):
    print(f"  {dist:.4f}  [{meta['category']}/{meta['year']}]  {doc}")

# Составной фильтр, два условия через $and, диапазон через $gte, перечисление через $in.
res = collection.get(
    where={
        "$and": [
            {"year": {"$gte": 2014}},
            {"level": {"$in": ["middle", "senior"]}},
        ]
    },
    include=["documents", "metadatas"],
)
print(f"составной фильтр вернул: {len(res['ids'])}")

# Полнотекстовый фильтр по телу документа, эмбеддинги здесь не участвуют вообще.
res = collection.get(where_document={"$contains": "Apache"}, include=["documents"])
print(f"подстрока Apache найдена в документах: {len(res['ids'])}")
На прогоне первый блок вернул три записи категории ai с расстояниями от 0.2865 до 0.3462, составной фильтр отобрал 6 документов из 12, а поиск подстроки нашёл 4 документа со словом Apache. Разобраться, как такие механизмы встраиваются в конвейер извлечения для языковой модели, помогает курс ИИ агенты для оптимизации бизнес-процессов.
Заключение
ChromaDB закрывает нишу векторного хранилища с минимальным порогом входа, где база стартует внутри процесса приложения, сама векторизует документы и переживает перезапуск за счёт файла на диске. Переход на ядро Rust снял болячки питоновской реализации и открыл дорогу клиентам на других языках. Главное ограничение остаётся архитектурным, потому что индекс HNSW живёт в оперативной памяти и жёстко привязывает размер коллекции к объёму RAM на машине. Пока корпус укладывается в этот потолок, Chroma даёт задержку запроса в единицы миллисекунд и почти нулевые эксплуатационные расходы.
Референсные ссылки
- Chroma Architecture Overview, официальная документация о модели данных и режимах развёртывания
- Chroma Distributed Architecture, разбор пяти компонентов, путей чтения и записи
- Single-Node Performance, замеры лимитов по памяти и рекомендации по размеру пачки
- Пакет chromadb на PyPI, версии и даты выпусков
- Chroma is now 4x faster, анонс перехода ядра на Rust