
 57
Содержание
- Что такое LSM-Tree и зачем оно нужно
- Архитектура и ключевые компоненты LSM-дерева
- Memtable и Write-Ahead Log
- SSTable и уровни L0…Lmax
- Принцип работы LSM-дерева
- Путь записи
- Путь чтения
- Компакция, level, universal, FIFO
- Компромисс амплификации записи, чтения и пространства
- LSM-Tree vs B-tree
- Когда применять LSM-дерево и когда не стоит
- Практика
- Заключение
- Референсные ссылки
LSM дерево (LSM-tree) это структура данных для хранения пар ключ-значение, в которой новые записи сначала копятся в памяти, а на диск попадают уже отсортированными неизменяемыми файлами вместо изменения данных на месте. Расшифровывается название как Log-Structured Merge-Tree, термин восходит к статье Patrick E. O’Neil, Edward Cheng, Dieter Gawlick и Elizabeth J. O’Neil «The Log-Structured Merge-Tree (LSM-Tree)», журнал Acta Informatica, 1996 год. Сегодня LSM-дерево лежит в основе движков хранения RocksDB, LevelDB, Cassandra и большинства write-heavy NoSQL-СУБД, подробный разбор есть в статье блога школы «Под капотом NoSQL-СУБД: чем полезно LSM-дерево».
Что такое LSM-Tree и зачем оно нужно
Обычная база данных на B-tree (B-дерево) хранит записи в одном большом файле и при каждой вставке или обновлении меняет данные прямо на месте, то есть выполняет случайную запись на диск. Случайная запись даже на быстром SSD дороже последовательной, потому что каждое обращение требует собственной операции ввода-вывода. LSM-дерево решает задачу иначе, оно превращает поток случайных записей в последовательную запись, а разбор данных по правильным местам откладывает на фоновый процесс. По определению TiKV Deep Dive, документации распределённой транзакционной key-value СУБД TiKV, LSM-tree «хранит данные в двух или более отдельных компонентах, каждый из которых оптимизирован под свой уровень хранения».
За 2025 и 2026 годы, судя по заголовкам вышедших академических работ, в их числе arXiv «How to Grow an LSM-tree?», фокус материалов по теме сместился. Изначально LSM-дерево описывалось как одна стратегия компакции, современные работы рассматривают его уже как семейство конструкций с разными стратегиями компакции и активно исследуемыми расширениями, а именно разделением ключа и значения и обучаемыми индексами. Ядро идеи при этом не изменилось, запись всегда идёт последовательно и в память, а раскладку данных по уровням выполняет фоновый процесс.
Архитектура и ключевые компоненты LSM-дерева
По RocksDB Wiki Overview у LSM-дерева четыре ключевых компонента.
Memtable и Write-Ahead Log
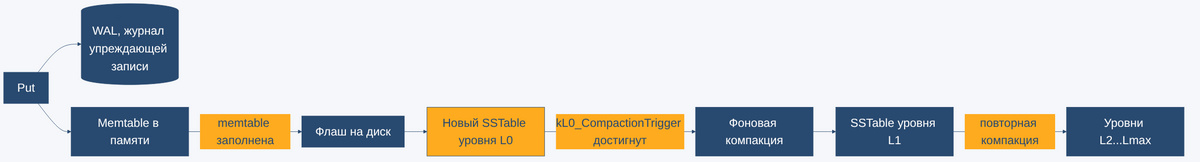
Новая запись сначала опционально дописывается в WAL (Write-Ahead Log, журнал упреждающей записи), последовательно растущий файл, а затем вставляется в memtable, отсортированную структуру в памяти. Если процесс упадёт до того, как memtable сбросится на диск, база восстановит потерянные записи, проиграв WAL заново. Для повышения пропускной способности записи движок может держать сразу несколько memtable одновременно, механизм называется memtable pipelining, пока одна ещё сбрасывается на диск, вторая уже принимает новые Put.
SSTable и уровни L0…Lmax
Когда объём memtable достигает предела, её содержимое сбрасывается на диск отдельным файлом SSTable (Sorted String Table, отсортированная неизменяемая таблица). Файлы организованы по уровням L0…Lmax. Уровень L0 получает файлы прямо из флаша memtable, поэтому диапазоны ключей соседних файлов L0 могут пересекаться. Уровень L1 собран фоновой компакцией из файлов L0, а каждый следующий уровень, компакцией предыдущего. Начиная с L1, внутри одного уровня диапазоны ключей файлов уже не пересекаются.
Это не абстракция, а наблюдаемый факт демо этой статьи на LevelDB 1.23_2. После записи 8000 ключей служебное свойство leveldb.sstables показало семь файлов level 0 с перекрывающимися диапазонами, например key00000003..key00007942 и key00000008..key00007988, тогда как единственный файл level 1 покрывал один несегментированный диапазон key00000000..key00007999. Отсюда прямо следует, почему чтение через L0 дороже, один Get обязан проверить каждый файл L0, диапазон которого может содержать искомый ключ, а на L1 и ниже достаточно одного файла.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Принцип работы LSM-дерева
Путь записи
Put сначала уходит в WAL, если журнал включён, затем вставляется в memtable. Когда объём memtable достигает write_buffer_size, движок сбрасывает её на диск новым файлом уровня L0. Демо write_read_path.py нарочно ставит маленький write_buffer_size, 32 KB, чтобы флаш происходил часто и рост числа файлов L0 был виден невооружённым глазом.
после 2000 записей: WAL=['000016.log', '000019.log'], SST-файлов=9, L0=5, L1=1
после 4000 записей: WAL=['000034.log', '000037.log'], SST-файлов=8, L0=4, L1=1
после 8000 записей: WAL=['000070.log', '000072.log'], SST-файлов=11, L0=7, L1=1
Число файлов L0 растёт не монотонно, оно то увеличивается новыми флашами, то падает, когда фоновая компакция успевает слить их в L1, поэтому в выводе видно 5, потом 4, потом снова 7. Порог, при котором LevelDB запускает компакцию L0 в L1, зафиксирован в исходном коде движка как kL0_CompactionTrigger и равен 4 файлам (db/dbformat.h в исходниках LevelDB), у RocksDB, форка LevelDB, есть эквивалентная опция level0_file_num_compaction_trigger, но её дефолтное значение отдельно не проверялось. Само срабатывание компакции асинхронно, поэтому реальное число файлов L0 в момент замера иногда успевает подняться выше порога, прежде чем фоновый поток компакции догонит очередь.
Путь чтения
Get идёт сверху вниз, сначала memtable, затем файлы L0, затем L1 и ниже. Поскольку диапазоны файлов L0 пересекаются, движку приходится заглядывать в каждый из них, если искомый ключ теоретически мог туда попасть, это read amplification (амплификация чтения) в чистом виде, число файлов L0 напрямую определяет, сколько лишних обращений к диску сделает один Get.
Демо измерило это напрямую. Пока в L0 лежало 7 файлов, 5 повторов чтения 500 ключей заняли 0.0324 с. После того как фоновая компакция слила L0 в L1 и число файлов L0 упало до 0, то же чтение заняло 0.0064 с.
L0 файлов во время замера: 7, время 5x500 Get: 0.0324 с
Ждём фоновую компакцию L0 -> L1...
L0 файлов после компакции: 0, время 5x500 Get: 0.0064 с
Отношение (до/после): 5.06x
Отношение неустойчиво между запусками, потому что фоновый поток компакции LevelDB не детерминирован по времени, при повторных прогонах наблюдался разброс 1.10x-5.06x. Направление эффекта при этом воспроизводится всегда, чтение после компакции быстрее чтения с большим числом файлов L0.
Компакция, level, universal, FIFO
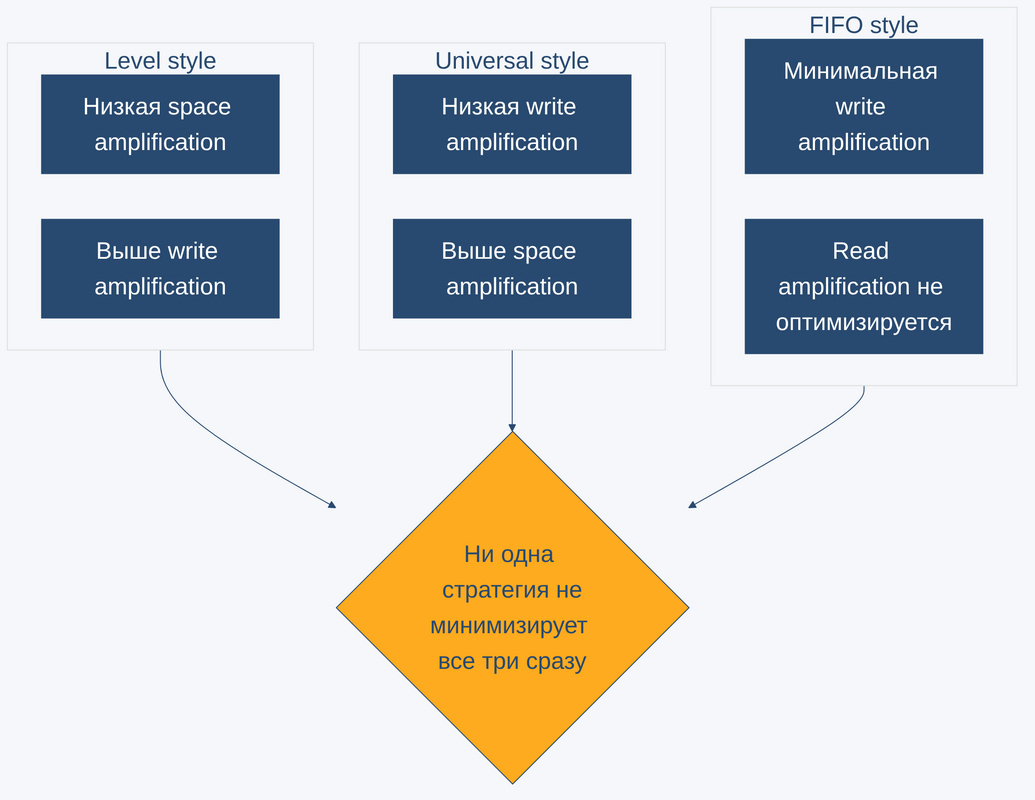
Компакция это фоновый процесс, который сливает несколько отсортированных SST-файлов в один, отбрасывая устаревшие версии перезаписанных и удалённых ключей. По официальному обзору RocksDB Wiki, у компакции есть три стратегии.
- Level style. Оптимизирует амплификацию пространства, данные организованы по уровням с растущим лимитом размера, каждый уровень компактится в следующий.
- Universal style. Минимизирует амплификацию записи ценой большего расхода пространства, файлы одного уровня сливаются реже и более крупными порциями.
- FIFO style. Просто удаляет старые файлы при превышении лимита общего размера, без пересортировки данных, подходит для кэш-подобных нагрузок, где старые данные не нужны вовсе.
Выбор стратегии это всегда компромисс между тремя видами амплификации, следующий раздел показывает его на измеренных числах.
Компромисс амплификации записи, чтения и пространства
У LSM-дерева есть фундаментальное ограничение, устройство хранения не может одновременно минимизировать все три вида амплификации, write amplification (амплификация записи), read amplification (амплификация чтения) и space amplification (амплификация пространства). Выигрыш по одной метрике достигается за счёт проигрыша по другой, а выбор стратегии компакции сдвигает баланс в нужную сторону.
| Стратегия компакции | Write amplification | Read amplification | Space amplification |
|---|---|---|---|
| Level | выше | ниже | минимальная, приоритет стратегии |
| Universal (tiered) | минимальная, приоритет стратегии | выше | выше |
| FIFO | минимальная, удаление без пересортировки | не оптимизируется целенаправленно | ограничена лимитом размера, старые данные просто отбрасываются |
Демо статьи измерило write и space amplification напрямую на LevelDB, восьмикратной перезаписи одного и того же набора из 5000 ключей.
По уровням Write(MB): [(0, 8), (1, 33), (2, 0)]
Суммарно физических байт записано компакцией: 42991616 (41 MB, округление leveldb.stats до целых MB)
Write amplification (физическая запись компакцией / логическая запись приложения): 5.09x

Отношение к логически записанному объёму: 0.201 (меньше 1.0 — компакция выбросила устаревшие версии перезаписанных ключей)
На каждый мегабайт логической записи диск в этом прогоне принял чуть больше пяти мегабайт физической записи, а итоговый размер базы на диске составил около 20% от суммы всех логических Put, потому что компакция выбросила промежуточные версии восемь раз перезаписанных ключей. Оба числа получены при compression=None, специально, чтобы увидеть чистый эффект компакции, не смешивая его со сжатием, в проде у LSM-движков сжатие обычно включено и дополнительно снижает объём на диске независимо от компакции.
LSM-Tree vs B-tree
B-tree (B-дерево) остаётся стандартом там, где важнее предсказуемое чтение, LSM-дерево выигрывает там, где важнее пропускная способность записи. По TiKV Deep Dive, у B+-дерева write amplification равна B, а read amplification оценивается как O(log_B N/B), тогда как у level-based LSM-дерева read amplification оценивается как Θ((log² N/B)/log k), а write amplification как Θ(k log_k N/B), где k, коэффициент роста размера между соседними уровнями.
| Аспект | B-tree | LSM-Tree |
|---|---|---|
| Запись | случайная, изменение на месте | последовательная, в memtable и WAL |
| Чтение одного ключа | один путь по дереву | потенциально несколько уровней, зависит от компакции |
| Основной компромисс | дороже запись, дешевле предсказуемое чтение | дешевле запись, дороже чтение и место на диске |
| Типичное применение | OLTP-СУБД с приоритетом на чтение | write-heavy NoSQL, key-value хранилища |
Простое правило выбора формулирует тот же источник, если чтение можно ускорить кэшем, а запись ускорить нечем, LSM-дерево предпочтительнее. Для сценариев, где чтение критично, а запись второстепенна, тот же источник прямо рекомендует B-дерево, потому что LSM-дерево платит за скорость записи более высокой амплификацией чтения.
Когда применять LSM-дерево и когда не стоит
Выбор между LSM-деревом и B-деревом определяется профилем нагрузки, а не одними лишь предпочтениями. LSM-дерево стоит выбирать в трёх типичных случаях.
- Write-heavy нагрузки. Логирование событий, метрики, тайм-серии, где новых записей на порядки больше, чем точечных обновлений.
- Key-value и wide-column хранилища. RocksDB, LevelDB, Cassandra и ScyllaDB используют LSM-дерево как основной движок хранения именно из-за пропускной способности записи.
- Встраиваемое хранилище внутри другого сервиса. LevelDB и RocksDB часто работают как embedded engine, не требуя отдельного сервера и сетевого протокола.
Не стоит выбирать LSM-дерево, когда чтение доминирует над записью и должно быть равномерно быстрым, например для точечных lookup по индексу в аналитических запросах, где непредсказуемая амплификация чтения из-за неполной компакции обернётся деградацией. Классическая реляционная OLTP-нагрузка с преобладанием точечных обновлений и предсказуемых чтений по-прежнему лучше ложится на B-дерево. Архитектурные решения для выбора движка хранения разбираются в курсе «Архитектура Данных».
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Практика
Демо построено на LevelDB 1.23_2 (Homebrew) через Python-обвязку plyvel 1.5.1, движок уже стоит на стенде школы и не требует поднятия отдельного сервера. Весь код статьи выложен на GitHub школы.
Первое демо, write_read_path.py, показывает путь записи и то, как число файлов L0 влияет на скорость чтения.
# LevelDB 1.23_2 (Homebrew) + snappy 1.2.2 + plyvel 1.5.1, python3.12, прогнано на стенде 2026-09-04
"""
Путь записи и путь чтения LSM-дерева на примере LevelDB.

Путь записи: Put -> WAL (.log) -> memtable (в памяти) -> при заполнении memtable
(write_buffer_size) флаш на диск отдельным SST-файлом уровня L0.

Путь чтения: Get идёт сверху вниз — сначала memtable, затем файлы L0 (могут
перекрываться по диапазону ключей, поэтому проверяются все), затем L1 и ниже
(диапазоны не пересекаются, нужен один файл на уровень). Чем больше
непрокомпакченных файлов L0, тем больше файлов заглядывает один Get —
это и есть read amplification на практике, а не только в асимптотике.
"""
import os
import random
import shutil
import time

import plyvel

DB_PATH = "/tmp/lsm_tree_demo_write_read"
WRITE_BUFFER_SIZE = 32 * 1024  # маленький специально, чтобы флаш случился быстро
VALUE_SIZE = 200
N_KEYS = 8000
PROBE_KEYS = 500
PROBE_REPEATS = 5


def list_db_files(path):
    """Раскладывает файлы каталога LevelDB по типу: WAL, SST, MANIFEST, прочее."""
    wal, sst, manifest, other = [], [], [], []
    for name in sorted(os.listdir(path)):
        if name.endswith(".log"):
            wal.append(name)
        elif name.endswith(".ldb") or name.endswith(".sst"):
            sst.append(name)
        elif name.startswith("MANIFEST"):
            manifest.append(name)
        else:
            other.append(name)
    return wal, sst, manifest, other


def num_files_at_level(db, level):
    return int(db.get_property(f"leveldb.num-files-at-level{level}".encode()))


def timed_gets(db, keys, repeats):
    t0 = time.perf_counter()
    for _ in range(repeats):
        for k in keys:
            db.get(k)
    return time.perf_counter() - t0


def main():
    shutil.rmtree(DB_PATH, ignore_errors=True)
    db = plyvel.DB(
        DB_PATH,
        create_if_missing=True,
        write_buffer_size=WRITE_BUFFER_SIZE,
        compression=None,  # без сжатия: файлы и байты на диске отражают только LSM-механику
    )

    print("=== ПУТЬ ЗАПИСИ ===")
    print("До записи:", list_db_files(DB_PATH))

    random.seed(7)
    value = bytes(random.getrandbits(8) for _ in range(VALUE_SIZE))
    keys = [f"key{i:08d}".encode() for i in range(N_KEYS)]
    random.shuffle(keys)  # случайный порядок ключей — иначе флаши сразу каскадом уедут на нижние уровни

    checkpoints = {N_KEYS // 4, N_KEYS // 2, N_KEYS}
    for i, k in enumerate(keys, start=1):
        db.put(k, value)
        if i in checkpoints:
            wal, sst, manifest, _ = list_db_files(DB_PATH)
            print(
                f"после {i} записей: WAL={wal}, SST-файлов={len(sst)}, "
                f"L0={num_files_at_level(db, 0)}, L1={num_files_at_level(db, 1)}"
            )

    print()
    print("=== СОСТОЯНИЕ УРОВНЕЙ СРАЗУ ПОСЛЕ ЗАПИСИ (leveldb.sstables) ===")
    print(db.get_property(b"leveldb.sstables").decode())

    print("=== ПУТЬ ЧТЕНИЯ: read amplification от количества файлов L0 ===")
    probe_keys = keys[:PROBE_KEYS]
    l0_before = num_files_at_level(db, 0)
    t_before = timed_gets(db, probe_keys, PROBE_REPEATS)
    print(f"L0 файлов во время замера: {l0_before}, время {PROBE_REPEATS}x{PROBE_KEYS} Get: {t_before:.4f} с")

    print("Ждём фоновую компакцию L0 -> L1...")
    for _ in range(80):
        time.sleep(0.1)
        if num_files_at_level(db, 0) <= 1:
            break
    l0_after = num_files_at_level(db, 0)

    t_after = timed_gets(db, probe_keys, PROBE_REPEATS)
    print(f"L0 файлов после компакции: {l0_after}, время {PROBE_REPEATS}x{PROBE_KEYS} Get: {t_after:.4f} с")
    print(f"Отношение (до/после): {t_before / t_after:.2f}x")

    db.close()
    shutil.rmtree(DB_PATH, ignore_errors=True)


if __name__ == "__main__":
    main()
Второе демо, write_amplification.py, восемь раз перезаписывает один и тот же набор ключей и считает write и space amplification по служебному свойству leveldb.stats.
# LevelDB 1.23_2 (Homebrew) + snappy 1.2.2 + plyvel 1.5.1, python3.12, прогнано на стенде 2026-09-04
"""
Write amplification и space amplification компакции LSM-дерева на примере LevelDB.

Сценарий: один и тот же набор ключей перезаписывается несколько раз (типичный
паттерн для key-value хранилища — обновления, а не только вставки). Каждая
перезапись физически лежит в новом SST-файле, пока фоновая компакция не сольёт
уровни и не выбросит устаревшие версии ключа.

leveldb.stats после серии записей даёт кумулятивные Read(MB)/Write(MB) по каждому
уровню за счёт компакций (не считая изначальный флаш memtable->L0, он тоже
попадает в строку уровня 0). Сумма Write(MB) по всем уровням — это физические
байты, ушедшие на диск сверх одного логического Put. Отношение этой суммы к
логическому объёму записи приложением — write amplification.

compression=None специально: цель — увидеть чистый эффект компакции, не смешивая
его с эффектом сжатия (снижает объём независимо от компакции и исказил бы ratio).
"""
import os
import random
import shutil

import plyvel

DB_PATH = "/tmp/lsm_tree_demo_write_amp"
WRITE_BUFFER_SIZE = 64 * 1024
VALUE_SIZE = 200
N_KEYS = 5000
UPDATES = 8  # сколько раз перезаписываем весь набор ключей


def parse_stats(stats_text):
    """Разбирает таблицу leveldb.stats в список (level, write_mb) по непустым строкам уровней."""
    rows = []
    for line in stats_text.splitlines():
        parts = line.split()
        if len(parts) == 6 and parts[0].isdigit():
            level, files, size_mb, time_s, read_mb, write_mb = parts
            rows.append((int(level), int(write_mb)))
    return rows


def dir_size_bytes(path):
    total = 0
    for name in os.listdir(path):
        fp = os.path.join(path, name)
        if os.path.isfile(fp):
            total += os.path.getsize(fp)
    return total


def main():
    shutil.rmtree(DB_PATH, ignore_errors=True)
    db = plyvel.DB(
        DB_PATH,
        create_if_missing=True,
        write_buffer_size=WRITE_BUFFER_SIZE,
        compression=None,
    )

    random.seed(42)
    value = bytes(random.getrandbits(8) for _ in range(VALUE_SIZE))
    keys = [f"key{i:08d}".encode() for i in range(N_KEYS)]

    logical_bytes = 0
    for update_round in range(UPDATES):
        random.shuffle(keys)  # порядок перемешиваем, чтобы не спамить одну и ту же соседнюю область
        for k in keys:
            db.put(k, value)
            logical_bytes += len(k) + len(value)

    print(f"=== ПРИЛОЖЕНИЕ ЛОГИЧЕСКИ ЗАПИСАЛО {logical_bytes} БАЙТ ({UPDATES} перезаписей x {N_KEYS} ключей) ===")

    stats_text = db.get_property(b"leveldb.stats").decode()
    print("--- leveldb.stats ---")
    print(stats_text)

    rows = parse_stats(stats_text)
    total_compaction_write_mb = sum(write_mb for _, write_mb in rows)
    total_compaction_write_bytes = total_compaction_write_mb * 1024 * 1024

    print("По уровням Write(MB):", rows)
    print(f"Суммарно физических байт записано компакцией: {total_compaction_write_bytes} "
          f"({total_compaction_write_mb} MB, округление leveldb.stats до целых MB)")

    if total_compaction_write_bytes > 0:
        write_amp = total_compaction_write_bytes / logical_bytes
        print(f"Write amplification (физическая запись компакцией / логическая запись приложения): {write_amp:.2f}x")
    else:
        print("Компакция ещё не отработала на этом объёме — write amplification не измерен.")

    final_disk_bytes = dir_size_bytes(DB_PATH)
    space_ratio = final_disk_bytes / logical_bytes
    print()
    print(f"=== ИТОГОВЫЙ РАЗМЕР НА ДИСКЕ ПОСЛЕ КОМПАКЦИИ: {final_disk_bytes} байт ===")
    print(f"Отношение к логически записанному объёму: {space_ratio:.3f} "
          "(меньше 1.0 — компакция выбросила устаревшие версии перезаписанных ключей)")

    db.close()
    shutil.rmtree(DB_PATH, ignore_errors=True)


if __name__ == "__main__":
    main()
Шаги запуска и типовые грабли, например обязательный флаг -fno-rtti при сборке plyvel против LevelDB 1.23, разобраны в RUNBOOK.md рядом с демо-кодом. Полный вывод обоих скриптов с этого прогона показан выше по тексту статьи.
Заключение
LSM-дерево ускоряет запись тем, что откладывает разбор данных по месту на фоновый процесс компакции, и платит за это амплификацией чтения и пространства, которую нельзя убрать полностью, только сдвинуть в сторону нужной метрики выбором стратегии компакции. Демо на LevelDB подтвердило оба конца компромисса числами: чтение ускорялось в 1.10-5.06 раза (разброс из-за недетерминированного тайминга фоновой компакции) после того, как компакция слила файлы L0, а запись обошлась дороже логического объёма стабильно в 5.09 раза той же компакцией. Для write-heavy нагрузок и key-value хранилищ это работающий обмен, для read-heavy OLTP-сценариев с предсказуемым чтением B-дерево остаётся более простым и предсказуемым выбором.