
 18
Содержание
- Что такое LevelDB
- Архитектура и ключевые компоненты
- Log-файл, memtable, SSTable
- MANIFEST и CURRENT
- Принцип работы
- Путь записи и путь чтения
- Compaction между уровнями
- Восстановление после сбоя
- Компромиссы LSM-дерева между write, read и space amplification
- Как RocksDB развила архитектуру LevelDB дальше
- Сценарии использования и отличительные черты
- Практика работы с LevelDB из Python через plyvel
- Заключение
- Референсные ссылки
LevelDB — это встраиваемая (embedded) key-value библиотека на основе LSM-дерева (Log-Structured Merge-tree), которую в Google написали Sanjay Ghemawat и Jeff Dean (Санджай Гемават и Джефф Дин) для быстрого упорядоченного хранения пар ключ-значение внутри одного процесса. У LevelDB нет сервера и сетевого протокола, она подключается к приложению как обычная библиотека и живёт в его памяти и на его диске. Из этой архитектуры выросли десятки встраиваемых движков хранения, самый известный из которых, RocksDB, разбирается ниже отдельным разделом.
Что такое LevelDB
По README проекта, LevelDB это библиотека, которая обеспечивает упорядоченное отображение строковых ключей в строковые значения (an ordered mapping from string keys to string values). Это не сервер СУБД, а линкуемая в процесс приложения библиотека на C++, обращение к базе идёт вызовом функций Put, Get и Delete, а не запросом по сети. Такой класс решений называют embedded-базой данных.
Задача, которую решает LevelDB, это быстрая упорядоченная запись и точечное чтение пар ключ-значение локально, без затрат на сетевой протокол, парсинг SQL и координацию нескольких клиентов. За упорядоченность и скорость записи отвечает LSM-дерево (Log-Structured Merge-tree), структура данных, которая копит изменения в памяти и последовательно сбрасывает их на диск вместо того, чтобы переписывать файлы на месте, как это делают B-деревья классических СУБД.
Архитектура и ключевые компоненты
Внутреннее устройство LevelDB подробно описано в документе doc/impl.md официального репозитория проекта на GitHub. Заголовочные файлы API прямо отражают архитектуру движка. db.h задаёт основной интерфейс базы, comparator.h отвечает за порядок сравнения ключей, write_batch.h описывает атомарные пакетные записи, а table.h и table_builder.h работают с sorted table (SSTable) на диске.
Log-файл, memtable, SSTable
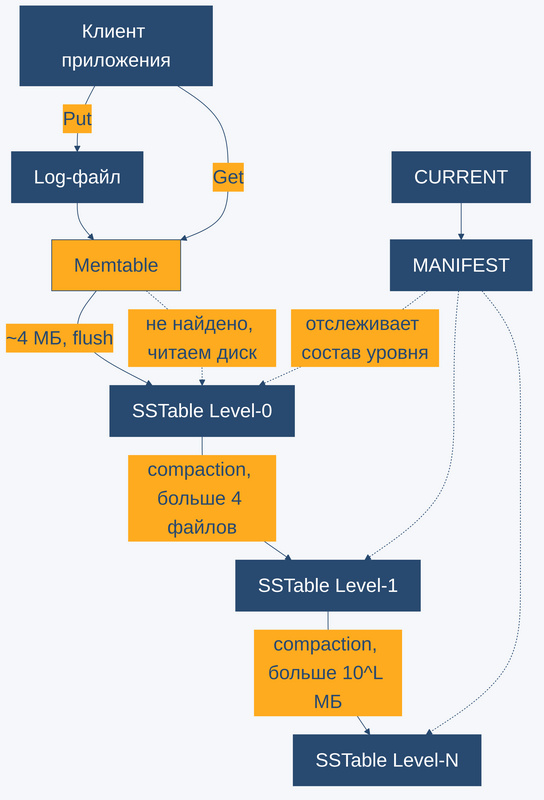
Log-файл (log file) это последовательный журнал, куда LevelDB сначала пишет каждое изменение. Одновременно то же изменение попадает в memtable, in-memory структуру данных, отсортированную по ключу для быстрого чтения без обращения к диску. Когда log-файл дорастает примерно до 4 МБ, его содержимое конвертируется в отсортированную таблицу (sorted table, SSTable) и переходит на самый молодой уровень Level-0. Файлы Level-0 могут пересекаться по диапазонам ключей, потому что формируются напрямую из memtable без предварительной сортировки между собой, а файлы Level-1 и выше уже не пересекаются, каждый следующий уровень собран compaction’ом из предыдущего.
MANIFEST и CURRENT
MANIFEST хранит список активных sorted tables на каждом уровне, диапазоны ключей внутри них и служебные метаданные, а файл CURRENT указывает, какой именно MANIFEST актуален прямо сейчас, потому что MANIFEST периодически пересоздаётся. Эта пара файлов и есть точка входа для восстановления состояния после перезапуска или сбоя, разбор которого дальше в разделе про принцип работы.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Принцип работы
Запись внутри LevelDB всегда идёт последовательно, а чтение опирается сначала на память и только потом на диск. Схема ниже сводит log-файл, memtable, уровни SSTable, compaction и пару MANIFEST/CURRENT в одну картину.
Путь записи и путь чтения
Путь записи (write path) устроен так. Новая пара ключ-значение сначала дописывается в конец log-файла, дешёвой последовательной операцией на диске, а не записью в случайное место, и тем же вызовом попадает в memtable в памяти. Когда log-файл достигает порога около 4 МБ, его содержимое конвертируется в SSTable и уходит на Level-0, а сам log-файл сменяется новым, пустым.
Путь чтения (read path) идёт в обратном порядке по свежести данных. Сначала опрашивается memtable, чтобы учесть изменения, ещё не сброшенные на диск, а затем поочерёдно проверяются уровни SSTable, начиная с Level-0, поэтому чтение всегда видит самую последнюю версию значения, даже если она физически ещё не долетела до диска.
Compaction между уровнями
Compaction это фоновый процесс, который сливает файлы соседних уровней и держит структуру LSM-дерева в рабочем состоянии. На Level-0 он запускается в Level-1, когда число файлов превышает 4, потому что пересекающийся по ключам уровень дорого читать. Для уровня L, начиная с первого, compaction запускается при превышении размера 10 в степени L мегабайт, то есть 10 МБ для Level-1, 100 МБ для Level-2 и так далее. Процесс берёт файл уровня L, все пересекающиеся с ним файлы уровня L+1, сливает их и пишет результат новыми файлами L+1 примерно по 2 МБ, попутно выбрасывая перезаписанные значения и устаревшие маркеры удаления.
На практике compaction работает настолько эффективно, что промежуточное состояние поймать сложно. Демонстрация на стенде, запись 50 000 пар по ~200 байт, около 10 МБ, не оставила файлов на Level-0 и Level-1, все 202 файла легли на Level-2 размером около 53 КБ каждый, как один flush memtable, а не выходной файл compaction (~2 МБ, см. ниже). leveldb.stats показывает нулевой Read(MB), файлы не читались и не сливались. LevelDB разместила их сразу на Level-2, минуя нижние уровни, а не провела каскадный compaction.
Восстановление после сбоя
При старте LevelDB читает файл CURRENT, определяет актуальный MANIFEST, восстанавливает по нему список sorted tables и проигрывает заново (replay) любой log-файл, который ещё не был сконвертирован в SSTable. Это делает библиотеку устойчивой к нечистому завершению процесса, потому что записи, попавшие в log-файл, переживают перезапуск даже без явного вызова close().
На стенде это проверено принудительно. Процесс-писатель, отправлявший запись каждые 10 миллисекунд, был убит сигналом SIGKILL примерно через секунду, exitcode=-9. После переоткрытия базы нашлось 78 записей, то, что писатель успел отправить за секунду до сигнала (лимит 500 записей недостижим за эту секунду). Ни одна отправленная запись не потерялась, всё в log-файле пережило нечистое завершение процесса.
Компромиссы LSM-дерева между write, read и space amplification
Архитектура из log-файла, memtable и каскада compaction не бесплатна. У LSM-деревьев есть три классических параметра, по которым их принято сравнивать между собой и с B-деревьями классических СУБД.
- Write amplification. Отношение объёма реально записанных на диск байт к объёму байт, которые попросило приложение. Каждая запись в LevelDB сначала уходит в log-файл, а затем ещё раз переписывается при каждом compaction, в котором участвует её SSTable.
- Read amplification. Число мест на диске, которые приходится проверить ради одного чтения. В LevelDB это memtable, потенциально несколько пересекающихся файлов на Level-0 и по одному файлу на каждом следующем уровне.
- Space amplification. Объём места на диске сверх размера актуальных данных. Старые версии значений и маркеры удаления физически остаются в SSTable, пока их не вычистит compaction.
LevelDB смещает этот баланс в сторону быстрой последовательной записи и терпит более дорогое чтение, поэтому она хорошо подходит там, где поток данных write-heavy, и хуже там, где нужны частые точечные чтения без прогретого кэша. Тот же компромисс на примере HBase и других NoSQL-СУБД разобран в статье блога «Под капотом NoSQL-СУБД: чем полезно LSM-дерево».
Как RocksDB развила архитектуру LevelDB дальше
LevelDB после релиза 1.23 в 2021 году развивается медленно, новых тегов в официальном репозитории с тех пор не выходило. Большая часть практического развития архитектуры ушла в RocksDB, который команда инженеров баз данных Facebook (ныне Meta) построила поверх кода LevelDB. RocksDB остаётся тем же классом решения, embedded key-value библиотекой на LSM-дереве, но добавляет к базовому механизму compaction несколько возможностей для серверной нагрузки и терабайтных объёмов.
| Критерий | LevelDB | RocksDB |
|---|---|---|
| Партиционирование ключевого пространства | Единое пространство ключей без встроенного разделения | Column Families, независимая настройка каждой и атомарная запись сразу в несколько партиций |
| Compaction | Один механизм, leveled compaction с фиксированными по формуле 10 в степени L МБ порогами | Многопоточный compaction, несколько стратегий, в том числе leveled и universal, с настраиваемыми порогами |
| Целевая нагрузка | Один процесс, компактные объёмы данных внутри приложения | Терабайтные объёмы, в том числе как движок хранения внутри серверных СУБД |
Column Families, партиции внутри одной базы с независимыми настройками compaction и атомарной записью сразу в несколько из них, лучше всего показывают, куда пошла архитектура. LevelDB такого партиционирования не имеет, у неё одно общее пространство ключей на всю базу, поэтому RocksDB стал выбором там, где нужно несколько логических хранилищ внутри одного процесса.
Сценарии использования и отличительные черты
LevelDB подходит там, где встроенному в приложение хранилищу нужен быстрый упорядоченный доступ по ключу, а полноценная СУБД избыточна. Итератор по диапазону, снапшоты и атомарные write batch делают библиотеку удобной как локальный слой персистентности внутри более крупной системы, а не как замену серверной базе данных для множества клиентов.
Документация прямо описывает и границы применимости. LevelDB не реляционная база, в ней нет SQL и вторичных индексов. Базу может держать открытой только один процесс за раз, параллельный доступ нескольких процессов к одному каталогу данных не поддерживается, а сама LevelDB не умеет отдавать данные по сети. Поэтому библиотека не подходит там, где к одному хранилищу должны параллельно обращаться разные процессы или сервисы, для такого сценария нужен сервер поверх неё или движок вроде RocksDB. Embedded key-value движки вроде LevelDB на практике часто изучают в связке с NoSQL-платформами данных, этому посвящён курс «Интеграция Hadoop и NoSQL».
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Практика работы с LevelDB из Python через plyvel
Весь код примеров ниже выложен в наш GitHub-репозиторий
Для Python к LevelDB чаще всего обращаются через биндинг plyvel. На стенде использованы LevelDB 1.23 (пакет Homebrew leveldb, версия 1.23_2), Python 3.12.13 и plyvel 1.5.1. Обычная установка pip install plyvel на LevelDB 1.23+ спотыкается дважды: заголовки Homebrew (leveldb/db.h) не попадают в путь компилятора, а LevelDB собрана без RTTI, тогда как plyvel линкует обвязку с RTTI, тогда сборка проходит, но импорт падает с ошибкой symbol not found in flat namespace. Решение это пересборка plyvel с явными CXXFLAGS/LDFLAGS на Homebrew-префиксы и -fno-rtti, шаги в RUNBOOK репозитория.
Первый файл, basic_operations.py, показывает Put/Get, атомарный write batch, снапшот для согласованного чтения и итерацию по диапазону ключей.
# plyvel 1.5.1 поверх LevelDB 1.23 (Homebrew), прогнано на стенде 2026-08-31
"""Базовые операции LevelDB через plyvel: Put/Get/Delete, атомарный write batch,
снапшот для консистентного чтения и итерация по диапазону ключей."""
import shutil

import plyvel

DB_PATH = "/tmp/leveldb_demo_basic"


def main():
    shutil.rmtree(DB_PATH, ignore_errors=True)
    db = plyvel.DB(DB_PATH, create_if_missing=True)

    # --- путь записи и чтения: Put/Get ---
    db.put(b"user:001", b"Alice")
    db.put(b"user:002", b"Bob")
    db.put(b"user:003", b"Carol")
    print("get user:002 =", db.get(b"user:002"))

    # --- атомарный write batch: несколько операций одной транзакцией ---
    # либо применяются все, либо ни одной — важно при сбое посреди записи
    with db.write_batch() as batch:
        batch.put(b"user:004", b"Dave")
        batch.delete(b"user:002")
    print("после batch: user:002 =", db.get(b"user:002"), ", user:004 =", db.get(b"user:004"))

    # --- снапшот: согласованное чтение на момент создания ---
    # снапшот не видит записи, сделанные после его создания, даже той же db-ручкой
    snapshot = db.snapshot()
    db.put(b"user:005", b"Erin")
    print("снапшот не видит user:005:", snapshot.get(b"user:005"))
    print("текущая db видит user:005:", db.get(b"user:005"))
    snapshot.close()

    # --- итерация по диапазону ключей (упорядоченность — ключевое свойство LevelDB) ---
    print("диапазон ключей user:001 .. user:004 (stop не включён):")
    for key, value in db.iterator(start=b"user:001", stop=b"user:004"):
        print(" ", key, value)

    db.close()
    shutil.rmtree(DB_PATH, ignore_errors=True)


if __name__ == "__main__":
    main()
Вывод прогона (run_output.txt, стенд от 31.08.2026) подтверждает описанное поведение.
# run_output.txt, стенд 2026-08-31, plyvel 1.5.1 / LevelDB 1.23_2
get user:002 = b'Bob'
после batch: user:002 = None , user:004 = b'Dave'
снапшот не видит user:005: None
текущая db видит user:005: b'Erin'
диапазон ключей user:001 .. user:004 (stop не включён):
  b'user:001' b'Alice'
  b'user:003' b'Carol'
Batch применил обе операции атомарно: user:002 пропал, user:004 появился. Снапшот, снятый до записи user:005, эту запись не видит, хотя текущая ручка db уже видит b’Erin’. Итератор вернул только user:001 и user:003, потому что user:002 к этому моменту удалён, а граница stop в результат не входит.
Второй файл, compaction_and_recovery.py, форсирует compaction маленьким write_buffer_size, а затем убивает процесс-писатель сигналом SIGKILL посреди записи и проверяет, что переживает переоткрытие базы.
# plyvel 1.5.1 поверх LevelDB 1.23 (Homebrew), прогнано на стенде 2026-08-31
"""Compaction между уровнями и восстановление после сбоя.

Часть 1 форсирует compaction маленьким write_buffer_size и показывает,
куда физически лёг SSTable-файл на каждом уровне.
Часть 2 убивает процесс-писатель SIGKILL посреди записи и проверяет,
что данные, попавшие в log-файл до этого момента, переживают сбой.
"""
import multiprocessing
import os
import shutil
import signal
import time

import plyvel

COMPACTION_DB_PATH = "/tmp/leveldb_demo_compaction"
CRASH_DB_PATH = "/tmp/leveldb_demo_crash"


def levels_snapshot(db, max_level=4):
    return {
        level: db.get_property(f"leveldb.num-files-at-level{level}".encode()).decode()
        for level in range(max_level)
    }


def demo_compaction():
    print("=== Compaction между уровнями ===")
    shutil.rmtree(COMPACTION_DB_PATH, ignore_errors=True)
    # маленький write_buffer_size (64 КБ вместо дефолтных 4 МБ), чтобы уложиться
    # в разумный объём данных и всё равно перейти пороги compaction из doc/impl.md
    db = plyvel.DB(COMPACTION_DB_PATH, create_if_missing=True, write_buffer_size=64 * 1024)

    t0 = time.time()
    for i in range(50_000):
        db.put(f"key{i:08d}".encode(), os.urandom(200))
    elapsed = time.time() - t0
    print(f"записано 50000 пар по ~200 байт (итого ~10 МБ) за {elapsed:.2f} с")

    print("файлов по уровням после записи:", levels_snapshot(db))
    print("db.get_property('leveldb.stats'):")
    print(db.get_property(b"leveldb.stats").decode())

    # 'leveldb.sstables' показывает физические файлы и диапазоны ключей внутри уровня
    sstables = db.get_property(b"leveldb.sstables").decode()
    print("первые строки leveldb.sstables (файл: размер [диапазон ключей]):")
    for line in sstables.splitlines()[:6]:
        print(" ", line)

    db.close()
    shutil.rmtree(COMPACTION_DB_PATH, ignore_errors=True)


def _crash_writer(path, n):
    db = plyvel.DB(path, create_if_missing=True)
    for i in range(n):
        db.put(f"k{i:06d}".encode(), b"v" * 50)
        time.sleep(0.01)
    # намеренно не вызываем db.close() — процесс убьют снаружи до этой строки


def demo_crash_recovery():
    print()
    print("=== Восстановление после сбоя ===")
    shutil.rmtree(CRASH_DB_PATH, ignore_errors=True)
    total = 500

    process = multiprocessing.Process(target=_crash_writer, args=(CRASH_DB_PATH, total))
    process.start()
    time.sleep(1.0)  # даём писателю проработать примерно секунду
    os.kill(process.pid, signal.SIGKILL)
    process.join()
    print(f"процесс-писатель убит SIGKILL, exitcode={process.exitcode}")

    # переоткрытие базы запускает восстановление: CURRENT -> MANIFEST -> replay log-файла
    db = plyvel.DB(CRASH_DB_PATH, create_if_missing=False)
    recovered = sum(1 for _ in db.iterator())
    print(f"после переоткрытия найдено записей: {recovered} из {total} (часть до момента убийства)")
    db.close()
    shutil.rmtree(CRASH_DB_PATH, ignore_errors=True)


if __name__ == "__main__":
    demo_compaction()
    demo_crash_recovery()
# run_output.txt, стенд 2026-08-31, plyvel 1.5.1 / LevelDB 1.23_2
=== Compaction между уровнями ===
записано 50000 пар по ~200 байт (итого ~10 МБ) за 3.42 с
файлов по уровням после записи: {0: '0', 1: '0', 2: '202', 3: '0'}
db.get_property('leveldb.stats'):
                               Compactions
Level  Files Size(MB) Time(sec) Read(MB) Write(MB)
--------------------------------------------------
  2      202       10         1        0        10

первые строки leveldb.sstables (файл: размер [диапазон ключей]):
  --- level 0 ---
  --- level 1 ---
  --- level 2 ---
   5:53189['key00000000' @ 1 : 1 .. 'key00000245' @ 246 : 1]
   7:53215['key00000246' @ 247 : 1 .. 'key00000491' @ 492 : 1]
   9:53214['key00000492' @ 493 : 1 .. 'key00000737' @ 738 : 1]

=== Восстановление после сбоя ===
процесс-писатель убит SIGKILL, exitcode=-9
после переоткрытия найдено записей: 78 из 500 (часть до момента убийства)
Все 50 000 записей легли в 202 файла Level-2 без чтения и слияния, LevelDB разместила их сразу на верхнем уровне. Строки leveldb.sstables показывают физические файлы и непересекающиеся диапазоны ключей. После SIGKILL нашлось 78 записей, без признаков потери переданных данных.
Заключение
LevelDB это компактная демонстрация того, как LSM-дерево решает задачу быстрой встроенной записи, и заодно ориентир по её ограничениям, среди них один процесс, отсутствие SQL и сетевого протокола. Сам проект с 2021 года почти не меняется, но заложенная архитектура, log-файл плюс memtable плюс каскад compaction по уровням, стала фундаментом для RocksDB и десятков других встраиваемых движков хранения.