
 9
Содержание
- Что такое Harness engineering и какую задачу он закрывает
- Из чего состоит harness агента
- Цикл агента и инструменты
- Контекст, память и мост между сессиями
- Песочница и проверяющие петли
- Как работает harness, цикл «действие, проверка, правка»
- Чем harness engineering отличается от prompt и context engineering
- Подводные камни harness engineering
- Когда применять и когда не стоит
- Практика, голая модель против минимального harness на Ollama
- Стенд Ollama в Docker
- Задача и тесты
- Голая модель
- Harness вокруг той же модели
- Результат прогона
- Заключение
- Референсные ссылки
Harness engineering (инженерия среды агента) это проектирование всего, что окружает языковую модель в ИИ-агенте, а именно цикла вызовов, набора инструментов, контекста и памяти, песочницы и проверок, которые возвращают модели результат её действий. Модель отвечает за то, что сказать, а harness решает, что она увидит, что ей разрешено сделать и как она узнает о своей ошибке. Практика выросла из опыта команд, которые строят агентов для написания кода, и опирается на их наблюдение. Качество агента часто меняется сильнее от правки среды вокруг модели, чем от смены самой модели.
Что такое Harness engineering и какую задачу он закрывает
Английское слово harness означает упряжь или обвязку, а в программной инженерии давно известен test harness, код, который запускает проверяемую систему и собирает результат. В мире агентов harness называют всю программную обвязку вокруг модели. В LangChain, компании-разработчике одноимённого фреймворка для LLM-приложений, Vivek Trivedy (Вивек Триведи) в марте 2026 года свёл это к формуле Agent = Model + Harness, где harness это весь код, конфигурация и логика исполнения, которые не являются самой моделью.
В феврале 2026 года словосочетание появилось в заголовках двух инженерных постов. OpenAI выпустила пост Harness engineering: leveraging Codex in an agent-first world о команде, которая строит продукт силами агента Codex, а 17 февраля Trivedy опубликовал разбор Improving Deep Agents with harness engineering. По данным LangChain, агент deepagents-cli на бенчмарке Terminal Bench 2.0 поднялся с 52.8% до 66.5% решённых задач, хотя модель gpt-5.2-codex всё это время оставалась той же. Менялись системный промпт, промежуточный слой middleware с проверкой перед завершением и детектором петли, а также бюджет рассуждений модели.
Сама практика старше названия. В ноябре 2025 года Justin Young (Джастин Янг) в инженерном блоге Anthropic описал harness для долгих агентов, которые пишут веб-приложение за десятки сессий. Задача у всех этих команд одна и та же. Модель умеет писать код и рассуждать, но без среды не знает, что сломала, забывает сделанное между сессиями и объявляет работу готовой раньше времени. Harness engineering закрывает эти провалы без дообучения модели.
Из чего состоит harness агента
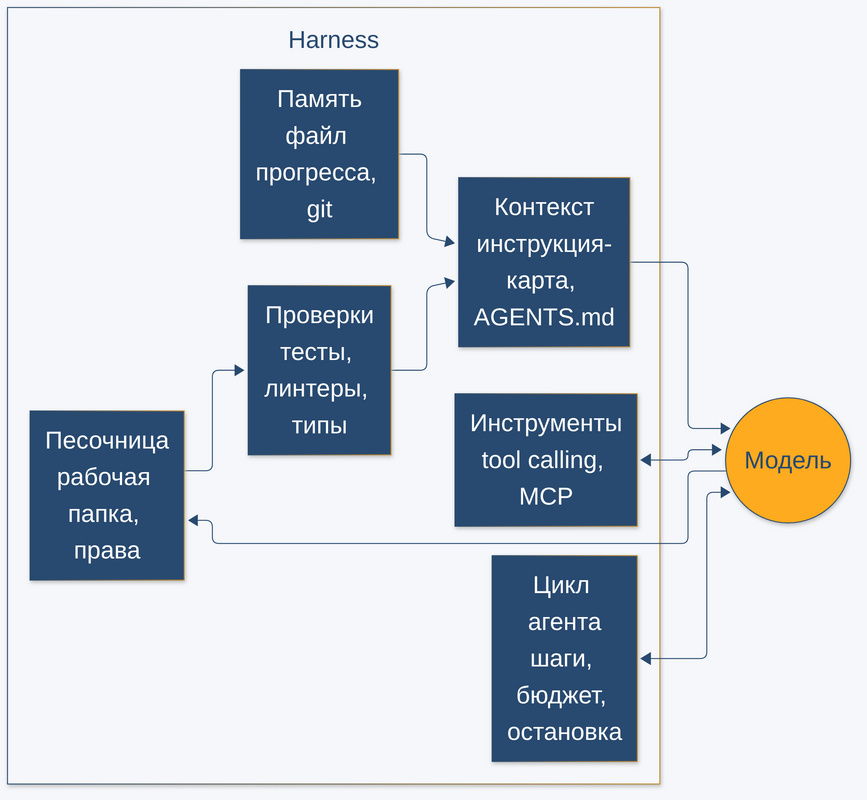
Единого стандарта на состав harness нет, официальных спецификаций памяти или песочницы как его частей тоже. Ниже то, что повторяется у Anthropic, LangChain и OpenAI. Как из таких частей складываются агентные системы, разобрано в статье блога об эволюции ИИ-агентов и топологиях LLM-процессов.
Цикл агента и инструменты
Цикл агента (agent loop) это внешняя программа, которая раз за разом вызывает модель, исполняет запрошенные ею действия и дописывает результат в историю сообщений. Именно цикл держит бюджет, то есть потолок шагов, токенов и времени, и решает, когда остановиться. Инструменты (tools) это функции, которые модель вызывает через механизм tool calling. От формулировок в схеме инструмента зависит, поймёт ли модель, когда он нужен. Внешние инструменты подключают и по протоколу MCP (Model Context Protocol), но какие из них открыть агенту, решает harness.
Контекст, память и мост между сессиями
Контекст это всё, что модель видит на текущем шаге. Системная инструкция, файлы проекта, результаты инструментов и история шагов делят одно окно, и лишнее вытесняет нужное. В переводной статье на Хабре о границе между context и harness engineering советуют держать AGENTS.md, файл с инструкциями для агента в корне репозитория, коротким оглавлением примерно на сотню строк, а подробности отдавать агенту по запросу через инструменты.
Память нужна, когда работа не помещается в одну сессию. Anthropic в своём harness для долгих агентов разделил роли. Первая сессия, initializer agent, готовит среду, а именно скрипт запуска init.sh, файл прогресса claude-progress.txt, первый git-коммит и JSON-список фич, где в примере больше 200 пунктов и все изначально помечены непройденными. Каждая следующая сессия, coding agent, читает git log и файл прогресса, берёт одну фичу, проверяет её и коммитит. Менять в списке фич агенту разрешено только поле passes, удалять или править сами тесты запрещено. Файл прогресса и история коммитов становятся мостом между сессиями.
Песочница и проверяющие петли
Песочница (sandbox) ограничивает, где агент читает и пишет и какие команды запускает. Проверяющие петли (feedback loops) возвращают модели объективный результат её действий. Это тесты, линтеры, проверка типов, сборка, скриншот страницы в браузере. В той же статье на Хабре эту механику называют обратным давлением (backpressure). Без неё агент оценивает свою работу сам и, как отмечает Anthropic, охотно помечает фичу готовой без сквозной проверки.
Как работает harness, цикл «действие, проверка, правка»
Работа агента в harness идёт по кругу. Модель получает задачу и контекст, выбирает действие, harness исполняет его в песочнице и возвращает результат. Если действие изменило код, harness сам прогоняет проверки и отдаёт модели не весь лог, а выжимку, то есть сколько тестов прошло, какие упали и хвост сообщений об ошибках. Затем модель делает следующий шаг, и так до прохождения проверок или исчерпания бюджета.
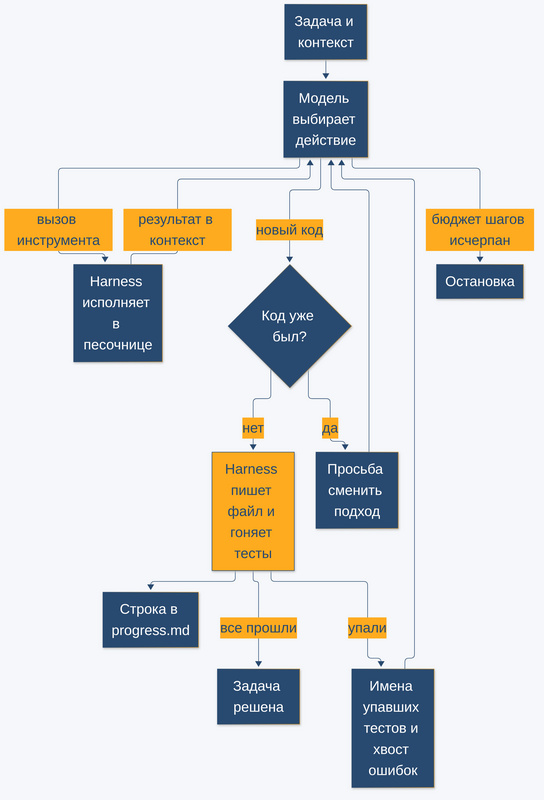
Ключевая деталь в том, кто запускает проверку. Если тесты гоняет сам harness после каждой правки, модель не может их пропустить или забыть. В демо ниже инструкция прямо говорит модели, что тесты прогоняются автоматически, и локальные модели qwen2.5:7b и llama3.1:8b ни разу не вызвали инструмент run_tests сами, все их вызовы были чтением файлов. Проверка сработала только потому, что её запускал harness. Второй важный элемент это защита от петли. Модель, получившая ту же ошибку, нередко присылает тот же код снова, и без детектора повтора harness тратит шаги на прогон уже проверенного варианта.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Чем harness engineering отличается от prompt и context engineering
Три практики вложены друг в друга. Путаница между ними начинается с того, что все три меняют поведение одной и той же модели без дообучения, но работают на разном масштабе.
| Практика | Что проектируют | Единица работы | Чем меряют успех |
|---|---|---|---|
| Prompt engineering | Текст запроса и системной инструкции | Один вызов модели | Качество одного ответа |
| Context engineering | Что попадает в окно контекста на каждом шаге, а именно документы, история, результаты инструментов | Один шаг агента | Полнота и релевантность контекста при ограниченном окне |
| Harness engineering | Цикл, инструменты, память, песочница, проверки, бюджет | Вся задача до проверенного результата | Доля задач, доведённых до прохождения проверок |
Таким образом, prompt engineering остаётся частью context engineering, а оба входят в harness как его слои. Хороший промпт не спасёт агента, которому нечем проверить свою работу, а аккуратно собранный контекст бесполезен, если цикл обрывается на первом же неудачном шаге.
Подводные камни harness engineering
Большинство проблем harness заметны не сразу, потому что агент продолжает работать, просто хуже. Чаще других встречаются четыре:
- Раздутый AGENTS.md. Инструкция на тысячи строк съедает окно контекста и прячет важное среди второстепенного. Поэтому вместо энциклопедии агенту дают карту со ссылками на подробности.
- Мало проверок. Если результат оценивает только сама модель, она объявляет задачу решённой при частичном результате. Anthropic называет это одним из основных режимов отказа долгих агентов.
- Harness под одну модель. Формулировки инструкции, формат правки и потолки токенов, подобранные под одну модель, на другой дают иной эффект, и демо ниже это показывает на двух моделях.
- Молчаливые сбои среды. Ошибка в самом harness выглядит как плохая работа модели. На прогоне Ollama 0.40.13, локальный сервер для запуска открытых моделей, молча выбрасывала вызов инструмента с многострочным кодом в JSON-аргументе, и за восемь шагов обе модели не внесли ни одной правки.
Поэтому harness отлаживают как обычный код, с трассой шагов и сравнением против голой модели.
Когда применять и когда не стоит
Harness engineering окупается там, где у задачи есть объективный критерий готовности и она не решается одним ответом модели. Типичные примеры это агенты для кода с тестами, разработка, растянутая на много сессий, агенты обработки данных со сверкой схемы и результатов, а также сценарии, где модель вызывает внешние системы и ошибка стоит дорого. Anthropic прямо оговаривает, что свой harness настраивал под full-stack веб-разработку, а перенос подхода на научные задачи или финансовое моделирование пока остаётся предположением.
Строить harness не стоит для разовых запросов, где хватает одного хорошего промпта, и для задач без проверяемого результата. Если правильность ответа может оценить только человек, петля обратной связи вырождается в ту же самооценку модели, и сложность цикла не окупается. Как собирать агентов с инструментами, отлаживать их и выводить в эксплуатацию, разбирают на курсе ИИ-агенты для оптимизации бизнес-процессов.
Архитектура ML-систем
Код курса
ARML
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24/32 ак.часов
Стоимость обучения
76 800
Практика, голая модель против минимального harness на Ollama
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо сравнивает одну и ту же локальную модель в двух режимах на одной задаче. Голая модель получает заготовку функции и тесты одним сообщением и отвечает один раз. Та же модель в harness работает циклом до 8 шагов и получает результат тестов после каждой правки. Модели qwen2.5:7b и llama3.1:8b запускались в Ollama 0.40.13 на Ubuntu 24.04 с 4 vCPU без GPU, демо написано только на стандартной библиотеке Python 3.12.
Стенд Ollama в Docker
Файл docker-compose.yml поднимает Ollama с лимитом памяти 10 ГБ. Переменная OLLAMA_MAX_LOADED_MODELS держит в памяти одну модель, потому что Ollama в контейнере видит память хоста, а не лимит контейнера, и на прогоне при смене модели ядро завершило её процесс по нехватке памяти. Переменная добавлена после этого сбоя, поэтому с ней снят только перезапуск голой llama3.1:8b, а три остальных прогона шли без неё.
# ollama 0.40.13 в Docker, стенд для статьи про Harness engineering, проверено на стенде 2026-11-05
services:
  ollama:
    image: ollama/ollama:0.40.13
    container_name: harness-ollama
    # 7-8B модели в q4 занимают около 5 ГБ, плюс KV-кэш на num_ctx 8192
    mem_limit: 10g
    environment:
      # Ollama видит память хоста, а не лимит контейнера: две модели сразу
      # не влезают в 10 ГБ, и ядро убивает llama-server по OOM
      OLLAMA_MAX_LOADED_MODELS: "1"
    ports:
      - "127.0.0.1:11434:11434"
    volumes:
      - ./ollama:/root/.ollama
Стенд поднимается и проверяется тремя группами команд, причём заготовка без реализации должна валить все 13 тестов.
# ollama 0.40.13 в Docker, Python 3.12.3, проверено на стенде 2026-11-05
# поднять Ollama и скачать обе модели
docker compose up -d
docker exec harness-ollama ollama pull qwen2.5:7b
docker exec harness-ollama ollama pull llama3.1:8b
docker exec harness-ollama ollama list
# заготовка без реализации: все 13 тестов падают с NotImplementedError
cd task && python3 -m unittest -q test_duration 2>&1 | tail -1; cd ..
Задача и тесты
Агент реализует функцию parse_duration, которая переводит строку вида 1h 30m в секунды. В описании функции заданы регистр, дробные числа, порядок единиц и ошибки на неверный ввод, а 13 тестов проверяют каждое из этих правил. Файл duration.py содержит только заготовку.
# задача для агента: заготовка без реализации, Python 3.12 stdlib, проверено на стенде 2026-11-05


def parse_duration(text: str) -> int:
    """Переводит строку длительности в целое число секунд.

    Формат: одна или несколько пар «число + единица», единицы d, h, m, s.
    - регистр единиц не важен: "1H" то же, что "1h";
    - пробелы между парами допустимы: "1h 30m";
    - число может быть дробным: "1.5h" -> 5400, итог округляется вниз до целого;
    - каждая единица встречается не больше одного раза, порядок строго d, h, m, s;
    - пустая строка, неизвестная единица, число без единицы, нарушение порядка
      или повтор единицы -> ValueError.
    """
    raise NotImplementedError
Файл test_duration.py агенту доступен для чтения, но перезаписать его harness не даёт.
# тесты задачи, unittest из stdlib Python 3.12, проверено на стенде 2026-11-05; агенту их менять нельзя
import unittest

from duration import parse_duration


class ParseDurationTest(unittest.TestCase):
    def test_seconds(self):
        self.assertEqual(parse_duration("45s"), 45)

    def test_minutes(self):
        self.assertEqual(parse_duration("2m"), 120)

    def test_days(self):
        self.assertEqual(parse_duration("1d"), 86400)

    def test_combined(self):
        self.assertEqual(parse_duration("1h30m"), 5400)

    def test_spaces(self):
        self.assertEqual(parse_duration("1h 30m 15s"), 5415)

    def test_case_insensitive(self):
        self.assertEqual(parse_duration("1H"), 3600)

    def test_fraction(self):
        self.assertEqual(parse_duration("1.5h"), 5400)

    def test_fraction_floor(self):
        self.assertEqual(parse_duration("2.75s"), 2)

    def test_empty(self):
        with self.assertRaises(ValueError):
            parse_duration("")

    def test_number_without_unit(self):
        with self.assertRaises(ValueError):
            parse_duration("10")

    def test_unknown_unit(self):
        with self.assertRaises(ValueError):
            parse_duration("10x")

    def test_wrong_order(self):
        with self.assertRaises(ValueError):
            parse_duration("30m1h")

    def test_repeated_unit(self):
        with self.assertRaises(ValueError):
            parse_duration("1h1h")


if __name__ == "__main__":
    unittest.main()
Голая модель
Скрипт bare.py делает один вызов /api/chat с temperature 0 и фиксированным seed, достаёт из ответа последний блок кода и прогоняет тесты во временной копии задачи. Результат проверки к модели не возвращается.
# Python 3.12 stdlib, ollama 0.40.13, модели qwen2.5:7b и llama3.1:8b, прогнано на стенде 2026-11-05
"""Голая модель без harness: один запрос, один ответ, тесты гоняем только для оценки.

Модель видит ту же заготовку и те же тесты, что и агент в harness.py, но результат
проверки к ней не возвращается: что написала с первого раза, то и засчитано.
"""
import json
import os
import re
import shutil
import subprocess
import sys
import tempfile
import time
import urllib.request
from pathlib import Path

OLLAMA = os.environ.get("OLLAMA_URL", "http://localhost:11434")
MODEL = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:7b"
TASK_DIR = Path(__file__).resolve().parent / "task"


def chat(messages):
    # один вызов /api/chat; temperature 0 и seed, чтобы прогон повторялся
    body = {"model": MODEL, "messages": messages, "stream": False,
            "options": {"temperature": 0, "seed": 42, "num_ctx": 8192, "num_predict": 900}}
    req = urllib.request.Request(f"{OLLAMA}/api/chat", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=900) as resp:
        return json.load(resp)["message"]


def run_tests(workdir):
    # тот же unittest, что и в harness.py, с таймаутом на случай зависшего кода
    proc = subprocess.run([sys.executable, "-m", "unittest", "-q", "test_duration"],
                          cwd=workdir, capture_output=True, text=True, timeout=30)
    out = proc.stdout + proc.stderr
    total = int(m.group(1)) if (m := re.search(r"Ran (\d+) test", out)) else 0
    bad = sum(int(x) for x in re.findall(r"(?:failures|errors)=(\d+)", out))
    return total - bad, total, out


def main():
    workdir = Path(tempfile.mkdtemp(prefix="bare_"))
    shutil.copytree(TASK_DIR, workdir, dirs_exist_ok=True)
    stub = (workdir / "duration.py").read_text()
    tests = (workdir / "test_duration.py").read_text()

    prompt = ("Реализуй функцию parse_duration в файле duration.py так, чтобы прошли тесты.\n"
              "Верни полный текст duration.py одним блоком ```python,\n"
              "без пояснений и без docstring.\n\n"
              f"duration.py:\n```python\n{stub}```\n\ntest_duration.py:\n```python\n{tests}```")
    t0 = time.time()
    answer = chat([{"role": "user", "content": prompt}])["content"]
    elapsed = time.time() - t0

    # достаём код из ответа; если блока нет, считаем ответом весь текст
    blocks = re.findall(r"```(?:python|py)?\s*\n(.*?)```", answer, re.S)
    (workdir / "duration.py").write_text(blocks[-1] if blocks else answer)

    passed, total, out = run_tests(workdir)
    print(f"модель: {MODEL}")
    print(f"вызовов модели: 1, время: {elapsed:.1f} с")
    print(f"тестов прошло: {passed} из {total}")
    if passed < total:
        # короткая выжимка упавших тестов, полную простыню не печатаем
        for line in out.splitlines():
            if line.startswith(("FAIL:", "ERROR:")):
                print("  " + line)
    shutil.rmtree(workdir)


if __name__ == "__main__":
    main()
Harness вокруг той же модели
Скрипт harness.py собирает части harness вокруг того же вызова модели. Инструменты read_file и run_tests описаны в формате tool calling Ollama. Код модель присылает не аргументом инструмента, а блоком в тексте ответа, из-за сбоя Ollama, описанного в подводных камнях. Песочница это временная папка с копией задачи. После каждой правки harness гоняет тесты, пишет строку в журнал progress.md и отправляет модели имена упавших тестов. Модели журнал в этом демо не передаётся, он показывает, как выглядел бы мост для следующей сессии. Детектор петли сравнивает новый код с прежними вариантами по AST и, если такой уже был, просит сменить подход вместо повторного прогона.
# Python 3.12 stdlib, ollama 0.40.13, модели qwen2.5:7b и llama3.1:8b, прогнано на стенде 2026-11-05
"""Минимальный harness поверх Ollama: та же модель и та же задача, что в bare.py.

Вокруг модели семь частей:
  инструменты  - read_file и run_tests в формате tool calling Ollama;
  формат правки - новый duration.py модель присылает блоком ```python в тексте ответа,
                 harness сам записывает его в файл (код внутри JSON-аргумента малые модели
                 ломают, и Ollama такой вызов молча выбрасывает);
  контекст     - короткая инструкция-карта; журнал progress.md только пишется
                 и в конце печатается, модели в этом демо не передаётся;
  песочница    - копия задачи во временной папке, читать можно только внутри неё,
                 записывается только duration.py, тесты агенту недоступны для правки;
  проверка     - после каждой правки harness сам гоняет тесты и возвращает ошибки модели;
  детектор петли - если модель прислала код, который уже был, harness говорит ей об этом
                 и просит сменить подход, а не прогоняет то же самое молча;
  цикл         - шаги до прохождения тестов или до исчерпания бюджета MAX_STEPS.
"""
import ast
import json
import os
import re
import shutil
import subprocess
import sys
import tempfile
import time
import urllib.request
from pathlib import Path

OLLAMA = os.environ.get("OLLAMA_URL", "http://localhost:11434")
MODEL = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:7b"
MAX_STEPS = int(os.environ.get("MAX_STEPS", "8"))
TASK_DIR = Path(__file__).resolve().parent / "task"
TARGET = "duration.py"              # единственный файл, который harness перезаписывает
FEEDBACK_LIMIT = 1500               # сколько символов вывода тестов отдаём модели
NUM_PREDICT = 900                   # потолок токенов на шаг: бюджет времени на CPU
TRACE = os.environ.get("TRACE")     # путь к jsonl с сырыми ответами модели, для разбора

# Контекст: карта задачи, а не энциклопедия. Всё остальное агент читает инструментами.
INSTRUCTIONS = """Ты агент, который пишет код в рабочей папке.
Правила:
1. Прочитай duration.py и test_duration.py инструментом read_file.
2. Новый duration.py присылай целиком в тексте ответа одним блоком ```python,
   без пояснений и без docstring. Не передавай код через инструменты:
   harness сам запишет блок в файл.
3. После каждой правки тесты прогоняются автоматически, результат придёт следующим сообщением.
4. Тесты менять нельзя.
Задача решена, когда проходят все тесты."""

TOOLS = [
    {"type": "function", "function": {
        "name": "read_file", "description": "Прочитать файл из рабочей папки",
        "parameters": {"type": "object", "required": ["path"],
                       "properties": {"path": {"type": "string"}}}}},
    {"type": "function", "function": {
        "name": "run_tests", "description": "Прогнать тесты test_duration.py",
        "parameters": {"type": "object", "properties": {}}}},
]


def chat(messages):
    # один шаг модели; temperature 0 и seed, чтобы прогон повторялся
    body = {"model": MODEL, "messages": messages, "tools": TOOLS, "stream": False,
            "options": {"temperature": 0, "seed": 42, "num_ctx": 8192,
                        "num_predict": NUM_PREDICT}}
    req = urllib.request.Request(f"{OLLAMA}/api/chat", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=900) as resp:
        data = json.load(resp)
    return data["message"], data.get("eval_count", 0)


class Sandbox:
    """Песочница: копия задачи во временной папке и проверка путей."""

    def __init__(self):
        self.root = Path(tempfile.mkdtemp(prefix="harness_")).resolve()
        shutil.copytree(TASK_DIR, self.root, dirs_exist_ok=True)
        self.progress = self.root / "progress.md"
        self.progress.write_text("# Прогресс агента\n")

    def path(self, name):
        p = (self.root / name).resolve()
        if p.parent != self.root:
            raise PermissionError(f"путь вне рабочей папки: {name}")
        return p

    def run_tests(self):
        proc = subprocess.run([sys.executable, "-m", "unittest", "-q", "test_duration"],
                              cwd=self.root, capture_output=True, text=True, timeout=30)
        out = proc.stdout + proc.stderr
        total = int(m.group(1)) if (m := re.search(r"Ran (\d+) test", out)) else 0
        bad = sum(int(x) for x in re.findall(r"(?:failures|errors)=(\d+)", out))
        return total - bad, total, out


def feedback(passed, total, out):
    # Проверяющая петля: модели уходит итог, имена упавших тестов и хвост ошибок, а не весь лог
    head = f"тестов прошло {passed} из {total}"
    if passed == total and total:
        return head + ". Все тесты прошли."
    failed = re.findall(r"^(?:FAIL|ERROR): (\w+)", out, re.M)
    return (head + ". Упали: " + ", ".join(failed) + ".\nХвост вывода:\n"
            + out[-FEEDBACK_LIMIT:])


def fingerprint(code):
    # отпечаток кода без форматирования и комментариев; не парсится - берём текст как есть
    try:
        return ast.dump(ast.parse(code))
    except SyntaxError:
        return code.strip()


def main():
    box = Sandbox()
    messages = [{"role": "system", "content": INSTRUCTIONS},
                {"role": "user", "content": "Реализуй parse_duration в duration.py."}]
    state = {"passed": 0, "total": 0, "tool_calls": 0, "refused": 0, "edits": 0, "empty": 0,
             "loops": 0}
    seen = {}                       # отпечаток кода -> (шаг, прошло, всего)

    def check(step):
        # прогон тестов и строка в журнал progress.md (заготовка моста между сессиями)
        passed, total, out = box.run_tests()
        state.update(passed=passed, total=total)
        with box.progress.open("a") as f:
            f.write(f"- шаг {step}: тестов прошло {passed} из {total}\n")
        return feedback(passed, total, out)

    def execute(step, name, args):
        state["tool_calls"] += 1
        try:
            if name == "read_file":
                return box.path(args["path"]).read_text()
            if name == "run_tests":
                return check(step)
            return f"нет такого инструмента: {name}"
        except PermissionError as e:
            state["refused"] += 1
            return f"отказано: {e}"
        except (OSError, KeyError, subprocess.TimeoutExpired) as e:
            return f"ошибка инструмента: {type(e).__name__}: {e}"

    t0 = time.time()
    step = 0
    for step in range(1, MAX_STEPS + 1):
        ts = time.time()
        msg, tokens = chat(messages)
        messages.append(msg)
        if TRACE:
            with open(TRACE, "a") as f:
                f.write(json.dumps({"step": step, "eval_count": tokens, "message": msg},
                                   ensure_ascii=False) + "\n")
        calls = msg.get("tool_calls") or []
        notes = []
        for call in calls:
            name = call["function"]["name"]
            args = call["function"].get("arguments") or {}
            if isinstance(args, str):           # часть моделей отдаёт аргументы строкой
                args = json.loads(args or "{}")
            result = execute(step, name, args)
            messages.append({"role": "tool", "tool_name": name, "content": result})
            notes.append(f"{name}({args.get('path', '')})")
        blocks = re.findall(r"```(?:python|py)?\s*\n(.*?)```", msg.get("content") or "", re.S)
        if blocks and (fp := fingerprint(blocks[-1])) in seen:
            # детектор петли: тот же код уже был, тесты не гоняем, просим другой подход
            state["loops"] += 1
            was, p_, t_ = seen[fp]
            messages.append({"role": "user", "content": (
                f"Этот код уже присылался на шаге {was} и дал {p_} из {t_} тестов. "
                "Повтор ничего не изменит. Перечитай упавшие тесты и смени подход к разбору "
                "строки, затем пришли новый duration.py целиком.")})
            notes.append(f"повтор кода шага {was}")
        elif blocks:
            # формат правки: последний блок кода из ответа harness кладёт в duration.py
            box.path(TARGET).write_text(blocks[-1])
            state["edits"] += 1
            messages.append({"role": "user", "content": check(step)})
            seen[fp] = (step, state["passed"], state["total"])
            notes.append(f"правка {TARGET}")
        elif not calls:
            # пустой ответ при сотнях токенов генерации: модель пыталась вызвать
            # инструмент, а Ollama не разобрала вызов и выбросила его целиком
            state["empty"] += 1
            messages.append({"role": "user", "content": "Ответ пришёл пустым. Пришли duration.py "
                             "целиком блоком ```python в тексте ответа, без вызова инструментов."})
            notes.append(f"пустой ответ ({tokens} токенов), напоминание")
        print(f"шаг {step} | {', '.join(notes)} | тестов {state['passed']}/{state['total']} "
              f"| {time.time() - ts:.1f} с", flush=True)
        if state["total"] and state["passed"] == state["total"]:
            break

    print(f"модель: {MODEL}")
    print(f"шагов модели: {step} из {MAX_STEPS}, правок кода: {state['edits']}, "
          f"повторов кода: {state['loops']}, вызовов инструментов: {state['tool_calls']}, "
          f"пустых ответов: {state['empty']}, "
          f"отказов песочницы: {state['refused']}, время: {time.time() - t0:.1f} с")
    print(f"тестов прошло: {state['passed']} из {state['total']}")
    print("progress.md:")
    print(box.progress.read_text().rstrip())
    shutil.rmtree(box.root)


if __name__ == "__main__":
    main()
Обе программы запускаются с именем модели в аргументе.
# Python 3.12.3, ollama 0.40.13, проверено на стенде 2026-11-05
# голая модель: один вызов, без обратной связи
python3 bare.py qwen2.5:7b
python3 bare.py llama3.1:8b
# та же модель в harness: цикл до 8 шагов с проверкой тестами
python3 harness.py qwen2.5:7b
python3 harness.py llama3.1:8b
Результат прогона
Строка шага показывает действие модели, число пройденных тестов и время шага на CPU. Голую llama3.1:8b пришлось перезапустить после сбоя памяти, поэтому её блок помечен отдельно.
# вывод прогона на стенде 2026-11-05, ollama 0.40.13, Python 3.12.3, фрагменты run_output.txt

=== ДЕМО bare.py qwen2.5:7b ===
модель: qwen2.5:7b
вызовов модели: 1, время: 368.3 с
тестов прошло: 5 из 13
  ERROR: test_case_insensitive (test_duration.ParseDurationTest.test_case_insensitive)
  ERROR: test_combined (test_duration.ParseDurationTest.test_combined)
  ERROR: test_days (test_duration.ParseDurationTest.test_days)
  ERROR: test_fraction (test_duration.ParseDurationTest.test_fraction)
  ERROR: test_fraction_floor (test_duration.ParseDurationTest.test_fraction_floor)
  ERROR: test_minutes (test_duration.ParseDurationTest.test_minutes)
  ERROR: test_seconds (test_duration.ParseDurationTest.test_seconds)
  ERROR: test_spaces (test_duration.ParseDurationTest.test_spaces)

=== ДЕМО harness.py qwen2.5:7b ===
шаг 1 | read_file(duration.py) | тестов 0/0 | 153.6 с
шаг 2 | read_file(test_duration.py) | тестов 0/0 | 30.7 с
шаг 3 | правка duration.py | тестов 1/13 | 212.7 с
шаг 4 | правка duration.py | тестов 3/13 | 218.8 с
шаг 5 | повтор кода шага 4 | тестов 3/13 | 271.9 с
шаг 6 | правка duration.py | тестов 3/13 | 348.6 с
шаг 7 | повтор кода шага 6 | тестов 3/13 | 483.9 с
шаг 8 | правка duration.py | тестов 5/13 | 329.9 с
модель: qwen2.5:7b
шагов модели: 8 из 8, правок кода: 4, повторов кода: 2, вызовов инструментов: 2, пустых ответов: 0, отказов песочницы: 0, время: 2050.1 с
тестов прошло: 5 из 13
progress.md:
# Прогресс агента
- шаг 3: тестов прошло 1 из 13
- шаг 4: тестов прошло 3 из 13
- шаг 6: тестов прошло 3 из 13
- шаг 8: тестов прошло 5 из 13

=== ДЕМО bare.py llama3.1:8b, перезапуск после OOM, OLLAMA_MAX_LOADED_MODELS=1 ===
Thu Nov  5 07:55:40 UTC 2026
модель: llama3.1:8b
вызовов модели: 1, время: 174.5 с
тестов прошло: 4 из 13
  ERROR: test_case_insensitive (test_duration.ParseDurationTest.test_case_insensitive)
  ERROR: test_combined (test_duration.ParseDurationTest.test_combined)
  ERROR: test_days (test_duration.ParseDurationTest.test_days)
  ERROR: test_fraction (test_duration.ParseDurationTest.test_fraction)
  ERROR: test_fraction_floor (test_duration.ParseDurationTest.test_fraction_floor)
  ERROR: test_minutes (test_duration.ParseDurationTest.test_minutes)
  ERROR: test_seconds (test_duration.ParseDurationTest.test_seconds)
  ERROR: test_spaces (test_duration.ParseDurationTest.test_spaces)
  FAIL: test_empty (test_duration.ParseDurationTest.test_empty)

=== ДЕМО harness.py llama3.1:8b ===
шаг 1 | read_file(duration.py) | тестов 0/0 | 242.4 с
шаг 2 | правка duration.py | тестов 6/13 | 135.6 с
шаг 3 | read_file(duration.py) | тестов 6/13 | 55.1 с
шаг 4 | правка duration.py | тестов 9/13 | 222.8 с
шаг 5 | read_file(duration.py) | тестов 9/13 | 77.1 с
шаг 6 | повтор кода шага 4 | тестов 9/13 | 289.8 с
шаг 7 | read_file(duration.py) | тестов 9/13 | 36.9 с
шаг 8 | повтор кода шага 4 | тестов 9/13 | 227.6 с
модель: llama3.1:8b
шагов модели: 8 из 8, правок кода: 2, повторов кода: 2, вызовов инструментов: 4, пустых ответов: 0, отказов песочницы: 0, время: 1287.3 с
тестов прошло: 9 из 13
progress.md:
# Прогресс агента
- шаг 2: тестов прошло 6 из 13
- шаг 4: тестов прошло 9 из 13
Сводка по обоим режимам собрана в таблицу.
| Модель | Голая модель | В harness | Правок кода | Повторов кода | Время harness |
|---|---|---|---|---|---|
| qwen2.5:7b | 5 из 13 | 5 из 13 | 4 | 2 | 2050 с |
| llama3.1:8b | 4 из 13 | 9 из 13 | 2 | 2 | 1287 с |
Голые модели прошли только тесты на ошибочный ввод, потому что их функции бросали ValueError и на правильных строках. Llama в harness за две правки дошла до 9 тестов из 13, после чего дважды прислала код шага 4 и упёрлась в потолок шагов. Непройденными остались регистр единиц, строка 1h30m, на которой функция вернула 3600 вместо 5400, и проверки порядка и повтора единиц. Qwen за четыре правки прошла путь от 1 до 5 тестов из 13 и голую версию не обогнала. Все её варианты делили строку не на пары из числа и единицы.
Прогон показывает и обратную сторону подхода. Без детектора петли та же qwen2.5:7b в harness прошла 3 теста из 13, хуже голой модели, потому что шесть шагов подряд присылала почти один и тот же код. Пилотная версия harness с другой формулировкой инструкции, первым блоком кода вместо последнего и без потолка токенов довела её до 11 из 13 за 5 шагов и остановилась по таймауту. Три версии harness дали на одной модели 11, 3 и 5 тестов из 13, и это наблюдение на одной задаче, а не закономерность. Harness поднимает модель к её потолку, но потолок задаёт сама модель, ведь проверка сообщает, что сломано, а не как исправить.
Заключение
Harness engineering переносит внимание с выбора модели на устройство среды, в которой она работает. Цикл с бюджетом, инструменты, короткий контекст, память между сессиями, песочница и автоматическая проверка превращают модель, отвечающую текстом, в агента, который доводит задачу до проверенного результата. Демо на Ollama показало обе стороны подхода. Один и тот же harness поднял llama3.1:8b с 4 до 9 тестов из 13 и не помог qwen2.5:7b, а три версии самого harness дали на одной модели от 3 до 11 тестов из 13. Поэтому harness стоит проверять на нескольких моделях, а не только на той, под которую он писался.
Референсные ссылки
- Effective harnesses for long-running agents в инженерном блоге Anthropic
- Improving Deep Agents with harness engineering в блоге LangChain
- The anatomy of an agent harness в блоге LangChain
- Harness engineering: leveraging Codex in an agent-first world в блоге OpenAI
- Статья о границе context engineering и harness engineering на Хабре