
 5
Содержание
- Что такое Context engineering
- Из чего состоит контекст LLM-агента
- Как работает context engineering
- Отбор и загрузка по требованию
- Сжатие, компакция истории и очистка выводов инструментов
- Память вне окна, заметки и списки задач
- Изоляция в субагентах
- Context rot, почему большое окно не отменяет отбор
- Prompt engineering, context engineering и harness engineering, где граница
- Подводные камни
- Когда нужен context engineering, а когда хватит хорошего промпта
- Практика, отбор и компакция контекста на Ollama
- Из чего состоит окно агента
- Отбор против загрузки всей базы
- Компакция истории агента
- Заключение
- Референсные ссылки
Context engineering (контекст инжиниринг) это инженерная практика, которая решает, какие токены попадут в контекстное окно большой языковой модели (LLM, large language model) на каждом шаге работы приложения или ИИ-агента. В окно идут не только промпт и вопрос пользователя, но и описания инструментов, история сообщений, результаты вызовов, найденные документы и заметки из внешней памяти. Окно конечно, а качество ответа зависит от всего набора сразу, поэтому отбор, сжатие и изоляция контекста становятся отдельной инженерной задачей, а не приложением к хорошему промпту.
Что такое Context engineering
Термин закрепился в 2025 году, когда языковые модели стали массово работать агентами, то есть десятки шагов подряд вызывать инструменты и читать их результаты. Команда Applied AI компании Anthropic, разработчика моделей Claude, в статье Effective context engineering for AI agents от 29 сентября 2025 года определила context engineering как набор стратегий для отбора и поддержания оптимального набора токенов во время инференса LLM, включая всю информацию, которая попадает в окно помимо промптов. Там же практика названа естественным продолжением prompt engineering, дисциплины, которая занимается написанием и организацией инструкций.
Prompt engineering оптимизирует формулировку, а context engineering решает, что окажется рядом с ней. У агента этот выбор повторяется на каждом шаге, потому что каждый вызов инструмента дописывает в историю новый вывод. Цель Anthropic формулирует как поиск наименьшего набора токенов с высоким сигналом, который максимизирует вероятность нужного результата.
Академическая версия понятия есть в обзоре A Survey of Context Engineering for Large Language Models, который группа исследователей во главе с Lingrui Mei (Линжуй Мэй) выложила на arXiv в июле 2025 года по итогам разбора более 1400 работ. Авторы выделяют три базовых компонента, а именно получение и генерацию контекста, его обработку и управление им, и отдельно разбирают системы, собранные из них, от RAG и систем памяти до мультиагентных.
Из чего состоит контекст LLM-агента
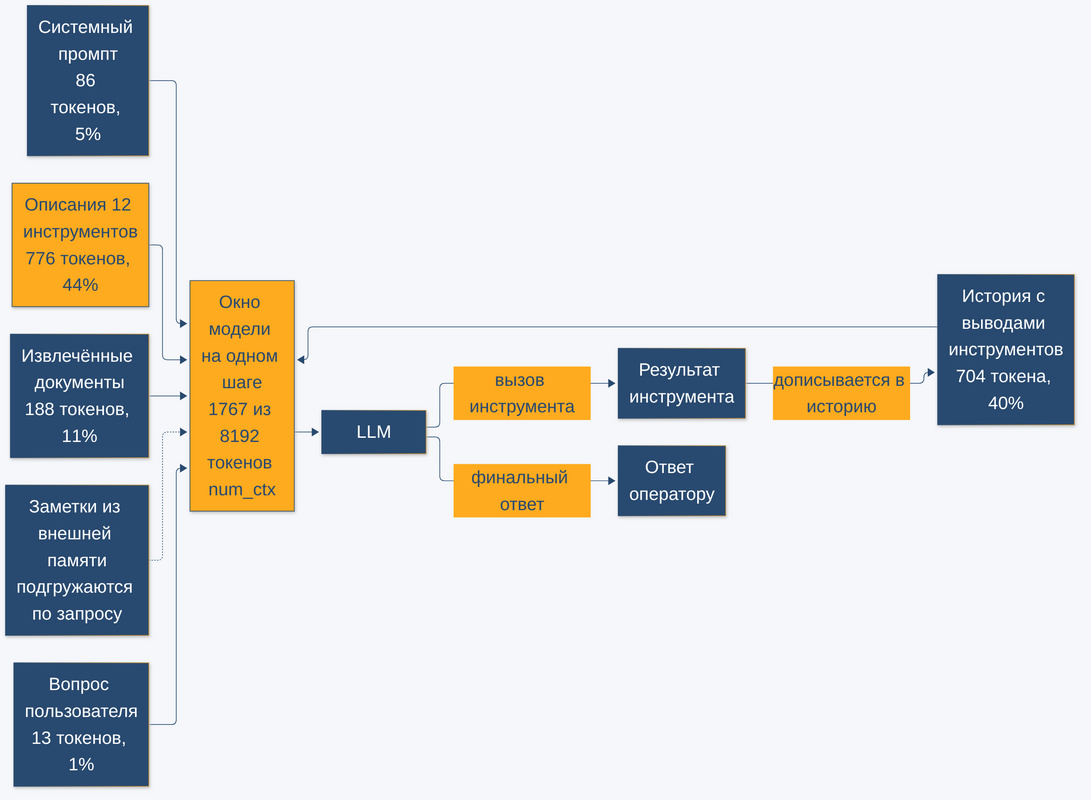
Окно одного шага агента собирается из нескольких слоёв, и у каждого своя цена:
- Системный промпт. Инструкция должна стоять «на правильной высоте», между жёсткой логикой на все случаи и расплывчатыми пожеланиями.
- Описания инструментов. Каждое описание вместе с JSON-схемой параметров уходит в каждый вызов модели.
- Примеры. Небольшой набор разнообразных канонических примеров работает лучше длинного списка граничных случаев.
- История сообщений. Реплики, ответы модели и выводы инструментов, слой растёт быстрее остальных.
- Извлечённые данные. Документы из RAG (Retrieval-Augmented Generation, генерация с дополнением выборкой), строки из базы, содержимое файлов.
- Внешняя память. Заметки и списки задач, которые агент пишет вне окна и подгружает обратно по необходимости.
Вопрос пользователя занимает меньше всего места. Больше всего окна обычно съедают описания инструментов и выводы прошлых шагов, это видно в первом демо практики. Инструменты и данные агенту всё чаще подключают через MCP (Model Context Protocol), его устройство разобрано в статье блога о модели контекстного протокола MCP.
Как работает context engineering
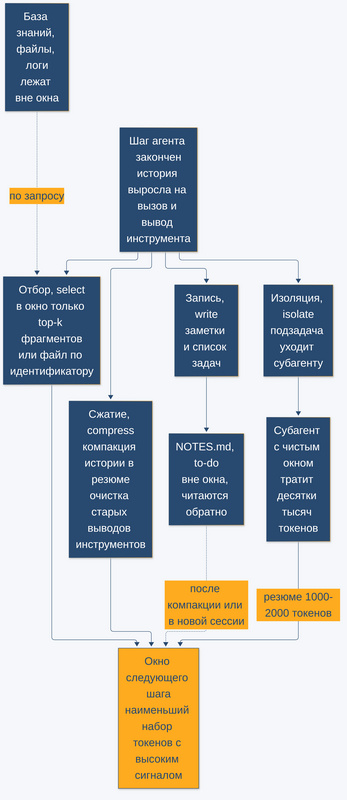
Команда LangChain, разработчика одноимённого фреймворка для LLM-приложений, в статье Context Engineering for Agents от 2 июля 2025 года свела техники в четыре группы. Записать (write) значит сохранить контекст вне окна, отобрать (select) значит подтянуть в окно нужное, сжать (compress) значит оставить только токены, необходимые для задачи, а изолировать (isolate) значит разделить контекст между несколькими исполнителями. Anthropic описывает те же приёмы на примере своего агента для разработки Claude Code.
Отбор и загрузка по требованию
Классический RAG заранее находит документы и кладёт их в окно. Подход just-in-time, то есть загрузка в момент надобности, устроен иначе. Агент держит в окне лёгкие идентификаторы, а именно пути к файлам, сохранённые запросы и ссылки, и сам подгружает данные инструментами, когда они понадобились. Claude Code сочетает оба подхода. Файлы CLAUDE.md с правилами проекта попадают в окно сразу, а остальное агент находит по ходу работы командами glob и grep. По оценке Anthropic, самые эффективные агенты, вероятно, используют именно такой гибрид.
Сжатие, компакция истории и очистка выводов инструментов
Компакция (compaction) это пересказ истории, которая подошла к пределу окна, и запуск нового окна с этим пересказом вместо исходных сообщений. Пересказ пишет сама модель отдельным вызовом, и это стоит времени и токенов. Самой лёгкой и безопасной формой сжатия Anthropic называет очистку результатов инструментов (tool result clearing). Старые выводы заменяются заглушкой, сами вызовы остаются в истории, и при необходимости агент вызывает инструмент повторно.
Память вне окна, заметки и списки задач
Структурированные заметки (structured note-taking) переносят состояние задачи из окна во внешнее хранилище. Claude Code ведёт список задач, самописный агент может вести файл NOTES.md, и после компакции или в новой сессии агент читает их обратно. Anthropic приводит пример агента, который играет в Pokémon и благодаря заметкам держит точные счётчики на протяжении тысяч игровых шагов.
Изоляция в субагентах
Субагент получает узкую задачу и чистое окно. Он может потратить на поиск десятки тысяч токенов, но главному агенту возвращает только сжатое резюме, по данным Anthropic обычно 1000-2000 токенов. Anthropic рекомендует такую схему для сложного исследования и анализа, где параллельный поиск окупается, потому что каждый субагент собирает свой контекст с нуля.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Context rot, почему большое окно не отменяет отбор
Окна выросли до сотен тысяч токенов, и кажется, что класть в них можно всё. Anthropic отвечает на это понятием context rot (деградация контекста). Исследования в стиле needle-in-a-haystack, где модель ищет вставленный факт в длинном тексте, показали, что с ростом числа токенов в окне способность модели точно вспоминать информацию из него падает. Деградация идёт постепенно, без резкого обрыва, и встречается у всех моделей.
Объяснение Anthropic связано с архитектурой трансформера. Каждый токен соотносится со всеми остальными, и n токенов дают n² попарных связей. У модели есть своего рода бюджет внимания, и каждый новый токен его немного расходует. Поэтому контекст рассматривают как конечный ресурс с убывающей отдачей, а не как бесплатный склад.
Собственный прогон из раздела о практике деградации точности не показал, на коротком окне модель нашла нужный факт в любой позиции. На коротком окне отбор экономит время и деньги, а на длинном ещё и защищает точность.
Prompt engineering, context engineering и harness engineering, где граница
Три практики часто путают, потому что все три меняют поведение модели без дообучения. Различаются они масштабом.
| Практика | Что проектируют | Единица работы | Когда меняется | Типичная ошибка |
|---|---|---|---|---|
| Prompt engineering | Текст системной инструкции и запроса | Один вызов модели | При смене задачи или модели | Длинный список граничных случаев в промпте |
| Context engineering | Состав окна на каждом шаге, а именно инструменты, история, документы, память | Один шаг агента | На каждом шаге, кодом приложения | Всё в окно в расчёте на его размер |
| Harness engineering | Цикл агента, инструменты, проверки, песочница, бюджет | Вся задача до проверенного результата | При смене класса задач | Нет внешней проверки, и модель сама объявляет задачу решённой |
Таким образом, prompt engineering остаётся частью context engineering, а оба входят в harness как его слои.
Подводные камни
Ошибки context engineering редко ломают агента сразу, он просто отвечает хуже и дороже:
- Агрессивная компакция. Резюме теряет детали, ценность которых выяснится только через несколько шагов. Anthropic советует сначала настроить промпт сжатия на полноту, чтобы в резюме попало всё нужное, и только потом убирать лишнее.
- Уверенная подмена после очистки. Когда вывод инструмента стёрт, модель может не сказать «не знаю», а взять похожее число из того, что осталось в окне.
- Загрузка по требованию медленнее. Just-in-time требует лишних вызовов инструментов, и без хороших инструментов и эвристик агент тратит контекст на тупиковые пути.
- Раздутый набор инструментов. Anthropic называет его одной из самых частых ошибок, потому что пересекающиеся функции сбивают модель при выборе.
- Молчаливая обрезка окна. В Ollama, локальном сервере для запуска открытых моделей, промпт длиннее параметра num_ctx обрезается без ошибки, и пропадает начало промпта. Этот эффект разобран с прогоном в статье про контекстное окно.
Общий совет Anthropic на все эти случаи короткий, делать самое простое, что работает.
Когда нужен context engineering, а когда хватит хорошего промпта
Если приложение делает один вызов модели с коротким документом, контекст собирается один раз, и работа сводится к промпту. Context engineering становится отдельной задачей, когда выполнено хотя бы одно из условий:
- Агент работает много шагов. История с выводами инструментов растёт, и модели приходится искать нужное среди старых логов.
- Данных больше, чем помещается в окно. База знаний, репозиторий или логи требуют отбора.
- Задача длится дольше одной сессии. Состояние нужно хранить вне окна, иначе после перезапуска агент начинает с нуля.
- Важны цена и задержка. Каждый токен оплачивается и читается при каждом вызове.
Если ни одно условие не выполняется, хватит хорошего промпта. Агентную сторону темы, то есть RAG, память и планирование для агентов, разбирают на курсе ИИ-агенты для оптимизации бизнес-процессов.
Архитектура ML-систем
Код курса
ARML
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24/32 ак.часов
Стоимость обучения
76 800
Практика, отбор и компакция контекста на Ollama
По традиции весь код, используемый в статье, выкладываем на наш GitHub репозиторий.
Три демо меряют вклад слоёв окна, сравнивают отбор с загрузкой всей базы и проверяют, что модель помнит после сжатия истории. Прогон сделан на стенде с Ubuntu 24.04.4 LTS, 4 vCPU без GPU, Python 3.12.3 и Ollama 0.40.13 в Docker. Модель qwen2.5:7b, открытая модель семейства Qwen от Alibaba в квантовании Q4_K_M, параметры temperature 0 и num_ctx 8192 заданы явно. Скрипты используют только стандартную библиотеку Python и HTTP API Ollama.
Чтение промпта перед генерацией называют префиллом (prefill). На CPU модель читала промпт со скоростью от 7 до 9 токенов в секунду, и все три демо шли 24.5 минуты. Ollama поднимается из файла docker-compose.yml, где одновременно разрешена только одна загруженная модель, потому что Ollama видит память хоста, а не лимит контейнера.
# ollama 0.40.13 в Docker, стенд для статьи про Context engineering, проверено на стенде 2026-11-05
services:
  ollama:
    image: ollama/ollama:0.40.13
    container_name: context-ollama
    # 7-8B модели в q4 занимают около 5 ГБ, плюс KV-кэш на num_ctx 8192
    mem_limit: 10g
    environment:
      # Ollama видит память хоста, а не лимит контейнера: две модели сразу
      # не влезают в 10 ГБ, и ядро убивает llama-server по OOM
      OLLAMA_MAX_LOADED_MODELS: "1"
    ports:
      - "127.0.0.1:11434:11434"
    volumes:
      - ./ollama:/root/.ollama
Скрипты берут адрес Ollama из переменной OLLAMA_URL, по умолчанию это локальный сервер на порту 11434.
# запуск демо к статье про Context engineering, Ollama 0.40.13 и qwen2.5:7b, прогнано на стенде 2026-11-05
# строка ollama pull по RUNBOOK, на стенде модель уже лежала в каталоге ./ollama
docker compose up -d
docker exec context-ollama ollama pull qwen2.5:7b
# три демо по очереди, на CPU около 25 минут
python3 01_context_budget.py qwen2.5:7b
python3 02_select_vs_dump.py qwen2.5:7b
python3 03_compaction.py qwen2.5:7b
Из чего состоит окно агента
Файл 01_context_budget.py собирает окно одного шага агента поддержки интернет-магазина. Слои добавляются по одному, и после каждого скрипт делает вызов с num_predict 1 и читает prompt_eval_count, то есть сколько токенов модель прочитала с учётом шаблона чата. Разница соседних замеров даёт вклад слоя.
# Python 3.12 stdlib, ollama 0.40.13, модель qwen2.5:7b, прогнано на стенде 2026-11-05
"""Из чего состоит окно агента: вклад каждого слоя контекста в токенах.

Окно одного шага агента собирается из пяти слоёв: системный промпт, описания инструментов,
история сообщений с выводами инструментов, извлечённые документы и текущий вопрос.
Скрипт добавляет слои по одному и после каждого спрашивает у Ollama, сколько токенов
промпта модель прочитала (prompt_eval_count, вызов с num_predict=1, ответ не нужен).
Разница между соседними замерами и есть вклад слоя.

prompt_eval_count в Ollama 0.40.13 считает всё окно, включая токены, взятые из кэша
префикса (они отдельно лежат в prompt_eval_cached_count). Слои добавляются в конец окна,
поэтому каждый следующий замер дочитывает только новый слой, а цифра окна остаётся полной.
"""
import json
import os
import sys
import urllib.request

OLLAMA = os.environ.get("OLLAMA_URL", "http://localhost:11434")
MODEL = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:7b"
NUM_CTX = 8192

SYSTEM = ("Ты агент поддержки интернет-магазина. Помогаешь оператору разбирать обращения "
          "клиентов: находишь заказ, проверяешь статус доставки и оплаты, предлагаешь решение. "
          "Возврат денег оформляешь только после проверки статуса оплаты. Отвечай кратко.")


def tool(name, desc, props):
    return {"type": "function", "function": {"name": name, "description": desc, "parameters": {
        "type": "object", "required": list(props),
        "properties": {k: {"type": "string", "description": v} for k, v in props.items()}}}}


# двенадцать инструментов: в реальных агентах их набор растёт быстрее всего остального
TOOLS = [
    tool("find_order", "Найти заказ по номеру или телефону клиента", {"query": "номер заказа или телефон"}),
    tool("order_status", "Статус заказа и история его изменений", {"order_id": "номер заказа"}),
    tool("payment_status", "Статус оплаты заказа в платёжном шлюзе", {"order_id": "номер заказа"}),
    tool("delivery_track", "Трек и статус доставки у перевозчика", {"order_id": "номер заказа"}),
    tool("refund", "Оформить возврат денег по заказу", {"order_id": "номер заказа", "reason": "причина"}),
    tool("cancel_order", "Отменить заказ до передачи в доставку", {"order_id": "номер заказа", "reason": "причина"}),
    tool("change_address", "Изменить адрес доставки", {"order_id": "номер заказа", "address": "новый адрес"}),
    tool("customer_profile", "Профиль клиента: контакты, заказы, обращения", {"customer_id": "id клиента"}),
    tool("search_kb", "Поиск по базе знаний поддержки", {"query": "текст запроса"}),
    tool("create_ticket", "Создать задачу во внутренний трекер", {"title": "заголовок", "body": "описание"}),
    tool("send_sms", "Отправить клиенту SMS", {"phone": "телефон", "text": "текст"}),
    tool("escalate", "Передать обращение старшему оператору", {"order_id": "номер заказа", "note": "комментарий"}),
]

HISTORY = [
    {"role": "user", "content": "Клиент пишет, что заказ 58213 не пришёл, а деньги списали неделю назад."},
    {"role": "assistant", "content": "", "tool_calls": [{"function": {"name": "order_status", "arguments": {"order_id": "58213"}}}]},
    {"role": "tool", "content": json.dumps({"order_id": "58213", "status": "shipped", "history": [
        {"ts": f"2026-10-{d:02d}T1{d % 10}:00:00Z", "status": s, "by": "system", "comment": c}
        for d, s, c in [(27, "created", "заказ создан на сайте"), (27, "paid", "оплата картой подтверждена"),
                        (28, "assembled", "собран на складе Север-2"), (28, "shipped", "передан перевозчику"),
                        (29, "in_transit", "принят на сортировке"), (30, "in_transit", "задержка на сортировке")]]},
        ensure_ascii=False)},
    {"role": "assistant", "content": "", "tool_calls": [{"function": {"name": "delivery_track", "arguments": {"order_id": "58213"}}}]},
    {"role": "tool", "content": json.dumps({"carrier": "СДЭК", "track": "1129384756", "events": [
        {"ts": f"2026-10-{d:02d}T0{d % 10}:30:00Z", "place": p, "event": e}
        for d, p, e in [(28, "Москва, склад", "принято от отправителя"), (29, "Москва, СЦ", "сортировка"),
                        (30, "Москва, СЦ", "задержка: повреждение упаковки"), (31, "Москва, СЦ", "ожидает переупаковки")]]},
        ensure_ascii=False)},
    {"role": "assistant", "content": "Посылка застряла на сортировке из-за повреждённой упаковки. Проверяю оплату."},
]

DOCS = ("Извлечённые документы базы знаний:\n"
        "[kb-114] Повреждение упаковки у перевозчика: если посылка ждёт переупаковки дольше 3 дней, "
        "оператор создаёт задачу в трекер с треком и предлагает клиенту выбор: ждать или вернуть деньги.\n"
        "[kb-087] Возврат денег по оплаченному заказу оформляется после проверки статуса оплаты, срок "
        "зачисления на карту до 10 рабочих дней.\n"
        "[kb-203] Компенсация за задержку доставки: промокод 10% при задержке больше 5 дней по вине перевозчика.")

QUESTION = {"role": "user", "content": "Что ответить клиенту и что сделать по заказу?"}


def prompt_tokens(messages, tools=None):
    # num_predict=1: ответ не нужен, нужен только счётчик прочитанных токенов
    body = {"model": MODEL, "messages": messages, "stream": False, "keep_alive": "60m",
            "options": {"temperature": 0, "num_ctx": NUM_CTX, "num_predict": 1}}
    if tools:
        body["tools"] = tools
    req = urllib.request.Request(f"{OLLAMA}/api/chat", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=1800) as resp:
        r = json.load(resp)
    return r["prompt_eval_count"], r.get("prompt_eval_cached_count", 0)


def main():
    system = {"role": "system", "content": SYSTEM}
    docs = {"role": "user", "content": DOCS}
    # слои добавляются по одному, как окно растёт от пустого агента к реальному шагу
    steps = [
        ("системный промпт", [system], None),
        ("+ инструменты (12)", [system], TOOLS),
        ("+ история с выводами", [system] + HISTORY, TOOLS),
        ("+ документы (3)", [system] + HISTORY + [docs], TOOLS),
        ("+ вопрос", [system] + HISTORY + [docs, QUESTION], TOOLS),
    ]
    print(f"модель {MODEL}, num_ctx {NUM_CTX}")
    print(f"{'слой':<24}{'окно, ток':>10}{'вклад':>8}{'доля':>7}{'из кэша':>9}")
    rows, prev = [], 0
    for name, msgs, tools in steps:
        n, cached = prompt_tokens(msgs, tools)
        rows.append((name, n, n - prev, cached))
        prev = n
    total = rows[-1][1]
    for name, n, delta, cached in rows:
        print(f"{name:<24}{n:>10}{delta:>8}{delta / total:>7.0%}{cached:>9}")
    print(f"итого окно {total} токенов из {NUM_CTX}: {total / NUM_CTX:.0%} num_ctx, "
          f"вопрос пользователя {rows[-1][2]} токенов")


if __name__ == "__main__":
    main()
модель qwen2.5:7b, num_ctx 8192
слой                     окно, ток   вклад   доля  из кэша
системный промпт                86      86     5%        3
+ инструменты (12)             862     776    44%       80
+ история с выводами          1566     704    40%      860
+ документы (3)               1754     188    11%     1566
+ вопрос                      1767      13     1%     1748
итого окно 1767 токенов из 8192: 22% num_ctx, вопрос пользователя 13 токенов
Описания 12 инструментов заняли 44% окна, больше всей истории с выводами и вчетверо больше трёх документов, ради которых окно собиралось. Вопрос оператора это 13 токенов из 1767, меньше процента. Столбец «из кэша» показывает токены, которые Ollama не читала заново, а взяла из кэша префикса (prefix cache), потому что начало окна совпало с прошлым вызовом. На втором шаге их только 80, потому что шаблон Qwen вставляет описания инструментов сразу за системным промптом.
Отбор против загрузки всей базы
Файл 02_select_vs_dump.py задаёт один вопрос по базе из 36 заметок дежурного инженера. Ответ лежит ровно в одной из них, а рядом лежит устаревшая заметка про ledger_v1 с другим портом. В режиме dump вся база идёт в окно, и нужная заметка стоит в начале, в середине или в конце. В режиме select окно получает три лучшие заметки по BM25, классической формуле ранжирования по совпадению слов. Чтобы время префилла режимов было сравнимым, каждый вызов получает уникальную метку сессии и не пользуется кэшем.
# Python 3.12 stdlib, ollama 0.40.13, модель qwen2.5:7b, прогнано на стенде 2026-11-05
"""Отбор против «всё в окно»: один и тот же вопрос по базе из 36 заметок.

База знаний это 36 коротких заметок дежурного инженера про внутренние сервисы. Ответ на вопрос
лежит ровно в одной из них (иголка), рядом лежит устаревшая заметка с похожими словами.

Режим dump: все 36 заметок идут в окно, иголка ставится в начало, в середину и в конец.
Режим select: окно получает только top-3 заметки по BM25 (написан на stdlib ниже).

Для каждого режима печатается: ответ модели, верен ли он, сколько токенов промпта
модель прочитала (prompt_eval_count) и сколько секунд ушло на их чтение (префилл).
Метка сессии в начале системного промпта меняется на каждом вызове: иначе Ollama возьмёт
общий префикс прошлого вызова из кэша, и время префилла режимов станет несравнимым.
"""
import json
import math
import os
import random
import re
import sys
import time
import urllib.request
import uuid

OLLAMA = os.environ.get("OLLAMA_URL", "http://localhost:11434")
MODEL = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:7b"
NUM_CTX = 8192

QUESTION = "На каком порту сервис ledger отдаёт метрики Prometheus?"
ANSWER = "9464"
NEEDLE = ("Сервис ledger ведёт проводки по счетам клиентов. Метрики Prometheus он отдаёт "
          "на порту 9464, путь /metrics, скрейп раз в 15 секунд. Владелец: команда finance-core.")
# устаревшая заметка с теми же словами: проверяет, не перепутает ли модель
STALE = ("Сервис ledger_v1 выведен из эксплуатации в 2025 году. Раньше он отдавал метрики "
         "на порту 9100, сейчас этот порт занят node_exporter.")

SERVICES = ["billing", "auth", "catalog", "search", "notify", "orders", "cart", "media",
            "geo", "pricing", "reports", "audit", "gateway", "profile", "chat", "promo",
            "delivery", "stock"]
TEAMS = ["platform", "growth", "core-api", "data", "mobile", "infra"]


def build_notes():
    # 34 заметки-шума по двум шаблонам: про логи и про дежурства, с метриками на своих портах
    rnd = random.Random(7)
    notes = []
    for i, s in enumerate(SERVICES):
        notes.append(f"Сервис {s} пишет логи в /var/log/{s} и хранит их {rnd.randint(3, 30)} дней. "
                     f"Метрики сервиса {s} доступны на порту {9200 + i * 7}. "
                     f"Владелец: команда {rnd.choice(TEAMS)}.")
        if len(notes) < 34:
            notes.append(f"Дежурство по сервису {s} передаётся по понедельникам в 10:00. "
                         f"При падении {s} сначала проверьте очередь {s}_events и пул соединений "
                         f"к базе, лимит {rnd.choice([20, 50, 100])} соединений.")
    notes = notes[:34] + [STALE]
    rnd.shuffle(notes)
    return notes


def tokens(text):
    # грубый стеммер: слово режется до первых 5 символов, чтобы «порту» совпало с «порт»
    return [w[:5] for w in re.findall(r"\w+", text.lower())]


def bm25_top(query, docs, k=3, k1=1.5, b=0.75):
    # классический BM25 без внешних библиотек
    docs_t = [tokens(d) for d in docs]
    avgdl = sum(map(len, docs_t)) / len(docs_t)
    n = len(docs_t)
    scores = []
    for i, dt in enumerate(docs_t):
        s = 0.0
        for q in set(tokens(query)):
            df = sum(1 for d in docs_t if q in d)
            if not df:
                continue
            idf = math.log(1 + (n - df + 0.5) / (df + 0.5))
            tf = dt.count(q)
            s += idf * tf * (k1 + 1) / (tf + k1 * (1 - b + b * len(dt) / avgdl))
        scores.append((s, i))
    return [docs[i] for _, i in sorted(scores, reverse=True)[:k]]


def ask(notes):
    # системный промпт одинаковый, меняется только набор заметок в окне
    ctx = "\n".join(f"[{i + 1}] {n}" for i, n in enumerate(notes))
    messages = [
        {"role": "system", "content": f"[сессия {uuid.uuid4().hex[:8]}] Ты помощник дежурного инженера. Отвечай только по заметкам. "
                                      "Если ответа в заметках нет, ответь: нет данных."},
        {"role": "user", "content": f"Заметки:\n{ctx}\n\nВопрос: {QUESTION}\nОтветь одним числом."},
    ]
    body = {"model": MODEL, "messages": messages, "stream": False, "keep_alive": "60m",
            "options": {"temperature": 0, "seed": 42, "num_ctx": NUM_CTX, "num_predict": 20}}
    req = urllib.request.Request(f"{OLLAMA}/api/chat", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=1800) as resp:
        return json.load(resp)


def report(label, notes):
    t = time.time()
    r = ask(notes)
    answer = r["message"]["content"].strip().replace("\n", " ")
    ok = ANSWER in answer
    print(f"{label:<16} заметок {len(notes):>2}  токенов промпта {r['prompt_eval_count']:>5}  "
          f"префилл {r['prompt_eval_duration'] / 1e9:6.1f} с  всего {time.time() - t:6.1f} с  "
          f"верно {'да ' if ok else 'нет'}  ответ: {answer[:60]}")
    return ok


def main():
    base = build_notes()
    print(f"модель {MODEL}, num_ctx {NUM_CTX}, заметок в базе {len(base) + 1}")
    # dump: вся база в окне, иголка в трёх позициях
    for label, pos in [("dump, начало", 0), ("dump, середина", len(base) // 2), ("dump, конец", len(base))]:
        notes = base[:pos] + [NEEDLE] + base[pos:]
        report(label, notes)
    # select: в окно идут только три лучшие заметки по BM25
    top = bm25_top(QUESTION, base + [NEEDLE], k=3)
    print("BM25 top-3:", " | ".join(n[:45] + "..." for n in top))
    report("select, top-3", top)


if __name__ == "__main__":
    main()
модель qwen2.5:7b, num_ctx 8192, заметок в базе 36
dump, начало     заметок 36  токенов промпта  2214  префилл  276.4 с  всего  280.2 с  верно да   ответ: 9464
dump, середина   заметок 36  токенов промпта  2214  префилл  313.1 с  всего  316.5 с  верно да   ответ: 9464
dump, конец      заметок 36  токенов промпта  2214  префилл  254.8 с  всего  257.7 с  верно да   ответ: 9464
BM25 top-3: Сервис ledger ведёт проводки по счетам клиент... | Сервис ledger_v1 выведен из эксплуатации в 20... | Сервис cart пишет логи в /var/log/cart и хран...
select, top-3    заметок  3  токенов промпта   260  префилл   23.2 с  всего   25.0 с  верно да   ответ: 9464
Все четыре ответа верны, и context rot на таком окне не проявился. Однако отбор сократил промпт с 2214 до 260 токенов, а время его чтения с 254.8-313.1 до 23.2 секунды. Устаревшая заметка про ledger_v1 попала в top-3, и модель правильно её отбросила. На реальной базе такая заметка, похожая по словам и неверная по сути, и есть главный риск отбора.
Компакция истории агента
Файл 03_compaction.py моделирует агента-аналитика, который за шесть вызовов инструментов собирает отчёт по ошибкам платёжного сервиса. Требования к отчёту пользователь дал в первом сообщении, а первый SQL-запрос вернул 1287 строк, и это число потом спросят. Вариант full оставляет историю как есть, clear заменяет выводы инструментов старше двух последних заглушкой, а summary заменяет раннюю историю резюме, которое пишет та же модель, и оставляет два последних шага.
# Python 3.12 stdlib, ollama 0.40.13, модель qwen2.5:7b, прогнано на стенде 2026-11-05
"""Компакция истории агента: полная история, очистка выводов инструментов и резюме.

Агент шесть шагов собирает отчёт по ошибкам платёжного сервиса. Требования к отчёту
пользователь дал в самом первом сообщении, а в выводе первого SQL-запроса лежит число,
которое потом спросят. Выводы инструментов многословные, как у настоящих логов и SQL.

Варианты истории перед финальным вопросом:
  full    - вся история как есть;
  clear   - выводы инструментов старше двух последних заменены короткой заглушкой
            (tool result clearing), сами вызовы и реплики остаются;
  summary - история заменена резюме, которое написала та же модель, плюс два последних шага.

Два вопроса к каждому варианту: про раннее требование (формат отчёта) и про деталь из
вывода первого инструмента (сколько строк вернул запрос). Печатается ответ, верен ли он,
токены промпта, сколько из них Ollama взяла из кэша префикса и сколько секунд ушло на
чтение остальных, для summary отдельно цена самого сжатия. Кэш здесь не сбивается
намеренно: очистка и резюме переписывают начало истории, и кэш префикса после них
перестаёт работать, это часть цены компакции.
"""
import json
import os
import sys
import time
import urllib.request

OLLAMA = os.environ.get("OLLAMA_URL", "http://localhost:11434")
MODEL = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:7b"
NUM_CTX = 8192
KEEP_LAST = 2   # сколько последних шагов с инструментами оставлять нетронутыми

SYSTEM = ("Ты агент-аналитик. Работаешь с базой платежей инструментами run_sql и read_logs. "
          "Отвечай кратко и только по фактам из истории.")
TASK = ("Собери отчёт по ошибкам сервиса payments за неделю 2026-10-26 - 2026-11-01. "
        "Требования к отчёту: формат CSV, разделитель точка с запятой, кодировка UTF-8, "
        "файл положить в каталог /reports/payments. Ошибки таймаута в отчёт не включать.")

QUESTIONS = [
    ("требование", "Перед сохранением: в каком формате, с каким разделителем и в какой каталог "
                   "сохранить отчёт? Ответь одной строкой.",
     lambda a: "csv" in a.lower() and ("точк" in a.lower() or ";" in a) and "/reports/payments" in a),
    ("деталь", "Сколько строк вернул самый первый SQL-запрос? Ответь одним числом.",
     lambda a: "1287" in a.replace(" ", "")),
]


def log_lines(n, start, code):
    # многословный вывод, как у настоящего read_logs: время, уровень, trace id, текст
    return "\n".join(f"2026-10-{start + i % 5:02d}T0{i % 10}:1{i % 6}:2{i % 9}Z ERROR payments "
                     f"trace={code}{i:04d}ab7f code={code} msg=\"upstream {code} for merchant m{100 + i}\""
                     for i in range(n))


def sql_rows(n):
    return "\n".join(f"| {d} | {c} | {cnt} |" for d, c, cnt in
                     [(f"2026-10-{26 + i % 6}", ["DECLINED", "TIMEOUT", "FRAUD", "5XX"][i % 4], 40 + i * 13)
                      for i in range(n)])


# шесть шагов агента: вызов инструмента и его многословный результат
STEPS = [
    ("run_sql", {"query": "SELECT * FROM payment_errors WHERE ts BETWEEN '2026-10-26' AND '2026-11-01'"},
     "Запрос выполнен за 2.4 с. Возвращено строк: 1287.\n| day | code | count |\n" + sql_rows(12)),
    ("run_sql", {"query": "SELECT code, count(*) FROM payment_errors GROUP BY code"},
     "| code | count |\n| DECLINED | 611 |\n| TIMEOUT | 402 |\n| FRAUD | 158 |\n| 5XX | 116 |\nВсего 4 строки."),
    ("read_logs", {"service": "payments", "level": "ERROR", "limit": 14},
     log_lines(14, 26, "5XX")),
    ("read_logs", {"service": "payments-gateway", "level": "ERROR", "limit": 14},
     log_lines(14, 27, "DECLINED")),
    ("run_sql", {"query": "SELECT merchant_id, count(*) FROM payment_errors WHERE code='FRAUD' GROUP BY 1 ORDER BY 2 DESC LIMIT 10"},
     "| merchant_id | count |\n" + "\n".join(f"| m{200 + i} | {30 - i * 2} |" for i in range(10))),
    ("run_sql", {"query": "SELECT count(*) FROM payment_errors WHERE code <> 'TIMEOUT'"},
     "| count |\n| 885 |"),
]


def history():
    msgs = [{"role": "user", "content": TASK}]
    for name, args, result in STEPS:
        msgs.append({"role": "assistant", "content": "",
                     "tool_calls": [{"function": {"name": name, "arguments": args}}]})
        msgs.append({"role": "tool", "content": result})
    msgs.append({"role": "assistant", "content": "Данные собраны: 885 ошибок без таймаутов, "
                                                 "разбивка по кодам и топ мерчантов по FRAUD готовы."})
    return msgs


def chat(messages, num_predict):
    body = {"model": MODEL, "messages": messages, "stream": False, "keep_alive": "60m",
            "options": {"temperature": 0, "seed": 42, "num_ctx": NUM_CTX, "num_predict": num_predict}}
    req = urllib.request.Request(f"{OLLAMA}/api/chat", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=1800) as resp:
        return json.load(resp)


def cleared(msgs):
    # tool result clearing: старые выводы инструментов заменяются заглушкой, вызовы остаются
    tool_idx = [i for i, m in enumerate(msgs) if m["role"] == "tool"]
    out = [dict(m) for m in msgs]
    for i in tool_idx[:-KEEP_LAST]:
        out[i]["content"] = "[вывод инструмента очищен, вызов можно повторить]"
    return out


def summarized(msgs):
    # компакция: модель сама пишет резюме ранней истории, два последних шага остаются как есть
    cut = [i for i, m in enumerate(msgs) if m["role"] == "assistant" and m.get("tool_calls")][-KEEP_LAST]
    early, tail = msgs[:cut], msgs[cut:]
    prompt = [{"role": "system", "content": SYSTEM}] + early + [{"role": "user", "content":
              "Сожми историю выше для продолжения работы. Сохрани требования пользователя, "
              "принятые решения и ключевые числа. Не больше 80 слов."}]
    t = time.time()
    r = chat(prompt, num_predict=160)
    summary = r["message"]["content"].strip()
    print(f"сжатие: прочитано {r['prompt_eval_count']} токенов (из кэша "
          f"{r.get('prompt_eval_cached_count', 0)}), написано {r['eval_count']}, "
          f"{time.time() - t:.1f} с")
    print("резюме:", summary.replace("\n", " "))
    return [{"role": "user", "content": f"Резюме предыдущей работы:\n{summary}"}] + tail


def main():
    full = history()
    print(f"модель {MODEL}, num_ctx {NUM_CTX}, шагов с инструментами {len(STEPS)}, KEEP_LAST {KEEP_LAST}")
    variants = [("full", full), ("clear", cleared(full)), ("summary", summarized(full))]
    for name, msgs in variants:
        for qname, q, check in QUESTIONS:
            t = time.time()
            r = chat([{"role": "system", "content": SYSTEM}] + msgs + [{"role": "user", "content": q}], 40)
            a = r["message"]["content"].strip().replace("\n", " ")
            print(f"{name:<8} {qname:<11} токенов промпта {r['prompt_eval_count']:>5}  "
                  f"из кэша {r.get('prompt_eval_cached_count', 0):>5}  "
                  f"префилл {r['prompt_eval_duration'] / 1e9:6.1f} с  всего {time.time() - t:6.1f} с  "
                  f"верно {'да ' if check(a) else 'нет'}  ответ: {a[:80]}")


if __name__ == "__main__":
    main()
модель qwen2.5:7b, num_ctx 8192, шагов с инструментами 6, KEEP_LAST 2
сжатие: прочитано 2138 токенов (из кэша 3), написано 65, 230.1 с
резюме: Сбор данных за 2026-10-26 по 2026-11-01. Ошибки: DECLINED 611, 5XX 116, FRAUD 158. Таймауты исключены.
full     требование  токенов промпта  2419  из кэша  2096  префилл   36.9 с  всего   47.1 с  верно да   ответ: Формат CSV, разделитель точка с запятой, каталог /reports/payments.
full     деталь      токенов промпта  2406  из кэша  2380  префилл    5.0 с  всего    7.1 с  верно да   ответ: 1287
clear    требование  токенов промпта   753  из кэша   209  префилл   46.8 с  всего   54.9 с  верно да   ответ: Формат CSV, разделитель точка с запятой, каталог /reports/payments.
clear    деталь      токенов промпта   740  из кэша   714  префилл    3.6 с  всего    4.8 с  верно нет  ответ: 885
summary  требование  токенов промпта   455  из кэша    54  префилл   44.7 с  всего   56.2 с  верно нет  ответ: Формат CSV, разделитель запятая, каталог /reports/payment_errors.
summary  деталь      токенов промпта   442  из кэша   416  префилл    4.2 с  всего    5.3 с  верно нет  ответ: 10
Очистка выводов уменьшила окно с 2419 до 753 токенов, в 3.2 раза, и сохранила требование, потому что оно лежало в сообщении пользователя, а не в выводе инструмента. Число 1287 исчезло вместе с выводом, и модель уверенно ответила 885, числом, которое в окне осталось. Резюме сжало окно до 455 токенов, в 5.3 раза, и потеряло оба факта, хотя промпт сжатия прямо требовал сохранить требования и ключевые числа. Разделитель и каталог модель заменила правдоподобной выдумкой, а само сжатие заняло 230.1 секунды. Прогон сделан на одной модели, поэтому цифры иллюстрируют механизм и бенчмарком не являются.
Заключение
Context engineering переносит внимание с формулировки промпта на состав всего окна, которое модель читает на каждом шаге. Основные приёмы это отбор, сжатие истории, память вне окна и изоляция в субагентах. Отбор трёх заметок вместо 36 дал тот же ответ при промпте в 8.5 раза короче, а очистка и резюме истории сократили окно в 3.2 и 5.3 раза ценой потерянных фактов. Большое окно эту работу не отменяет, потому что точность вспоминания падает по мере его заполнения, а каждый лишний токен оплачивается при каждом вызове.