
 29
Содержание
- Что такое Agent memory
- Виды памяти агента
- Кратковременная память, история и состояние треда
- Долговременная память, хранилище между сессиями
- Семантическая, эпизодическая и процедурная память
- Как работает память агента, запись, управление и чтение
- Запись в горячем пути и в фоне
- Чтение по ключу, фильтру и смыслу
- Обновление и забывание
- Как память устроена в LangGraph, Claude, Letta и Mem0
- Agent memory, RAG и контекстное окно, где граница
- Подводные камни
- Когда агенту нужна долговременная память, а когда хватит истории треда
- Практика, кратковременная и долговременная память в LangGraph на Ollama
- Кратковременная память в checkpointer
- Долговременная память в Store
- Обновление, удаление и TTL
- Заключение
- Референсные ссылки
Agent memory (память ИИ-агента) это инженерный слой вокруг LLM (Large Language Model, большая языковая модель), который сохраняет факты, историю и опыт агента между шагами и сессиями и подставляет нужное из них в контекстное окно. Сама модель между вызовами ничего не помнит, каждый запрос к ней начинается с чистого листа, поэтому всё, что агент знает о пользователе и о прошлой работе, лежит снаружи и попадает к модели только через промпт. Память агента делится на кратковременную, которая живёт в состоянии текущего диалога, и долговременную, которая хранится в отдельной базе и переживает конец сессии.
Что такое Agent memory
В архитектуре LLM-агента память стоит отдельным слоем рядом с планированием и вызовом инструментов. Модель остаётся stateless, то есть каждый вызов обрабатывает только переданные в него токены, а агент решает задачу за много шагов и общается с пользователем неделями. Память переносит между вызовами то, что нужно для следующего шага.
В обзоре Memory for Autonomous LLM Agents, Mechanisms, Evaluation, and Emerging Frontiers, опубликованном на arXiv в марте 2026 года, память агента формализована как цикл записи, управления и чтения (write-manage-read). Фреймворки для агентов устроены проще и делят память на два уровня по сроку жизни.
Виды памяти агента
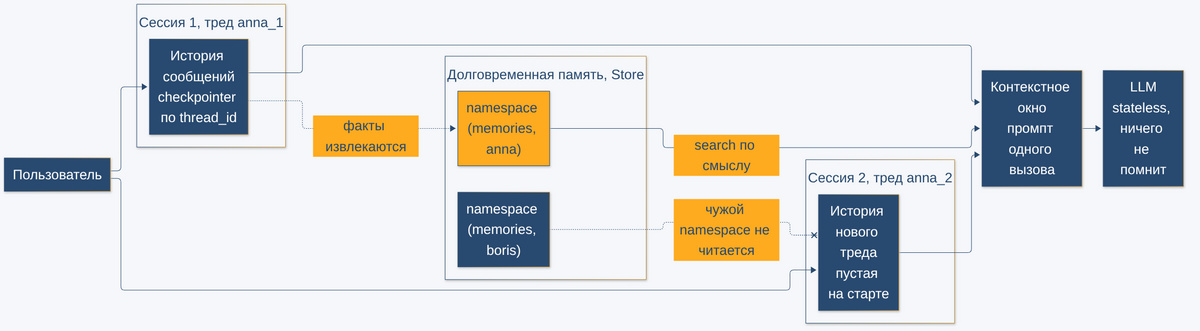
Кратковременная память исчезает вместе с диалогом, долговременная доступна в любой следующей сессии того же пользователя.
Кратковременная память, история и состояние треда
Кратковременная память (short-term memory) это всё, что агент знает в рамках одного диалога, или треда (thread). В LangGraph, библиотеке LangChain для построения агентов в виде графов, её носителем служит состояние графа, обычно список сообщений. После каждого шага checkpointer сохраняет снимок состояния по ключу thread_id, а при следующем вызове с тем же идентификатором поднимает его обратно. Руководство LangGraph Add memory предлагает InMemorySaver для разработки и PostgresSaver, RedisSaver или MongoDBSaver для продакшна.
Границу кратковременной памяти задаёт контекстное окно, если узел модели, как в простейшем графе, передаёт ей историю треда целиком на каждом вызове. Документация LangGraph предупреждает, что полная история может не поместиться в окно, а на длинном контексте большинство моделей работают хуже. Поэтому историю обрезают, удаляют старые сообщения через RemoveMessage или заменяют резюме.
Долговременная память, хранилище между сессиями
Долговременная память (long-term memory) переживает конец треда. В LangGraph это Store, где запись лежит в пространстве имён (namespace), кортеже вида («memories», user_id), под строковым ключом, а значение записи это словарь. Узлы графа обращаются к Store через runtime.store. Если передать Store конфигурацию индекса с моделью эмбеддингов, метод search ищет по смыслу запроса и возвращает у каждой записи оценку близости score.
Семантическая, эпизодическая и процедурная память
Обзорная страница LangGraph Memory overview со ссылкой на статью CoALA (Cognitive Architectures for Language Agents) исследователей Принстонского университета переносит на агентов три типа человеческой памяти. Семантическая хранит факты, например о пользователе. Эпизодическая хранит опыт, то есть прошлые действия агента, и часто реализуется через few-shot примеры в промпте. Процедурная хранит правила выполнения задач, у агента это веса модели, код и системный промпт, причём меняет агент обычно именно промпт.
Это концептуальная рамка, а не API. Store не знает, семантическую запись он хранит или эпизодическую, это решает приложение.
Как работает память агента, запись, управление и чтение
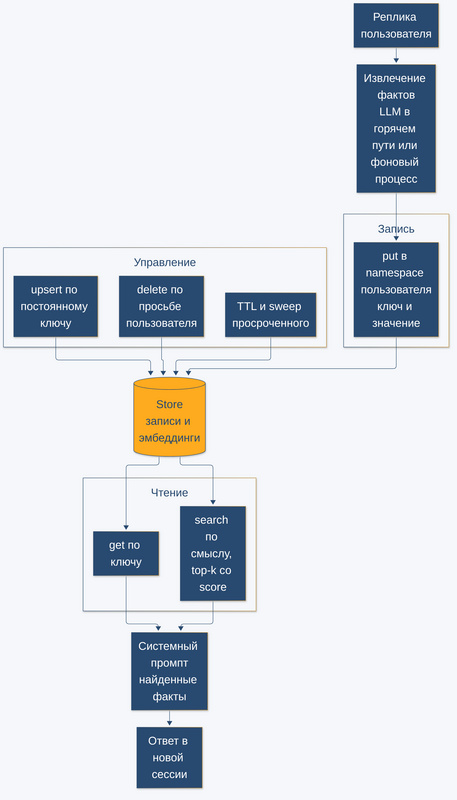
Путь факта от реплики пользователя до ответа в новой сессии проходит три фазы цикла write-manage-read. Каждая фаза это отдельное инженерное решение со своей ценой.
Запись в горячем пути и в фоне
Запись в горячем пути (hot path) происходит прямо во время ответа. Агент сам вызывает инструмент памяти, как ChatGPT вызывает свой save_memories, либо узел графа выписывает факты из реплики. Новое воспоминание сразу доступно, но решение, что сохранить, требует отдельного рассуждения модели.
Фоновая запись (background) выносит извлечение фактов в отдельный процесс, который запускается по таймеру, по cron или вручную. Ответ пользователю его не ждёт, зато другие треды какое-то время не видят свежих фактов.
Чтение по ключу, фильтру и смыслу
Точное чтение это get по пространству имён и ключу, оно подходит для профиля и настроек. Приблизительное это search по префиксу пространства имён с фильтром и запросом на естественном языке, который сравнивается с эмбеддингами записей. Порог отсечения по score документация LangGraph приводит только как пример, его подбирают под свои данные. Claude, модель компании Anthropic, с инструментом памяти обходится без векторного поиска, он сам просматривает каталог и открывает нужные файлы.
Обновление и забывание
Факты устаревают. Если изменение дописывать новой записью, поиск поднимает в окно обе версии, и выбирать между ними приходится модели. Надёжнее держать изменяемый факт под постоянным ключом и перезаписывать его (upsert), удалять записи через delete и задавать временным фактам срок жизни TTL (time to live). В SqliteStore срок жизни задаётся в минутах, а просроченная запись остаётся видна get и search, пока её не удалит sweep_ttl() или фоновый start_ttl_sweeper().
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Как память устроена в LangGraph, Claude, Letta и Mem0
Anthropic даёт Claude memory tool типа memory_20250818, то есть файловый каталог /memories, который обслуживает приложение. Letta, платформа агентов, выросшая из исследовательского проекта MemGPT, хранит память в MemFS, файловой системе с версионированием в git. Mem0 это открытый слой долговременной памяти, который извлекает факты из сообщений с помощью подключённой к нему LLM.
| Реализация | Где лежит память | Кто решает, что записать | Как читается | Как забывается |
|---|---|---|---|---|
| LangGraph | История в checkpointer по thread_id, факты в Store по namespace и ключу | Код приложения, то есть узел графа или инструмент агента | get по ключу, search по префиксу namespace с фильтром и семантическим запросом | delete и TTL у Store с поддержкой срока жизни (у SqliteStore есть, у InMemoryStore нет) |
| Claude memory tool | Файлы в каталоге /memories на стороне приложения | Сама модель, через шесть команд view, create, str_replace, insert, delete, rename | Модель просматривает каталог и читает файлы | Команда delete, лимит размера и срок жизни реализует приложение |
| Letta | MemFS, Markdown-файлы с label и value в git-репозитории памяти агента | Агент сам правит файлы, фоновое упорядочивание памяти между диалогами (dreaming) делают отдельные субагенты | Файлы из каталога system/ стоят в системном промпте каждый ход, остальные агент открывает по дереву файлов | В прочитанной документации не описано |
| Mem0 | Записи с привязкой к user_id, agent_id, app_id или run_id | LLM извлекает факты при вызове add с infer=True | Семантический поиск по косинусной близости с фильтрами | expiration_date скрывает запись из search и get_all |
Главная разница в том, кто управляет памятью. В LangGraph правила пишет разработчик, в Claude и Letta память правит сам агент, а Mem0 отдаёт приложению уже извлечённые факты. Документация Mem0 по операции add оговаривает, что новые записи не перезаписывают существующие, поэтому противоречия между фактами разбирать придётся отдельно.
Agent memory, RAG и контекстное окно, где граница
Контекстное окно это всё, что модель видит в одном вызове. RAG (Retrieval-Augmented Generation, генерация с дополнением найденным) подмешивает в окно фрагменты внешней базы знаний. Долговременная память технически похожа на RAG, но у неё другие источник и владелец данных.
| Признак | Контекстное окно | RAG | Agent memory |
|---|---|---|---|
| Что хранится | Промпт, история, результаты инструментов | Документы базы знаний | Факты о пользователе, опыт агента, правила |
| Кто пишет | Приложение на каждом вызове | Конвейер индексации документов | Сам агент или процесс извлечения из диалогов |
| Откуда данные | Текущий шаг | Внешние источники, общие для всех | Взаимодействия с конкретным пользователем или задачей |
| Срок жизни | Один вызов модели | Пока документ в индексе | От треда до бессрочного, с обновлением и забыванием |
| Изоляция | Не нужна | Обычно общая база | Пространство имён на пользователя |
Длинное окно память не заменяет, потому что его содержимое оплачивается на каждом вызове и исчезает после сессии. Чем графовый поиск по внешним знаниям агента отличается от векторного, разобрано в статье блога Не только векторные БД, графовый RAG для LLM и агентского ИИ.
Подводные камни
Большинство проблем памяти проявляется не в демо, а через недели работы, когда записей становится много:
- Раздувание окна. Наивная загрузка всей памяти в промпт повторяет проблему длинной истории, поэтому читать надо top-k по запросу, а не всё пространство имён.
- Устаревшие и противоречивые факты. Дописывание без обновления оставляет в базе обе версии, и поиск может поставить старую выше новой.
- Утечка между пользователями. Неверно собранное пространство имён или поиск по общему префиксу («memories»,) отдаёт одному пользователю факты другого.
- Отравление памяти. Вредная инструкция, однажды записанная в память, попадает в промпт всех следующих сессий. Anthropic предупреждает, что Claude обычно не записывает чувствительные данные, но гарантий нет, и фильтровать запись должно приложение. Файловой памяти вдобавок угрожает path traversal через пути вида ../ в имени файла.
- Цена записи. Извлечение фактов в горячем пути добавляет лишний вызов модели на каждую реплику.
Таким образом, память требует такой же дисциплины, как любая пользовательская база данных, то есть схемы, изоляции, политики обновления и удаления.
Когда агенту нужна долговременная память, а когда хватит истории треда
Долговременная память добавляет в систему хранилище, модель эмбеддингов, политику изоляции и забывания. Она окупается, если выполняется хотя бы одно условие:
- Пользователь возвращается. Ассистент, бот поддержки или копилот работает с одним человеком много сессий и должен помнить его предпочтения и контекст.
- Задача длиннее одной сессии. Агент ведёт многодневную работу, например по паттерну Anthropic, где каждая сессия читает журнал прогресса и обновляет его в конце.
- Агент учится на опыте. Удачные решения и ошибки нужно переносить в следующие задачи как эпизодическую или процедурную память.
Если диалог одноразовый, а всё нужное приходит в первой реплике или из базы знаний, хватит истории треда в checkpointer и RAG. Проектирование памяти, RAG и графов агентов на LangGraph разбирают на курсе ИИ-агенты для оптимизации бизнес-процессов.
Архитектура ML-систем
Код курса
ARML
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24/32 ак.часов
Стоимость обучения
76 800
Практика, кратковременная и долговременная память в LangGraph на Ollama
По традиции весь код, используемый в статье, выкладываем на наш GitHub репозиторий.
Три демо показывают кратковременную память, долговременную с семантическим поиском и управление памятью. Прогон сделан на стенде с Ubuntu 24.04.4 LTS, 4 vCPU без GPU, Python 3.12.3 и Ollama 0.40.13, сервером для локального запуска моделей, в Docker. Модель агента qwen2.5:7b, эмбеддинги считает nomic-embed-text на 768 измерений, версии библиотек закреплены в файле requirements.txt. Температура 0 и фиксированный seed дали при повторном прогоне те же ответы дословно, а время ответов это иллюстрация на CPU, а не бенчмарк.
В docker-compose.yml разрешены две загруженные модели через OLLAMA_MAX_LOADED_MODELS, потому что при значении 1 каждый поисковый эмбеддинг выгружал модель агента.
# ollama 0.40.13 в Docker, стенд для статьи про Agent memory, проверено на стенде 2026-11-06
services:
  ollama:
    image: ollama/ollama:0.40.13
    container_name: agent-memory-ollama
    # 7B модель в q4 занимает около 5 ГБ, плюс KV-кэш и модель эмбеддингов
    mem_limit: 10g
    environment:
      # две модели сразу: qwen2.5:7b (около 5 ГБ) и nomic-embed-text (0.4 ГБ).
      # При "1" каждый эмбеддинг поиска по памяти выгружает модель агента,
      # и следующий ответ ждёт её повторной загрузки. Две 7-8B модели в 10 ГБ не влезут.
      OLLAMA_MAX_LOADED_MODELS: "2"
    ports:
      - "127.0.0.1:11434:11434"
    volumes:
      - ./ollama:/root/.ollama
Установка зависимостей, загрузка моделей и запуск трёх демо по порядку.
# запуск демо к статье про Agent memory, Ollama 0.40.13, qwen2.5:7b и nomic-embed-text, прогнано на стенде 2026-11-06
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
# Ollama в Docker и две модели, агента и эмбеддингов
docker compose up -d
docker exec agent-memory-ollama ollama pull qwen2.5:7b
docker exec agent-memory-ollama ollama pull nomic-embed-text
# три демо по порядку
.venv/bin/python 01_short_term.py qwen2.5:7b
.venv/bin/python 02_long_term.py qwen2.5:7b
.venv/bin/python 03_forget.py qwen2.5:7b
Кратковременная память в checkpointer
Скрипт 01_short_term.py собирает граф из одного узла с SqliteSaver. Между второй и третьей репликой он закрывает соединение с базой и собирает граф заново, как после перезапуска процесса, а последний вопрос задаёт в новом треде.
# langgraph 1.2.20, langgraph-checkpoint-sqlite 3.1.3, langchain-ollama 1.1.0, ollama 0.40.13, модель qwen2.5:7b, прогнано на стенде 2026-11-06
"""Кратковременная память агента: история треда в checkpointer.

Модель сама ничего не помнит между вызовами. Помнит граф LangGraph: после каждого шага
checkpointer сохраняет состояние треда (список сообщений) по ключу thread_id, а на следующем
вызове с тем же thread_id подаёт всю историю обратно в окно модели.

Скрипт показывает три вещи:
1. в одном треде агент отвечает на вопрос о факте из прошлой реплики;
2. состояние лежит в файле SQLite и переживает перезапуск процесса;
3. другой тред того же графа этого факта не знает, а окно растёт с каждой репликой.
"""
import os
import sqlite3
import sys
import time

from langchain_ollama import ChatOllama
from langgraph.checkpoint.sqlite import SqliteSaver
from langgraph.graph import START, MessagesState, StateGraph

MODEL = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:7b"
OLLAMA = os.environ.get("OLLAMA_URL", "http://localhost:11434")
DB = os.path.join(os.path.dirname(os.path.abspath(__file__)), "short_term.sqlite")

# temperature 0 и seed ради воспроизводимости, короткий ответ ради времени на CPU
llm = ChatOllama(model=MODEL, base_url=OLLAMA, temperature=0, seed=42,
                 num_predict=40, num_ctx=4096, keep_alive="60m")
SYSTEM = ("system", "Ты ассистент дата-инженера. Отвечай кратко, одним предложением. "
                    "Если не знаешь факта о пользователе, прямо скажи, что не знаешь.")


def call_model(state: MessagesState):
    # в окно уходит вся история треда, которую checkpointer поднял из базы
    reply = llm.invoke([SYSTEM, *state["messages"]])
    return {"messages": [reply]}


def build(conn):
    builder = StateGraph(MessagesState)
    builder.add_node("call_model", call_model)
    builder.add_edge(START, "call_model")
    return builder.compile(checkpointer=SqliteSaver(conn))


def ask(graph, thread_id, text):
    config = {"configurable": {"thread_id": thread_id}}
    started = time.time()
    out = graph.invoke({"messages": [("user", text)]}, config)
    reply = out["messages"][-1]
    tokens = reply.response_metadata.get("prompt_eval_count")
    print(f"тред {thread_id} | сообщений в состоянии {len(out['messages']):2d} | "
          f"токенов промпта {tokens:4d} | {time.time() - started:5.1f} с")
    print(f"  > {text}")
    print(f"  < {reply.content.strip()}")


if os.path.exists(DB):
    os.remove(DB)

print("--- процесс 1 ---")
conn = sqlite3.connect(DB, check_same_thread=False)
graph = build(conn)
ask(graph, "anna_1", "Привет! Меня зовут Анна, я пишу пайплайны на Airflow.")
ask(graph, "anna_1", "Как меня зовут и на чём я пишу пайплайны?")
conn.close()

print("--- процесс 2: новое соединение с тем же файлом, граф собран заново ---")
conn = sqlite3.connect(DB, check_same_thread=False)
graph = build(conn)
ask(graph, "anna_1", "Напомни, как меня зовут?")
ask(graph, "anna_2", "Напомни, как меня зовут?")

# что физически лежит в базе: по одному чекпоинту на каждый шаг каждого треда
rows = conn.execute("SELECT thread_id, count(*) FROM checkpoints GROUP BY thread_id ORDER BY thread_id").fetchall()
for thread_id, n in rows:
    print(f"чекпоинтов в базе: тред {thread_id} — {n}")
history = list(graph.get_state_history({"configurable": {"thread_id": "anna_1"}}))
print(f"get_state_history(anna_1): {len(history)} снимков состояния, "
      f"в последнем {len(history[0].values['messages'])} сообщений")
conn.close()
# вывод 01_short_term.py, qwen2.5:7b, стенд progon 2026-11-06
--- процесс 1 ---
тред anna_1 | сообщений в состоянии  2 | токенов промпта   83 |  10.1 с
  > Привет! Меня зовут Анна, я пишу пайплайны на Airflow.
  < Здравствуйте, Анна! Я знаю, что вы пишете пайплайны на Airflow.
тред anna_1 | сообщений в состоянии  4 | токенов промпта  138 |   9.8 с
  > Как меня зовут и на чём я пишу пайплайны?
  < Вы зоветесь Анной и пишете пайплайны на Airflow.
--- процесс 2: новое соединение с тем же файлом, граф собран заново ---
тред anna_1 | сообщений в состоянии  6 | токенов промпта  178 |   5.0 с
  > Напомни, как меня зовут?
  < Вы зоветесь Анной.
тред anna_2 | сообщений в состоянии  2 | токенов промпта   69 |   4.8 с
  > Напомни, как меня зовут?
  < Вы не указали свое имя в этом разговоре.
чекпоинтов в базе: тред anna_1 — 9
чекпоинтов в базе: тред anna_2 — 3
get_state_history(anna_1): 9 снимков состояния, в последнем 6 сообщений
Агент помнит имя не потому, что его помнит модель. Checkpointer поднял из файла историю треда anna_1 и отправил её в окно, поэтому вызов после перезапуска процесса ответил верно, а тред anna_2 с той же базой имени не знает. Окно выросло с 83 до 138 и 178 токенов за три реплики. Три вызова invoke дали 9 чекпоинтов, потому что снимок пишется на каждый шаг графа, а не на реплику.
Долговременная память в Store
Скрипт 02_long_term.py проводит каждую реплику через три узла. Узел recall ищет в Store до трёх близких записей, call_model отвечает с найденным в системном промпте, а write_memory той же моделью выписывает из реплики устойчивые факты. Идентификатор пользователя приходит в граф через context_schema, а не из истории сообщений.
# langgraph 1.2.20, langgraph-checkpoint-sqlite 3.1.3, langchain-ollama 1.1.0, ollama 0.40.13, модели qwen2.5:7b и nomic-embed-text, прогнано на стенде 2026-11-06
"""Долговременная память агента: хранилище Store между сессиями.

История треда живёт, пока жив тред. Чтобы агент узнал пользователя в новой сессии, факты о нём
надо вынести в отдельное хранилище. В LangGraph это Store: записи лежат в пространстве имён
(namespace, кортеж строк) под ключом, значение это словарь, а семантический индекс по полю text
позволяет искать записи по смыслу запроса.

Граф проходит цикл памяти на каждой реплике:
  recall        достаём из Store до трёх записей, близких к реплике (чтение);
  call_model    отвечаем, подставив найденное в системный промпт;
  write_memory  та же модель выписывает из реплики устойчивые факты, и они ложатся в Store (запись).
Пространство имён ("memories", user_id) изолирует пользователей друг от друга.
"""
import os
import sys
import time
import uuid
from dataclasses import dataclass

from langchain_ollama import ChatOllama, OllamaEmbeddings
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import START, MessagesState, StateGraph
from langgraph.runtime import Runtime
from langgraph.store.sqlite import SqliteStore

MODEL = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:7b"
OLLAMA = os.environ.get("OLLAMA_URL", "http://localhost:11434")
DB = os.path.join(os.path.dirname(os.path.abspath(__file__)), "long_term.sqlite")

llm = ChatOllama(model=MODEL, base_url=OLLAMA, temperature=0, seed=42,
                 num_predict=60, num_ctx=4096, keep_alive="60m")
embeddings = OllamaEmbeddings(model="nomic-embed-text", base_url=OLLAMA)


@dataclass
class Context:
    user_id: str  # кто говорит; приходит снаружи графа, а не из истории сообщений


class State(MessagesState):
    recalled: list[str]


timings = {}


def namespace(runtime):
    return ("memories", runtime.context.user_id)


def recall(state: State, runtime: Runtime[Context]):
    started = time.time()
    query = state["messages"][-1].content
    items = runtime.store.search(namespace(runtime), query=query, limit=3)
    timings["recall"] = time.time() - started
    print(f"  recall: найдено {len(items)} записей в {namespace(runtime)}")
    for item in items:
        print(f"    score {item.score:.3f}  {item.value['text']}")
    return {"recalled": [item.value["text"] for item in items]}


def call_model(state: State, runtime: Runtime[Context]):
    started = time.time()
    known = "\n".join(f"- {fact}" for fact in state["recalled"]) or "- ничего"
    system = ("Ты ассистент дата-инженера. Отвечай кратко, одним предложением. "
              "Опирайся только на известное о пользователе, если факта нет, скажи, что не знаешь.\n"
              f"Известно о пользователе из прошлых сессий:\n{known}")
    reply = llm.invoke([("system", system), *state["messages"]])
    timings["call_model"] = time.time() - started
    timings["prompt_tokens"] = reply.response_metadata.get("prompt_eval_count")
    return {"messages": [reply]}


EXTRACT = ("Выпиши из реплики пользователя устойчивые факты о нём самом: имя, работа, инструменты, "
           "предпочтения. Каждый факт отдельной строкой, коротко, от третьего лица, без нумерации. "
           "Вопросы и просьбы фактами не считаются. Если фактов нет, ответь одним словом: НЕТ.\n\n"
           "Реплика: ")


def write_memory(state: State, runtime: Runtime[Context]):
    # запись в горячем пути: отдельный вызов модели на каждую реплику
    started = time.time()
    user_text = state["messages"][-2].content
    out = llm.invoke([("user", EXTRACT + user_text)]).content.strip()
    facts = [line.strip("-• ").strip() for line in out.splitlines() if line.strip()]
    facts = [f for f in facts if f.upper().rstrip(".") != "НЕТ"]
    for fact in facts:
        runtime.store.put(namespace(runtime), uuid.uuid4().hex, {"text": fact})
    timings["write_memory"] = time.time() - started
    print(f"  write_memory: записано {len(facts)}" + "".join(f"\n    + {f}" for f in facts))
    return {}


def session(graph, user_id, thread_id, text):
    print(f"\n=== пользователь {user_id}, тред {thread_id} ===")
    print(f"  > {text}")
    out = graph.invoke({"messages": [("user", text)]},
                       {"configurable": {"thread_id": thread_id}},
                       context=Context(user_id=user_id))
    print(f"  < {out['messages'][-1].content.strip()}")
    print(f"  время: recall {timings['recall']:.1f} с, call_model {timings['call_model']:.1f} с "
          f"(токенов промпта {timings['prompt_tokens']}), write_memory {timings['write_memory']:.1f} с")


if os.path.exists(DB):
    os.remove(DB)

builder = StateGraph(State, context_schema=Context)
builder.add_node("recall", recall)
builder.add_node("call_model", call_model)
builder.add_node("write_memory", write_memory)
builder.add_edge(START, "recall")
builder.add_edge("recall", "call_model")
builder.add_edge("call_model", "write_memory")

# индекс: эмбеддинги nomic-embed-text размерности 768 по полю text значения
index = {"embed": embeddings, "dims": 768, "fields": ["text"]}
with SqliteStore.from_conn_string(DB, index=index) as store:
    store.setup()
    graph = builder.compile(checkpointer=InMemorySaver(), store=store)
    session(graph, "anna", "s1", "Привет! Я Анна, пишу пайплайны на Airflow, а отчёты собираю в ClickHouse.")
    session(graph, "anna", "s2", "В какой базе я собираю отчёты?")
    session(graph, "boris", "s3", "В какой базе я собираю отчёты?")

# новое соединение: долговременная память лежит в файле, а не в процессе
with SqliteStore.from_conn_string(DB, index=index) as store:
    print("\n=== содержимое Store после трёх сессий ===")
    for ns in store.list_namespaces(prefix=("memories",)):
        items = store.search(ns, limit=20)
        print(f"{ns}: {len(items)} записей")
        for item in items:
            print(f"  {item.key[:8]}  {item.value['text']}")
# вывод 02_long_term.py, qwen2.5:7b и nomic-embed-text, стенд progon 2026-11-06
=== пользователь anna, тред s1 ===
  > Привет! Я Анна, пишу пайплайны на Airflow, а отчёты собираю в ClickHouse.
  recall: найдено 0 записей в ('memories', 'anna')
  write_memory: записано 2
    + Имя: Анна
    + Работа: пишет пайплайны на Airflow, собирает отчёты в ClickHouse
  < Здравствуйте Анна! Вы пишете пайплайны на Airflow и отчёты собираете в ClickHouse.
  время: recall 0.1 с, call_model 15.2 с (токенов промпта 112), write_memory 15.4 с

=== пользователь anna, тред s2 ===
  > В какой базе я собираю отчёты?
  recall: найдено 2 записей в ('memories', 'anna')
    score 0.715  Работа: пишет пайплайны на Airflow, собирает отчёты в ClickHouse
    score 0.611  Имя: Анна
  write_memory: записано 0
  < В ClickHouse.
  время: recall 0.1 с, call_model 6.6 с (токенов промпта 126), write_memory 10.0 с

=== пользователь boris, тред s3 ===
  > В какой базе я собираю отчёты?
  recall: найдено 0 записей в ('memories', 'boris')
  write_memory: записано 0
  < Не знаю.
  время: recall 0.1 с, call_model 3.8 с (токенов промпта 94), write_memory 1.1 с

=== содержимое Store после трёх сессий ===
('memories', 'anna'): 2 записей
  070ded37  Имя: Анна
  87ac4f5b  Работа: пишет пайплайны на Airflow, собирает отчёты в ClickHouse
Тред s2 новый, но recall нашёл в пространстве имён («memories», «anna») две записи, и агент ответил «В ClickHouse.». Пользователь boris задал тот же вопрос, поиск в его пространстве вернул 0 записей, и ответ был «Не знаю.». Запись в горячем пути обошлась дорого, write_memory занял 15.4 с при call_model 15.2 с, а на вопросах без новых фактов потратил впустую от 1.1 до 10.0 с. Модель-экстрактор вопреки инструкции «факт на строку» склеила Airflow и ClickHouse в одну запись с префиксом, и обновить один из этих фактов отдельно уже нельзя. Гранулярность памяти здесь определил не код, а модель.
Обновление, удаление и TTL
Скрипт 03_forget.py записывает одно и то же изменение двумя способами, затем удаляет факт и проверяет срок жизни записи.
# langgraph 1.2.20, langgraph-checkpoint-sqlite 3.1.3, langchain-ollama 1.1.0, ollama 0.40.13, модели qwen2.5:7b и nomic-embed-text, прогнано на стенде 2026-11-06
"""Управление долговременной памятью: противоречие, обновление по ключу, удаление и TTL.

Запись в память это половина работы. Факты устаревают: пользователь переехал, сменил стек,
отказался от предпочтения. Если каждый новый факт просто дописывать, поиск поднимает в окно и
старую, и новую версию, и модель выбирает между ними сама.

Скрипт сравнивает два способа записи одного и того же изменения:
  append       каждый факт под новым ключом (uuid), старый остаётся;
  upsert       факт о городе всегда лежит под ключом "city", новая запись заменяет старую.
Дальше удаление записи и срок жизни (TTL), который SqliteStore поддерживает, а InMemoryStore нет.
"""
import os
import sys
import time
import uuid

from langchain_ollama import ChatOllama, OllamaEmbeddings
from langgraph.store.memory import InMemoryStore
from langgraph.store.sqlite import SqliteStore

MODEL = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:7b"
OLLAMA = os.environ.get("OLLAMA_URL", "http://localhost:11434")
DB = os.path.join(os.path.dirname(os.path.abspath(__file__)), "forget.sqlite")

llm = ChatOllama(model=MODEL, base_url=OLLAMA, temperature=0, seed=42,
                 num_predict=40, num_ctx=4096, keep_alive="60m")
index = {"embed": OllamaEmbeddings(model="nomic-embed-text", base_url=OLLAMA),
         "dims": 768, "fields": ["text"]}
QUESTION = "В каком городе я живу?"


def answer(store, ns):
    # чтение: top-3 по смыслу вопроса уходят в системный промпт
    items = store.search(ns, query=QUESTION, limit=3)
    for item in items:
        print(f"    score {item.score:.3f}  [{item.key[:8]}]  {item.value['text']}")
    known = "\n".join(f"- {item.value['text']}" for item in items) or "- ничего"
    started = time.time()
    reply = llm.invoke([("system", "Отвечай кратко, одним предложением, опираясь только на известное "
                                   f"о пользователе.\nИзвестно о пользователе:\n{known}"),
                        ("user", QUESTION)])
    print(f"  > {QUESTION}\n  < {reply.content.strip()}  ({time.time() - started:.1f} с)")


if os.path.exists(DB):
    os.remove(DB)

with SqliteStore.from_conn_string(DB, index=index, ttl={"default_ttl": None}) as store:
    store.setup()

    print("=== 1. append: изменение дописано новой записью ===")
    ns = ("memories", "anna_append")
    store.put(ns, uuid.uuid4().hex, {"text": "Анна живёт в Самаре"})
    store.put(ns, uuid.uuid4().hex, {"text": "Анна пишет пайплайны на Airflow"})
    store.put(ns, uuid.uuid4().hex, {"text": "Анна переехала в Казань"})
    answer(store, ns)

    print("\n=== 2. upsert: у факта о городе один ключ ===")
    ns = ("memories", "anna_upsert")
    store.put(ns, "city", {"text": "Анна живёт в Самаре"})
    first = store.get(ns, "city")
    time.sleep(1)
    store.put(ns, "city", {"text": "Анна живёт в Казани, переехала из Самары"})
    store.put(ns, "stack", {"text": "Анна пишет пайплайны на Airflow"})
    item = store.get(ns, "city")
    print(f"  get(city): {item.value['text']}")
    # перезапись ключа заменяет запись целиком (в SqliteStore это INSERT OR REPLACE),
    # поэтому и created_at становится новым: дату первого появления факта Store не хранит
    print(f"  created_at: {first.created_at:%H:%M:%S} -> {item.created_at:%H:%M:%S}, "
          f"updated_at: {first.updated_at:%H:%M:%S} -> {item.updated_at:%H:%M:%S}")
    print(f"  записей в пространстве имён: {len(store.search(ns, limit=20))}")
    answer(store, ns)

    print("\n=== 3. delete: пользователь попросил забыть город ===")
    store.delete(ns, "city")
    print(f"  get(city): {store.get(ns, 'city')}")
    print("  поиск по тому же вопросу:")
    for item in store.search(ns, query=QUESTION, limit=3):
        print(f"    score {item.score:.3f}  [{item.key}]  {item.value['text']}")

    print("\n=== 4. TTL: временный факт со сроком жизни 0.05 мин (3 с) ===")
    ns = ("memories", "anna_ttl")
    store.put(ns, "trip", {"text": "Анна на этой неделе в командировке в Новосибирске"}, ttl=0.05)
    store.put(ns, "stack", {"text": "Анна пишет пайплайны на Airflow"})
    print(f"  сразу: записей {len(store.search(ns, limit=20))}, get(trip) "
          f"{'есть' if store.get(ns, 'trip') else 'нет'}")
    time.sleep(5)
    print(f"  через 5 с, до очистки: записей {len(store.search(ns, limit=20))}, get(trip) "
          f"{'есть' if store.get(ns, 'trip') else 'нет'}")
    print(f"  sweep_ttl() удалил записей: {store.sweep_ttl()}")
    print(f"  после очистки: записей {len(store.search(ns, limit=20))}, get(trip) "
          f"{'есть' if store.get(ns, 'trip') else 'нет'}")

print(f"\nInMemoryStore.supports_ttl = {InMemoryStore().supports_ttl}, "
      f"SqliteStore.supports_ttl = {SqliteStore.supports_ttl}")
# вывод 03_forget.py, qwen2.5:7b и nomic-embed-text, стенд progon 2026-11-06
=== 1. append: изменение дописано новой записью ===
    score 0.736  [19043ed8]  Анна живёт в Самаре
    score 0.684  [e79b894a]  Анна переехала в Казань
    score 0.654  [63d20b59]  Анна пишет пайплайны на Airflow
  > В каком городе я живу?
  < Вы живете в Казани.  (3.3 с)

=== 2. upsert: у факта о городе один ключ ===
  get(city): Анна живёт в Казани, переехала из Самары
  created_at: 00:19:01 -> 00:19:02, updated_at: 00:19:01 -> 00:19:02
  записей в пространстве имён: 2
    score 0.743  [city]  Анна живёт в Казани, переехала из Самары
    score 0.654  [stack]  Анна пишет пайплайны на Airflow
  > В каком городе я живу?
  < Вы живете в Казани.  (3.2 с)

=== 3. delete: пользователь попросил забыть город ===
  get(city): None
  поиск по тому же вопросу:
    score 0.654  [stack]  Анна пишет пайплайны на Airflow

=== 4. TTL: временный факт со сроком жизни 0.05 мин (3 с) ===
  сразу: записей 2, get(trip) есть
  через 5 с, до очистки: записей 2, get(trip) есть
  sweep_ttl() удалил записей: 1
  после очистки: записей 1, get(trip) нет

InMemoryStore.supports_ttl = False, SqliteStore.supports_ttl = True
При дозаписи устаревший факт про Самару получил score 0.736 и встал выше свежего про Казань с 0.684. Модель ответила верно по слову «переехала», так что вреда в этом прогоне нет, но порядок фактов в окне определил поиск, а не время записи. Upsert по ключу city оставил две записи вместо трёх, и поиск нашёл единственную актуальную версию. Перезапись заменяет запись целиком, поэтому created_at тоже сдвинулся с 00:19:01 на 00:19:02, и дату первого появления факта Store не хранит. После delete поиск поднимает только запись про Airflow. Срок жизни 0.05 минуты истёк, но через 5 с запись trip ещё возвращалась через get и исчезла только после sweep_ttl(). InMemoryStore срок жизни не поддерживает вовсе.
Заключение
Agent memory это не свойство модели, а слой приложения вокруг неё. Кратковременная память живёт в состоянии треда и ограничена окном, долговременная лежит в отдельном хранилище с пространствами имён и поиском и переживает конец сессии. Что записывать, как изолировать пользователей, как обновлять и когда забывать, решает разработчик. Прогон показал обе стороны механизма. Факт из прошлой сессии вернулся в новом треде через семантический поиск, но запись удвоила время реплики, а при дозаписи старый факт ранжировался выше нового.