2
Содержание
- Что рассказал Dremio и чего не хватает
- Три уровня статистики Iceberg
- Метрики колонок в манифестах
- NDV в файлах Puffin
- Статистика партиций
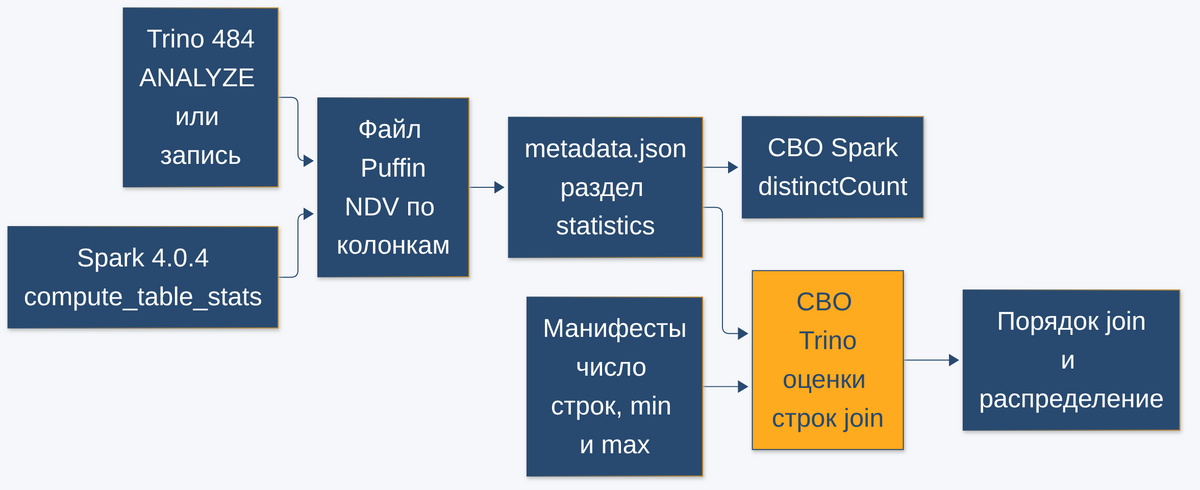
- Кто пишет и кто читает NDV
- Trino, ANALYZE и сбор при записи
- Spark и compute_table_stats
- Как статистика меняет план запроса
- Iceberg и альтернативы, где живёт статистика
- Практика, статистика на стенде Trino и Spark
- Стенд
- Таблицы без NDV
- ANALYZE и план до и после
- NDV от Spark в планах Trino
- Ограничения и подводные камни
- Когда запускать ANALYZE
- Заключение
- Референсные ссылки
12 октября 2026 года в блоге Dremio, компании-разработчика lakehouse-платформы поверх Apache Iceberg, вышел обзор того, как устроена статистика таблиц Iceberg (Iceberg table statistics) и почему оптимизатор запросов без неё работает вслепую. Обзор перечисляет виды статистики, но оставляет за кадром три практических вопроса. Кто именно пишет число уникальных значений колонки и кто его потом читает? Почему после обычной загрузки этого числа в таблице нет? И меняет ли оно хоть что-то в плане реального запроса? Мы подняли стенд с Trino 484, Spark 4.0.4 и Iceberg 1.10.1, загрузили эталонный набор TPC-H (бенчмарк аналитических запросов) с полутора миллионами заказов и посмотрели на план одного и того же join без статистики, после ANALYZE в Trino и после расчёта статистики в Spark. В статье разбираем три уровня статистики, формат Puffin изнутри, сравнение с Hive Metastore и Delta Lake и несколько неудобных результатов стенда.
Что рассказал Dremio и чего не хватает
Автор обзора статистики таблиц Iceberg в блоге Dremio Alex Merced из команды по работе с разработчиками делит статистику на три уровня. Метрики колонок лежат в манифестах и пишутся при каждом коммите. Число уникальных значений хранится в отдельных файлах Puffin и само не появляется. Статистика партиций помогает увидеть перекос данных. Отдельно автор советует пересчитывать статистику после компакции и крупных загрузок, потому что устаревшая оценка может навредить сильнее, чем её отсутствие.
Короткий пересказ обзора мы уже публиковали в новости о статистике NDV и файлах Puffin в Iceberg. Версий движков в обзоре нет, команд для Trino тоже нет, а примеры написаны для Spark. Поэтому здесь мы идём от механизма к стенду и проверяем каждое утверждение на живых таблицах.
Три уровня статистики Iceberg
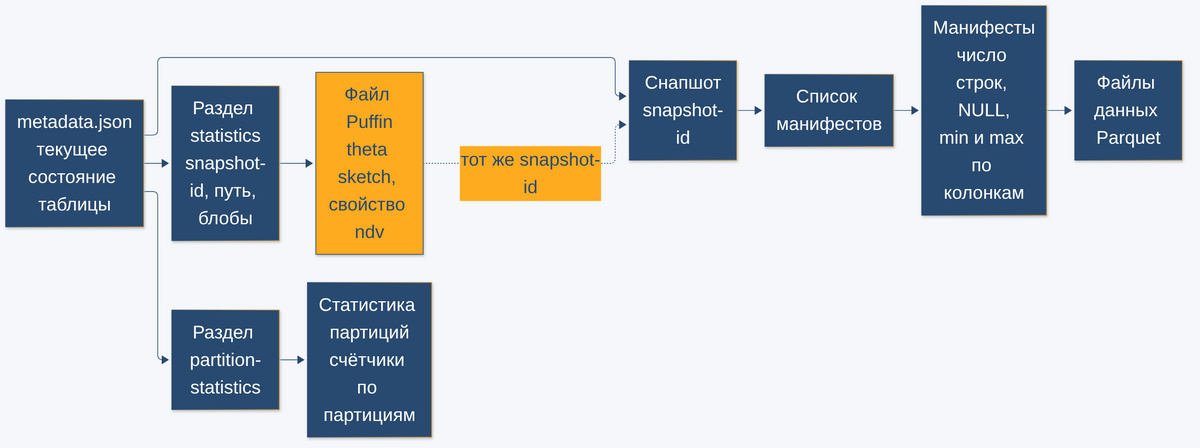
Таблица Iceberg это дерево метаданных. Каталог хранит указатель на текущий файл metadata.json, в нём перечислены снапшоты (snapshot), каждый снапшот ссылается на список манифестов (manifest list), а манифесты описывают файлы данных. Статистика живёт на разных ветках этого дерева, и от ветки зависит, кто её пишет и когда она устаревает.
Метрики колонок в манифестах
Для каждого файла данных манифест хранит число строк (record count), число значений и пустых значений по колонкам (value counts, null counts) и границы диапазона (lower bounds, upper bounds). Эти метрики пишет сам писатель таблицы при каждом коммите, будь то Trino, Spark или Flink, поэтому они есть всегда и всегда соответствуют снапшоту. Главное их назначение это пропуск файлов (file pruning): если фильтр просит даты 1995 года, а у файла верхняя граница 1993-12-31, файл не читается вовсе.
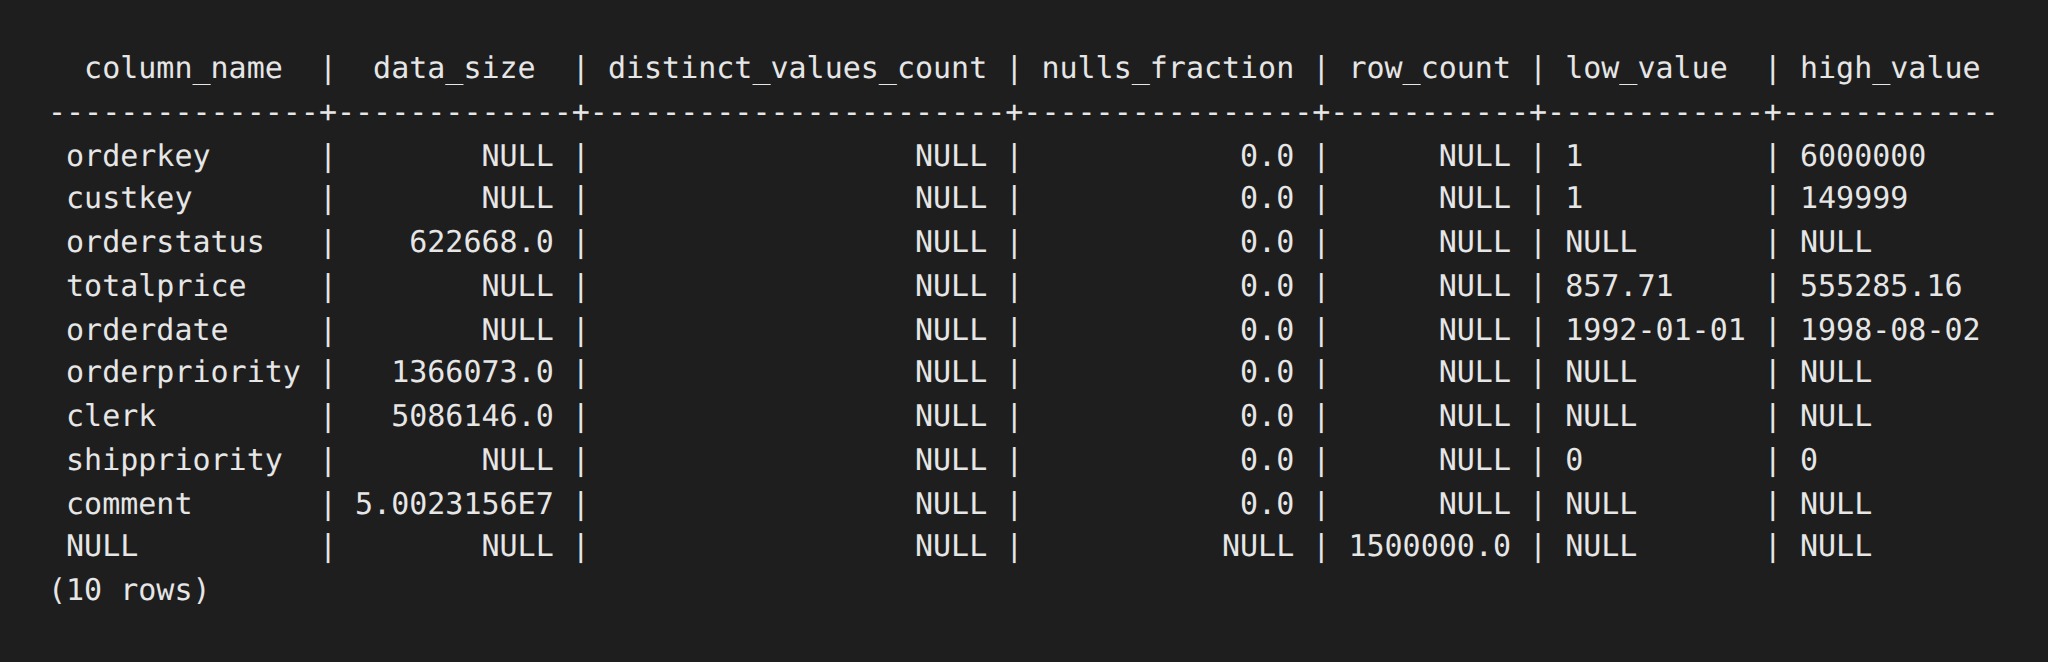
Из тех же метрик Trino собирает статистику для оптимизатора. На стенде таблица orders, загруженная без расчёта NDV, всё равно показывает в SHOW STATS число строк 1500000, долю пустых значений 0.0 и диапазоны вроде orderkey от 1 до 6000000. Чего из манифестов не достать, так это числа уникальных значений. Минимум и максимум по файлам не складываются в количество разных значений, а точный подсчёт требует прочитать всю колонку.
NDV в файлах Puffin
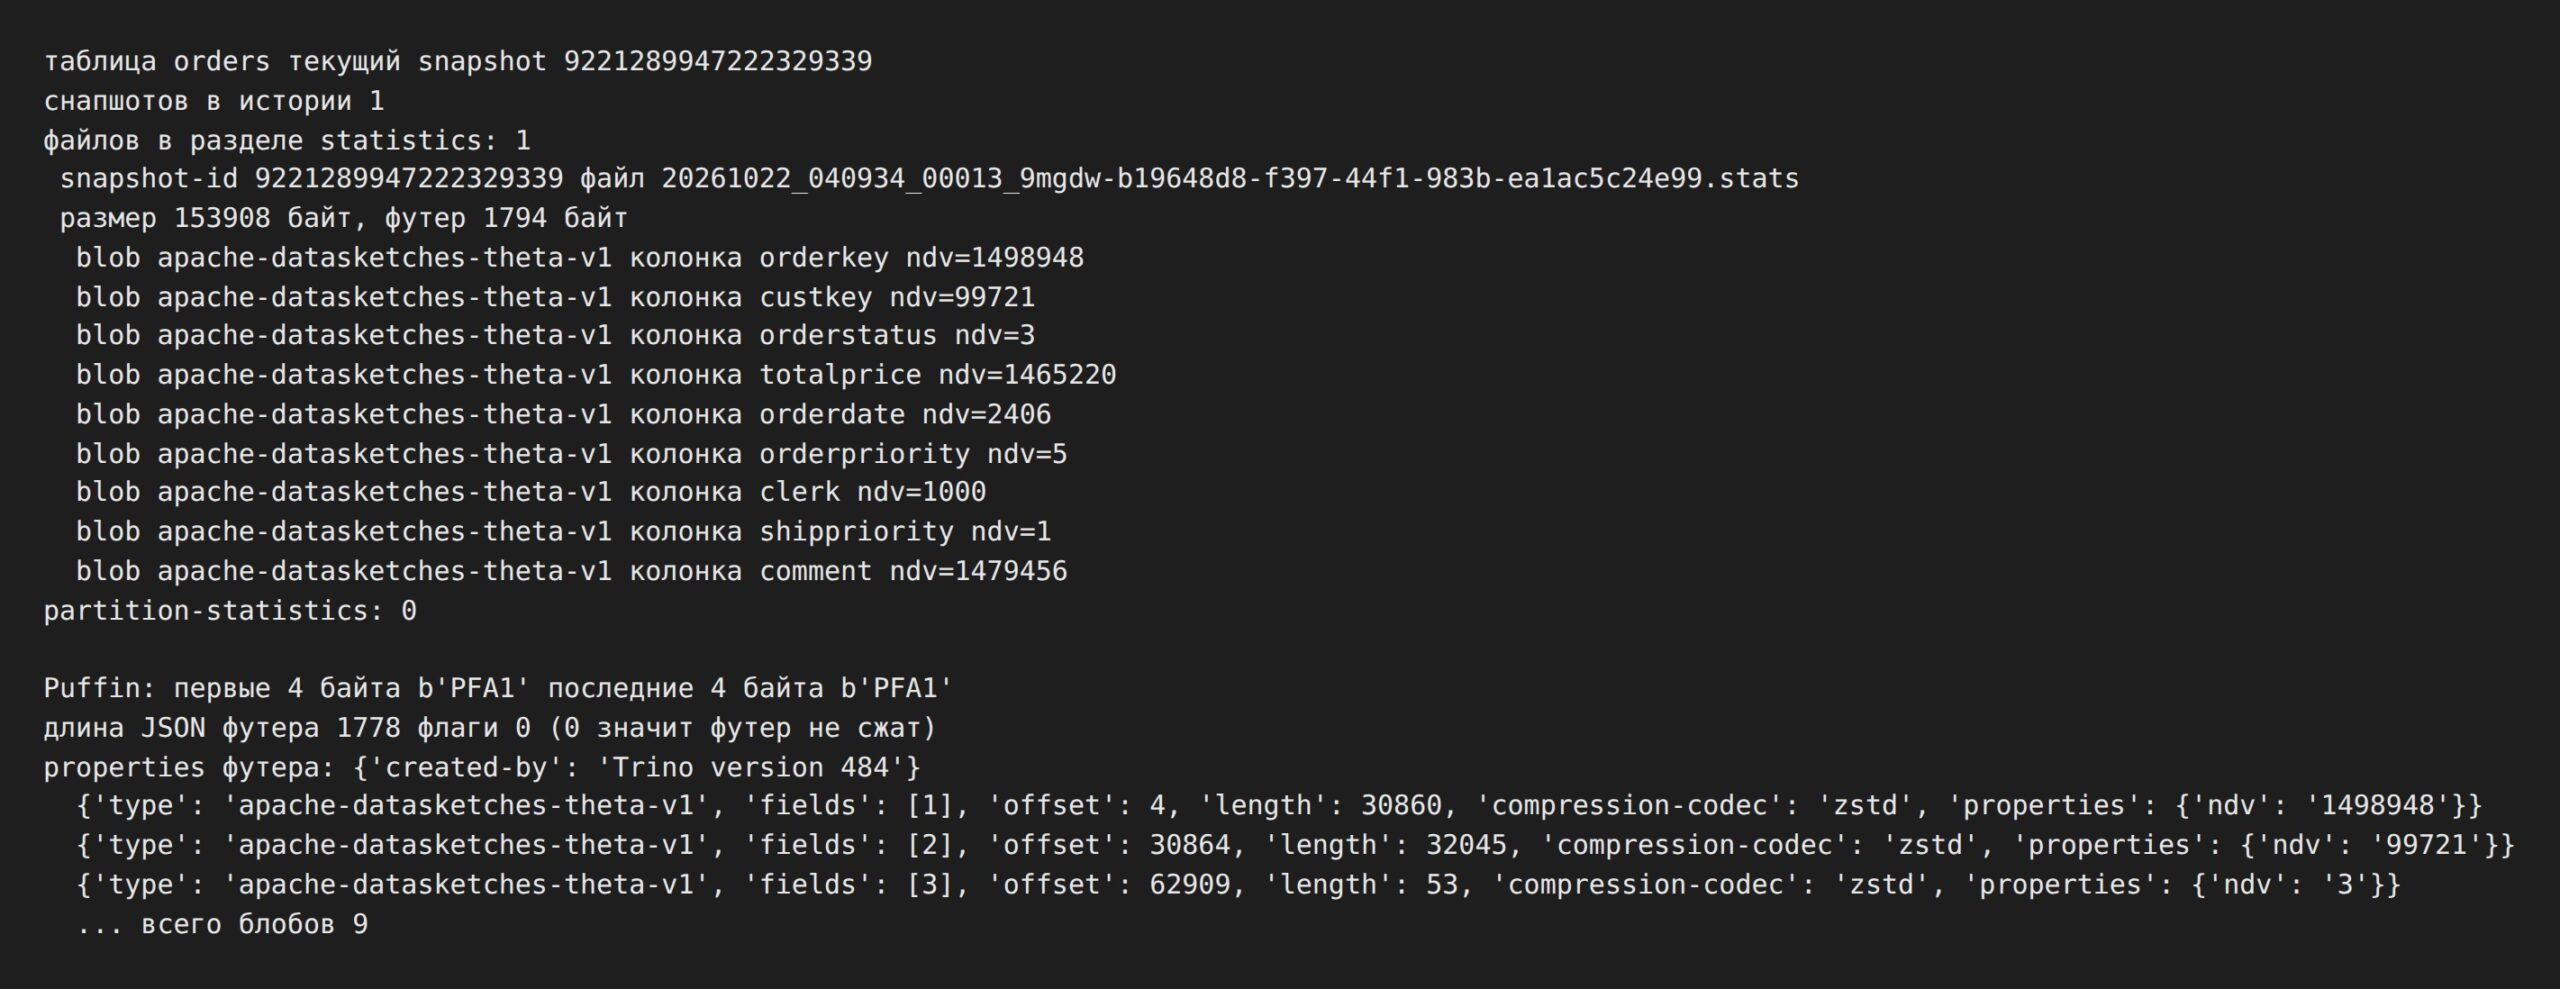
Число уникальных значений колонки, NDV (number of distinct values, количество различных значений), Iceberg хранит в файлах формата Puffin. Puffin это бинарный контейнер для статистики и индексов, которые не помещаются в манифест. Файл начинается и заканчивается магической последовательностью PFA1, между ними идут блобы (blob) и футер. Футер содержит JSON с описанием блобов, его длину в четырёх байтах, четыре байта флагов и ещё раз магию. Именно так файл и выглядит на стенде после ANALYZE в Trino, с футером длиной 1778 байт, нулевыми флагами и строкой created-by со значением Trino version 484.
Для NDV спецификация определяет тип блоба apache-datasketches-theta-v1. Внутри лежит theta sketch из библиотеки Apache DataSketches, то есть вероятностная структура фиксированного размера, по которой оценивается число уникальных значений. Сама оценка, выведенная из скетча, лежит рядом в свойстве ndv блоба целым числом. Цена такого подхода в том, что NDV остаётся оценкой. На стенде для колонки custkey Trino насчитал 99721 уникальное значение при точных 99996, расхождение 0.28%.
Файл Puffin регистрируется в разделе statistics файла metadata.json. Запись содержит snapshot-id, путь к файлу, его размер, размер футера и копию описаний блобов. Привязка к снапшоту принципиальна. Статистика описывает конкретное состояние таблицы, и у одной таблицы может быть несколько файлов статистики для разных снапшотов.
Статистика партиций
Третий уровень, статистика партиций (partition statistics), хранится в отдельном файле и регистрируется в разделе partition-statistics метаданных. Он даёт счётчики строк и файлов по каждой партиции и помогает видеть перекос, когда в одну партицию попала большая часть данных. В Spark его считает процедура compute_partition_stats, и считает инкрементально, от последнего снапшота, для которого такой файл уже есть. На нашем стенде таблицы TPC-H не партиционированы, и раздел partition-statistics пуст. Дальше речь пойдёт только о NDV, потому что именно он меняет оценки join.
Кто пишет и кто читает NDV
Ключевая фраза обзора Dremio звучит так. NDV не появляется автоматически. На деле это верно для Spark и неверно для Trino, и это различие легко пропустить.
Trino, ANALYZE и сбор при записи
В коннекторе Iceberg для Trino NDV называется расширенной статистикой (extended statistics). Команда ANALYZE считает её по всем колонкам таблицы или по списку из опции columns и пишет файл Puffin к текущему снапшоту. Кроме того, свойство каталога iceberg.extended-statistics.collect-on-write и его сессионный аналог collect_extended_statistics_on_write по умолчанию включены. Поэтому CTAS (CREATE TABLE AS SELECT) и INSERT в Trino уже оставляют после себя Puffin с NDV, и для таблиц, которые пишет только Trino, отдельный ANALYZE часто не нужен. На стенде мы выключаем сбор при записи намеренно, чтобы получить таблицу в том виде, в каком её оставил бы движок без сбора NDV.
Удаляет расширенную статистику процедура ALTER TABLE … EXECUTE drop_extended_stats. В старых инструкциях можно встретить свойство iceberg.extended-statistics.enabled и сессионное extended_statistics_enabled. В Trino 480 оба удалены, и в конфигурации свежих версий их быть не должно.
Spark и compute_table_stats
Обычная запись из Spark NDV не считает. Для расчёта в Iceberg есть действие (action) ComputeTableStats, появившееся в версии 1.7.0, и SQL-процедура compute_table_stats, которая в 1.10 вызывается через CALL с аргументами table, snapshot_id и columns. Процедура возвращает путь к записанному файлу статистики. На стенде мы считали NDV только по ключам join и колонке фильтра, и на таблицу из полутора миллионов строк ушло 2.3 с.
Читателей у Puffin на стенде два. Trino берёт NDV из Puffin, кто бы его ни записал, и это проверено на файле, который создал Spark. Оптимизатор Spark тоже видит NDV в статистике плана, но, как покажет практика, пользуется им с оговорками. Про другие движки мы ничего не утверждаем, потому что не проверяли.
Как статистика меняет план запроса
Стоимостный оптимизатор (cost-based optimizer, CBO) Trino оценивает, сколько строк выйдет из каждого фильтра и каждого join, и по этим оценкам решает две задачи. Первая это порядок соединений (join reordering). Вторая это способ распределения данных между узлами, то есть копировать ли меньшую сторону на все узлы (broadcast, в плане Trino это REPLICATED) или перераспределять обе стороны по ключу (partitioned). Обе стратегии по умолчанию работают в режиме AUTOMATIC, и подробно внутренности оптимизатора мы разбирали в статье «Под капотом Trino» про оптимизацию запросов.
Перебирая порядки join, Trino оценивает их стоимость по статистике, которую отдаёт коннектор. Если посчитать стоимость нельзя, режим AUTOMATIC откатывается к стратегии ELIMINATE_CROSS_JOINS, и соединения идут почти в том порядке, в котором написаны в запросе. На стенде без NDV оценки строк у всех join превратились в знак вопроса, и порядок остался исходным. Размеры самих таблиц при этом известны из манифестов, поэтому выбор broadcast против partitioned может остаться разумным и без NDV. На стенде так и вышло.
Trino для инженеров данных
Код курса
TRINO
Ближайшая дата курса
15 марта, 2027
Продолжительность
16 ак.часов
Стоимость обучения
51 200
Iceberg и альтернативы, где живёт статистика
Статистика для оптимизатора есть у всех распространённых табличных форматов и каталогов, но хранится она в разных местах, и от места хранения зависит, сможет ли второй движок её прочитать. Сравнение ниже опирается на спецификации и документацию, а для Iceberg ещё и на стенд.
| Критерий | Iceberg, Puffin | Hive Metastore | Delta Lake | Iceberg только с манифестами |
|---|---|---|---|---|
| Где хранится | Файл Puffin рядом с данными, ссылка в разделе statistics файла metadata.json | Таблица TAB_COL_STATS в базе метастора | Поле stats каждой записи add в _delta_log | Манифесты снапшота |
| Переносимость между движками | Вместе с таблицей, на стенде Trino прочитал NDV, записанный Spark | Для движков, подключённых к тому же метастору | Для любого читателя _delta_log | Для любого читателя Iceberg |
| Есть ли NDV | Да, theta sketch и свойство ndv | Да, поле NUM_DISTINCTS, метод оценки в документации не описан | Нет, в логе numRecords, minValues, maxValues, nullCount | Нет |
| Когда обновляется | ANALYZE или запись в Trino, compute_ |
ANALYZE TABLE … COMPUTE STATISTICS FOR COLUMNS, автосбор колонок с Hive 2.3 | При каждой записи файла, по умолчанию первые 32 колонки | При каждом коммите |
| Цена сбора на стенде | ANALYZE четырёх таблиц TPC-H с масштабом sf1 (scale factor 1) за 19 с, compute_ |
Отдельный запуск ANALYZE по таблице или партиции | Входит в запись, пересчёт ANALYZE TABLE … COMPUTE DELTA STATISTICS есть в Databricks Runtime 14.3+ | Входит в запись |
Hive Metastore умеет хранить NDV дольше всех, команда ANALYZE TABLE … COMPUTE STATISTICS FOR COLUMNS существует с Hive 0.10.0. Но статистика живёт в базе метастора, а не в файлах таблицы, и перенос таблицы в другой каталог её теряет. У Iceberg статистика лежит в том же хранилище, что и данные, и переезжает вместе с метаданными.
Delta Lake выигрывает в простоте, потому что статистика по файлам пишется при каждой записи и ничего запускать не нужно. Однако, судя по документации Databricks о пропуске данных, в логе есть только счётчики и границы, а NDV там нет. Такой статистики хватает для пропуска файлов, но не для оценки join по ключу. Ближайший аналог в Iceberg это последняя колонка таблицы, метрики манифестов без Puffin, и на стенде видно, что их оптимизатору мало.
Практика, статистика на стенде Trino и Spark
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Сценарий такой. Загружаем TPC-H sf1 в Iceberg без NDV, смотрим статистику и план четырёхтабличного join. Затем считаем NDV через ANALYZE в Trino, разбираем файл Puffin и снова смотрим план. В конце удаляем статистику Trino, пересчитываем её в Spark и проверяем, увидит ли её Trino. Прогон шёл на сервере с 4 vCPU и 16 ГБ памяти, весь сценарий занял четыре минуты.
Стенд
Стенд собран в Docker Compose из пяти сервисов. SeaweedFS 4.48 играет роль S3-хранилища. Образов minio/minio в Docker Hub больше нет, поэтому взят SeaweedFS. Тестовый REST-каталог apache/iceberg-rest-fixture 1.10.1 держит каталог в SQLite в памяти, а одноразовый сервис create_bucket создаёт бакет warehouse и завершается. Trino 484 и Spark 4.0.4 подключены к одному и тому же каталогу и хранилищу, и это условие всего эксперимента. Порты публикуются только на 127.0.0.1.
# SeaweedFS 4.48 + iceberg-rest-fixture 1.10.1 + Trino 484 + Spark 4.0.4 (Iceberg 1.10.1), прогнано на стенде 2026-10-22
name: blog-iceberg_table_statistics

x-s3-env: &s3-env
  AWS_ACCESS_KEY_ID: admin
  AWS_SECRET_ACCESS_KEY: password123
  AWS_REGION: us-east-1

services:
  # S3-совместимое хранилище: здесь лежат data-файлы, манифесты и Puffin
  seaweedfs:
    image: chrislusf/seaweedfs:4.48
    mem_limit: 1g
    command: server -dir=/data -s3 -s3.port=8333 -s3.config=/etc/seaweedfs/s3.json
    ports:
      - "127.0.0.1:8333:8333"
    volumes:
      - ./seaweedfs/s3.json:/etc/seaweedfs/s3.json:ro
      - s3_data:/data

  # одноразовый шаг: создаёт бакет warehouse и завершается
  create_bucket:
    image: chrislusf/seaweedfs:4.48
    mem_limit: 256m
    depends_on: [seaweedfs]
    entrypoint: ["sh", "-c", "until echo 's3.bucket.create -name warehouse' | weed shell -master=seaweedfs:9333 2>&1 | grep -qiE 'created|exist'; do sleep 2; done; echo bucket warehouse ready"]

  # REST-каталог Iceberg: хранит указатель на текущий metadata.json каждой таблицы
  rest:
    image: apache/iceberg-rest-fixture:1.10.1
    mem_limit: 1g
    depends_on:
      create_bucket: { condition: service_completed_successfully }
    environment:
      <<: *s3-env
      CATALOG_WAREHOUSE: s3://warehouse/
      CATALOG_IO__IMPL: org.apache.iceberg.aws.s3.S3FileIO
      CATALOG_S3_ENDPOINT: http://seaweedfs:8333
      CATALOG_S3_PATH__STYLE__ACCESS: "true"
    ports:
      - "127.0.0.1:8181:8181"

  trino:
    image: trinodb/trino:484
    mem_limit: 4g
    depends_on:
      rest: { condition: service_healthy }
    ports:
      - "127.0.0.1:8080:8080"
    volumes:
      # каталог iceberg добавляется к встроенным tpch, tpcds и memory
      - ./trino/iceberg.properties:/etc/trino/catalog/iceberg.properties:ro
      - ./:/demo:ro

  spark:
    build: { context: ., dockerfile: spark.Dockerfile }
    image: blog-iceberg_table_statistics-spark:4.0.4-iceberg1.10.1
    mem_limit: 3g
    depends_on:
      rest: { condition: service_healthy }
    environment:
      <<: *s3-env
    command: ["sleep", "infinity"]
    volumes:
      - ./:/demo:ro

volumes:
  s3_data:
Образ Spark собирается из официального apache/spark с двумя jar Iceberg, runtime для Spark 4.0 и aws-bundle для работы с S3. Файл log4j2.properties глушит логи Spark до уровня ошибок, чтобы вывод демо читался.
# Spark 4.0.4 + Iceberg 1.10.1: runtime и aws-bundle кладутся прямо в jars
FROM apache/spark:4.0.4-scala2.13-java17-python3-ubuntu
ADD --chown=spark:spark https://repo1.maven.org/maven2/org/apache/iceberg/iceberg-spark-runtime-4.0_2.13/1.10.1/iceberg-spark-runtime-4.0_2.13-1.10.1.jar /opt/spark/jars/
ADD --chown=spark:spark https://repo1.maven.org/maven2/org/apache/iceberg/iceberg-aws-bundle/1.10.1/iceberg-aws-bundle-1.10.1.jar /opt/spark/jars/
COPY log4j2.properties /opt/spark/conf/log4j2.properties
# Spark пишет в консоль только ошибки, чтобы вывод демо читался
rootLogger.level = error
rootLogger.appenderRef.stdout.ref = console
appender.console.type = Console
appender.console.name = console
appender.console.target = SYSTEM_ERR
appender.console.layout.type = PatternLayout
appender.console.layout.pattern = %d{yy/MM/dd HH:mm:ss} %p %c{1}: %m%n
Ключи локального S3 задаются в seaweedfs/s3.json. Они нужны только стенду и наружу не публикуются.
{
  "identities": [
    {
      "name": "admin",
      "credentials": [{ "accessKey": "admin", "secretKey": "password123" }],
      "actions": ["Admin", "Read", "Write", "List", "Tagging"]
    }
  ]
}
Каталог iceberg в Trino описан файлом trino/iceberg.properties и работает через REST-каталог и нативный клиент S3. Встроенные каталоги tpch и memory в образе Trino уже есть, из tpch мы и берём данные.
# Trino 484, каталог Iceberg через REST, прогнано на стенде 2026-10-22
connector.name=iceberg
iceberg.catalog.type=rest
iceberg.rest-catalog.uri=http://rest:8181
fs.native-s3.enabled=true
s3.endpoint=http://seaweedfs:8333
s3.region=us-east-1
s3.path-style-access=true
s3.aws-access-key=admin
s3.aws-secret-key=password123
Для скриптов на хосте нужны три Python-пакета из requirements.txt.
trino==0.340.0
boto3==1.43.117
requests==2.34.2
# Docker Compose v2, Python 3.12, прогнано на стенде 2026-10-22
docker compose up -d --build --wait
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt

docker compose exec -T trino trino --version
docker compose exec -T spark sh -c '/opt/spark/bin/spark-submit --version 2>&1 | grep -m1 version; ls /opt/spark/jars | grep iceberg'
docker compose exec -T seaweedfs weed version | tail -1
docker compose images
Проверка версий внутри контейнеров подтверждает пины. Из вывода убраны две строки рекламы SeaweedFS Enterprise и пустая строка перед ними.
Trino CLI 484
   /___/ .__/\_,_/_/ /_/\_\   version 4.0.4
iceberg-aws-bundle-1.10.1.jar
iceberg-spark-runtime-4.0_2.13-1.10.1.jar
version 30GB 4.48 530be3e37 linux amd64
CONTAINER                                       REPOSITORY                            TAG                   PLATFORM            IMAGE ID            SIZE                CREATED
blog-iceberg_table_statistics-create_bucket-1   chrislusf/seaweedfs                   4.48                  linux/amd64         4e61d15fd359        194MB               13 minutes ago
blog-iceberg_table_statistics-rest-1            apache/iceberg-rest-fixture           1.10.1                linux/amd64         f7d679d30ac9        300MB               13 minutes ago
blog-iceberg_table_statistics-seaweedfs-1       chrislusf/seaweedfs                   4.48                  linux/amd64         4e61d15fd359        194MB               13 minutes ago
blog-iceberg_table_statistics-spark-1           blog-iceberg_table_statistics-spark   4.0.4-iceberg1.10.1   linux/amd64         004f4ad2176c        874MB               36 seconds ago
blog-iceberg_table_statistics-trino-1           trinodb/trino                         484                   linux/amd64         2704eb53935a        1.04GB              14 minutes ago
Таблицы без NDV
Первый скрипт копирует четыре таблицы TPC-H из встроенного каталога tpch в Iceberg через CTAS. Перед загрузкой сессия выключает сбор NDV при записи. Скрипт запускается целиком одним вызовом CLI с ключом —file, потому что SET SESSION живёт только до конца вызова.
-- Trino 484, Iceberg REST-каталог, прогнано на стенде 2026-10-22
-- Грузим TPC-H sf1 в Iceberg и намеренно не собираем NDV при записи.

CREATE SCHEMA IF NOT EXISTS iceberg.tpch;

-- По умолчанию CTAS в Trino сразу пишет Puffin с NDV. Выключаем, чтобы увидеть таблицу
-- только с метриками из манифестов: так выглядит таблица, записанная движком без сбора NDV.
SET SESSION iceberg.collect_extended_statistics_on_write = false;

CREATE TABLE iceberg.tpch.nation   AS SELECT * FROM tpch.sf1.nation;
CREATE TABLE iceberg.tpch.customer AS SELECT * FROM tpch.sf1.customer;
CREATE TABLE iceberg.tpch.orders   AS SELECT * FROM tpch.sf1.orders;
CREATE TABLE iceberg.tpch.lineitem AS SELECT * FROM tpch.sf1.lineitem;

-- distinct_values_count пустой, min/max и nulls_fraction есть: они из манифестов
SHOW STATS FOR iceberg.tpch.orders;
# Trino CLI 484, прогнано на стенде 2026-10-22
docker compose exec -T trino trino --output-format ALIGNED --file /demo/01_load_without_ndv.sql
Загрузка 7.6 млн строк заняла 36 с по таймеру прогона, строка таймера из вывода убрана. Колонка distinct_values_count пуста у всех колонок, а диапазоны, доля пустых значений и число строк на месте. Это ровно те метрики, которые Trino собрал из манифестов.
CREATE SCHEMA
SET SESSION
CREATE TABLE: 25 rows
CREATE TABLE: 150000 rows
CREATE TABLE: 1500000 rows
CREATE TABLE: 6001215 rows
  column_name  |  data_size  | distinct_values_count | nulls_fraction | row_count | low_value  | high_value
---------------+-------------+-----------------------+----------------+-----------+------------+------------
 orderkey      |        NULL |                  NULL |            0.0 |      NULL | 1          | 6000000
 custkey       |        NULL |                  NULL |            0.0 |      NULL | 1          | 149999
 orderstatus   |    622668.0 |                  NULL |            0.0 |      NULL | NULL       | NULL
 totalprice    |        NULL |                  NULL |            0.0 |      NULL | 857.71     | 555285.16
 orderdate     |        NULL |                  NULL |            0.0 |      NULL | 1992-01-01 | 1998-08-02
 orderpriority |   1366073.0 |                  NULL |            0.0 |      NULL | NULL       | NULL
 clerk         |   5086146.0 |                  NULL |            0.0 |      NULL | NULL       | NULL
 shippriority  |        NULL |                  NULL |            0.0 |      NULL | 0          | 0
 comment       | 5.0023156E7 |                  NULL |            0.0 |      NULL | NULL       | NULL
 NULL          |        NULL |                  NULL |           NULL | 1500000.0 | NULL       | NULL
(10 rows)
Теперь запрос, на котором будем смотреть план. Это выручка по странам за первый квартал 1995 года, четыре таблицы и три join. Скрипт join_plan.py печатает из EXPLAIN только узлы join и сканирования с оценками строк, а затем трижды выполняет запрос и берёт медиану серверного времени.
# trino 0.340.0, Trino 484, прогнано на стенде 2026-10-22
"""План и время одного join-запроса в Trino.

Запуск: python join_plan.py "подпись состояния"
Печатает узлы join с распределением и оценками строк, затем медиану трёх запусков.
"""
import re
import statistics
import sys

import trino

QUERY = """
SELECT n.name, count(*) AS lines, sum(l.extendedprice) AS revenue
FROM iceberg.tpch.lineitem l
JOIN iceberg.tpch.orders o   ON l.orderkey = o.orderkey
JOIN iceberg.tpch.customer c ON o.custkey = c.custkey
JOIN iceberg.tpch.nation n   ON c.nationkey = n.nationkey
WHERE o.orderdate >= DATE '1995-01-01' AND o.orderdate < DATE '1995-04-01'
GROUP BY n.name
ORDER BY revenue DESC
"""

label = sys.argv[1] if len(sys.argv) > 1 else "текущее состояние"
conn = trino.dbapi.connect(host="127.0.0.1", port=8080, user="demo")
cur = conn.cursor()

# EXPLAIN показывает, что решил оптимизатор: порядок, тип распределения, оценки
cur.execute("EXPLAIN (TYPE DISTRIBUTED) " + QUERY)
plan = cur.fetchall()[0][0].splitlines()
print(f"--- план: {label}")
for i, line in enumerate(plan):
    if re.search(r"(Inner|Left|Right|Cross)Join\[|ScanFilter|TableScan\[", line):
        print(line.rstrip()[:160])
        est = next((p for p in plan[i + 1:i + 4] if "Estimates:" in p), None)
        if est:
            print(re.sub(r", cpu:.*", "}", est.rstrip()))

# Время: три запуска, берём медиану по серверному elapsed
times, peak = [], []
for _ in range(3):
    cur.execute(QUERY)
    rows = cur.fetchall()
    times.append(cur.stats["elapsedTimeMillis"])
    peak.append(cur.stats["peakMemoryBytes"])
print(f"--- время: {label}")
print(f"строк результата {len(rows)}, первая {rows[0][0]} {rows[0][1]}")
print(f"elapsed мс: {times}, медиана {statistics.median(times):.0f}")
print(f"peak memory МБ: {max(peak) / 2**20:.0f}")
# trino 0.340.0, Trino 484, прогнано на стенде 2026-10-22
.venv/bin/python join_plan.py "без NDV"
--- план: без NDV
    └─ InnerJoin[criteria = (nationkey = nationkey_10), distribution = REPLICATED]
       │   Estimates: {rows: ? (?)}
       ├─ InnerJoin[criteria = (custkey = custkey_5), distribution = REPLICATED]
       │  │   Estimates: {rows: ? (?)}
       │  ├─ InnerJoin[criteria = (orderkey = orderkey_0), distribution = REPLICATED]
       │  │  │   Estimates: {rows: ? (?)}
       │  │  ├─ ScanFilter[table = iceberg:tpch.lineitem$data@3932404925859451115, dynamicFilters = {orderkey = #df_685}]
       │  │  │      Estimates: {rows: 6001215 (103.02MB)}
    ScanFilterProject[table = iceberg:tpch.orders$data@9221289947222329339, filterPredicate = ((date '1995-01-01' <= orderdate) AND (orderdate < date '1995-04-0
        Estimates: {rows: 1500000 (25.75MB)}
    ScanFilter[table = iceberg:tpch.customer$data@3152910255929120275, dynamicFilters = {nationkey = #df_683}]
        Estimates: {rows: 150000 (2.57MB)}
    TableScan[table = iceberg:tpch.nation$data@7436702068544008759]
        Estimates: {rows: 25 (863B)}
--- время: без NDV
строк результата 25, первая JORDAN 9614
elapsed мс: [4001, 2369, 1937], медиана 2369
peak memory МБ: 45
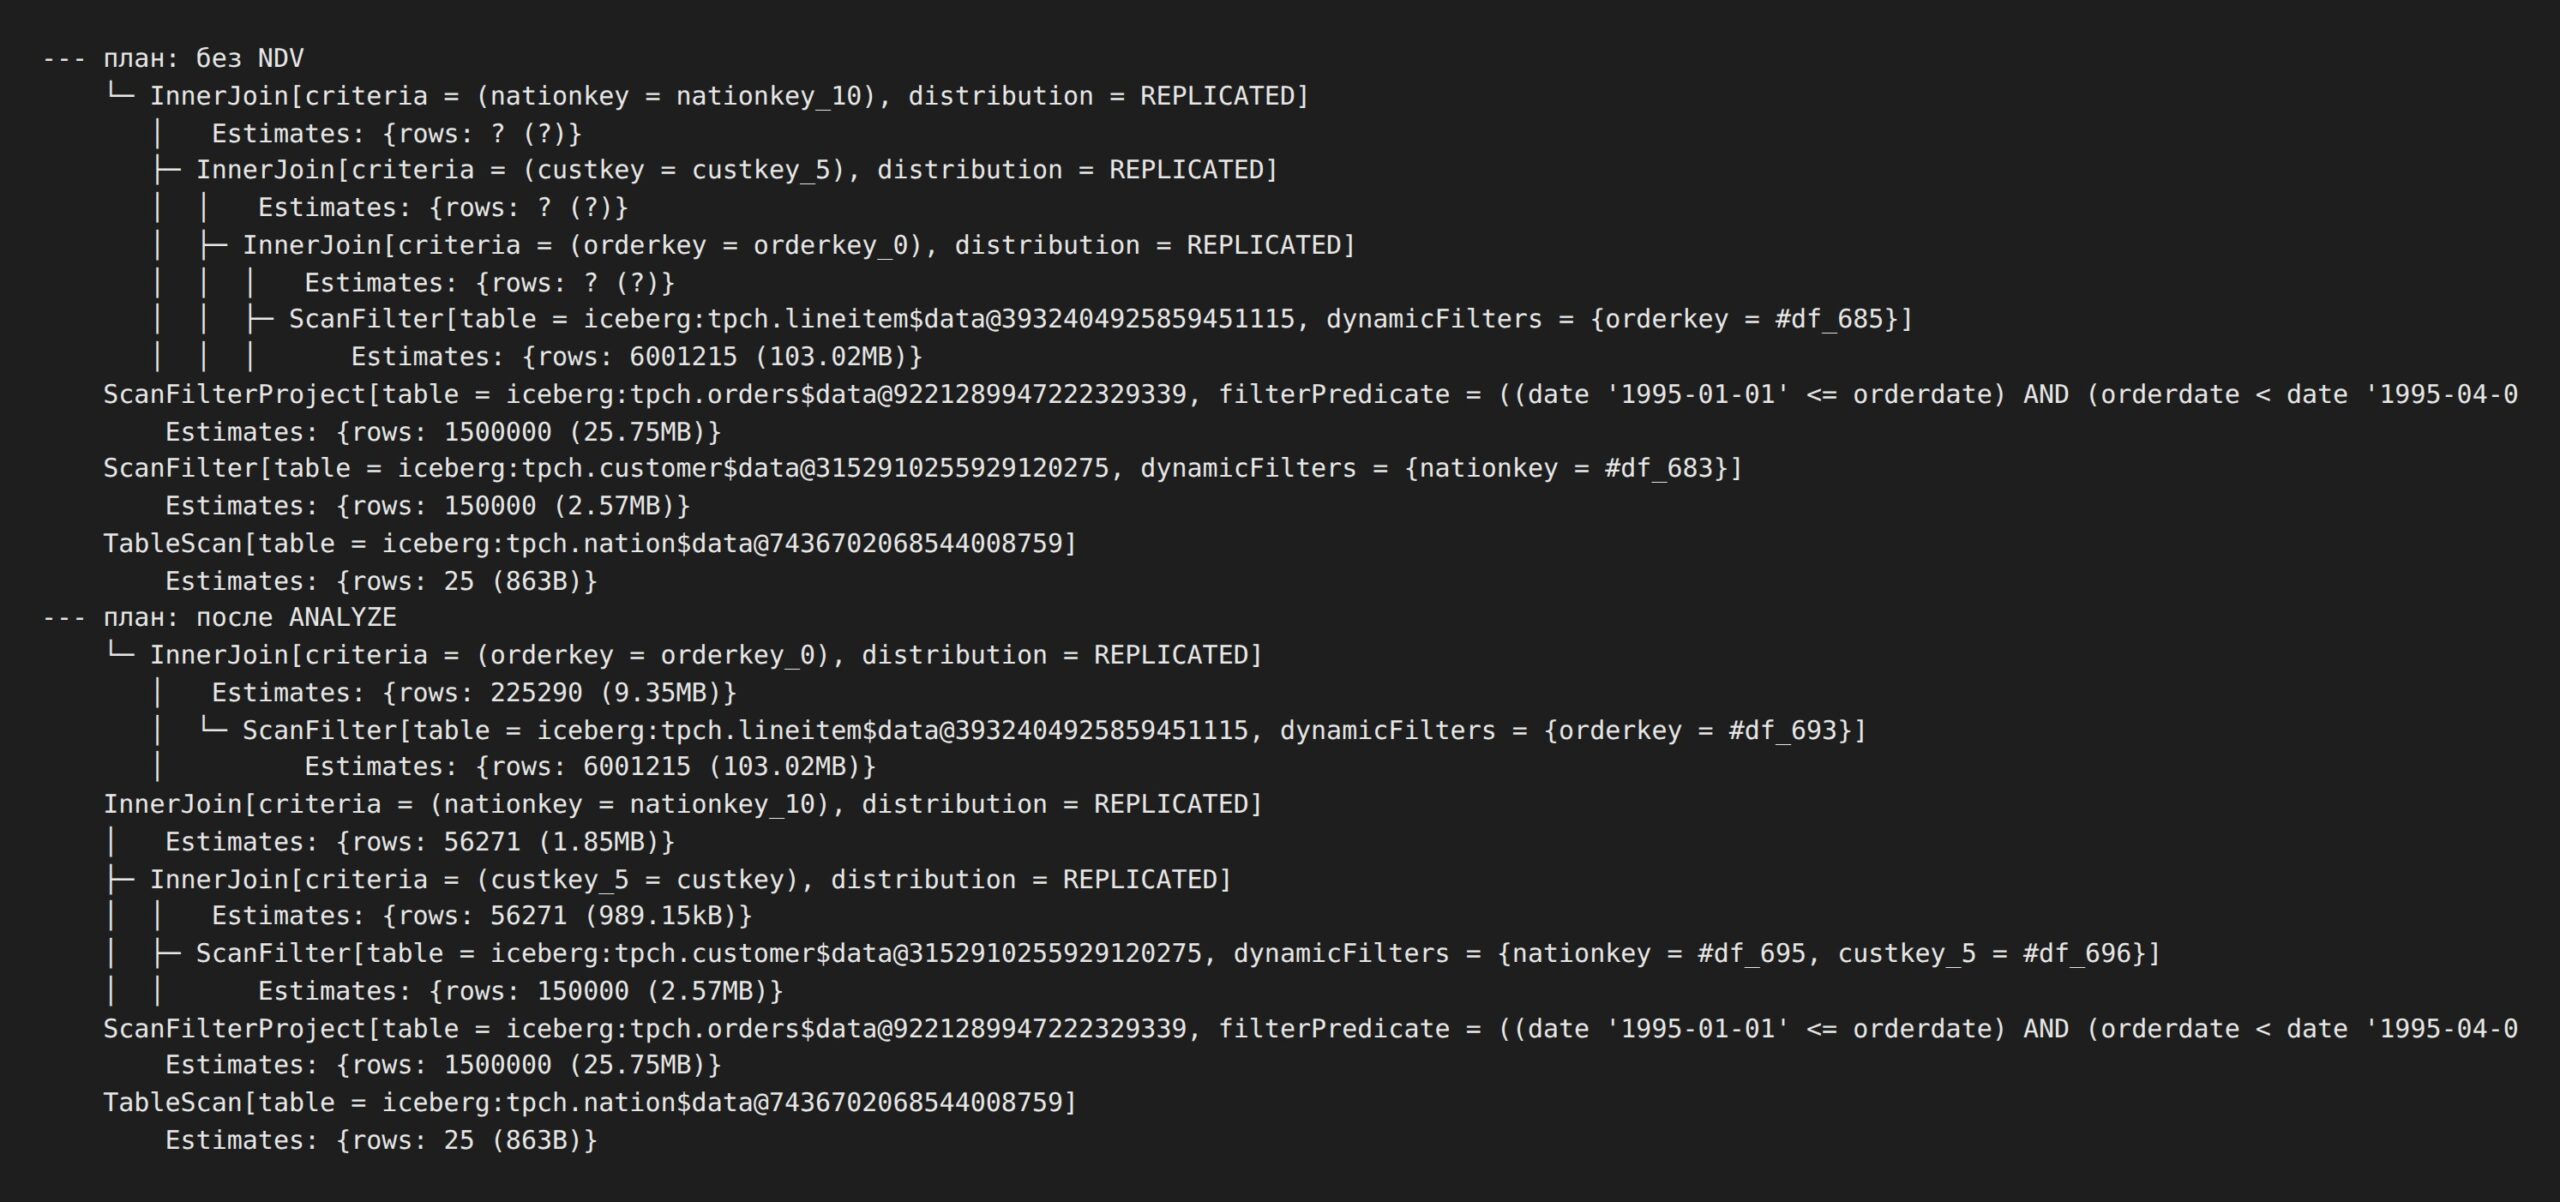
У всех трёх join оценка строк неизвестна, а порядок совпадает с текстом запроса. Сначала lineitem на шесть миллионов строк соединяется с orders, потом результат с customer, и только в конце с nation. Тип распределения при этом везде REPLICATED, потому что размеры таблиц Trino знает из манифестов.
ANALYZE и план до и после
Второй скрипт запускает ANALYZE для всех четырёх таблиц и сверяет оценку NDV с точным подсчётом через count(DISTINCT).
-- Trino 484, Iceberg REST-каталог, прогнано на стенде 2026-10-22
-- ANALYZE считает NDV по всем колонкам и пишет Puffin-файл к текущему снапшоту.

ANALYZE iceberg.tpch.nation;
ANALYZE iceberg.tpch.customer;
ANALYZE iceberg.tpch.orders;
ANALYZE iceberg.tpch.lineitem;

-- Колонка distinct_values_count заполнена
SHOW STATS FOR iceberg.tpch.orders;

-- NDV это оценка по theta sketch. Сверяем с точным подсчётом
SELECT count(DISTINCT custkey) AS exact_custkey,
       count(DISTINCT clerk)   AS exact_clerk
FROM iceberg.tpch.orders;
# Trino CLI 484, прогнано на стенде 2026-10-22
docker compose exec -T trino trino --output-format ALIGNED --file /demo/02_analyze.sql
ANALYZE четырёх таблиц занял 19 с по таймеру прогона, строка таймера убрана. Для clerk оценка совпала с точным значением 1000, для custkey вышло 99721 против 99996.
ANALYZE
 rows
------
 NULL
(1 row)
ANALYZE
 rows
------
 NULL
(1 row)
ANALYZE
 rows
------
 NULL
(1 row)
ANALYZE
 rows
------
 NULL
(1 row)
  column_name  |  data_size  | distinct_values_count | nulls_fraction | row_count | low_value  | high_value
---------------+-------------+-----------------------+----------------+-----------+------------+------------
 orderkey      |        NULL |             1498948.0 |            0.0 |      NULL | 1          | 6000000
 custkey       |        NULL |               99721.0 |            0.0 |      NULL | 1          | 149999
 orderstatus   |    622668.0 |                   3.0 |            0.0 |      NULL | NULL       | NULL
 totalprice    |        NULL |             1465220.0 |            0.0 |      NULL | 857.71     | 555285.16
 orderdate     |        NULL |                2406.0 |            0.0 |      NULL | 1992-01-01 | 1998-08-02
 orderpriority |   1366073.0 |                   5.0 |            0.0 |      NULL | NULL       | NULL
 clerk         |   5086146.0 |                1000.0 |            0.0 |      NULL | NULL       | NULL
 shippriority  |        NULL |                   1.0 |            0.0 |      NULL | 0          | 0
 comment       | 5.0023156E7 |             1479456.0 |            0.0 |      NULL | NULL       | NULL
 NULL          |        NULL |                  NULL |           NULL | 1500000.0 | NULL       | NULL
(10 rows)
 exact_custkey | exact_clerk
---------------+-------------
         99996 |        1000
(1 row)
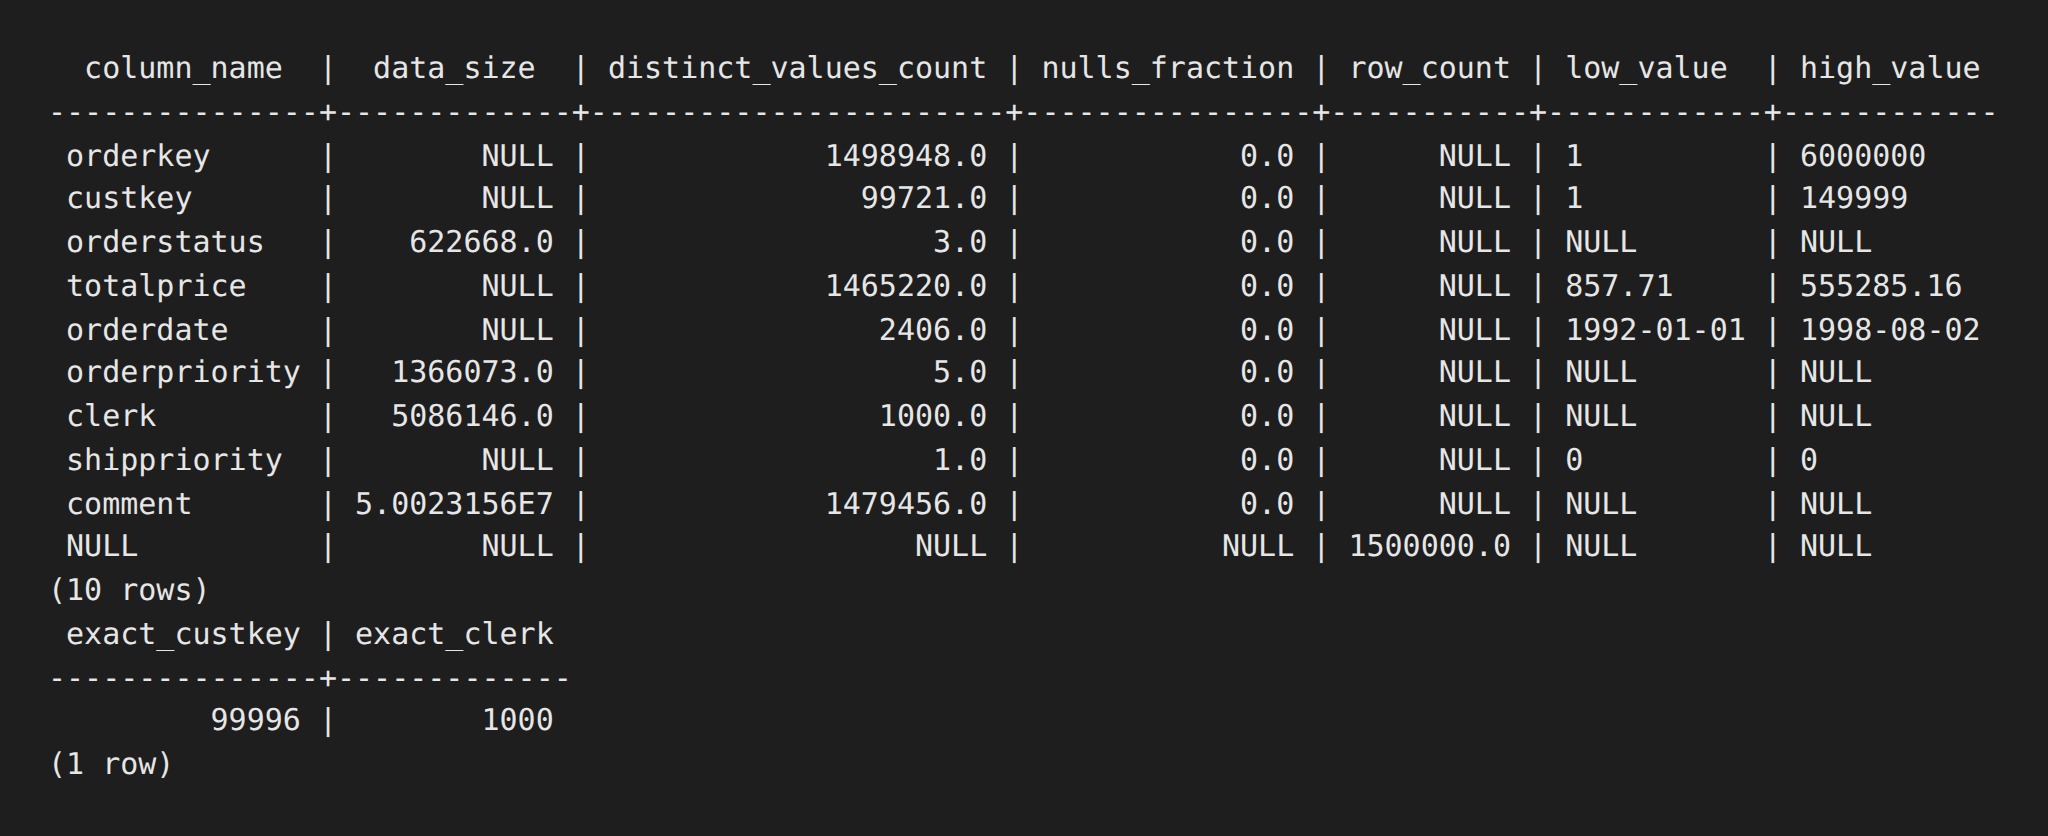
Где теперь лежит NDV, показывает inspect_metadata.py. Он берёт metadata.json таблицы из REST-каталога, печатает раздел statistics, затем скачивает файл Puffin из S3 и разбирает его хвост по спецификации.
# boto3 1.43.117, requests 2.34.2, iceberg-rest-fixture 1.10.1, прогнано на стенде 2026-10-22
"""Где лежит NDV: раздел statistics в metadata.json и футер Puffin-файла.

Запуск: python inspect_metadata.py [таблица]   (по умолчанию orders)
"""
import json
import struct
import sys

import boto3
import requests

REST = "http://127.0.0.1:8181/v1/namespaces/tpch/tables/"
table = sys.argv[1] if len(sys.argv) > 1 else "orders"

# REST-каталог отдаёт текущий metadata.json таблицы целиком
resp = requests.get(REST + table, timeout=30)
resp.raise_for_status()
meta = resp.json()["metadata"]
schema = {f["id"]: f["name"] for f in meta["schemas"][-1]["fields"]}
print("таблица", table, "текущий snapshot", meta["current-snapshot-id"])
print("снапшотов в истории", len(meta["snapshots"]))

stats = meta.get("statistics", [])
print("файлов в разделе statistics:", len(stats))
for sf in stats:
    print(" snapshot-id", sf["snapshot-id"], "файл", sf["statistics-path"].rsplit("/", 1)[-1])
    print(" размер", sf["file-size-in-bytes"], "байт, футер", sf["file-footer-size-in-bytes"], "байт")
    for b in sf["blob-metadata"]:
        cols = ",".join(schema.get(f, str(f)) for f in b["fields"])
        print(f"  blob {b['type']} колонка {cols} ndv={b['properties'].get('ndv')}")
print("partition-statistics:", len(meta.get("partition-statistics", [])))
if not stats:
    sys.exit(0)

# Сам Puffin: Magic | блобы | футер. Футер это Magic, JSON, длина JSON (4 байта LE),
# флаги (4 байта), Magic. Читаем хвост файла и разбираем JSON футера.
s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:8333", region_name="us-east-1",
                  aws_access_key_id="admin", aws_secret_access_key="password123")
bucket, key = stats[-1]["statistics-path"].removeprefix("s3://").split("/", 1)
obj = s3.get_object(Bucket=bucket, Key=key)["Body"].read()
print()
print("Puffin: первые 4 байта", obj[:4], "последние 4 байта", obj[-4:])
payload_size, flags = struct.unpack("<ii", obj[-12:-4])
print("длина JSON футера", payload_size, "флаги", flags, "(0 значит футер не сжат)")
footer = json.loads(obj[-12 - payload_size:-12])
print("properties футера:", footer.get("properties"))
for b in footer["blobs"][:3]:
    print(" ", {k: b.get(k) for k in ("type", "fields", "offset", "length", "compression-codec", "properties")})
if len(footer["blobs"]) > 3:
    print("  ... всего блобов", len(footer["blobs"]))
# boto3 1.43.117, requests 2.34.2, прогнано на стенде 2026-10-22
.venv/bin/python inspect_metadata.py orders
таблица orders текущий snapshot 9221289947222329339
снапшотов в истории 1
файлов в разделе statistics: 1
 snapshot-id 9221289947222329339 файл 20261022_040934_00013_9mgdw-b19648d8-f397-44f1-983b-ea1ac5c24e99.stats
 размер 153908 байт, футер 1794 байт
  blob apache-datasketches-theta-v1 колонка orderkey ndv=1498948
  blob apache-datasketches-theta-v1 колонка custkey ndv=99721
  blob apache-datasketches-theta-v1 колонка orderstatus ndv=3
  blob apache-datasketches-theta-v1 колонка totalprice ndv=1465220
  blob apache-datasketches-theta-v1 колонка orderdate ndv=2406
  blob apache-datasketches-theta-v1 колонка orderpriority ndv=5
  blob apache-datasketches-theta-v1 колонка clerk ndv=1000
  blob apache-datasketches-theta-v1 колонка shippriority ndv=1
  blob apache-datasketches-theta-v1 колонка comment ndv=1479456
partition-statistics: 0

Puffin: первые 4 байта b'PFA1' последние 4 байта b'PFA1'
длина JSON футера 1778 флаги 0 (0 значит футер не сжат)
properties футера: {'created-by': 'Trino version 484'}
  {'type': 'apache-datasketches-theta-v1', 'fields': [1], 'offset': 4, 'length': 30860, 'compression-codec': 'zstd', 'properties': {'ndv': '1498948'}}
  {'type': 'apache-datasketches-theta-v1', 'fields': [2], 'offset': 30864, 'length': 32045, 'compression-codec': 'zstd', 'properties': {'ndv': '99721'}}
  {'type': 'apache-datasketches-theta-v1', 'fields': [3], 'offset': 62909, 'length': 53, 'compression-codec': 'zstd', 'properties': {'ndv': '3'}}
  ... всего блобов 9
Файл статистики один, его snapshot-id совпадает с текущим снапшотом таблицы. Девять блобов по одному на колонку, у каждого сжатие zstd и свойство ndv с теми же числами, что в SHOW STATS. Весь файл занимает 153908 байт, из них футер 1794 байт. Самые тяжёлые блобы у колонок с большим числом уникальных значений, около 30 КБ у orderkey и custkey, а у orderstatus с тремя значениями блоб весит 53 байта.
Тот же join после ANALYZE выглядит иначе.
# trino 0.340.0, Trino 484, прогнано на стенде 2026-10-22
.venv/bin/python join_plan.py "после ANALYZE"
--- план: после ANALYZE
    └─ InnerJoin[criteria = (orderkey = orderkey_0), distribution = REPLICATED]
       │   Estimates: {rows: 225290 (9.35MB)}
       │  └─ ScanFilter[table = iceberg:tpch.lineitem$data@3932404925859451115, dynamicFilters = {orderkey = #df_693}]
       │         Estimates: {rows: 6001215 (103.02MB)}
    InnerJoin[criteria = (nationkey = nationkey_10), distribution = REPLICATED]
    │   Estimates: {rows: 56271 (1.85MB)}
    ├─ InnerJoin[criteria = (custkey_5 = custkey), distribution = REPLICATED]
    │  │   Estimates: {rows: 56271 (989.15kB)}
    │  ├─ ScanFilter[table = iceberg:tpch.customer$data@3152910255929120275, dynamicFilters = {nationkey = #df_695, custkey_5 = #df_696}]
    │  │      Estimates: {rows: 150000 (2.57MB)}
    ScanFilterProject[table = iceberg:tpch.orders$data@9221289947222329339, filterPredicate = ((date '1995-01-01' <= orderdate) AND (orderdate < date '1995-04-0
        Estimates: {rows: 1500000 (25.75MB)}
    TableScan[table = iceberg:tpch.nation$data@7436702068544008759]
        Estimates: {rows: 25 (863B)}
--- время: после ANALYZE
строк результата 25, первая JORDAN 9614
elapsed мс: [2958, 1916, 1836], медиана 1916
peak memory МБ: 65
Оптимизатор переставил соединения. Сначала отфильтрованные по дате заказы соединяются с customer и nation, оценка этой стороны 56271 строка. Только потом по orderkey к ней подключается lineitem, и оценка итогового join 225290 строк. Маленькая собранная сторона рассылается на все узлы, а шесть миллионов строк lineitem читаются один раз с динамическим фильтром по orderkey. Время при этом изменилось мало, медиана 2369 мс без NDV против 1916 мс после ANALYZE, и к этим цифрам мы вернёмся в разделе ограничений.
NDV от Spark в планах Trino
Теперь проверим переносимость. Сначала удаляем статистику, которую записал Trino.
-- Trino 484, Iceberg REST-каталог, прогнано на стенде 2026-10-22
-- Удаляем NDV, который записал Trino, чтобы статистику пересчитал Spark.

ALTER TABLE iceberg.tpch.nation   EXECUTE drop_extended_stats;
ALTER TABLE iceberg.tpch.customer EXECUTE drop_extended_stats;
ALTER TABLE iceberg.tpch.orders   EXECUTE drop_extended_stats;
ALTER TABLE iceberg.tpch.lineitem EXECUTE drop_extended_stats;

-- distinct_values_count снова пустой
SHOW STATS FOR iceberg.tpch.orders;
# Trino CLI 484, trino 0.340.0, прогнано на стенде 2026-10-22
docker compose exec -T trino trino --output-format ALIGNED --file /demo/03_drop_extended_stats.sql
.venv/bin/python join_plan.py "после drop_extended_stats"
ALTER TABLE EXECUTE
       metric_name        | metric_value
--------------------------+--------------
 removed_statistics_count |            1
(1 row)
ALTER TABLE EXECUTE
       metric_name        | metric_value
--------------------------+--------------
 removed_statistics_count |            1
(1 row)
ALTER TABLE EXECUTE
       metric_name        | metric_value
--------------------------+--------------
 removed_statistics_count |            1
(1 row)
ALTER TABLE EXECUTE
       metric_name        | metric_value
--------------------------+--------------
 removed_statistics_count |            1
(1 row)
  column_name  |  data_size  | distinct_values_count | nulls_fraction | row_count | low_value  | high_value
---------------+-------------+-----------------------+----------------+-----------+------------+------------
 orderkey      |        NULL |                  NULL |            0.0 |      NULL | 1          | 6000000
 custkey       |        NULL |                  NULL |            0.0 |      NULL | 1          | 149999
 orderstatus   |    622668.0 |                  NULL |            0.0 |      NULL | NULL       | NULL
 totalprice    |        NULL |                  NULL |            0.0 |      NULL | 857.71     | 555285.16
 orderdate     |        NULL |                  NULL |            0.0 |      NULL | 1992-01-01 | 1998-08-02
 orderpriority |   1366073.0 |                  NULL |            0.0 |      NULL | NULL       | NULL
 clerk         |   5086146.0 |                  NULL |            0.0 |      NULL | NULL       | NULL
 shippriority  |        NULL |                  NULL |            0.0 |      NULL | 0          | 0
 comment       | 5.0023156E7 |                  NULL |            0.0 |      NULL | NULL       | NULL
 NULL          |        NULL |                  NULL |           NULL | 1500000.0 | NULL       | NULL
(10 rows)
--- план: после drop_extended_stats
    └─ InnerJoin[criteria = (nationkey = nationkey_10), distribution = REPLICATED]
       │   Estimates: {rows: ? (?)}
       ├─ InnerJoin[criteria = (custkey = custkey_5), distribution = REPLICATED]
       │  │   Estimates: {rows: ? (?)}
       │  ├─ InnerJoin[criteria = (orderkey = orderkey_0), distribution = REPLICATED]
       │  │  │   Estimates: {rows: ? (?)}
       │  │  ├─ ScanFilter[table = iceberg:tpch.lineitem$data@3932404925859451115, dynamicFilters = {orderkey = #df_685}]
       │  │  │      Estimates: {rows: 6001215 (103.02MB)}
    ScanFilterProject[table = iceberg:tpch.orders$data@9221289947222329339, filterPredicate = ((date '1995-01-01' <= orderdate) AND (orderdate < date '1995-04-0
        Estimates: {rows: 1500000 (25.75MB)}
    ScanFilter[table = iceberg:tpch.customer$data@3152910255929120275, dynamicFilters = {nationkey = #df_683}]
        Estimates: {rows: 150000 (2.57MB)}
    TableScan[table = iceberg:tpch.nation$data@7436702068544008759]
        Estimates: {rows: 25 (863B)}
--- время: после drop_extended_stats
строк результата 25, первая JORDAN 9614
elapsed мс: [1731, 1929, 2212], медиана 1929
peak memory МБ: 45
Статистика удалена у всех четырёх таблиц, и план вернулся к исходному виду со знаками вопроса. Дальше Spark считает NDV по ключам join и колонке фильтра. До и после расчёта скрипт печатает статистику колонок, которую видит оптимизатор Spark, а в конце выводит логическую часть EXPLAIN COST для того же запроса.
# pyspark 4.0.4, iceberg-spark-runtime-4.0_2.13 1.10.1, прогнано на стенде 2026-10-22
"""NDV от Spark: compute_table_stats пишет Puffin, его потом читает и Spark CBO, и Trino.

Запуск внутри контейнера spark:
  /opt/spark/bin/spark-submit --driver-memory 2g /demo/04_spark_compute_stats.py
"""
import time

from pyspark.sql import SparkSession

spark = (
    SparkSession.builder.appName("compute_table_stats")
    .config("spark.sql.extensions",
            "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions")
    # тот же REST-каталог и то же S3, что у Trino
    .config("spark.sql.catalog.iceberg", "org.apache.iceberg.spark.SparkCatalog")
    .config("spark.sql.catalog.iceberg.type", "rest")
    .config("spark.sql.catalog.iceberg.uri", "http://rest:8181")
    .config("spark.sql.catalog.iceberg.io-impl", "org.apache.iceberg.aws.s3.S3FileIO")
    .config("spark.sql.catalog.iceberg.s3.endpoint", "http://seaweedfs:8333")
    .config("spark.sql.catalog.iceberg.s3.path-style-access", "true")
    # без CBO Spark не смотрит на статистику колонок
    .config("spark.sql.cbo.enabled", "true")
    .config("spark.sql.cbo.joinReorder.enabled", "true")
    .getOrCreate()
)
spark.sparkContext.setLogLevel("ERROR")
print("Spark", spark.version)


def column_ndv(table: str) -> dict:
    """NDV колонок, которые видит оптимизатор Spark в логическом плане."""
    stats = spark.table(table)._jdf.queryExecution().optimizedPlan().stats()
    result = {}
    it = stats.attributeStats().iterator()
    while it.hasNext():
        pair = it.next()
        cs = pair._2()
        # Оценка join в Spark требует и distinctCount, и nullCount у ключа
        ndv = int(str(cs.distinctCount().get())) if cs.distinctCount().isDefined() else None
        nulls = int(str(cs.nullCount().get())) if cs.nullCount().isDefined() else None
        result[pair._1().name()] = {"distinctCount": ndv, "nullCount": nulls}
    return result


print("статистика колонок в плане Spark до расчёта:", column_ndv("iceberg.tpch.orders"))

# Ключи join и колонки фильтров: считать NDV по всем колонкам дорого и не нужно
targets = {
    "tpch.nation": ["nationkey"],
    "tpch.customer": ["custkey", "nationkey"],
    "tpch.orders": ["orderkey", "custkey", "orderdate"],
    "tpch.lineitem": ["orderkey"],
}
for table, cols in targets.items():
    t = time.time()
    arr = ", ".join(f"'{c}'" for c in cols)
    row = spark.sql(
        f"CALL iceberg.system.compute_table_stats(table => '{table}', columns => array({arr}))"
    ).first()
    print(f"{table}: {time.time() - t:.1f} с, файл {row.statistics_file.rsplit('/', 1)[-1]}")

print("статистика колонок в плане Spark после расчёта:")
for name, cs in column_ndv("iceberg.tpch.orders").items():
    print(" ", name, cs)

# Тот же запрос, что в join_plan.py: смотрим оценки строк в плане Spark
plan = spark.sql("""
EXPLAIN COST
SELECT n.name, count(*) AS lines, sum(l.extendedprice) AS revenue
FROM iceberg.tpch.lineitem l
JOIN iceberg.tpch.orders o   ON l.orderkey = o.orderkey
JOIN iceberg.tpch.customer c ON o.custkey = c.custkey
JOIN iceberg.tpch.nation n   ON c.nationkey = n.nationkey
WHERE o.orderdate >= DATE '1995-01-01' AND o.orderdate < DATE '1995-04-01'
GROUP BY n.name
""").first()[0]
logical = plan.split("== Physical Plan ==")[0]
for line in logical.splitlines():
    if "Join" in line or "RelationV2" in line:
        print(line.strip()[:200])
spark.stop()
# Spark 4.0.4, Iceberg 1.10.1, прогнано на стенде 2026-10-22
docker compose exec -T spark /opt/spark/bin/spark-submit --driver-memory 2g /demo/04_spark_compute_stats.py
Весь скрипт отработал за 35 с вместе со стартом JVM. Из вывода отфильтровано предупреждение JVM про incubator modules, строка таймера тоже убрана.
Spark 4.0.4
статистика колонок в плане Spark до расчёта: {}
tpch.nation: 5.6 с, файл 7436702068544008759-73704362-0192-48b2-abb2-250710a5778f.stats
tpch.customer: 1.2 с, файл 3152910255929120275-b801440c-2901-47bc-a6b1-6898f537c9ba.stats
tpch.orders: 2.3 с, файл 9221289947222329339-9b21ded3-51cc-487f-bdee-917ae040ecb6.stats
tpch.lineitem: 2.0 с, файл 3932404925859451115-a9a65169-4753-48b9-af1d-829248f6ffee.stats
статистика колонок в плане Spark после расчёта:
  custkey {'distinctCount': 99721, 'nullCount': None}
  orderdate {'distinctCount': 2406, 'nullCount': None}
  orderkey {'distinctCount': 1498948, 'nullCount': None}
+- Join Inner, (orderkey#295L = orderkey#311L), Statistics(sizeInBytes=1522.5 EiB, rowCount=3.38E+19)
:  +- Join Inner, (custkey#312L = custkey#320L), Statistics(sizeInBytes=266.0 TiB, rowCount=5.63E+12)
:     :  +- Join Inner, (nationkey#323L = nationkey#328L), Statistics(sizeInBytes=186.0 MiB, rowCount=3.75E+6)
:     :     :  +- RelationV2[custkey#320L, nationkey#323L] iceberg.tpch.customer, Statistics(sizeInBytes=2.3 MiB, rowCount=1.50E+5)
:     :        +- RelationV2[nationkey#328L, name#329] iceberg.tpch.nation, Statistics(sizeInBytes=700.0 B, rowCount=25)
:           +- RelationV2[orderkey#311L, custkey#312L, orderdate#315] iceberg.tpch.orders, Statistics(sizeInBytes=28.6 MiB, rowCount=1.50E+6)
+- RelationV2[orderkey#295L, extendedprice#300] iceberg.tpch.lineitem, Statistics(sizeInBytes=91.6 MiB, rowCount=6.00E+6)
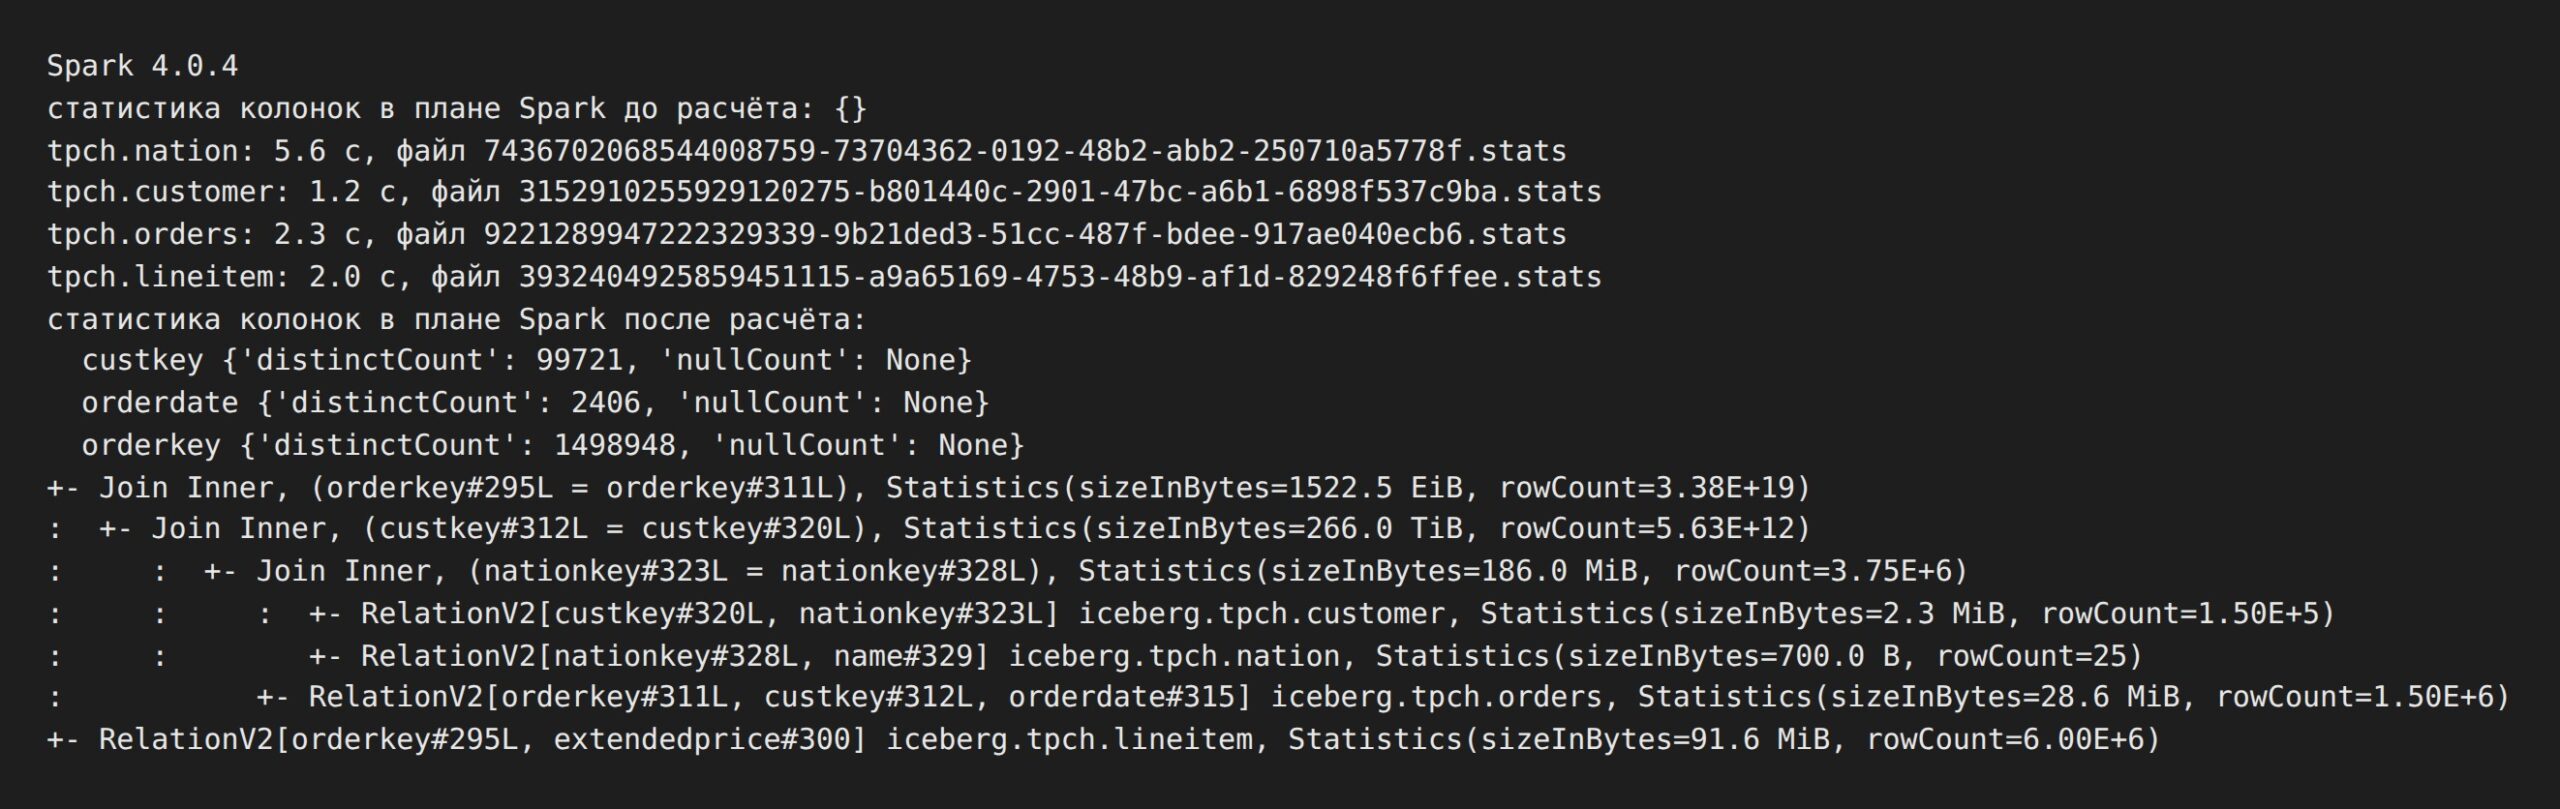
До расчёта оптимизатор Spark не видел никакой статистики колонок. После расчёта у трёх колонок orders появился distinctCount, и значения совпали с теми, что раньше насчитал Trino. Поле nullCount при этом пустое. Порядок join в плане Spark поменялся, первыми соединяются customer и nation. Этот порядок, вероятно, задаёт число строк таблиц (rowCount), а не NDV, а сами оценки строк выглядят абсурдно, вплоть до 3.38E+19 строк и 1522.5 EiB на верхнем join.
Осталось проверить, что Trino прочитает Puffin, который записал Spark.
-- Trino 484, Iceberg REST-каталог, прогнано на стенде 2026-10-22
-- Trino читает Puffin, который записал Spark: NDV есть только у посчитанных колонок.

SHOW STATS FOR iceberg.tpch.orders;
# Trino CLI 484, trino 0.340.0, boto3 1.43.117, прогнано на стенде 2026-10-22
docker compose exec -T trino trino --output-format ALIGNED --file /demo/05_show_stats.sql
.venv/bin/python inspect_metadata.py orders
.venv/bin/python join_plan.py "NDV от Spark"
  column_name  |  data_size  | distinct_values_count | nulls_fraction | row_count | low_value  | high_value
---------------+-------------+-----------------------+----------------+-----------+------------+------------
 orderkey      |        NULL |             1498948.0 |            0.0 |      NULL | 1          | 6000000
 custkey       |        NULL |               99721.0 |            0.0 |      NULL | 1          | 149999
 orderstatus   |    622668.0 |                  NULL |            0.0 |      NULL | NULL       | NULL
 totalprice    |        NULL |                  NULL |            0.0 |      NULL | 857.71     | 555285.16
 orderdate     |        NULL |                2406.0 |            0.0 |      NULL | 1992-01-01 | 1998-08-02
 orderpriority |   1366073.0 |                  NULL |            0.0 |      NULL | NULL       | NULL
 clerk         |   5086146.0 |                  NULL |            0.0 |      NULL | NULL       | NULL
 shippriority  |        NULL |                  NULL |            0.0 |      NULL | 0          | 0
 comment       | 5.0023156E7 |                  NULL |            0.0 |      NULL | NULL       | NULL
 NULL          |        NULL |                  NULL |           NULL | 1500000.0 | NULL       | NULL
(10 rows)
таблица orders текущий snapshot 9221289947222329339
снапшотов в истории 1
файлов в разделе statistics: 1
 snapshot-id 9221289947222329339 файл 9221289947222329339-9b21ded3-51cc-487f-bdee-917ae040ecb6.stats
 размер 82912 байт, футер 725 байт
  blob apache-datasketches-theta-v1 колонка orderkey ndv=1498948
  blob apache-datasketches-theta-v1 колонка custkey ndv=99721
  blob apache-datasketches-theta-v1 колонка orderdate ndv=2406
partition-statistics: 0

Puffin: первые 4 байта b'PFA1' последние 4 байта b'PFA1'
длина JSON футера 709 флаги 0 (0 значит футер не сжат)
properties футера: {'created-by': 'Iceberg Apache Iceberg 1.10.1 (commit ccb8bc435062171e64bc8b7e5f56e6aed9c5b934) Spark 4.0.4'}
  {'type': 'apache-datasketches-theta-v1', 'fields': [1], 'offset': 4, 'length': 30860, 'compression-codec': 'zstd', 'properties': {'ndv': '1498948'}}
  {'type': 'apache-datasketches-theta-v1', 'fields': [2], 'offset': 30864, 'length': 32045, 'compression-codec': 'zstd', 'properties': {'ndv': '99721'}}
  {'type': 'apache-datasketches-theta-v1', 'fields': [5], 'offset': 62909, 'length': 19278, 'compression-codec': 'zstd', 'properties': {'ndv': '2406'}}
--- план: NDV от Spark
    └─ InnerJoin[criteria = (orderkey = orderkey_0), distribution = REPLICATED]
       │   Estimates: {rows: 225290 (9.35MB)}
       │  └─ ScanFilter[table = iceberg:tpch.lineitem$data@3932404925859451115, dynamicFilters = {orderkey = #df_693}]
       │         Estimates: {rows: 6001215 (103.02MB)}
    InnerJoin[criteria = (nationkey = nationkey_10), distribution = REPLICATED]
    │   Estimates: {rows: 56271 (1.85MB)}
    ├─ InnerJoin[criteria = (custkey_5 = custkey), distribution = REPLICATED]
    │  │   Estimates: {rows: 56271 (989.15kB)}
    │  ├─ ScanFilter[table = iceberg:tpch.customer$data@3152910255929120275, dynamicFilters = {nationkey = #df_695, custkey_5 = #df_696}]
    │  │      Estimates: {rows: 150000 (2.57MB)}
    ScanFilterProject[table = iceberg:tpch.orders$data@9221289947222329339, filterPredicate = ((date '1995-01-01' <= orderdate) AND (orderdate < date '1995-04-0
        Estimates: {rows: 1500000 (25.75MB)}
    TableScan[table = iceberg:tpch.nation$data@7436702068544008759]
        Estimates: {rows: 25 (863B)}
--- время: NDV от Spark
строк результата 25, первая JORDAN 9614
elapsed мс: [1832, 1798, 2073], медиана 1832
peak memory МБ: 5
Trino видит NDV ровно у трёх колонок, которые посчитал Spark. В футере Puffin стоит created-by от Iceberg 1.10.1 и Spark 4.0.4, файл меньше прежнего, потому что блобов три, а не девять. План Trino совпал с планом после собственного ANALYZE до последней оценки. Сам Trino статистику не считал, ему хватило файла, лежащего рядом с таблицей.
Анализ данных с помощью современного Apache Spark
Код курса
SPARK
Ближайшая дата курса
14 декабря, 2026
Продолжительность
32 ак.часов
Стоимость обучения
102 400
Ограничения и подводные камни
Стенд показал несколько вещей, о которых обзоры обычно молчат.
- Миллисекунды на sf1 ничего не доказывают. Медиана упала с 2369 до 1916 мс после ANALYZE, но после удаления NDV было 1929 мс, а первый запуск без статистики занял 4001 мс. Разброс между запусками больше эффекта, поэтому судить нужно по плану и оценкам, а выигрыш во времени может проявиться на объёмах, где неудачный порядок join стоит дорого.
- Тип распределения не изменился. Без NDV Trino всё равно выбрал REPLICATED у всех join, потому что размеры таблиц известны из манифестов. На этом наборе NDV поменял порядок соединений и оценки, а не выбор между broadcast и partitioned.
- Spark CBO видит NDV, но оценивает join плохо. У колонок нет nullCount, и оценки строк в EXPLAIN COST завышены на порядки. Вероятная причина в том, что оценке join в Spark нужны и distinctCount, и nullCount ключа. Это вывод из кода Spark, в документации он не подтверждён.
- NDV плавает между прогонами. Для orderkey на одних и тех же данных мы видели 1498649 и 1498948. Theta sketch даёт оценку, и на неё влияет раскладка файлов после CTAS. Внутри одного прогона Trino и Spark дали одинаковые числа.
- Статистика привязана к снапшоту. Файл Puffin описывает тот снапшот, для которого его посчитали. Если новые данные пишет движок без сбора NDV, статистика описывает уже не текущее состояние таблицы. Как движки обходятся с таким файлом, на стенде мы не проверяли, у таблиц был один снапшот.
Ни одно из этих ограничений не отменяет статистику, но каждое влияет на то, как её собирать и как читать результат.
Когда запускать ANALYZE
Если таблицу пишет только Trino с настройками по умолчанию, NDV собирается при записи, и ANALYZE нужен после массовых изменений, когда накопленная статистика перестала отражать данные. Если в таблицу пишет Spark, NDV сам не появится, и расчёт нужно встроить в конвейер. Разумная точка для этого после компакции и крупных загрузок, как и советует Dremio. Считать NDV по всем колонкам необязательно. Достаточно ключей join и колонок частых фильтров, это дешевле и в Trino через опцию columns, и в Spark через аргумент columns. Проверка простая. Если в EXPLAIN у join стоят знаки вопроса вместо оценок строк, статистики оптимизатору не хватает. Как читать планы Trino и настраивать оптимизатор под реальную нагрузку, мы подробно разбираем на курсе по Trino для инженеров данных.
Заключение
Статистика таблиц Iceberg устроена в три слоя, и только верхний, NDV в файлах Puffin, даёт оптимизатору возможность оценить join. Trino пишет его по умолчанию при записи и по команде ANALYZE, Spark только по явному вызову compute_table_stats. Главное свойство этого формата подтвердилось на стенде. NDV, посчитанный одним движком, другой движок читает без всякой настройки, потому что статистика лежит рядом с таблицей, а не в чужом метасторе.