3
Содержание
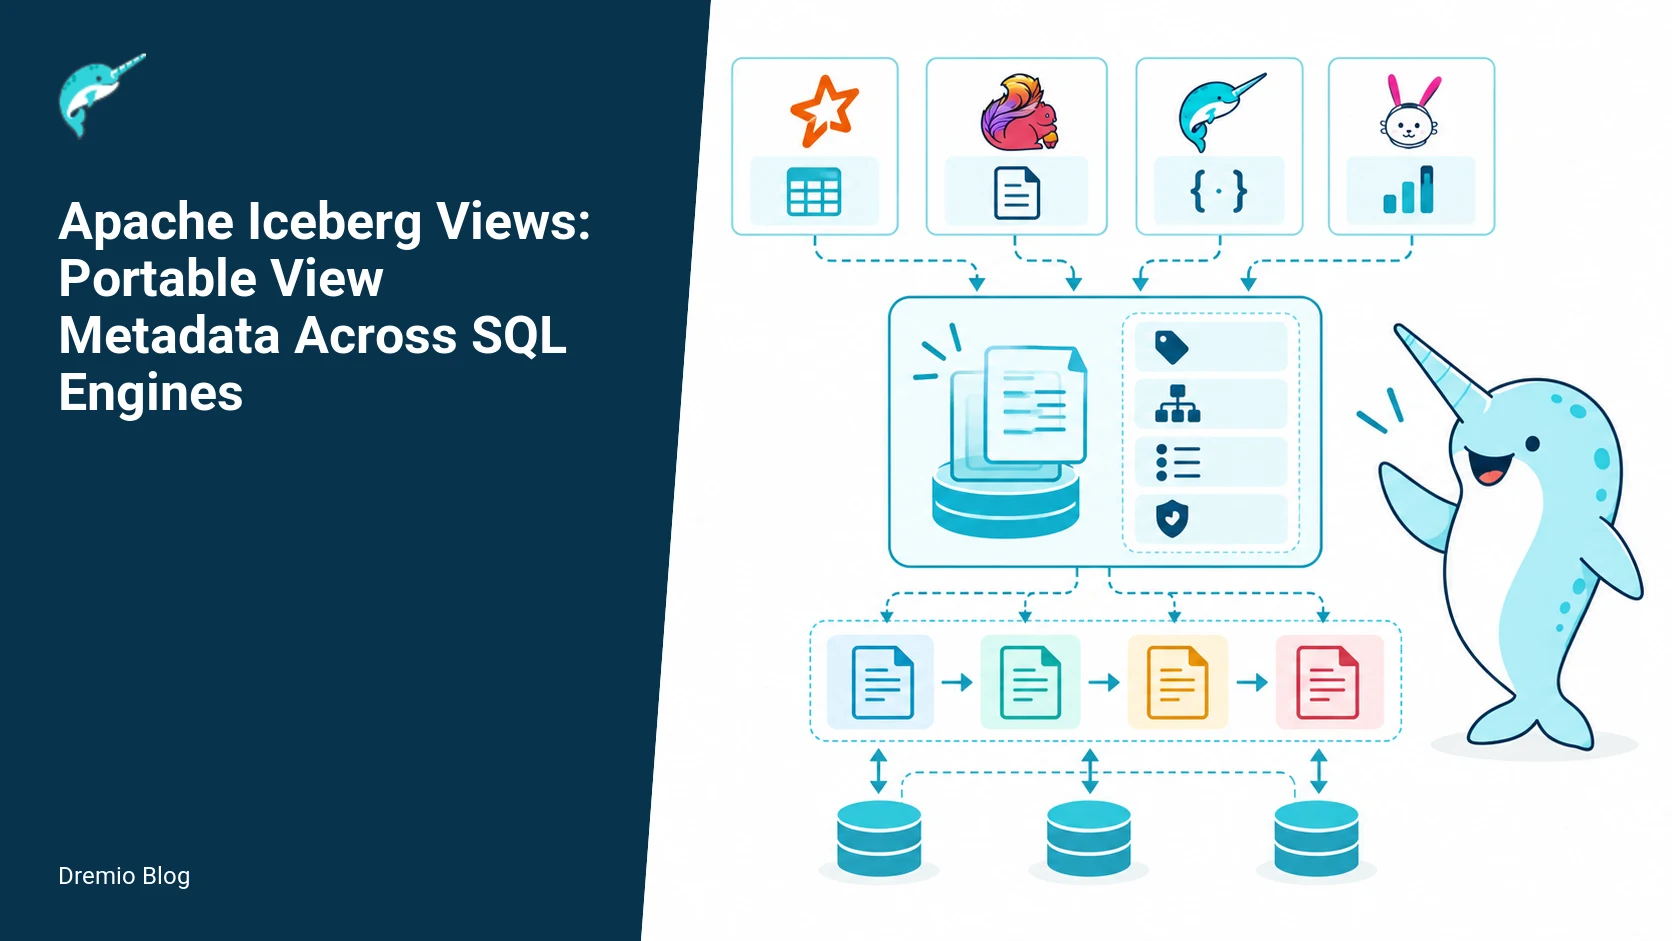
Apache Iceberg добавил в спецификацию поддержку представлений с хранением метаданных прямо в каталоге. Теперь SQL-запрос, схема, версии и зависимости описываются один раз и становятся доступны разным движкам без пересоздания. Это решает задачу совместного использования views в Spark, Trino и аналогичных системах, где раньше каждое представление приходилось дублировать под конкретный синтаксис и каталог. В крупных озёрах данных, где несколько команд одновременно работают с одними и теми же таблицами, такая централизация снижает риск расхождений и упрощает поддержку. Для архитекторов и инженеров данных это означает возможность выбирать между разными SQL-движками без дополнительной работы по синхронизации представлений.
Что именно хранит спецификация
Метаданные представления включают исходный SQL, результирующую схему, список зависимых таблиц и версию определения. При изменении базовой таблицы каталог фиксирует новую версию представления, сохраняя историю. Движок при обращении к view получает актуальный запрос и проверяет совместимость схемы, снижая риск ошибок после обновления данных. Здесь важно понимать, что каталог в экосистеме Iceberg выступает как единый источник правды: он хранит не только сами данные, но и описание того, как эти данные должны выглядеть для аналитиков. Версионирование позволяет откатиться к предыдущему состоянию представления, если после обновления базовой таблицы возникли проблемы с отчётами.
Дополнительно спецификация фиксирует диалекты SQL, чтобы при переносе между системами учесть различия в функциях и синтаксисе. Каталог возвращает не только текст запроса, но и сведения о том, какой движок создал представление и какие ограничения к нему применялись. Это позволяет избежать ручного анализа кода при миграции или совместной работе нескольких команд. Для команд, которые планируют переход с одного движка на другой или используют гибридную инфраструктуру, такая информация помогает оценить объём доработок заранее. Без этих метаданных миграция представлений часто превращается в длительный процесс ручного переписывания запросов.
Как это работает с Trino и Spark
Trino и Spark читают одни и те же метаданные Iceberg, но выполняют запрос в своём диалекте. При создании view в Spark его определение сохраняется в каталоге, после чего Trino может обратиться к тому же объекту без изменений. Каталог отвечает за разрешение зависимостей и проверку прав, поэтому права и история версий остаются едиными. Это особенно ценно в средах, где Spark используется для тяжёлых пакетных обработок, а Trino — для интерактивных запросов: обе системы работают с одним и тем же определением представления и не требуют отдельной синхронизации.
При обновлении базовой таблицы обе системы видят новую версию представления автоматически. Это устраняет необходимость синхронизировать DDL-скрипты вручную и снижает количество ошибок, связанных с расхождением схем. В крупных хранилищах данных такая централизация особенно заметна при работе нескольких аналитических команд. При принятии решения о внедрении стоит оценить, насколько часто в текущей инфраструктуре меняются базовые таблицы и насколько критична для бизнеса скорость реакции на эти изменения. Если обновления происходят ежедневно, а отчёты используются разными командами, централизованные представления дают заметный выигрыш в скорости и надёжности.
Ограничения при внедрении
Спецификация пока не покрывает все функции конкретных движков, поэтому сложные оконные выражения или proprietary-функции могут потребовать адаптации. При переносе нужно проверять, поддерживает ли целевой движок диалект, записанный в метаданных. Если поддержка отсутствует, view придётся переписывать или хранить отдельно. Перед внедрением рекомендуется составить список используемых функций и сравнить их с возможностями целевых движков, чтобы понять, какая доля представлений потребует доработки.
Каталог должен реализовать Iceberg View Spec полностью, иначе часть метаданных будет игнорироваться. Старые версии таблиц Iceberg без поддержки представлений придётся обновлять. В контурах с несколькими каталогами требуется обеспечить согласованность метаданных, иначе разные движки могут видеть разные версии одного представления. При оценке готовности инфраструктуры важно проверить, какие именно каталоги уже используются в проекте и поддерживают ли они новую спецификацию. Если каталог не обновлён, внедрение представлений не даст ожидаемого эффекта и может привести к скрытым расхождениям.
Использование в российских проектах
В инфраструктурах на базе Spark и Trino, где данные хранятся в S3-совместимых хранилищах, новая возможность сокращает дублирование DDL-скриптов и упрощает миграцию между кластерами. Команды, работающие с озёрами данных, получают единый источник правды для представлений, что снижает время настройки новых отчётов. При этом важно проверить совместимость используемого каталога с Iceberg View Spec до начала внедрения. В российских компаниях, где часто сочетаются несколько аналитических платформ и требуется быстро переносить отчётность между кластерами, это снижает операционную нагрузку на инженеров данных и уменьшает вероятность ошибок при передаче знаний между командами.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Переносимые представления Iceberg между движками.
Курс по теме — Каталог курсов Школы Больших Данных