
В продолжение темы про совместное использование Apache Kudu с другими технологиями Big Data, сегодня рассмотрим, как эта NoSQL-СУБД работает вместе с Kafka, Spark и Cloudera Impala для построения озера данных (Data Lake) для быстрой аналитики больших данных в режиме реального времени. Также читайте в нашей статье про особенности интеграции Apache...
Продолжая разговор про интеграцию информационных систем с помощью стриминговой платформы, сегодня мы рассмотрим преимущества event streaming архитектуры на примере Apache Kafka. Также читайте в нашей статье про 5 ключевых сценариев использования Кафка в потоковой обработке событий: от IoT/IIoT до микросервисного разделения в системах аналитики больших данных (Big Data) и машинного...
В этой статье поговорим про интеграцию информационных систем: обсудим SOA и ESB-подходы, рассмотрим стриминговую архитектуру и возможности Apache Kafka для организации быстрого и эффективного обмена данными между различными бизнес-приложениями. Также обсудим, что влияет на архитектуру интеграции корпоративных систем и распределенных Big Data приложений, что такое спагетти-структура и почему много сервисов...
Сегодня мы расскажем, почему каждый Big Data специалист должен знать этот язык программирования и как «Школа Больших Данных» поможет вам освоить его на профессиональном уровне. Читайте в нашей статье, кому и зачем нужны корпоративные курсы по Python в области Big Data, Machine Learning и других методов Data Science. Чем хорош...
В продолжение темы про проявление Agile-принципов в Big Data системах, сегодня мы рассмотрим, как DevOps-подход отражается в использовании Apache Kafka. Читайте в нашей статье про кластерную архитектуру коннекторов Кафка и KSQL – SQL-движка на основе API клиентской библиотеки Kafka Streams для аналитики больших данных, о которой мы рассказывали здесь. Из...
Мы уже рассказывали, как некоторые принципы Agile отражаются в Big Data системах. Сегодня рассмотрим это подробнее на примере коннекторов Кафка и KSQL – SQL-движка для Apache Kafka. Он который базируется на API клиентской библиотеки для разработки распределенных приложений с потоковыми данными Kafka Streams и позволяет обрабатывать данные в режиме реального...
Продолжая разговор про интеграцию Elasticsearch с Кафка, сегодня мы рассмотрим, с какими ошибками можно столкнуться при практическом использовании Apache Kafka Connect. Также рассмотрим, как Kafka Connect поддерживает обработку ошибок и какие параметры нужно настроить для непрерывной передачи данных или ее остановки в случае сбоя. 2 варианта обработки ошибок в Kafka...
Сегодня поговорим, как связать Elasticsearch с Apache Kafka: рассмотрим, зачем нужны коннекторы, когда их следует использовать и какие особенности популярных в Big Data форматов JSON и AVRO стоит при этом учитывать. Также читайте в нашей статье, что такое Logstash Shipper, чем он отличается от FileBeat и при чем тут Kafka...
Сегодня рассмотрим основные преимущества ClickHouse – аналитической СУБД от Яндекса для обработки запросов по структурированным большим данным в реальном времени. Читайте в нашей статье, чем еще хорош Кликхаус, кроме высокой скорости, и почему эту систему так любят аналитики, разработчики и администраторы Big Data. Чем хорош ClickHouse: главные преимущества Напомним, основным...
Интеграционный движок Kafka Engine для потоковой загрузки данных в ClickHouse из топиков Кафка – наиболее популярный инструмент для связи этих Big Data систем. Однако, он не единственное средство интеграции Кликхаус с Apache Kafka. Сегодня рассмотрим, как еще можно организовать потоковую передачу больших данных от самого популярного брокера сообщений в колоночную...
Вчера мы рассматривали интеграцию ClickHouse с Apache Kafka с помощью встроенного движка. Сегодня поговорим про проблемы, которые могут возникнуть при его практическом использовании и разберем способы их решения для корректной связи этих Big Data систем. Почему случаются тайм-ауты: многопоточность и безопасность Напомним, интеграцию ClickHouse и Kafka обеспечивает встроенный движок (engine),...
В этой статье рассмотрим интеграцию ClickHouse с Apache Kafka: когда и зачем она нужна, как связать эти две Big Data системы, каковы ограничения и недостатки существующих способов и каким образом их можно обойти. Также разберем, почему кластер Кликхаус использует Zookeeper и что такое материализованное представление таблицы Кафка. Big Data маркетинг,...
Мы уже рассказывали про интеграцию Tarantool с Apache Kafka на примере Arenadata Grid. Сегодня рассмотрим, как интегрировать Кафка с MPP-СУБД Greenplum и каковы ограничения каждого из существующих способов. Читайте в сегодняшнем материале, что такое GPSS, PXF и при чем тут Docker-контейнер с коннектором Кафка для Arenadata DB. IoT и не...
Продолжая разбираться с In-Memory СУБД Tarantool и Arenadata Grid, сегодня рассмотрим, как эти резидентные базы данных интегрируются с Apache Kafka. Читайте в нашей статье, что такое коннекторы и процессоры, а также как записать в топик Кафка сообщение, SQL-запрос или часть таблицы. Arenadata Grid и Apache Kafka: коннектор + процессоры Напомним,...
Вчера мы затрагивали тему управления поставками в ритейле с помощью технологий Big Data и Machine Learning. Теперь разберем подробнее, как большие данные, машинное обучение и интернет вещей меняют складскую логистику и насколько это выгодно бизнесу. Сегодня мы собрали для вас 7 практических примеров: кейсы от отечественных и зарубежных транспортных компаний,...
В этой статье мы продолжим рассказывать про практическое использование отечественных Big Data решений на примере российского дистрибутива Arenadata Hadoop (ADH) и массивно-параллельной СУБД для хранения и анализа больших данных Arenadata DB (ADB). Сегодня мы приготовили для вас еще 3 интересных кейса применения этих решений в проектах цифровизации бизнеса и государственном...
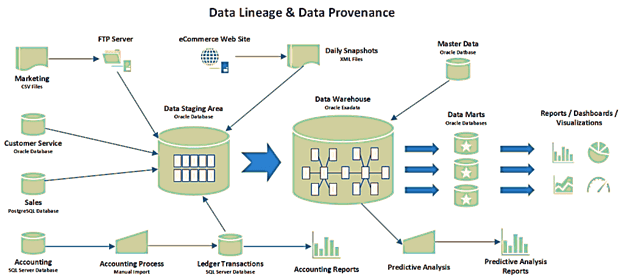
В этой статье мы продолжим разговор про основы управления данными и рассмотрим, что такое data provenance и data lineage, чем похожи и чем отличаются эти понятия. Также разберем, почему эти термины особенно важны для Big Data, какие инструменты помогают работать с ними, а также при чем здесь GDPR. Что такое...
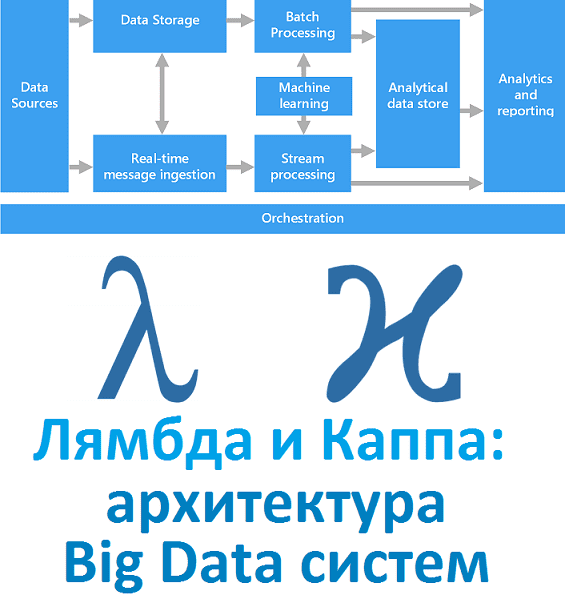
Вчера мы рассказали, что такое лямбда-архитектура. Сегодня рассмотрим Каппа - альтернативный подход к проектированию Big Data систем. Читайте в нашей статье, зачем нужна эта концепция, каковы ее достоинства и недостатки, чем Каппа отличается от Лямбда, где это используется на практике и при чем тут Apache Kafka с Machine Learning. Зачем...
Не претендуя на лавры Мэри и Тома Поппендиков, которые впервые освятили применение Lean в разработке ПО, сегодня мы расскажем, как идеи бережливого производства реализуются в области Big Data. Читайте в нашей статье про принцип вытягивания в Apache Kafka, концепцию «точно вовремя» в Apache Spark, SMED в Kubernetes и облачных кластерах...
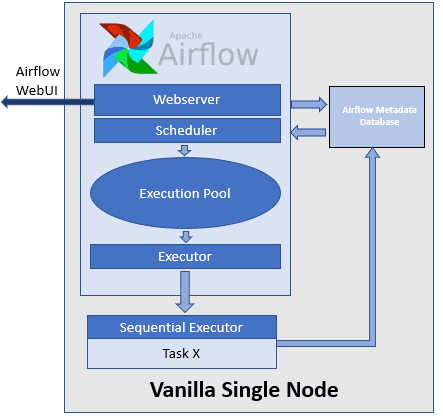
Недавно мы рассказывали про Airflow Kubernetes Executor, который позволяет выполнять задачи DAG-графа Эйрфлоу в среде Kubernetes, развертывая Docker-контейнер на отдельном пользовательском модуле (pod). Сегодня рассмотрим, какие еще есть исполнители задач в Apache Airflow, как они используются при автоматизации batch-процессов обработки больших данных и с какими проблемами можно столкнуться при их...