1
Содержание
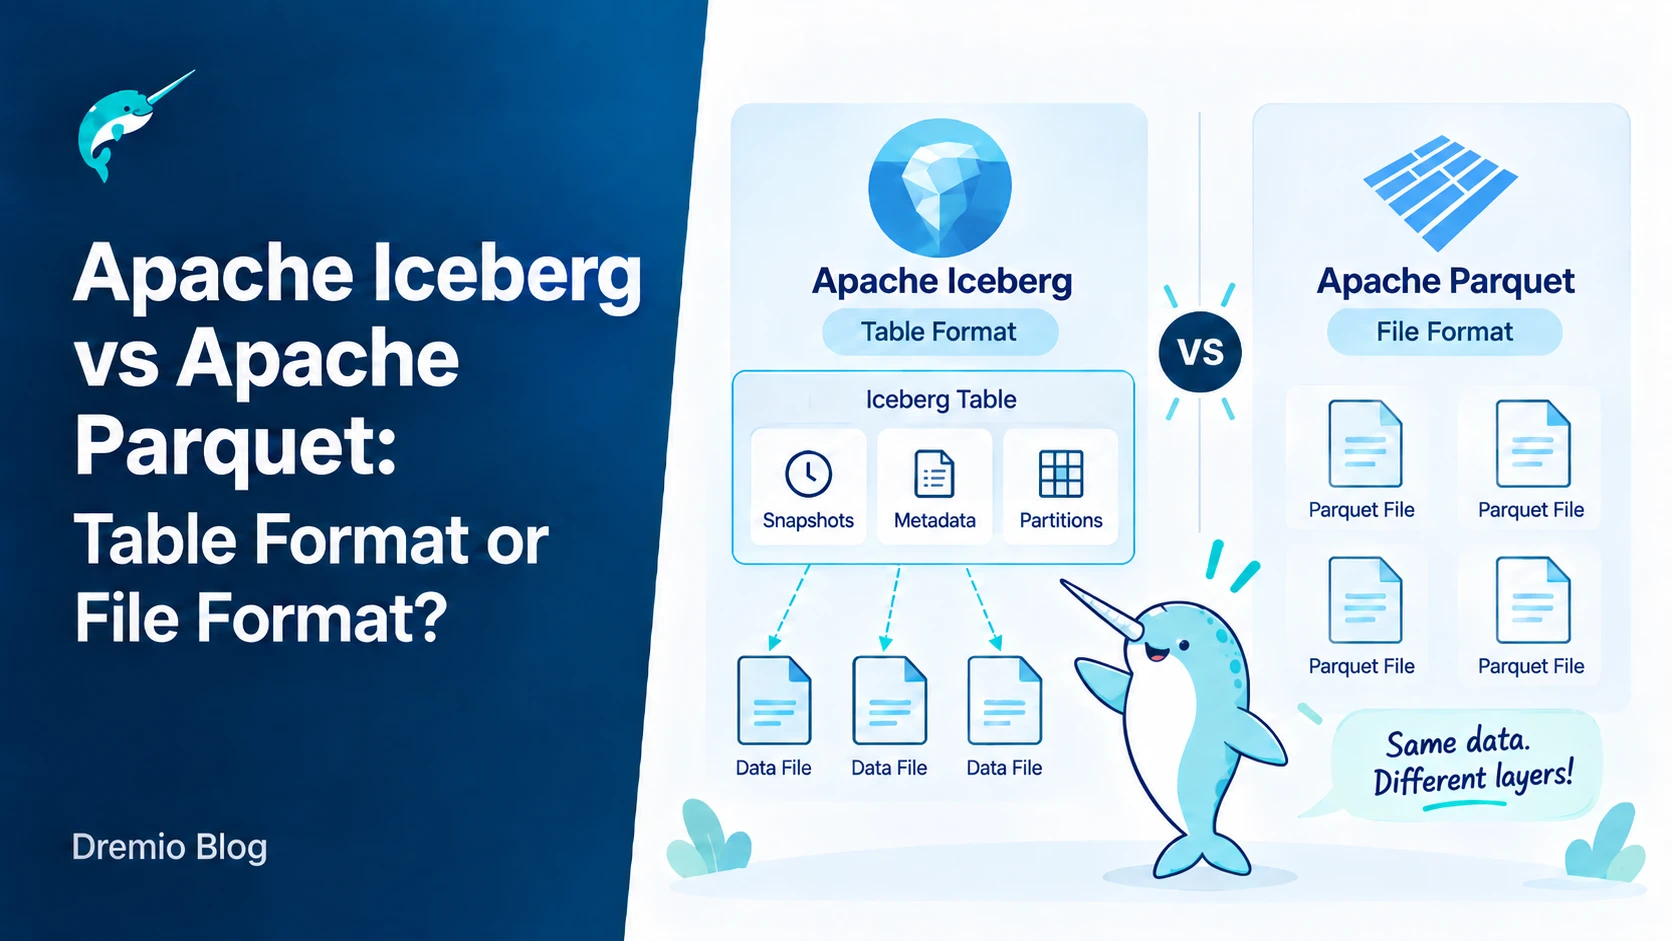
Dremio напомнила, что Apache Iceberg и Apache Parquet относятся к разным уровням стека и не конкурируют между собой. Iceberg описывает структуру таблицы, метаданные и правила доступа, а Parquet хранит сами данные в колонковом виде. Без понимания этой разницы инженеры часто выбирают инструмент не по задаче и получают лишние ограничения при масштабировании. Разделение уровней помогает точно определить, где возникает узкое место: в управлении таблицей или в физическом хранении данных. Это особенно важно при планировании роста хранилища и выборе между добавлением нового слоя или оптимизацией существующего.
Какой слой отвечает за что
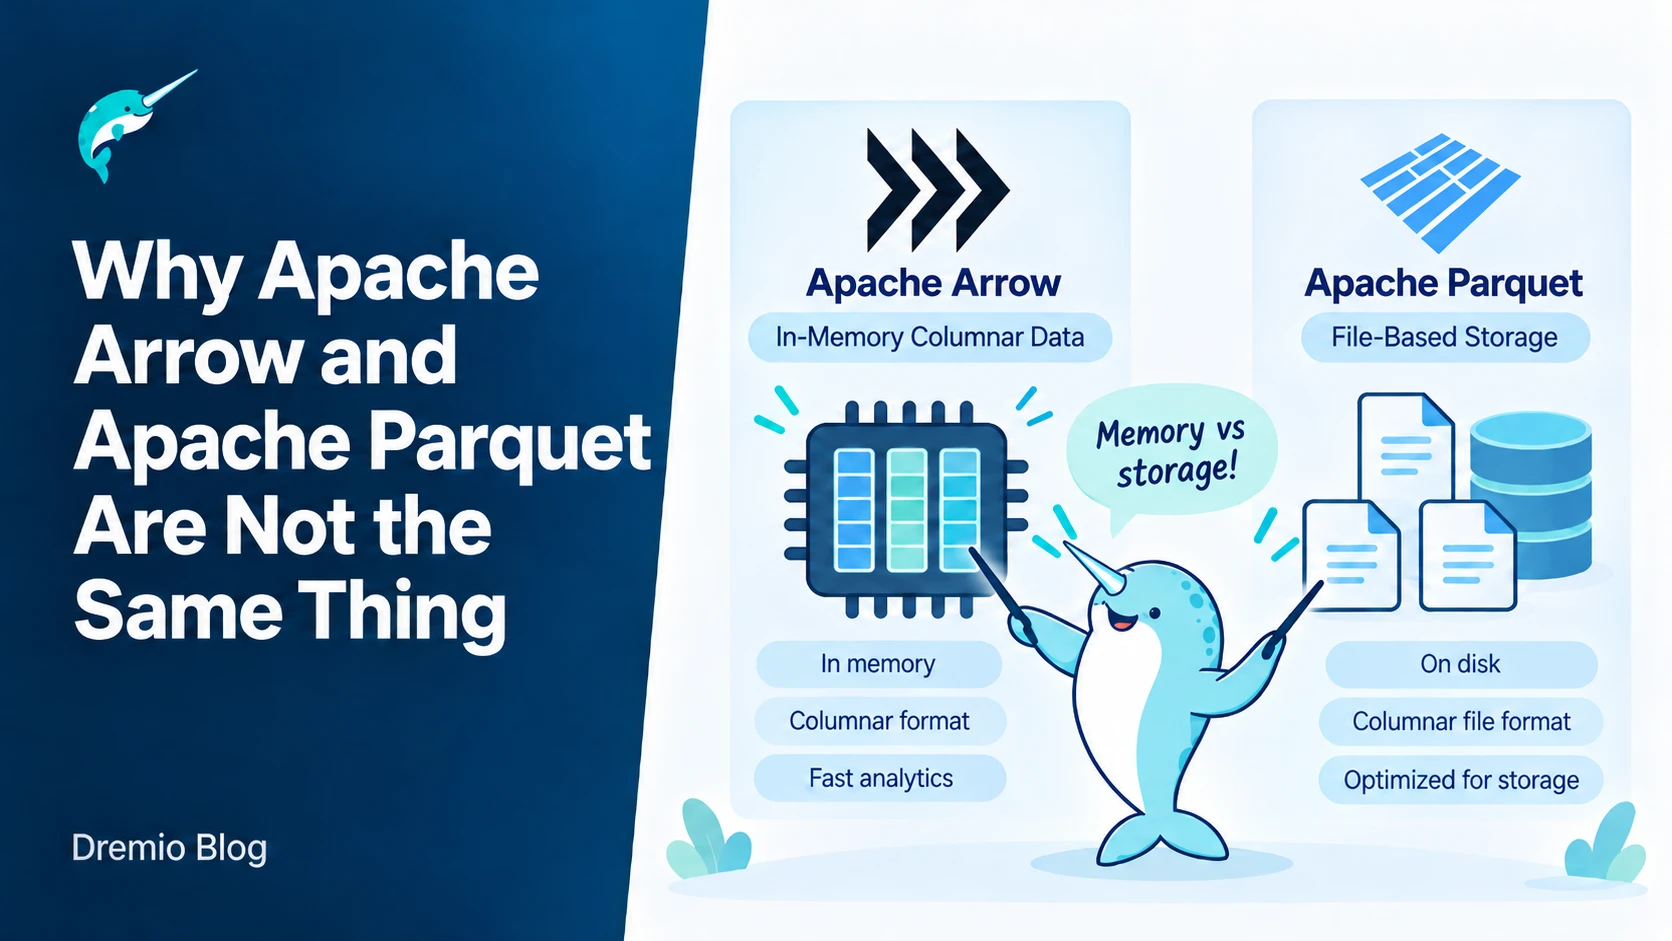
Iceberg работает с каталогом таблиц: фиксирует схему, партиции, снапшоты и правила эволюции. Он не хранит строки, а только указывает, какие файлы относятся к таблице и в каком порядке их читать. Снапшоты представляют собой версии состояния таблицы в разные моменты времени, что позволяет отслеживать изменения и выполнять откат. Parquet, напротив, отвечает за физическое размещение данных внутри файла: сжатие колонок, кодирование и статистику по блокам. Статистика помогает механизмам запросов пропускать ненужные блоки при фильтрации. Когда Iceberg записывает данные, он просто создаёт новые Parquet-файлы и обновляет свои метаданные. Поэтому замена одного формата файла на другой не требует переписывания логики таблицы, а смена движка Iceberg на другой каталог не меняет сами файлы. Такое разделение снижает риск ошибок при миграции и упрощает поддержку нескольких аналитических движков.
Что даёт понимание разницы при выборе
Если проект упирается в управление версиями и атомарные изменения, то добавляют Iceberg или аналогичный слой, а не меняют Parquet на ORC. Атомарность гарантирует, что либо все изменения применяются, либо ни одно, что критично при параллельной записи. Если же узкое место — скорость чтения отдельных колонок или размер хранилища, то оптимизируют настройки Parquet: размер row group, кодирование, bloom-фильтры. Row group — это логическая группа строк внутри файла, от размера которой зависит эффективность фильтрации и сжатия. Смешение уровней приводит к тому, что команды пытаются решить задачу партиционирования через свойства файла или, наоборот, ждут от Iceberg лучшего сжатия. В итоге появляются лишние копии данных и усложняется отладка запросов. При выборе важно оценить, насколько часто данные меняются и требуется ли история версий, чтобы избежать избыточных затрат на метаданные.
Как это выглядит в российских контурах
В изолированных сетях без доступа к коммерческим каталогам чаще всего разворачивают Iceberg поверх HDFS или S3-совместимого хранилища. HDFS обеспечивает распределённое хранение внутри организации, а S3-совместимые решения позволяют использовать локальные объектные хранилища. При этом важно проверить совместимость используемого Spark или Trino с версией Iceberg, потому что старые сборки не всегда корректно обрабатывают метаданные снапшотов. Parquet-файлы при этом остаются теми же, что и в открытых облаках, поэтому перенос кода между тестовым и промышленным контуром не требует переписывания запросов. Ограничением становится отсутствие managed-каталога с branching, как в Nessie, поэтому команды сами реализуют политику хранения снапшотов через скрипты. Это требует дополнительных усилий по мониторингу и очистке устаревших версий, но сохраняет независимость от внешних сервисов.
Когда стоит добавлять Iceberg
Если таблица растёт на десятки терабайт и требует частых обновлений отдельных партиций без перезаписи всего набора, Iceberg даёт атомарность и историю изменений. Это снижает время простоя и риск потери данных при откате. Если же данные загружаются раз в сутки и запросы касаются всего датасета целиком, то достаточно Parquet с правильно выбранным партиционированием на уровне файловой системы. В первом случае добавление Iceberg увеличивает накладные расходы на метаданные, во втором — даёт избыточный слой без заметного выигрыша. Поэтому решение принимают после оценки частоты изменений и требований к откату. Дополнительно учитывают, нужно ли поддерживать несколько движков запросов одновременно и насколько критична переносимость данных между средами.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Iceberg и Parquet решают разные задачи.
Курс по теме — Каталог курсов Школы Больших Данных