1
Содержание
В июле 2026 года в сообществе Apache Iceberg рассмотрели предложение добавить Vortex как четвертый формат данных. Автор разбил заявку на критерии и описание кандидата, чтобы сначала договориться о правилах, а потом обсуждать конкретный формат. Это важно потому, что любое расширение списка форматов меняет контракт между всеми движками на годы вперед и влияет на то, смогут ли Spark, Trino, Flink и DuckDB работать с одной таблицей без доработок. Решение о включении нового формата напрямую определяет, стоит ли командам планировать миграцию или продолжать полагаться на проверенные решения, поскольку несовместимость может привести к изолированным датасетам и дополнительным затратам на поддержку нескольких систем.
Требования к метаданным и эволюции схемы
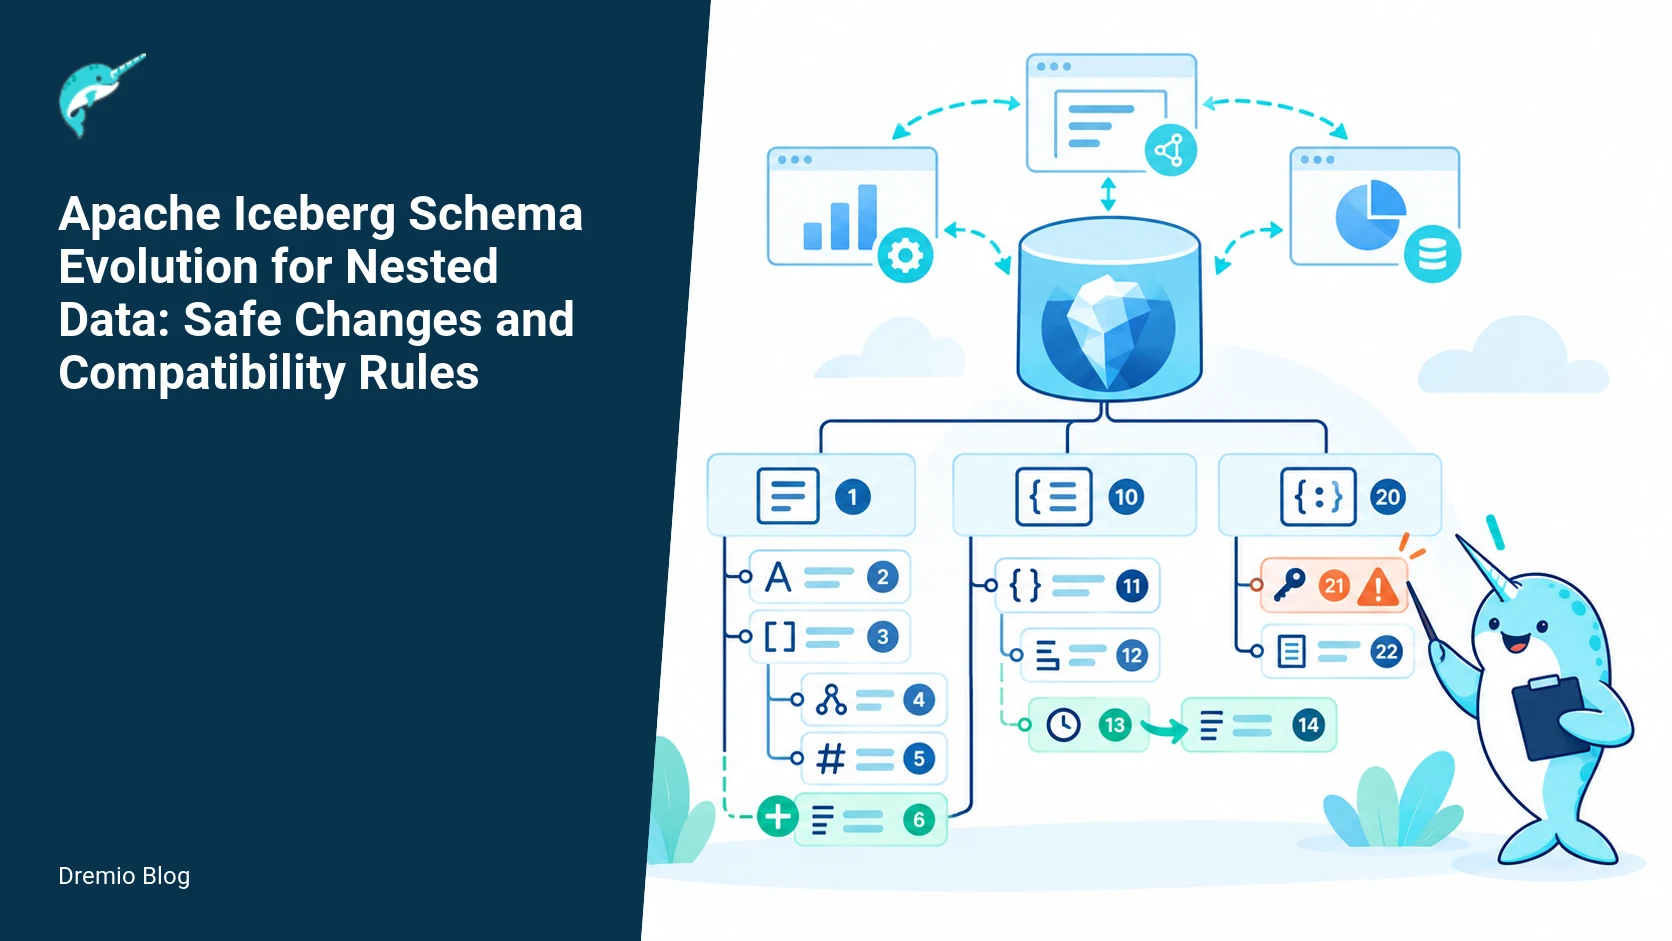
Iceberg хранит в манифестах номера полей, а не только имена, поэтому новый формат обязан сохранять те же field IDs при записи и чтении. Field IDs — это уникальные числовые идентификаторы колонок, которые позволяют отслеживать эволюцию схемы: переименование, добавление или удаление полей без переписывания существующих файлов. Без этого теряется возможность переименовывать колонки и добавлять поля без переписывания файлов. Vortex должен доказать, что его заголовки позволяют хранить и обновлять эти идентификаторы точно так же, как Parquet. Если формат не обеспечивает стабильность field IDs, команды не смогут безопасно эволюционировать схемы в production, что делает его непригодным для долгосрочного использования в многодвижковых средах.
Кроме того, формат обязан отдавать статистику по колонкам и позиции строк внутри файла. Эти данные используют для pruning и для merge-on-read. Pruning — это механизм отсечения файлов и блоков данных при выполнении запроса на основе минимальных и максимальных значений в колонках, что снижает объем сканируемых данных. Merge-on-read — подход к обработке изменений, при котором обновления и удаления применяются динамически во время чтения, а не записываются сразу в новые файлы. Если статистика неполная или позиции строк нестабильны, планировщики в Trino и Spark начнут читать лишние файлы, а в некоторых случаях вообще откажутся от pushdown. Проверять нужно не только наличие полей, но и точность значений при разных типах данных. Для принятия решения о внедрении это критично: недостаточная статистика напрямую влияет на производительность запросов и может сделать формат неприемлемым для аналитических нагрузок с большими объемами данных.
Управление и поддержка экосистемы
Формат, попадающий в спецификацию, обязаны поддерживать все основные реализации Iceberg. Спецификация (spec) — это набор правил, который гарантирует одинаковое поведение формата во всех движках. Плагин в Java 1.11.0 позволяет экспериментировать, но вхождение в spec означает, что каждая команда Flink, DuckDB и Python-библиотек должна добавить чтение. Без этого таблица перестает быть универсальной и делится на «читается только в тех движках, где есть плагин». Такой раскол повышает риски при выборе формата, поскольку организации, использующие несколько систем, теряют гибкость и вынуждены поддерживать отдельные контуры.
Vortex уже имеет открытый код и политику управления через независимый фонд. Это снижает риск, что формат уйдет под контроль одной компании. Однако до включения в spec нужно подтверждение от мейнтейнеров Spark, Trino и Flink, что они готовы взять поддержку на себя в разумные сроки. В российских контурах чаще всего используют Spark и Trino на своих кластерах, а обновления приходят с задержкой. Поэтому раннее появление поддержки Vortex маловероятно, и команды продолжат полагаться на Parquet. При этом любые эксперименты с плагинами стоит вести только в изолированных таблицах, чтобы не сломать совместимость с остальными системами. При оценке стоит учитывать, что отсутствие широкой поддержки делает формат рискованным для production-таблиц, где требуется стабильная работа без привязки к одному вендору.
Положение Parquet и смешанные таблицы
Parquet продолжает получать улучшения: columnar индексы, лучшая компрессия и поддержка row-level deletes. Эти изменения уменьшают разрыв в скорости случайного доступа, который Vortex обещает закрыть. Если Parquet закроет большую часть потребностей, необходимость в четвертом формате снизится. Командам важно отслеживать, насколько реальные приросты производительности Vortex оправдают затраты на интеграцию, особенно если Parquet уже обеспечивает приемлемую скорость для большинства сценариев.
Iceberg уже умеет хранить в одной таблице файлы разных форматов. Это позволяет постепенно переводить старые данные на новый формат, но только если все движки читают оба варианта. Пока Vortex не войдет в spec, смешанные таблицы останутся доступны лишь тем, кто явно настроил плагины. Возможность смешанных таблиц снижает порог входа для тестирования, однако без гарантий совместимости такой подход несет риск фрагментации данных и усложнения миграций в будущем.
Что делать командам сейчас
Пока решение не принято, безопаснее продолжать использовать Parquet и следить за обсуждением критериев. Если Vortex докажет совместимость по field IDs, статистике и row positions, а также получит поддержку ключевых движков, его можно будет тестировать на новых таблицах. До этого момента любые попытки внедрения рискуют создать изолированные датасеты, которые перестанут работать при смене движка или обновлении Iceberg. При принятии решения стоит взвесить потенциал производительности против рисков совместимости и задержек в поддержке.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Vortex и бар для новых форматов Iceberg.
Курс по теме — Каталог курсов Школы Больших Данных