
 11
Содержание
- Что такое Star schema и какую задачу она решает
- Архитектура звезды, таблица фактов и измерения
- Гранулярность, меры и внешние ключи факта
- Измерения, суррогатные ключи, иерархии и conformed dimensions
- Как запрос работает со звездой
- Snowflake schema и нормализованные измерения
- Star schema против Snowflake schema
- Медленно меняющиеся измерения и другие подводные камни
- Когда выбирать звезду, а когда снежинку
- Практика, одна выборка на звезде и на снежинке в PostgreSQL 18
- Схемы и тестовые данные
- Планы запросов и время выполнения
- Цена переименования атрибута
- Заключение
- Референсные ссылки
Схема звезда (Star schema) это метод многомерного моделирования хранилища и витрины данных, где в центре стоит таблица фактов с числовыми мерами, а вокруг неё денормализованные таблицы измерений. Каждое измерение связано с фактом напрямую, поэтому аналитический запрос обходится одним уровнем JOIN, а диаграмма связей похожа на звезду. Snowflake schema (схема «снежинка») раскладывает те же измерения по цепочкам нормализованных подтаблиц.
Ниже разобраны устройство звезды, работа запроса и отличия от снежинки, замеренные на PostgreSQL 18.6 на одних и тех же 2 млн строк продаж.
Что такое Star schema и какую задачу она решает
Аналитику нужен не отдельный заказ, а выручка по категориям за квартал или средний чек по регионам. В базе, нормализованной до третьей нормальной формы (3NF), такой вопрос превращается в запрос на десяток таблиц, и автор должен помнить, через какие связи идти. Звезда решает задачу разделением ролей. Всё, что считается, лежит в таблице фактов, а всё, по чему режут и фильтруют, в измерениях.
Метод популяризовал Ralph Kimball (Ральф Кимбалл), основатель Kimball Group и автор книги The Data Warehouse Toolkit, третье издание которой вышло в 2013 году. На неё ссылается и руководство Microsoft для BI-платформы Power BI, где звезда рекомендована основной формой модели.
Архитектура звезды, таблица фактов и измерения
Таблицы звезды бывают двух типов, и Microsoft отдельно предупреждает против таблиц, где измерение и факт сложены вместе. Как из отдельных звёзд и снежинок складывается всё хранилище, рассказано в статье DWH по Кимбаллу и Data Mesh.
Гранулярность, меры и внешние ключи факта
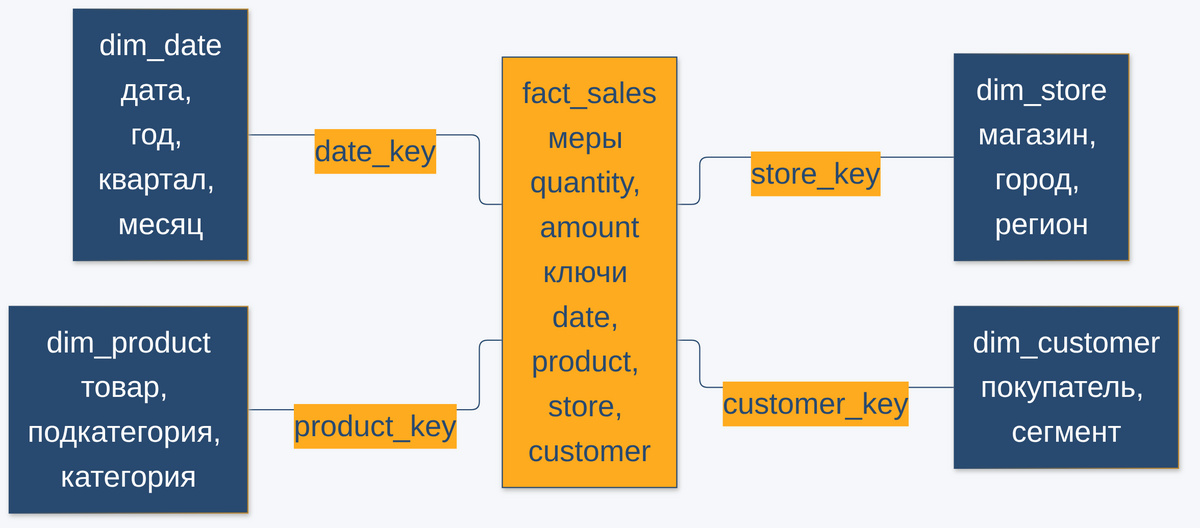
Таблица фактов (fact table) хранит события, например продажи или остатки на складе. В ней только ключи измерений и числовые меры (measures) вроде количества и суммы. Значения ключей задают гранулярность (grain), то есть смысл одной строки. В демо ниже строка fact_sales это позиция чека с датой, товаром, магазином и покупателем. Гранулярность на всю таблицу одна, иначе суммы по мерам перестают складываться.
Факты занимают почти весь объём хранилища. На тестовых данных таблица фактов из 2 млн строк весит 115 MB, а самое крупное измерение, покупатель на 100 тысяч строк, 9976 kB. Поэтому внешние ключи (foreign key) на факте объявляют после загрузки или не объявляют совсем. В пилотном прогоне вставка 2 млн строк в таблицу с четырьмя внешними ключами шла 79.6 с, а без них 6.0 с плюс 3.6 с на последующий ALTER TABLE.
Измерения, суррогатные ключи, иерархии и conformed dimensions
Таблица измерений (dimension table) описывает бизнес-сущность, например товар, магазин или дату. В ней ключ и текстовые атрибуты для фильтров и группировки, а строк на порядки меньше, чем в факте. Ключ обычно суррогатный (surrogate key), это целое число, которое назначает хранилище, а не учётная система. Естественный ключ вроде артикула SKU-00042 остаётся обычным атрибутом. Суррогатный ключ становится обязательным, как только измерение начинает хранить историю.
Иерархия в звезде лежит в одной строке. Товар, подкатегория и категория записаны рядом в dim_product, и название категории повторяется у каждого товара. Такая денормализация избавляет запрос от лишних JOIN ценой дублирования. Измерение, общее для нескольких фактов, например одна дата для продаж и для остатков, в каталоге техник Kimball Group значится в разделе интеграции как conformed dimension (согласованное измерение): через него два факта сводятся в одном отчёте.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Как запрос работает со звездой
Запрос к звезде фильтрует и группирует по атрибутам измерений, а агрегирует меры факта. Каждое измерение соединяется с фактом напрямую, поэтому глубина соединений всегда один уровень. В Power BI такой запрос порождает каждый визуал отчёта.
Порядок соединений выбирает планировщик, а не автор SQL. В PostgreSQL 18 явные JOIN, кроме FULL JOIN, переписываются в общий список FROM и переставляются, пока элементов в нём не больше join_collapse_limit, по умолчанию 8. Для подзапросов тот же предел задаёт from_collapse_limit. С 12 элементов, это geqo_threshold, вместо полного перебора включается генетический оптимизатор GEQO (Genetic Query Optimizer). Звезда с четырьмя-шестью измерениями укладывается в первый предел с запасом, а снежинка из факта, даты и двух цепочек по три таблицы упирается в него ровно.
В плане сначала параллельно читается факт, первым соединяется измерение даты с фильтром, затем товар и магазин. Hash Join строит хеш-таблицу по меньшей стороне соединения, здесь по измерению, и прогоняет через неё все отобранные строки факта. Пока справочники маленькие и хеш помещается в память, цена запроса растёт в первую очередь с числом соединений.
Snowflake schema и нормализованные измерения
Snowflake schema (схема «снежинка») это звезда с нормализованными измерениями. Товар ссылается на подкатегорию, подкатегория на категорию, магазин на город, город на регион, и каждое название хранится один раз. С облачной СУБД Snowflake модель не связана, совпадает только название. Обе модели разбираются на курсе Архитектура данных с Apache Spark, в программе которого схема звезда и снежинка разбирается отдельным пунктом.
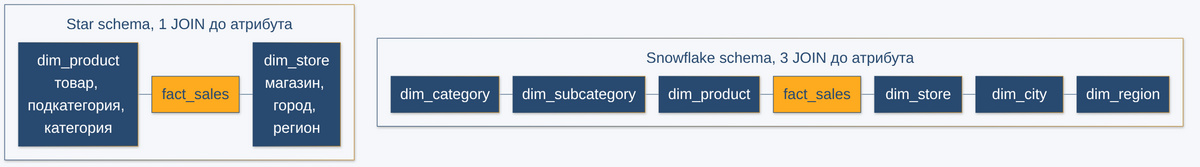
Факт при этом не меняется, удлиняется только путь до атрибута.
Star schema против Snowflake schema
Различия двух моделей на данных из практической части сведены в таблицу.
| Критерий | Star schema | Snowflake schema |
|---|---|---|
| Таблиц в демо-модели | 4 измерения и факт | 8 измерений и факт |
| Соединений в запросе по категории и региону | 3 | 7 |
| Дублирование атрибутов | название категории повторяется у каждого товара | каждое название хранится один раз |
| Размер измерений товара и магазина | 2 таблицы, 2120 kB | 6 таблиц, 1912 kB |
| Переименование категории | UPDATE 1000 строк, 2287 kB в WAL (Write-Ahead Log, журнал предзаписи) | UPDATE 1 строки, 1072 bytes WAL |
| Медиана выполнения запроса | 302.3 мс | 389.1 мс |
| Медиана планирования | 0.476 мс | 1.156 мс |
| Удобство для BI | измерение одной таблицей, иерархия видна сразу | иерархию собирает модель или представление |
| Иерархии | плоские столбцы в одной строке | цепочки таблиц, подиерархию можно переиспользовать |
Таким образом, снежинка выигрывает в цене обновления справочника, а звезда в простоте запросов и скорости.
Медленно меняющиеся измерения и другие подводные камни
Атрибуты измерений меняются, а факты ссылаются на них годами. Клиент переезжает, товар переводят в другую категорию. Судьбу старых продаж решает тип медленно меняющегося измерения SCD (Slowly Changing Dimension). Kimball Group перечисляет типы с 0 по 7, а руководство Microsoft разбирает два основных:
- SCD Type 1. Значение перезаписывается, история теряется, и прошлые продажи клиента начинают числиться за его новым регионом.
- SCD Type 2. На каждое изменение добавляется новая строка измерения со своим суррогатным ключом и датами действия StartDate и EndDate. Факт ссылается на версию, действовавшую на его дату, поэтому бизнес-ключ перестаёт быть уникальным и без суррогатного ключа не обойтись.
Быстро меняющиеся атрибуты Microsoft советует вовсе не держать в измерении, а хранить мерой в факте.
Кроме SCD, у звезды есть несколько типовых конструкций, на которых спотыкаются при первом проектировании:
- Role-playing dimension. Одно измерение даты играет несколько ролей, например дату заказа и дату отгрузки, а роль задаёт столбец факта, по которому идёт соединение.
- Junk dimension. Мелкие флаги и признаки собираются в одно измерение, обычно как декартово произведение значений с суррогатным ключом.
- Degenerate dimension. Атрибут вроде номера заказа лежит прямо в факте, потому что отдельное измерение из одного атрибута бессмысленно.
- Factless fact table. Таблица фактов без мер, с одними ключами. Она фиксирует само событие или служит мостом для связи многие-ко-многим.
Все четыре конструкции описаны в руководстве Microsoft по звезде для Power BI. Там же дана рекомендация сворачивать снежинку в одно денормализованное измерение, потому что выгоды одной таблицы модели, как правило, перевешивают выгоды нескольких.
Отдельная позиция отрасли касается колоночных движков вроде ClickHouse, BigQuery и Snowflake. По отраслевым блогам, денормализация там дешёвая, и для BI строят One Big Table (OBT), одну широкую таблицу с атрибутами измерений прямо в строке факта. Цена в том, что правка измерения означает перезапись всей таблицы. Сравнительных замеров OBT против звезды у вендоров не нашлось, так что выбор между ними на колоночном движке решает собственный замер на своих данных.
Построение DWH на ClickHouse
Код курса
CLICH
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Когда выбирать звезду, а когда снежинку
Выбор делается по признакам, которые можно проверить на собственной модели:
- Звезда по умолчанию. Она подходит для витрин и моделей BI, где важны простые запросы и предсказуемый план, а дублирование атрибутов в небольших измерениях почти ничего не стоит.
- Снежинка при частой смене иерархии. Если категории и регионы регулярно переименовывают, обновить одну строку справочника дешевле, чем тысячу строк измерения.
- Снежинка при общих подиерархиях. Справочник регионов, на который ссылаются несколько измерений, удобнее держать одной таблицей.
- Звезда поверх снежинки. Хранилище держит нормализованные справочники, а для BI собирается звезда из представлений или таблиц с развёрнутой иерархией.
На уровне всего хранилища тот же выбор известен как спор Bill Inmon (Билл Инмон), автора подхода с нормализованным корпоративным хранилищем, и Ralph Kimball с витринами по схеме звезды. Его разбор есть в материале Data Modeling and Design. От концепции к физической реализации в Big Data.
Практика, одна выборка на звезде и на снежинке в PostgreSQL 18
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Стенд это PostgreSQL 18.6 в Docker Compose, данные генерирует сам SQL через generate_series. Прогон шёл 2026-11-07 на Ubuntu 24.04 с 4 vCPU и занял 39 секунд.
Схемы и тестовые данные
Сервер описан файлом docker-compose.yml. Параметр shared_buffers поднят до 256 MB, чтобы обе таблицы фактов лежали в кэше и замеры не скакали от чтения с диска.
# postgres 18.6 в Docker, прогнано на стенде 2026-11-07: один сервер, две схемы (star и snowflake) на одних данных
services:
  pg:
    image: postgres:18.6
    container_name: star-schema-pg
    mem_limit: 1g
    # shared_buffers 256MB: обе таблицы фактов помещаются в кэш, замеры времени не скачут от чтения с диска
    # max_wal_size 256MB: загрузка 4 млн строк не раздувает WAL на диске до гигабайта
    command: ["postgres", "-c", "shared_buffers=256MB", "-c", "max_wal_size=256MB"]
    environment:
      POSTGRES_USER: demo
      POSTGRES_PASSWORD: demo
      POSTGRES_DB: dwh
    ports:
      - "127.0.0.1:55439:5432"
    volumes:
      - pgdata:/var/lib/postgresql
      # SQL-сценарии видны внутри контейнера в /demo/sql
      - ./sql:/demo/sql:ro
    healthcheck:
      # -h 127.0.0.1: на время initdb временный сервер слушает только сокет, по TCP готов уже рабочий
      test: ["CMD-SHELL", "pg_isready -h 127.0.0.1 -U demo -d dwh"]
      interval: 2s
      timeout: 3s
      retries: 30

volumes:
  pgdata:
Оркестратор star_schema_demo.sh прогоняет четыре SQL-сценария по очереди через psql внутри контейнера.
#!/usr/bin/env bash
# postgres 18.6 в Docker, прогнано на стенде 2026-11-07
# Все шаги по очереди: ./star_schema_demo.sh all
# или по одному: ./star_schema_demo.sh star|snowflake|queries|rename
set -uo pipefail
cd "$(dirname "$0")" || exit 1

# -e печатает каждый запрос перед результатом, 2>&1 внутри контейнера держит ошибки рядом с запросом
psql_file() {
  docker compose exec -T pg sh -c "psql -U demo -d dwh -X -e -v ON_ERROR_STOP=1 -f /demo/sql/$1 2>&1"
}

star()      { psql_file 01_star.sql; }
snowflake() { psql_file 02_snowflake.sql; }
queries()   { psql_file 03_queries.sql; }
rename()    { psql_file 04_rename.sql; }

case ${1:-all} in
  star|snowflake|queries|rename) "$1" ;;
  all)
    rc=0
    echo "=== 1. Star schema: факт и денормализованные измерения ==="; star      || rc=1
    echo; echo "=== 2. Snowflake schema на тех же данных ===";       snowflake || rc=1
    echo; echo "=== 3. Одна выборка на двух схемах ===";            queries   || rc=1
    echo; echo "=== 4. Цена переименования категории ===";         rename    || rc=1
    exit $rc ;;
  *) echo "использование: $0 all|star|snowflake|queries|rename" >&2; exit 2 ;;
esac
Весь прогон запускается из папки репозитория одной строкой, том с базой снимается в конце.
# PostgreSQL 18.6, Docker Compose 2.40.3, проверено на стенде 2026-11-07
docker compose up -d --wait && ./star_schema_demo.sh all && docker compose down -v
Звезду строит файл 01_star.sql. Значения идут от фиксированного setseed, поэтому повторный прогон на чистой базе даёт те же строки.
-- postgres 18.6, прогнано на стенде 2026-11-07
-- Star schema: таблица фактов продаж и четыре денормализованных измерения.
-- Гранулярность факта: одна строка на позицию чека (дата, товар, магазин, покупатель).
-- Данные воспроизводимы: random() идёт от фиксированного setseed.
\timing on
DROP SCHEMA IF EXISTS star CASCADE;
CREATE SCHEMA star;

-- Измерение даты: ключ в виде ГГГГММДД, атрибуты для фильтров и группировки
CREATE TABLE star.dim_date (
  date_key    int PRIMARY KEY,
  full_date   date NOT NULL,
  year        smallint NOT NULL,
  quarter     smallint NOT NULL,
  month       smallint NOT NULL,
  iso_dow     smallint NOT NULL
);
INSERT INTO star.dim_date
SELECT to_char(d, 'YYYYMMDD')::int, d, extract(year FROM d), extract(quarter FROM d),
       extract(month FROM d), extract(isodow FROM d)
FROM generate_series(date '2024-01-01', date '2025-12-31', interval '1 day') AS g(ts),
     LATERAL (SELECT ts::date AS d) x;

-- Измерение товара: иерархия товар -> подкатегория -> категория лежит в одной строке
CREATE TABLE star.dim_product (
  product_key      int PRIMARY KEY,         -- суррогатный ключ хранилища
  product_code     text NOT NULL UNIQUE,    -- естественный ключ из учётной системы
  product_name     text NOT NULL,
  subcategory_name text NOT NULL,
  category_name    text NOT NULL
);
INSERT INTO star.dim_product
SELECT n,
       format('SKU-%s', lpad(n::text, 5, '0')),
       format('Товар %s', n),
       format('%s: группа %s', cat[1 + (n - 1) % 12], 1 + ((n - 1) / 12) % 10),
       cat[1 + (n - 1) % 12]
FROM generate_series(1, 12000) AS n,
     (SELECT ARRAY['Электроника','Бытовая техника','Одежда','Обувь','Книги','Игрушки',
                   'Спорт','Дом и сад','Красота','Продукты','Автотовары','Зоотовары'] AS cat) c;

-- Измерение магазина: иерархия магазин -> город -> регион тоже в одной строке
CREATE TABLE star.dim_store (
  store_key   int PRIMARY KEY,
  store_name  text NOT NULL,
  city_name   text NOT NULL,
  region_name text NOT NULL
);
INSERT INTO star.dim_store
SELECT n,
       format('Магазин %s', n),
       format('Город %s', lpad((1 + (n - 1) % 40)::text, 2, '0')),
       reg[1 + ((n - 1) % 40) % 8]
FROM generate_series(1, 400) AS n,
     (SELECT ARRAY['Центральный','Северо-Западный','Южный','Северо-Кавказский',
                   'Приволжский','Уральский','Сибирский','Дальневосточный'] AS reg) r;

-- Измерение покупателя: в выборке не участвует, нужно для опыта с удалением JOIN
CREATE TABLE star.dim_customer (
  customer_key  int PRIMARY KEY,
  customer_name text NOT NULL,
  segment       text NOT NULL
);
INSERT INTO star.dim_customer
SELECT n, format('Покупатель %s', n), (ARRAY['розница','опт','корпоративный'])[1 + n % 3]
FROM generate_series(1, 100000) AS n;

-- Таблица фактов: только ключи измерений и аддитивные меры
CREATE TABLE star.fact_sales (
  date_key     int NOT NULL,
  product_key  int NOT NULL,
  store_key    int NOT NULL,
  customer_key int NOT NULL,
  quantity     smallint NOT NULL,
  amount       numeric(10,2) NOT NULL
);
-- setseed делает random() воспроизводимым: при каждом прогоне на чистой базе выходят те же 2 млн строк
SELECT setseed(0.42);
INSERT INTO star.fact_sales
SELECT to_char(date '2024-01-01' + random(0, 730), 'YYYYMMDD')::int,
       random(1, 12000),
       random(1, 400),
       random(1, 100000),
       random(1, 5),
       random(500, 99999) / 100.0
FROM generate_series(1, 2000000);

-- Внешние ключи ставятся после загрузки: одна проверка всей таблицы вместо четырёх поисков на каждую строку
ALTER TABLE star.fact_sales
  ADD FOREIGN KEY (date_key)     REFERENCES star.dim_date,
  ADD FOREIGN KEY (product_key)  REFERENCES star.dim_product,
  ADD FOREIGN KEY (store_key)    REFERENCES star.dim_store,
  ADD FOREIGN KEY (customer_key) REFERENCES star.dim_customer;

VACUUM (ANALYZE) star.dim_date, star.dim_product, star.dim_store, star.dim_customer, star.fact_sales;
\timing off

SELECT 'star.fact_sales' AS "таблица", count(*) AS "строк" FROM star.fact_sales
UNION ALL SELECT 'star.dim_product', count(*) FROM star.dim_product
UNION ALL SELECT 'star.dim_store', count(*) FROM star.dim_store;
Загрузка факта и внешние ключи после неё заняли около 10 секунд.
# вывод прогона на стенде 2026-11-07, PostgreSQL 18.6, фрагмент run_output.txt
INSERT 0 2000000
Time: 6042.830 ms (00:06.043)
ALTER TABLE star.fact_sales
  ADD FOREIGN KEY (date_key)     REFERENCES star.dim_date,
  ADD FOREIGN KEY (product_key)  REFERENCES star.dim_product,
  ADD FOREIGN KEY (store_key)    REFERENCES star.dim_store,
  ADD FOREIGN KEY (customer_key) REFERENCES star.dim_customer;
ALTER TABLE
Time: 3551.209 ms (00:03.551)
Снежинка в 02_snowflake.sql собирается из звезды, поэтому факты и атрибуты совпадают строка в строку. Нормализованы только товар и магазин.
-- postgres 18.6, прогнано на стенде 2026-11-07
-- Snowflake schema на тех же данных: измерения товара и магазина нормализованы в цепочки
-- товар -> подкатегория -> категория и магазин -> город -> регион.
-- Схема строится из star, поэтому факты и значения атрибутов совпадают строка в строку.
\timing on
DROP SCHEMA IF EXISTS snowflake CASCADE;
CREATE SCHEMA snowflake;

-- Цепочка товара: каждое название категории и подкатегории хранится один раз
CREATE TABLE snowflake.dim_category (
  category_key  int GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  category_name text NOT NULL UNIQUE
);
INSERT INTO snowflake.dim_category (category_name)
SELECT DISTINCT category_name FROM star.dim_product ORDER BY 1;

CREATE TABLE snowflake.dim_subcategory (
  subcategory_key  int GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  subcategory_name text NOT NULL UNIQUE,
  category_key     int NOT NULL REFERENCES snowflake.dim_category
);
INSERT INTO snowflake.dim_subcategory (subcategory_name, category_key)
SELECT DISTINCT p.subcategory_name, c.category_key
FROM star.dim_product p JOIN snowflake.dim_category c USING (category_name)
ORDER BY 1;

CREATE TABLE snowflake.dim_product (
  product_key     int PRIMARY KEY,
  product_code    text NOT NULL UNIQUE,
  product_name    text NOT NULL,
  subcategory_key int NOT NULL REFERENCES snowflake.dim_subcategory
);
INSERT INTO snowflake.dim_product
SELECT p.product_key, p.product_code, p.product_name, s.subcategory_key
FROM star.dim_product p JOIN snowflake.dim_subcategory s USING (subcategory_name);

-- Цепочка магазина
CREATE TABLE snowflake.dim_region (
  region_key  int GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  region_name text NOT NULL UNIQUE
);
INSERT INTO snowflake.dim_region (region_name)
SELECT DISTINCT region_name FROM star.dim_store ORDER BY 1;

CREATE TABLE snowflake.dim_city (
  city_key   int GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  city_name  text NOT NULL UNIQUE,
  region_key int NOT NULL REFERENCES snowflake.dim_region
);
INSERT INTO snowflake.dim_city (city_name, region_key)
SELECT DISTINCT s.city_name, r.region_key
FROM star.dim_store s JOIN snowflake.dim_region r USING (region_name)
ORDER BY 1;

CREATE TABLE snowflake.dim_store (
  store_key  int PRIMARY KEY,
  store_name text NOT NULL,
  city_key   int NOT NULL REFERENCES snowflake.dim_city
);
INSERT INTO snowflake.dim_store
SELECT s.store_key, s.store_name, c.city_key
FROM star.dim_store s JOIN snowflake.dim_city c USING (city_name);

-- Дата и покупатель не нормализуются: в них нет иерархии, которую стоило бы выносить
CREATE TABLE snowflake.dim_date (LIKE star.dim_date INCLUDING ALL);
INSERT INTO snowflake.dim_date SELECT * FROM star.dim_date;
CREATE TABLE snowflake.dim_customer (LIKE star.dim_customer INCLUDING ALL);
INSERT INTO snowflake.dim_customer SELECT * FROM star.dim_customer;

-- Факт тот же самый: снежинка меняет только измерения
CREATE TABLE snowflake.fact_sales (
  date_key     int NOT NULL,
  product_key  int NOT NULL,
  store_key    int NOT NULL,
  customer_key int NOT NULL,
  quantity     smallint NOT NULL,
  amount       numeric(10,2) NOT NULL
);
INSERT INTO snowflake.fact_sales SELECT * FROM star.fact_sales;

-- Внешние ключи ставятся после загрузки: одна проверка всей таблицы вместо четырёх поисков на каждую строку
ALTER TABLE snowflake.fact_sales
  ADD FOREIGN KEY (date_key)     REFERENCES snowflake.dim_date,
  ADD FOREIGN KEY (product_key)  REFERENCES snowflake.dim_product,
  ADD FOREIGN KEY (store_key)    REFERENCES snowflake.dim_store,
  ADD FOREIGN KEY (customer_key) REFERENCES snowflake.dim_customer;

VACUUM (ANALYZE) snowflake.dim_category, snowflake.dim_subcategory, snowflake.dim_product,
  snowflake.dim_region, snowflake.dim_city, snowflake.dim_store,
  snowflake.dim_date, snowflake.dim_customer, snowflake.fact_sales;
\timing off

-- Сколько таблиц в каждой схеме, сколько строк и места занимает каждая (с индексами)
SELECT n.nspname AS "схема", c.relname AS "таблица",
       (xpath('/row/n/text()', query_to_xml(
          format('SELECT count(*) AS n FROM %I.%I', n.nspname, c.relname), false, true, '')))[1]::text::bigint AS "строк",
       pg_size_pretty(pg_total_relation_size(c.oid)) AS "размер"
FROM pg_class c JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE n.nspname IN ('star', 'snowflake') AND c.relkind = 'r'
ORDER BY 1 DESC, 2;

-- Итог по измерениям товара и магазина, то есть по тому, чем схемы отличаются
SELECT n.nspname AS "схема", count(*) AS "таблиц",
       pg_size_pretty(sum(pg_total_relation_size(c.oid))) AS "размер вместе с индексами"
FROM pg_class c JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE n.nspname IN ('star', 'snowflake') AND c.relkind = 'r'
  AND c.relname IN ('dim_product','dim_subcategory','dim_category','dim_store','dim_city','dim_region')
GROUP BY 1 ORDER BY 1 DESC;
Последние два запроса сценария показывают размеры таблиц.
# вывод прогона на стенде 2026-11-07, PostgreSQL 18.6, фрагмент run_output.txt
   схема   |     таблица     |  строк  | размер
-----------+-----------------+---------+---------
 star      | dim_customer    |  100000 | 9976 kB
 star      | dim_date        |     731 | 96 kB
 star      | dim_product     |   12000 | 2024 kB
 star      | dim_store       |     400 | 96 kB
 star      | fact_sales      | 2000000 | 115 MB
 snowflake | dim_category    |      12 | 80 kB
 snowflake | dim_city        |      40 | 80 kB
 snowflake | dim_customer    |  100000 | 9976 kB
 snowflake | dim_date        |     731 | 96 kB
 snowflake | dim_product     |   12000 | 1504 kB
 snowflake | dim_region      |       8 | 80 kB
 snowflake | dim_store       |     400 | 80 kB
 snowflake | dim_subcategory |     120 | 88 kB
 snowflake | fact_sales      | 2000000 | 115 MB
(14 rows)
   схема   | таблиц | размер вместе с индексами
-----------+--------+---------------------------
 star      |      2 | 2120 kB
 snowflake |      6 | 1912 kB
(2 rows)
Факт весит 115 MB в обеих схемах, а нормализация сэкономила 208 kB. Вес хранилища определяет таблица фактов, а не измерения.
Планы запросов и время выполнения
В 03_queries.sql выборка «выручка по категории и региону за II квартал 2025» записана для звезды, для снежинки и для снежинки с датой последней в тексте. Функции считают md5 результата и медианы EXPLAIN ANALYZE по пяти прогонам после прогрева.
-- postgres 18.6, прогнано на стенде 2026-11-07
-- Одна бизнес-выборка «выручка по категории и региону за II квартал 2025» на звезде и на снежинке.
-- Сравниваем результат, план (число JOIN), время выполнения и время планирования.

-- Тексты запросов лежат в таблице, чтобы планы и замеры шли ровно по тому же SQL
CREATE TEMP TABLE demo_queries (name text PRIMARY KEY, sql text NOT NULL);
INSERT INTO demo_queries VALUES
('star', $q$
SELECT p.category_name, s.region_name, sum(f.amount) AS revenue, sum(f.quantity) AS units
FROM star.fact_sales f
JOIN star.dim_date    d ON d.date_key    = f.date_key
JOIN star.dim_product p ON p.product_key = f.product_key
JOIN star.dim_store   s ON s.store_key   = f.store_key
WHERE d.year = 2025 AND d.quarter = 2
GROUP BY p.category_name, s.region_name
$q$),
('snowflake', $q$
SELECT cat.category_name, r.region_name, sum(f.amount) AS revenue, sum(f.quantity) AS units
FROM snowflake.fact_sales f
JOIN snowflake.dim_date        d   ON d.date_key         = f.date_key
JOIN snowflake.dim_product     p   ON p.product_key      = f.product_key
JOIN snowflake.dim_subcategory sc  ON sc.subcategory_key = p.subcategory_key
JOIN snowflake.dim_category    cat ON cat.category_key   = sc.category_key
JOIN snowflake.dim_store       s   ON s.store_key        = f.store_key
JOIN snowflake.dim_city        ci  ON ci.city_key        = s.city_key
JOIN snowflake.dim_region      r   ON r.region_key       = ci.region_key
WHERE d.year = 2025 AND d.quarter = 2
GROUP BY cat.category_name, r.region_name
$q$),
-- тот же запрос снежинки, но измерение даты с фильтром стоит в тексте последним
('snowflake_date_last', $q$
SELECT cat.category_name, r.region_name, sum(f.amount) AS revenue, sum(f.quantity) AS units
FROM snowflake.fact_sales f
JOIN snowflake.dim_product     p   ON p.product_key      = f.product_key
JOIN snowflake.dim_subcategory sc  ON sc.subcategory_key = p.subcategory_key
JOIN snowflake.dim_category    cat ON cat.category_key   = sc.category_key
JOIN snowflake.dim_store       s   ON s.store_key        = f.store_key
JOIN snowflake.dim_city        ci  ON ci.city_key        = s.city_key
JOIN snowflake.dim_region      r   ON r.region_key       = ci.region_key
JOIN snowflake.dim_date        d   ON d.date_key         = f.date_key
WHERE d.year = 2025 AND d.quarter = 2
GROUP BY cat.category_name, r.region_name
$q$);

-- Отпечаток результата: все строки, отсортированные как текст, в один md5
CREATE FUNCTION pg_temp.result_md5(q text) RETURNS TABLE (rows bigint, total_revenue numeric, md5 text)
LANGUAGE plpgsql AS $f$
BEGIN
  RETURN QUERY EXECUTE format(
    'SELECT count(*), sum(revenue), md5(string_agg(t::text, %L ORDER BY t::text)) FROM (%s) t', '|', q);
END $f$;

-- Замер: прогрев, затем N прогонов EXPLAIN ANALYZE; медианы времени и разбор узлов последнего плана
CREATE FUNCTION pg_temp.plan_stats(q text, runs int DEFAULT 5)
RETURNS TABLE (tables int, join_nodes int, planning_ms numeric, execution_ms numeric,
               min_ms numeric, max_ms numeric, shared_hit bigint, shared_read bigint)
LANGUAGE plpgsql AS $f$
DECLARE
  p json;
  pt numeric[] := '{}';
  et numeric[] := '{}';
BEGIN
  EXECUTE 'EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON) ' || q INTO p;
  FOR i IN 1..runs LOOP
    EXECUTE 'EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON) ' || q INTO p;
    pt := pt || (p->0->>'Planning Time')::numeric;
    et := et || (p->0->>'Execution Time')::numeric;
  END LOOP;
  RETURN QUERY
  WITH RECURSIVE nodes(n) AS (
    SELECT p->0->'Plan'
    UNION ALL
    SELECT c FROM nodes, json_array_elements(nodes.n->'Plans') AS c
  )
  SELECT (SELECT count(DISTINCT n->>'Relation Name') FROM nodes)::int,
         (SELECT count(*) FROM nodes WHERE n->>'Node Type' IN ('Hash Join', 'Merge Join', 'Nested Loop'))::int,
         (SELECT round(percentile_cont(0.5) WITHIN GROUP (ORDER BY x)::numeric, 3) FROM unnest(pt) x),
         (SELECT round(percentile_cont(0.5) WITHIN GROUP (ORDER BY x)::numeric, 1) FROM unnest(et) x),
         (SELECT round(min(x), 1) FROM unnest(et) x),
         (SELECT round(max(x), 1) FROM unnest(et) x),
         (p->0->'Plan'->>'Shared Hit Blocks')::bigint,
         (p->0->'Plan'->>'Shared Read Blocks')::bigint;
END $f$;

\echo '--- Пределы планировщика, в пределах которых он переставляет JOIN'
SELECT name, setting FROM pg_settings
WHERE name IN ('join_collapse_limit', 'from_collapse_limit', 'geqo_threshold', 'geqo',
               'max_parallel_workers_per_gather', 'shared_buffers')
ORDER BY name;

\echo '--- Пять верхних строк результата на звезде'
SELECT format('SELECT * FROM (%s) t ORDER BY revenue DESC LIMIT 5', sql) FROM demo_queries WHERE name = 'star' \gexec

\echo '--- Результаты двух схем совпадают? (строк, сумма выручки, md5 всех строк)'
SELECT q.name AS "запрос", r.* FROM demo_queries q, pg_temp.result_md5(q.sql) r ORDER BY q.name DESC;

\echo '--- План на звезде'
SELECT 'EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) ' || sql FROM demo_queries WHERE name = 'star' \gexec

\echo '--- План на снежинке'
SELECT 'EXPLAIN (ANALYZE, BUFFERS, COSTS OFF) ' || sql FROM demo_queries WHERE name = 'snowflake' \gexec

\echo '--- Замер: таблиц в плане, узлов JOIN, медианы планирования и выполнения по 5 прогонам'
SELECT q.name AS "схема", s.* FROM demo_queries q, pg_temp.plan_stats(q.sql) s
WHERE q.name IN ('star', 'snowflake') ORDER BY q.name DESC;

\echo '--- Дата последней в тексте, join_collapse_limit = 8: планировщик сам ставит фильтр по дате первым'
SELECT 'EXPLAIN (COSTS OFF) ' || sql FROM demo_queries WHERE name = 'snowflake_date_last' \gexec

\echo '--- То же при join_collapse_limit = 1: JOIN идут ровно в порядке текста запроса'
SET join_collapse_limit = 1;
SELECT 'EXPLAIN (COSTS OFF) ' || sql FROM demo_queries WHERE name = 'snowflake_date_last' \gexec
RESET join_collapse_limit;

\echo '--- Замер обоих вариантов, по 5 прогонов'
SELECT 'join_collapse_limit = 8' AS "вариант", s.* FROM demo_queries q, pg_temp.plan_stats(q.sql) s
WHERE q.name = 'snowflake_date_last';
SET join_collapse_limit = 1;
SELECT 'join_collapse_limit = 1' AS "вариант", s.* FROM demo_queries q, pg_temp.plan_stats(q.sql) s
WHERE q.name = 'snowflake_date_last';
RESET join_collapse_limit;

\echo '--- Удаление лишнего JOIN: LEFT JOIN к измерению без его колонок в запросе'
EXPLAIN (COSTS OFF)
SELECT sum(f.amount) FROM star.fact_sales f
LEFT JOIN star.dim_customer c ON c.customer_key = f.customer_key;

\echo '--- То же через INNER JOIN: внешний ключ есть, но JOIN остаётся'
EXPLAIN (COSTS OFF)
SELECT sum(f.amount) FROM star.fact_sales f
JOIN star.dim_customer c ON c.customer_key = f.customer_key;
Сначала пределы планировщика и проверка, что модели отвечают одинаково.
# вывод прогона на стенде 2026-11-07, PostgreSQL 18.6, фрагмент run_output.txt
--- Пределы планировщика, в пределах которых он переставляет JOIN
SELECT name, setting FROM pg_settings
WHERE name IN ('join_collapse_limit', 'from_collapse_limit', 'geqo_threshold', 'geqo',
               'max_parallel_workers_per_gather', 'shared_buffers')
ORDER BY name;
              name               | setting
---------------------------------+---------
 from_collapse_limit             | 8
 geqo                            | on
 geqo_threshold                  | 12
 join_collapse_limit             | 8
 max_parallel_workers_per_gather | 2
 shared_buffers                  | 32768
(6 rows)
--- Пять верхних строк результата на звезде
  category_name  |    region_name    |  revenue   | units
-----------------+-------------------+------------+-------
 Игрушки         | Северо-Западный   | 1389857.24 |  8208
 Спорт           | Северо-Кавказский | 1379861.88 |  8198
 Книги           | Южный             | 1370338.02 |  8075
 Продукты        | Дальневосточный   | 1360402.65 |  7805
 Бытовая техника | Дальневосточный   | 1358912.21 |  7971
(5 rows)
--- Результаты двух схем совпадают? (строк, сумма выручки, md5 всех строк)
SELECT q.name AS "запрос", r.* FROM demo_queries q, pg_temp.result_md5(q.sql) r ORDER BY q.name DESC;
       запрос        | rows | total_revenue |               md5
---------------------+------+---------------+----------------------------------
 star                |   96 |  125438593.05 | 6c49277e535078937bf25f37376c36d5
 snowflake_date_last |   96 |  125438593.05 | 6c49277e535078937bf25f37376c36d5
 snowflake           |   96 |  125438593.05 | 6c49277e535078937bf25f37376c36d5
(3 rows)
Все три варианта вернули 96 строк с одной суммой 125438593.05 и одинаковым md5. План звезды под EXPLAIN (ANALYZE, BUFFERS) выглядит так.
# вывод прогона на стенде 2026-11-07, PostgreSQL 18.6, фрагмент run_output.txt
--- План на звезде
                                                           QUERY PLAN
--------------------------------------------------------------------------------------------------------------------------------
 Finalize GroupAggregate (actual time=305.830..313.398 rows=96.00 loops=1)
   Group Key: p.category_name, s.region_name
   Buffers: shared hit=15244
   ->  Gather Merge (actual time=305.810..313.162 rows=288.00 loops=1)
         Workers Planned: 2
         Workers Launched: 2
         Buffers: shared hit=15244
         ->  Sort (actual time=301.207..301.220 rows=96.00 loops=3)
               Sort Key: p.category_name, s.region_name
               Sort Method: quicksort  Memory: 37kB
               Buffers: shared hit=15244
               Worker 0:  Sort Method: quicksort  Memory: 37kB
               Worker 1:  Sort Method: quicksort  Memory: 37kB
               ->  Partial HashAggregate (actual time=300.959..301.012 rows=96.00 loops=3)
                     Group Key: p.category_name, s.region_name
                     Batches: 1  Memory Usage: 64kB
                     Buffers: shared hit=15228
                     Worker 0:  Batches: 1  Memory Usage: 64kB
                     Worker 1:  Batches: 1  Memory Usage: 64kB
                     ->  Hash Join (actual time=6.231..253.984 rows=83192.00 loops=3)
                           Hash Cond: (f.store_key = s.store_key)
                           Buffers: shared hit=15228
                           ->  Hash Join (actual time=6.015..229.370 rows=83192.00 loops=3)
                                 Hash Cond: (f.product_key = p.product_key)
                                 Buffers: shared hit=15213
                                 ->  Hash Join (actual time=0.134..177.140 rows=83192.00 loops=3)
                                       Hash Cond: (f.date_key = d.date_key)
                                       Buffers: shared hit=14718
                                       ->  Parallel Seq Scan on fact_sales f (actual time=0.010..66.771 rows=666666.67 loops=3)
                                             Buffers: shared hit=14706
                                       ->  Hash (actual time=0.102..0.103 rows=91.00 loops=3)
                                             Buckets: 1024  Batches: 1  Memory Usage: 12kB
                                             Buffers: shared hit=12
                                             ->  Seq Scan on dim_date d (actual time=0.054..0.084 rows=91.00 loops=3)
                                                   Filter: ((year = 2025) AND (quarter = 2))
                                                   Rows Removed by Filter: 640
                                                   Buffers: shared hit=12
                                 ->  Hash (actual time=5.783..5.784 rows=12000.00 loops=3)
                                       Buckets: 16384  Batches: 1  Memory Usage: 769kB
                                       Buffers: shared hit=495
                                       ->  Seq Scan on dim_product p (actual time=0.011..2.544 rows=12000.00 loops=3)
                                             Buffers: shared hit=495
                           ->  Hash (actual time=0.195..0.196 rows=400.00 loops=3)
                                 Buckets: 1024  Batches: 1  Memory Usage: 32kB
                                 Buffers: shared hit=15
                                 ->  Seq Scan on dim_store s (actual time=0.024..0.091 rows=400.00 loops=3)
                                       Buffers: shared hit=15
 Planning:
   Buffers: shared hit=16
 Planning Time: 0.390 ms
 Execution Time: 313.539 ms
(51 rows)
Дата соединяется первой и отсекает квартал, дальше через каждый Hash Join проходит в среднем по 83192 строки на каждый из трёх процессов. У снежинки таких соединений семь. Сводка по пяти прогонам.
# вывод прогона на стенде 2026-11-07, PostgreSQL 18.6, фрагмент run_output.txt
--- Замер: таблиц в плане, узлов JOIN, медианы планирования и выполнения по 5 прогонам
   схема   | tables | join_nodes | planning_ms | execution_ms | min_ms | max_ms | shared_hit | shared_read
-----------+--------+------------+-------------+--------------+--------+--------+------------+-------------
 star      |      4 |          3 |       0.476 |        302.3 |  288.0 |  352.3 |      15244 |           0
 snowflake |      8 |          7 |       1.156 |        389.1 |  378.0 |  427.8 |      15058 |           0
(2 rows)
Снежинка на 29% дольше по выполнению и в 2.4 раза дольше по планированию. Разница не «в разы», потому что хеш-таблицы справочников занимают от 9 до 24 kB, и каждое лишнее соединение стоит одного прохода почти 250 тысяч строк через хеш.
Дальше опыт с порядком соединений. В варианте snowflake_date_last измерение даты с фильтром стоит в тексте последним, и при стандартном пределе 8 планировщик сам переставляет его первым.
# вывод прогона на стенде 2026-11-07, PostgreSQL 18.6, фрагмент run_output.txt
--- Дата последней в тексте, join_collapse_limit = 8: планировщик сам ставит фильтр по дате первым
                                                     QUERY PLAN
---------------------------------------------------------------------------------------------------------------------
 Finalize GroupAggregate
   Group Key: cat.category_name, r.region_name
   ->  Gather Merge
         Workers Planned: 2
         ->  Sort
               Sort Key: cat.category_name, r.region_name
               ->  Partial HashAggregate
                     Group Key: cat.category_name, r.region_name
                     ->  Hash Join
                           Hash Cond: (ci.region_key = r.region_key)
                           ->  Hash Join
                                 Hash Cond: (s.city_key = ci.city_key)
                                 ->  Hash Join
                                       Hash Cond: (f.store_key = s.store_key)
                                       ->  Hash Join
                                             Hash Cond: (sc.category_key = cat.category_key)
                                             ->  Hash Join
                                                   Hash Cond: (p.subcategory_key = sc.subcategory_key)
                                                   ->  Hash Join
                                                         Hash Cond: (f.product_key = p.product_key)
                                                         ->  Hash Join
                                                               Hash Cond: (f.date_key = d.date_key)
                                                               ->  Parallel Seq Scan on fact_sales f
                                                               ->  Hash
                                                                     ->  Seq Scan on dim_date d
                                                                           Filter: ((year = 2025) AND (quarter = 2))
                                                         ->  Hash
                                                               ->  Seq Scan on dim_product p
                                                   ->  Hash
                                                         ->  Seq Scan on dim_subcategory sc
                                             ->  Hash
                                                   ->  Seq Scan on dim_category cat
                                       ->  Hash
                                             ->  Seq Scan on dim_store s
                                 ->  Hash
                                       ->  Seq Scan on dim_city ci
                           ->  Hash
                                 ->  Seq Scan on dim_region r
(38 rows)
С join_collapse_limit = 1 перестановка запрещена, соединения идут ровно в порядке текста, и весь факт проходит шесть Hash Join до фильтра по дате.
# вывод прогона на стенде 2026-11-07, PostgreSQL 18.6, фрагмент run_output.txt
--- То же при join_collapse_limit = 1: JOIN идут ровно в порядке текста запроса
                                                 QUERY PLAN
-------------------------------------------------------------------------------------------------------------
 Finalize GroupAggregate
   Group Key: cat.category_name, r.region_name
   ->  Gather Merge
         Workers Planned: 2
         ->  Sort
               Sort Key: cat.category_name, r.region_name
               ->  Partial HashAggregate
                     Group Key: cat.category_name, r.region_name
                     ->  Hash Join
                           Hash Cond: (f.date_key = d.date_key)
                           ->  Hash Join
                                 Hash Cond: (ci.region_key = r.region_key)
                                 ->  Hash Join
                                       Hash Cond: (s.city_key = ci.city_key)
                                       ->  Hash Join
                                             Hash Cond: (f.store_key = s.store_key)
                                             ->  Hash Join
                                                   Hash Cond: (sc.category_key = cat.category_key)
                                                   ->  Hash Join
                                                         Hash Cond: (p.subcategory_key = sc.subcategory_key)
                                                         ->  Hash Join
                                                               Hash Cond: (f.product_key = p.product_key)
                                                               ->  Parallel Seq Scan on fact_sales f
                                                               ->  Hash
                                                                     ->  Seq Scan on dim_product p
                                                         ->  Hash
                                                               ->  Seq Scan on dim_subcategory sc
                                                   ->  Hash
                                                         ->  Seq Scan on dim_category cat
                                             ->  Hash
                                                   ->  Seq Scan on dim_store s
                                       ->  Hash
                                             ->  Seq Scan on dim_city ci
                                 ->  Hash
                                       ->  Seq Scan on dim_region r
                           ->  Hash
                                 ->  Seq Scan on dim_date d
                                       Filter: ((year = 2025) AND (quarter = 2))
(38 rows)
--- Замер обоих вариантов, по 5 прогонов
         вариант         | tables | join_nodes | planning_ms | execution_ms | min_ms | max_ms | shared_hit | shared_read
-------------------------+--------+------------+-------------+--------------+--------+--------+------------+-------------
 join_collapse_limit = 8 |      8 |          7 |       1.151 |        424.6 |  404.0 |  442.6 |      15058 |           0
(1 row)
         вариант         | tables | join_nodes | planning_ms | execution_ms | min_ms | max_ms | shared_hit | shared_read
-------------------------+--------+------------+-------------+--------------+--------+--------+------------+-------------
 join_collapse_limit = 1 |      8 |          7 |       0.561 |       1572.4 | 1533.3 | 1803.8 |      15058 |           0
(1 row)
Выполнение выросло с 424.6 до 1572.4 мс, в 3.7 раза. Снежинка на восемь таблиц стоит ровно на пределе, и с девятой таблицей текст запроса снова начнёт ограничивать порядок соединений, поэтому такие запросы стоит проверять по EXPLAIN.
Последний опыт касается лишних соединений. LEFT JOIN к измерению покупателя по первичному ключу, из которого запрос не берёт ни одного столбца, PostgreSQL 18.6 выбросил из плана. INNER JOIN остался, хотя внешний ключ гарантирует наличие пары.
# вывод прогона на стенде 2026-11-07, PostgreSQL 18.6, фрагмент run_output.txt
--- Удаление лишнего JOIN: LEFT JOIN к измерению без его колонок в запросе
EXPLAIN (COSTS OFF)
SELECT sum(f.amount) FROM star.fact_sales f
LEFT JOIN star.dim_customer c ON c.customer_key = f.customer_key;
                     QUERY PLAN
-----------------------------------------------------
 Finalize Aggregate
   ->  Gather
         Workers Planned: 2
         ->  Partial Aggregate
               ->  Parallel Seq Scan on fact_sales f
(5 rows)
--- То же через INNER JOIN: внешний ключ есть, но JOIN остаётся
EXPLAIN (COSTS OFF)
SELECT sum(f.amount) FROM star.fact_sales f
JOIN star.dim_customer c ON c.customer_key = f.customer_key;
                                            QUERY PLAN
--------------------------------------------------------------------------------------------------
 Finalize Aggregate
   ->  Gather
         Workers Planned: 2
         ->  Partial Aggregate
               ->  Parallel Hash Join
                     Hash Cond: (f.customer_key = c.customer_key)
                     ->  Parallel Seq Scan on fact_sales f
                     ->  Parallel Hash
                           ->  Parallel Index Only Scan using dim_customer_pkey on dim_customer c
(9 rows)
Поэтому представление для BI с LEFT JOIN ко всем измерениям не платит за те, столбцы которых отчёт не трогает, а с INNER JOIN платит за все.
Цена переименования атрибута
Категорию «Электроника» переименовали в «Электроника и гаджеты» в обеих схемах сценарием 04_rename.sql. Объём записи в WAL считается по разнице позиций журнала до и после UPDATE.
-- postgres 18.6, прогнано на стенде 2026-11-07
-- Цена смены атрибута: категорию «Электроника» переименовали в «Электроника и гаджеты».
-- В звезде название повторяется в каждой строке товара, в снежинке хранится один раз.

\echo '--- Звезда: UPDATE по всем товарам категории'
SELECT pg_current_wal_lsn() AS lsn0 \gset
UPDATE star.dim_product SET category_name = 'Электроника и гаджеты' WHERE category_name = 'Электроника';
SELECT pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), :'lsn0')) AS "WAL на звезде";

\echo '--- Снежинка: UPDATE одной строки справочника категорий'
SELECT pg_current_wal_lsn() AS lsn0 \gset
UPDATE snowflake.dim_category SET category_name = 'Электроника и гаджеты' WHERE category_name = 'Электроника';
SELECT pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), :'lsn0')) AS "WAL на снежинке";

\echo '--- Выручка новой категории за II квартал 2025 в обеих схемах'
SELECT 'star' AS "схема", sum(f.amount) AS revenue
FROM star.fact_sales f
JOIN star.dim_date d ON d.date_key = f.date_key
JOIN star.dim_product p ON p.product_key = f.product_key
WHERE d.year = 2025 AND d.quarter = 2 AND p.category_name = 'Электроника и гаджеты'
UNION ALL
SELECT 'snowflake', sum(f.amount)
FROM snowflake.fact_sales f
JOIN snowflake.dim_date d ON d.date_key = f.date_key
JOIN snowflake.dim_product p ON p.product_key = f.product_key
JOIN snowflake.dim_subcategory sc ON sc.subcategory_key = p.subcategory_key
JOIN snowflake.dim_category cat ON cat.category_key = sc.category_key
WHERE d.year = 2025 AND d.quarter = 2 AND cat.category_name = 'Электроника и гаджеты';
# вывод прогона на стенде 2026-11-07, PostgreSQL 18.6, фрагмент run_output.txt
=== 4. Цена переименования категории ===
--- Звезда: UPDATE по всем товарам категории
SELECT pg_current_wal_lsn() AS lsn0
UPDATE star.dim_product SET category_name = 'Электроника и гаджеты' WHERE category_name = 'Электроника';
UPDATE 1000
SELECT pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), '0/2B865D00')) AS "WAL на звезде";
 WAL на звезде
---------------
 2287 kB
(1 row)

--- Снежинка: UPDATE одной строки справочника категорий
SELECT pg_current_wal_lsn() AS lsn0
UPDATE snowflake.dim_category SET category_name = 'Электроника и гаджеты' WHERE category_name = 'Электроника';
UPDATE 1
SELECT pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), '0/2BAA1878')) AS "WAL на снежинке";
 WAL на снежинке
-----------------
 1072 bytes
(1 row)

--- Выручка новой категории за II квартал 2025 в обеих схемах
SELECT 'star' AS "схема", sum(f.amount) AS revenue
FROM star.fact_sales f
JOIN star.dim_date d ON d.date_key = f.date_key
JOIN star.dim_product p ON p.product_key = f.product_key
WHERE d.year = 2025 AND d.quarter = 2 AND p.category_name = 'Электроника и гаджеты'
UNION ALL
SELECT 'snowflake', sum(f.amount)
FROM snowflake.fact_sales f
JOIN snowflake.dim_date d ON d.date_key = f.date_key
JOIN snowflake.dim_product p ON p.product_key = f.product_key
JOIN snowflake.dim_subcategory sc ON sc.subcategory_key = p.subcategory_key
JOIN snowflake.dim_category cat ON cat.category_key = sc.category_key
WHERE d.year = 2025 AND d.quarter = 2 AND cat.category_name = 'Электроника и гаджеты';
   схема   |   revenue
-----------+-------------
 star      | 10357272.08
 snowflake | 10357272.08
(2 rows)
Звезда переписала 1000 строк и 2287 kB журнала, снежинка одну строку и 1072 bytes. У снежинки объём зависит от того, впервые ли страница меняется после контрольной точки, ведь тогда в журнал пишется образ всей страницы, и в одном из прогонов вышло 9984 bytes. Выручка новой категории в обеих схемах совпала.
Заключение
Star schema раскладывает данные на таблицу фактов с мерами на одной гранулярности и денормализованные измерения, поэтому любой запрос укладывается в один уровень JOIN. Snowflake schema нормализует измерения и платит лишними соединениями, зато атрибут меняется в одной строке. На PostgreSQL 18.6 это 29% по времени выполнения и 1000 обновлённых строк против одной при почти равном месте на диске. Звезда остаётся моделью по умолчанию для витрин и BI, а снежинка оправдана при часто меняющихся или общих иерархиях.