
 18
Содержание
- Что такое Sparse Mixture-of-Experts и какую задачу решает
- Архитектура и ключевые особенности
- Роутер и top-k gating
- Expert capacity и capacity factor
- Принцип работы
- Маршрутизация токена и auxiliary loss
- Top-1 routing в Switch Transformer против top-2 в GShard
- Эволюция балансировки нагрузки от auxiliary loss до loss-free
- Подводные камни collapse экспертов и token dropping
- Сценарии использования и отличительные черты
- Демо top-k router на PyTorch
- Заключение
- Референсные ссылки
Sparse Mixture-of-Experts, или sparse MoE, это архитектурный паттерн трансформера, в котором на каждый входной токен считается не весь слой, а лишь малая часть его весов. Общий обзор идеи Mixture of Experts уже есть на сайте отдельной статьёй, а здесь разбор идёт глубже, в конкретные архитектуры и механику sparse-роутинга, которые превратили общий принцип в рабочие модели на сотни миллиардов параметров, а именно GShard, Switch Transformer и DeepSpeed-MoE.
Что такое Sparse Mixture-of-Experts и какую задачу решает
Задача, которую решает sparse-активация, простая по формулировке и дорогая по факту. Плотный трансформер считает все параметры слоя на каждый токен, поэтому рост качества почти всегда означает пропорциональный рост стоимости обучения и инференса, а масштаб современных языковых моделей уже сам по себе создаёт инфраструктурную и экономическую проблему, разобранную в материале о том, что такое LLMOps или MLOps для больших языковых моделей. Sparse MoE отвечает на этот вызов иначе, чем плотное масштабирование. Слой становится большим по числу параметров, но каждый токен активирует только выбранное router’ом подмножество экспертов, поэтому общие параметры растут, а вычислительная стоимость на токен остаётся почти постоянной.
Архитектура и ключевые особенности
У всех рассмотренных архитектур один и тот же набор компонентов. Router, небольшая обучаемая сеть поверх скрытого состояния токена, выдаёт распределение вероятностей по N экспертам. Эксперты, обычно структурно идентичные обычному FFN-блоку трансформера, обрабатывают только назначенные им токены. Буфер ёмкости (capacity buffer) ограничивает число токенов на эксперта за батч, а в распределённых реализациях вроде DeepSpeed-MoE токены физически пересылаются между устройствами через all-to-all коммуникацию и собираются обратно после обработки. DeepSpeed-MoE поддерживает несколько схем совмещения expert parallelism с другими видами параллелизма, от простого expert-only разбиения до комбинаций с data, ZeRO (техника DeepSpeed, шардирующая состояние оптимизатора и градиенты между устройствами) и model parallelism.
Нейронные сети на Python
Код курса
PYNN
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Роутер и top-k gating
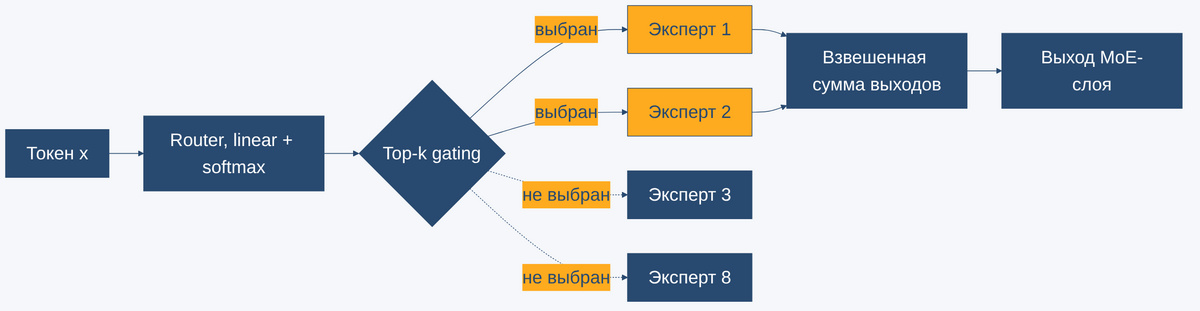
Router считает logits линейным слоем без смещения, применяет к ним softmax и получает вероятность каждого эксперта для конкретного токена. Дальше из этого распределения выбираются top-k экспертов с наибольшей вероятностью, а их веса ренормализуются так, чтобы снова суммироваться в единицу. Именно параметр k разделяет архитектуры. У Switch Transformer k равен единице, у GShard он равен двум. Выход MoE-слоя для токена это взвешенная сумма выходов выбранных экспертов, где веса и есть ренормализованные вероятности router’а.
Expert capacity и capacity factor
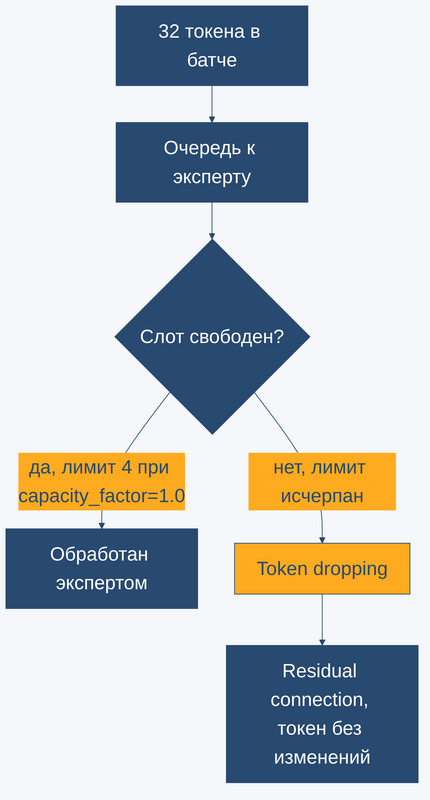
Каждый эксперт не может принять неограниченное число токенов за батч, иначе балансировка нагрузки теряет смысл. Ёмкость эксперта равна произведению capacity_factor на число токенов в батче, делённому на число экспертов, с округлением вверх. Токены, которые пришли к уже заполненному эксперту, эксперт не обрабатывает вообще, это и называется token dropping, а такой токен проходит дальше через residual-связь без изменений от MoE-подслоя. Авторы Switch Transformer отмечают, что модель показывает лучшие результаты при capacity factor от 1.0 до 1.25, то есть при почти минимальном запасе ёмкости, а не с большим буфером про запас.
Принцип работы
Полный проход токена через sparse MoE слой складывается из трёх шагов подряд. Router вычисляет вероятности по экспертам, top-k gating выбирает, кому из них токен достанется, а к основной функции потерь добавляется штраф за неравномерность распределения нагрузки, который не даёт router’у скатиться к использованию нескольких любимых экспертов.
Маршрутизация токена и auxiliary loss
Auxiliary loss в формулировке Switch Transformer выглядит как alpha, умноженное на N экспертов, умноженное на сумму произведений f-i на P-i по всем экспертам i. Здесь f-i это фактическая доля токенов батча, отправленных эксперту i, а P-i это средняя вероятность, которую router приписал этому же эксперту по всему батчу. Смысл конструкции в том, что штраф растёт, когда высокая уверенность router’а в эксперте совпадает с высокой фактической загрузкой этого эксперта, и штраф минимален, когда нагрузка распределена равномерно. Коэффициент alpha, по данным экспериментов авторов Switch Transformer, оптимален на уровне 10 в минус второй степени, этого достаточно, чтобы выровнять нагрузку и не помешать основной задаче обучения. У GShard в части источников встречается похожая, но не тождественная запись той же идеи без явного множителя N, и без сверки с оригинальным препринтом нельзя утверждать, что расхождение содержательное, а не следствие разных обозначений при пересказе.
Top-1 routing в Switch Transformer против top-2 в GShard
Разница между top-1 и top-2 не абстрактная, она прямо видна на счётчике активных параметров. В демо-слое на 8 экспертов с двухслойным FFN 64 на 128 на 64 top-1 роутинг Switch Transformer активирует 17 088 параметров на токен из 133 120 общих, это 12,8%. Top-2 роутинг GShard на том же слое активирует почти вдвое больше, 33 664 параметра из тех же 133 120, то есть 25,3%. Рост объясняется напрямую. При top-k равном двум на каждый токен считается вдвое больше экспертов при неизменном размере самого слоя, а не удваивается ровно вся активная часть, потому что сам router не входит в это удвоение.
| Параметр | Top-1 (Switch Transformer) | Top-2 (GShard) |
|---|---|---|
| Активные параметры на токен | 17 088 из 133 120 (12,8%) | 33 664 из 133 120 (25,3%) |
| Стоимость на токен | ниже | почти вдвое выше |
| Риск переполнения буфера | выше, нужна аккуратная настройка capacity factor | ниже за счёт второго кандидата-эксперта |
| Качество | базовое для sparse MoE | выше ценой стоимости |
Эволюция балансировки нагрузки от auxiliary loss до loss-free
Auxiliary loss решает проблему баланса, но добавляет к основной функции потерь собственный градиент, который в некоторых случаях мешает именно основной задаче обучения, а не только выравнивает нагрузку. По вторичным источникам, в архитектуре DeepSeek-V3 2025 года эта проблема решена иначе, через loss-free balancing, где вместо штрафного члена в функции потерь router корректируется динамическим bias-термом, который обновляется по ходу обучения без участия в градиенте основной задачи. Первоисточник DeepSeek-V3 в рамках этой статьи не проверялся, поэтому факт приводится с пометкой вторичного источника, а не как подтверждённая цитата из технического отчёта. Общая траектория архитектур укладывается в контекст более широкой эволюции подходов к построению LLM-инфраструктуры, которая разобрана в материале об эволюции ИИ-агентов и топологиях LLM-конвейеров.
Подводные камни collapse экспертов и token dropping
Без балансировки нагрузки router склонен направлять большинство токенов на малое число экспертов, а остальные параметры слоя фактически простаивают, это называется routing collapse. Эффект самоусиливающийся. Эксперт, получивший чуть больше градиента на старте обучения, чаще выбирается router’ом и обучается быстрее остальных, из-за чего разрыв между экспертами только растёт. Собственный эксперимент это подтверждает без всякой теории. На сбалансированном router’е со случайной инициализацией при capacity factor 1.0 дропается 8 токенов из 32, а на искусственно смещённом router’е с имитацией коллапса на один эксперт дропается уже 11 из 32, при этом auxiliary loss почти удваивается, с 0,010505 до 0,019086. Рост штрафа почти вдвое при явном перекосе нагрузки показывает, что формула реагирует именно на неравномерность, а не на общий уровень активности router’а.
К collapse добавляются менее очевидные грабли. Токены, стоящие ближе к концу батча, чаще отбрасываются, потому что к этому моменту буферы экспертов уже успевают заполниться токенами, пришедшими раньше. Паттерны маршрутизации, настроенные на распределение данных при обучении, не обязательно переносятся на инференс при сдвиге домена, а балансировка, достигнутая на этапе обучения, сама по себе не гарантирует равномерную загрузку экспертов уже после выкладки модели в прод.
Сценарии использования и отличительные черты
Sparse MoE подходит там, где нужно масштабировать число параметров модели без пропорционального роста стоимости прямого прохода на токен. Именно на этом принципе построены GShard с переводом на модели свыше 600 миллиардов параметров, Switch Transformer с обучением моделей до триллиона параметров и GLaM (Generalist Language Model, ещё одна top-2 MoE-архитектура Google) с качеством на уровне GPT-3 при заметно меньших энергозатратах на обучение. Обратная сторона в том, что архитектура требует инфраструктуры распределённого обучения, а не единичного GPU. DeepSpeed-MoE прямо описывает необходимость expert parallelism поверх обычного data или model parallelism, и вопросы такой эксплуатации разбираются на курсе «Архитектура ML-систем».
- Подходит. Масштабирование параметров модели при ограниченном бюджете на инференс, обучение очень крупных языковых моделей, сценарии с доступом к multi-GPU или multi-node кластеру.
- Требует осторожности. Сильный сдвиг домена между обучением и инференсом, сценарии, где важна предсказуемая задержка на батч, потому что token dropping вносит недетерминированность в то, какие токены будут обработаны полноценно.
Эксплуатация таких моделей в проде, мониторинг нагрузки на эксперты и выбор инфраструктуры под expert parallelism дальше разбираются на курсе по разработке и внедрению ML-решений.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Демо top-k router на PyTorch
Демо ниже не обучает MoE-слой, а показывает саму механику на игрушечном слое из 8 экспертов, каждый эксперт это обычный двухслойный FFN 64 на 128 на 64 со случайными весами. Веса фиксированы через torch.manual_seed(42), внешние модели и сервисы не задействованы, весь прогон идёт на CPU локальными тензорными операциями и занимает около 1,5 секунды на оба файла суммарно, из которых большая часть времени уходит на импорт torch.
# PyTorch 2.13.0, прогнано на стенде 2026-08-31
"""
Top-k роутер Sparse Mixture-of-Experts: линейный слой считает logits по числу
экспертов, softmax даёт вероятности, top-k выбирает k экспертов на токен и
ренормализует их веса. Демо сравнивает top-1 (Switch Transformer,
arXiv:2101.03961) и top-2 (GShard, arXiv:2006.16668) на одном и том же батче
токенов и считает долю активных параметров относительно общих — ключевую
метрику sparse-активации: слой большой, но на каждый токен считается только
малая его часть.
"""
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(42)

D_MODEL = 64
HIDDEN = 128
NUM_EXPERTS = 8
NUM_TOKENS = 16


class Expert(nn.Module):
    """Один эксперт — обычный двухслойный FFN, как в плотном трансформере."""

    def __init__(self, d_model: int, hidden: int):
        super().__init__()
        self.fc1 = nn.Linear(d_model, hidden)
        self.fc2 = nn.Linear(hidden, d_model)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.fc2(F.relu(self.fc1(x)))


class TopKRouter(nn.Module):
    """Роутер: считает logits по экспертам, выбирает top-k и ренормализует веса
    выбранных экспертов так, чтобы они снова суммировались в единицу."""

    def __init__(self, d_model: int, num_experts: int, top_k: int):
        super().__init__()
        self.gate = nn.Linear(d_model, num_experts, bias=False)
        self.top_k = top_k

    def forward(self, x: torch.Tensor):
        logits = self.gate(x)  # [tokens, num_experts]
        probs = F.softmax(logits, dim=-1)
        top_probs, top_idx = torch.topk(probs, self.top_k, dim=-1)
        top_probs = top_probs / top_probs.sum(dim=-1, keepdim=True)
        return top_probs, top_idx, probs


def count_params(module: nn.Module) -> int:
    return sum(p.numel() for p in module.parameters())


def run_moe(top_k: int, x: torch.Tensor, experts: nn.ModuleList, router: TopKRouter):
    """Диспетчеризация: для каждого из top_k слотов группируем токены по
    выбранному эксперту и прогоняем каждую группу через свой FFN одним вызовом."""
    top_probs, top_idx, _ = router(x)
    output = torch.zeros_like(x)
    for k in range(top_k):
        expert_idx = top_idx[:, k]
        weight = top_probs[:, k].unsqueeze(-1)
        for e in range(len(experts)):
            mask = expert_idx == e
            if mask.any():
                output[mask] += weight[mask] * experts[e](x[mask])
    return output, top_idx


if __name__ == "__main__":
    x = torch.randn(NUM_TOKENS, D_MODEL)
    experts = nn.ModuleList([Expert(D_MODEL, HIDDEN) for _ in range(NUM_EXPERTS)])

    total_expert_params = count_params(experts)
    single_expert_params = count_params(experts[0])

    for top_k, name in [(1, "top-1 (Switch Transformer)"), (2, "top-2 (GShard)")]:
        router = TopKRouter(D_MODEL, NUM_EXPERTS, top_k)
        router_params = count_params(router)
        output, top_idx = run_moe(top_k, x, experts, router)

        # распределение токенов по экспертам (учитываются все top_k назначения)
        counts = torch.zeros(NUM_EXPERTS, dtype=torch.long)
        for k in range(top_k):
            counts += torch.bincount(top_idx[:, k], minlength=NUM_EXPERTS)

        # активные параметры = то, что реально считается на один токен:
        # роутер плюс top_k экспертов. Общие параметры = роутер плюс все эксперты.
        active_params = router_params + top_k * single_expert_params
        total_params = router_params + total_expert_params

        print(f"\n--- {name} ---")
        print("токенов на эксперта:", counts.tolist())
        print(f"выход батча: shape={tuple(output.shape)}")
        print(f"активные параметры на токен: {active_params:,} из {total_params:,} "
              f"({100 * active_params / total_params:.1f}%)")
Вывод скрипта подтверждает арифметику удвоения на этом же слое.
--- top-1 (Switch Transformer) ---
активные параметры на токен: 17,088 из 133,120 (12.8%)

--- top-2 (GShard) ---
активные параметры на токен: 33,664 из 133,120 (25.3%)
Второй файл демонстрирует capacity factor, token dropping и auxiliary loss на том же слое, но уже с явным сравнением сбалансированного router’а и router’а с искусственно смещёнными логитами, имитирующими коллапс на одного эксперта.
# PyTorch 2.13.0, прогнано на стенде 2026-08-31
"""
Capacity factor, token dropping и auxiliary loss в Sparse MoE. Capacity задаёт
жёсткий лимит токенов на эксперта: ceil(capacity_factor * tokens_in_batch /
num_experts). Токены сверх лимита эксперт не обслуживает (token dropping,
GShard, arXiv:2006.16668) — в демо у них просто нет вклада эксперта, как если
бы MoE-подслой для них вернул ноль и residual-связь пронесла их дальше без
изменений. Auxiliary loss (Switch Transformer, arXiv:2101.03961:
loss = alpha * N * sum(f_i * P_i)) штрафует роутер за неравномерность:
f_i — доля токенов, реально отправленных на эксперта i, P_i — средняя
вероятность роутера по эксперту i. Демо сравнивает сбалансированный роутер со
смещённым (искусственная имитация коллапса на один эксперт) и показывает, как
растут дропы и auxiliary loss.
"""
import math
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(42)

D_MODEL = 64
NUM_EXPERTS = 8
NUM_TOKENS = 32
ALPHA = 1e-2  # коэффициент auxiliary loss из Switch Transformer


def route_top1(x: torch.Tensor, gate: nn.Linear, capacity_factor: float):
    logits = gate(x)
    probs = F.softmax(logits, dim=-1)
    top_prob, top_idx = probs.max(dim=-1)

    num_tokens = x.shape[0]
    capacity = math.ceil(capacity_factor * num_tokens / NUM_EXPERTS)

    # диспетчеризация по порядку токенов в батче: кто пришёл первым, тот и занял слот
    dispatched = torch.zeros(num_tokens, dtype=torch.bool)
    slot_in_expert = torch.zeros(NUM_EXPERTS, dtype=torch.long)
    for t in range(num_tokens):
        e = top_idx[t].item()
        if slot_in_expert[e]  torch.Tensor:
    num_tokens = probs.shape[0]
    f = torch.bincount(top_idx, minlength=NUM_EXPERTS).float() / num_tokens  # доля диспетчеризации
    p = probs.mean(dim=0)  # средняя вероятность роутера по эксперту
    return ALPHA * NUM_EXPERTS * (f * p).sum()


if __name__ == "__main__":
    x = torch.randn(NUM_TOKENS, D_MODEL)

    print("=== Сбалансированный роутер (случайная инициализация) ===")
    gate_balanced = nn.Linear(D_MODEL, NUM_EXPERTS, bias=False)
    for capacity_factor in (1.0, 1.25):
        top_idx, top_prob, probs, dispatched, capacity = route_top1(x, gate_balanced, capacity_factor)
        dropped = (~dispatched).sum().item()
        print(f"capacity_factor={capacity_factor}: лимит на эксперта={capacity}, "
              f"дропнуто токенов={dropped} из {NUM_TOKENS}")
    aux = auxiliary_loss(top_idx, probs)
    print(f"auxiliary loss (alpha={ALPHA}): {aux.item():.6f}")

    print("\n=== Смещённый роутер (collapse: один эксперт доминирует) ===")
    gate_collapsed = nn.Linear(D_MODEL, NUM_EXPERTS, bias=False)
    with torch.no_grad():
        # искусственно поднимаем логит одного эксперта — имитация коллапса роутинга,
        # к которому в реальности приводит самоусиливающийся эффект: эксперт, получивший
        # чуть больше градиента на старте, чаще выбирается и обучается быстрее остальных
        gate_collapsed.weight[0] += 5.0
    for capacity_factor in (1.0, 1.25):
        top_idx, top_prob, probs, dispatched, capacity = route_top1(x, gate_collapsed, capacity_factor)
        dropped = (~dispatched).sum().item()
        counts = torch.bincount(top_idx, minlength=NUM_EXPERTS).tolist()
        print(f"capacity_factor={capacity_factor}: лимит на эксперта={capacity}, "
              f"дропнуто токенов={dropped} из {NUM_TOKENS}, токенов на эксперта={counts}")
    aux_collapsed = auxiliary_loss(top_idx, probs)
    print(f"auxiliary loss (alpha={ALPHA}): {aux_collapsed.item():.6f}")
Числа в выводе совпадают с уже разобранными выше в разделе про collapse экспертов.
=== Сбалансированный роутер (случайная инициализация) ===
capacity_factor=1.0: лимит на эксперта=4, дропнуто токенов=8 из 32
capacity_factor=1.25: лимит на эксперта=5, дропнуто токенов=5 из 32
auxiliary loss (alpha=0.01): 0.010505

=== Смещённый роутер (collapse: один эксперт доминирует) ===
capacity_factor=1.0: лимит на эксперта=4, дропнуто токенов=11 из 32, токенов на эксперта=[14, 4, 2, 1, 2, 5, 3, 1]
capacity_factor=1.25: лимит на эксперта=5, дропнуто токенов=9 из 32, токенов на эксперта=[14, 4, 2, 1, 2, 5, 3, 1]
auxiliary loss (alpha=0.01): 0.019086
Числа детерминированы фиксированным сидом и зависят от случайной инициализации nn.Linear, которая теоретически может немного отличаться между мажорными версиями PyTorch, но сама механика, рост доли активных параметров при переходе с top-1 на top-2 и рост дропов вместе с auxiliary loss при коллапсе router’а, воспроизводится на любой версии PyTorch 2.x.
Заключение
Sparse Mixture-of-Experts переводит рост параметров модели из линейной зависимости от стоимости инференса в почти независимую переменную, и это единственная причина, по которой модели на сотни миллиардов и триллионы параметров вообще можно обучать и обслуживать на существующей инфраструктуре. Цена за это ощутима. Router становится отдельной точкой отказа, capacity factor превращается в ручной компромисс между дропами и избыточным буфером, а коллапс экспертов приходится постоянно сдерживать либо auxiliary loss, либо его более новой loss-free альтернативой. Ни одна из архитектур не убрала эти компромиссы полностью, они лишь по-разному распределяют их между router’ом, функцией потерь и инфраструктурой распределённого обучения.
Референсные ссылки
- GShard, arXiv:2006.16668, архитектура top-2 gating и capacity-ограничения с token dropping.
- Switch Transformer, arXiv:2101.03961, top-1 routing и формула auxiliary loss.
- Официальный туториал DeepSpeed-MoE, expert parallelism и Random Token Selection.
- HuggingFace, обзор эволюции балансировки нагрузки в MoE LLM, вторичный источник по loss-free balancing DeepSeek-V3.
- DeepSeek-V3 Technical Report, arXiv:2412.19437, для сверки архитектуры при необходимости.