
 34
Содержание
- Что такое prompt caching и зачем он нужен
- Архитектура и ключевые компоненты
- Иерархия tools, system и messages у Anthropic и точки cache_control
- Кэш KV-тензоров и prompt_cache_key у OpenAI
- Принцип работы записи и чтения кэша
- Сравнение лимитов и экономики Anthropic и OpenAI
- Prompt caching в агентных и многоходовых системах
- Когда кэш работает, а когда нет
- Практический замер переиспользования префикса на локальной модели
- Заключение
- Референсные ссылки
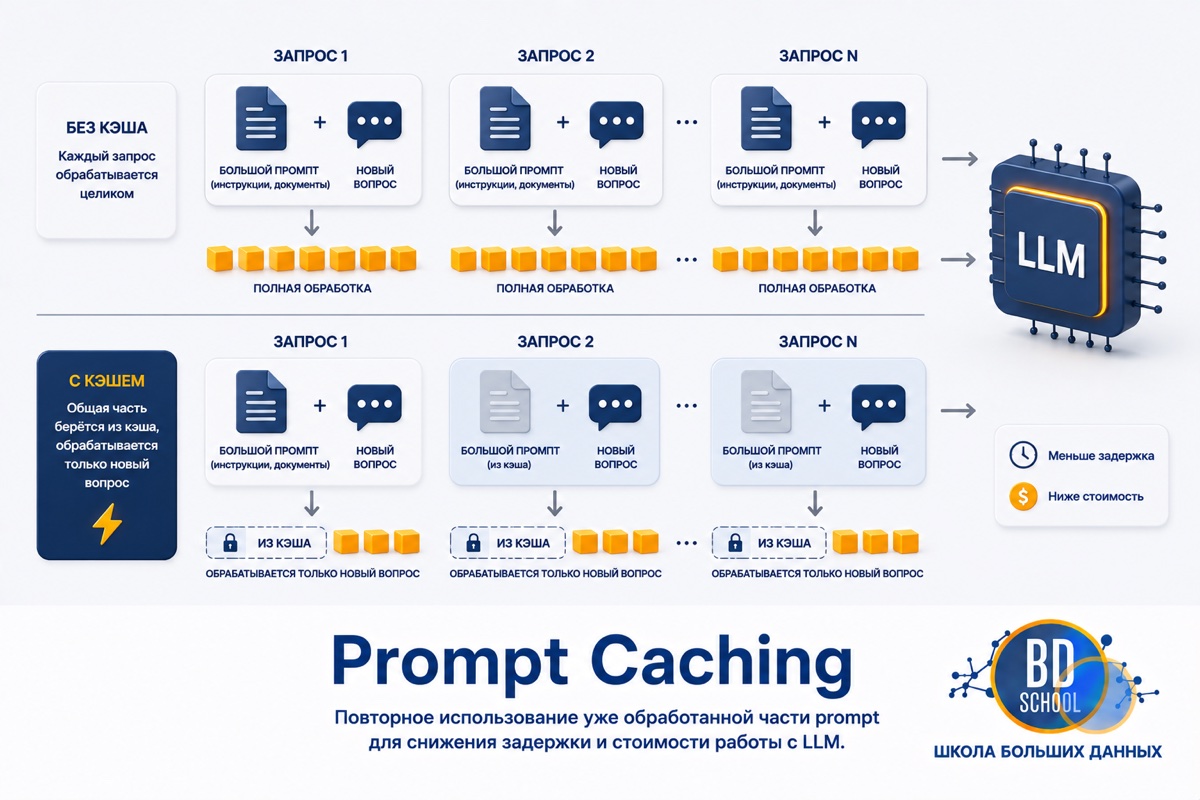
Prompt caching (кэширование промптов) это фича API у крупных провайдеров LLM, которая позволяет не пересчитывать заново повторяющийся начальный фрагмент запроса (системный промпт, описания инструментов, длинный контекст) и платить за его обработку меньше на каждом следующем вызове. У Anthropic и OpenAI это конкретная возможность API со своей ценой, лимитами и правилами попадания в кэш, а не общая архитектурная идея без цифр. Больше всего от неё выигрывают многоходовые агентные и диалоговые системы, где системный промпт и определения инструментов не меняются от хода к ходу, и дальше в статье это подтверждается не только документацией вендоров, но и собственным замером переиспользования префикса на локальной модели.
Что такое prompt caching и зачем он нужен
На уровне вычислений это устроено просто. Модель на трансформерной архитектуре при обработке текста считает для каждого токена промежуточные key-value состояния слоёв внимания, всё вместе называют KV-кэшем (KV-cache, key-value cache). Если новый запрос начинается с точно того же префикса, что обрабатывался раньше, эти состояния переиспользуются вместо повторного прохода модели по тем же токенам. Anthropic описывает эффект как возобновление работы с уже обработанного префикса промпта. OpenAI описывает то же самое иначе, через механику вычислений. Кэшируются сами key-value тензоры, вычисленные при обработке входных токенов, а не исходный текст. Разница формулировок отражает разный уровень абстракции в документации, а не разную физику, оба вендора экономят один и тот же тип вычислений.
Эффект двойной. Латентность падает, потому что модель не пересчитывает уже обработанную часть промпта, а стоимость снижается за счёт скидки на чтение из кэша. Оба эффекта растут вместе с длиной префикса и числом повторных вызовов.
Архитектура и ключевые компоненты
Оба вендора решают одну задачу, но раскладывают запрос на кэшируемые уровни по-разному, и это определяет, где в промпте выгоднее размещать стабильный контент, а где переменный.
Иерархия tools, system и messages у Anthropic и точки cache_control
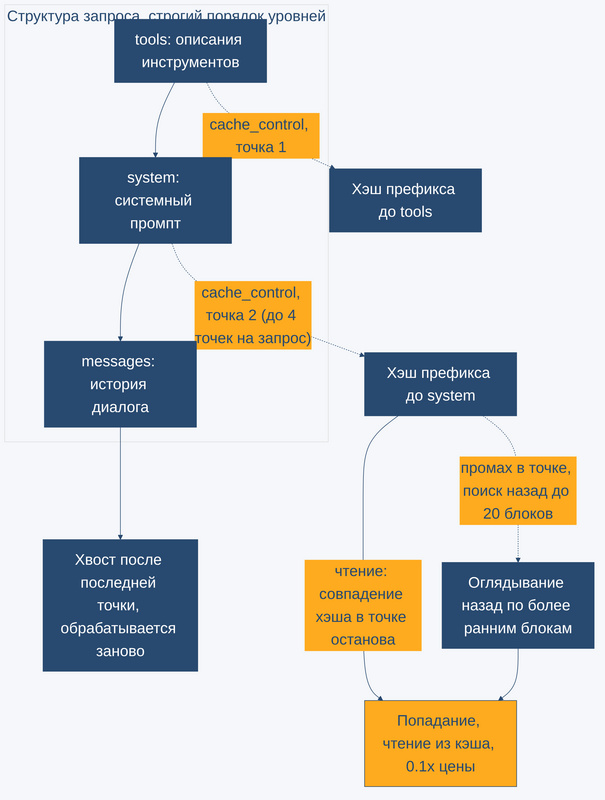
Anthropic делит запрос на три уровня, кэшируемых в строгом порядке tools, system, messages. Точка cache_control хэширует префикс запроса до себя включительно, поэтому изменение блока до точки или в ней меняет хэш и ломает кэш там же (подробности в официальной документации). Расставить точки кэша можно двумя способами. В режиме automatic caching достаточно одного поля cache_control на верхнем уровне запроса, и система сама подтягивает точку к последнему кэшируемому блоку по мере роста диалога. В режиме explicit точки cache_control расставляются вручную на отдельных content-блоках, максимум четыре на запрос, и это даёт больше контроля там, где префикс состоит из нескольких независимо меняющихся частей. Хранилище кэша изолировано на уровне workspace для Claude API, Claude Platform on AWS и Microsoft Foundry, либо на уровне организации для Bedrock и Google Cloud Vertex AI, поэтому кэш одного клиентского приложения не виден другому в том же аккаунте на других платформах.
Кэш KV-тензоров и prompt_cache_key у OpenAI
OpenAI кэширует не текст, а «полный отрендеренный контекст» запроса целиком, то есть системные и developer-инструкции, определения инструментов и историю диалога с текстом, изображениями, документами и поддерживаемым аудио. Совпадение проверяется по всему префиксу сразу, а не по отдельным блокам, как у Anthropic, поэтому у OpenAI нет ручной расстановки точек кэша внутри запроса. Для управления распределением нагрузки между инстансами кэша есть параметр prompt_cache_key, который привязывает поток однотипных запросов к одному и тому же кэш-инстансу и повышает шанс попадания при высокой нагрузке.
Принцип работы записи и чтения кэша
У Anthropic запись кэша происходит только в точке cache_control, и это кумулятивный хэш всего префикса вплоть до этого блока включительно; изменение любого более раннего блока меняет хэш целиком. Чтение ищет совпадение хэша ровно в точке останова, а при промахе «оглядывается назад» по более ранним блокам в поисках совпадающей записи, но не дальше 20 блоков от точки останова. Есть практическая деталь для латентности. Запись становится доступна для использования следующим запросом уже после начала первого ответа, а не после его завершения. У OpenAI модель при обработке входных токенов вычисляет промежуточные KV-состояния, они сохраняются и при полном совпадении префикса переиспользуются вместо пересчёта, но хвост запроса после точки совпадения модель всё равно обрабатывает заново. «Скрытые системные токены» в счёт кэшированных не идут, а на моделях старше GPT-5.6 длина совпадения округляется вниз до кратных 128 токенам. У обоих вендоров совпадение должно быть точным до символа. Один изменённый символ в кэшируемом сегменте превращает совпадение в промах целиком, частичное сходство не считается, и дальше в статье это видно на собственном замере.
Сравнение лимитов и экономики Anthropic и OpenAI
Числа по TTL и порогу токенов у вендоров архитектурно разные, это не противоречие источников, а особенность каждой реализации, сравнивать их напрямую как «один и тот же лимит» нельзя. Свести к одной таблице стоит то, что реально определяет решение об использовании кэша, а именно минимальный размер префикса, время жизни записи и разницу в цене между записью и чтением.
| Параметр | Anthropic (Claude) | OpenAI (GPT-5.6+) |
|---|---|---|
| Минимальная длина кэшируемого префикса | 512-4096 токенов в зависимости от модели | 1024 токена (2048 на моделях старше GPT-5.6) |
| Точки кэша | до 4 явных cache_control на запрос, либо automatic | нет ручных точек, совпадение по всему префиксу |
| TTL кэша | 5 минут по умолчанию, 1 час за доплату | 30 минут с последней записи или чтения |
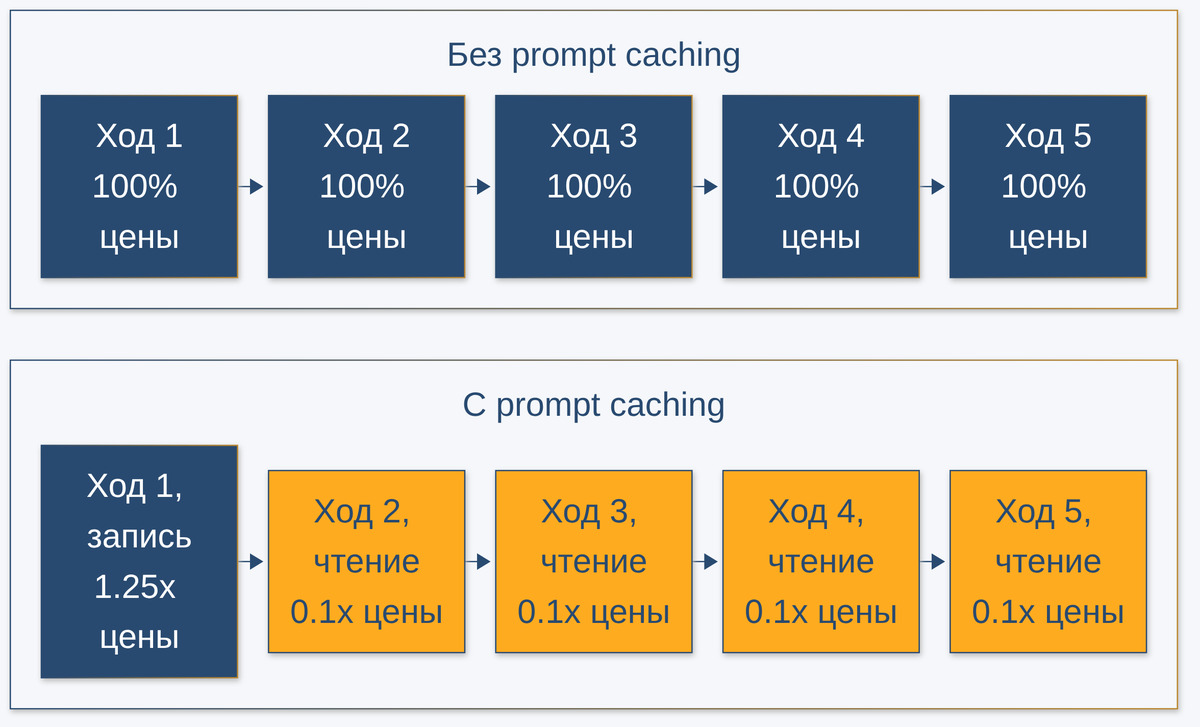
| Наценка на запись | 1.25× цены входных токенов (2× для часового TTL) | 1.25× цены входных токенов |
| Скидка на чтение | 0.1× цены входных токенов (минус 90%) | 0.1× цены входных токенов (минус 90%) |
| Известное ограничение нагрузки | окно поиска совпадения не более 20 блоков назад | около 15 запросов в минуту на пару префикс + prompt_ |
Итог по цифрам простой. Оба вендора берут наценку на запись и одинаковую скидку 90% на чтение, различия сосредоточены в TTL и в разметке точек кэша. Живой пример поля cached_tokens на реальном тесте через OpenRouter (агрегатор API разных LLM-вендоров) разобран в статье «Экономика токенов в OpenRouter, кэш и субагенты». Управление стоимостью и архитектурой таких систем на проде разбирается в курсе «Архитектура ML-систем».
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Prompt caching в агентных и многоходовых системах
Агентный цикл вызывает модель десятки раз за одну сессию, и на каждом ходу вместе с новым сообщением пользователя в запрос уходит один и тот же системный промпт и одни и те же определения инструментов. Без кэша каждый такой ход платит полную цену за неизменную часть промпта, хотя модель обрабатывала её уже на предыдущем шаге. Anthropic прямо перечисляет сценарии, где выгода максимальна.
- Диалоговые агенты с длинными инструкциями. Системный промпт с персоной, правилами и загруженными документами не меняется от хода к ходу.
- Кодовые ассистенты с большим контекстом. Кодовая база или её релевантный срез остаются в префиксе между запросами.
- Агентное использование инструментов. Определения tools повторяются в каждом вызове модели, даже когда сам вызов инструмента произошёл только что.
- Few-shot промпты и повторяющиеся задачи. Набор примеров или инструкция задачи одни и те же на множестве запросов подряд.
Общий признак у всех четырёх сценариев один, доля стабильного текста в промпте растёт быстрее доли нового содержимого, и именно эта доля определяет экономию.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Когда кэш работает, а когда нет
Не всякий промпт выигрывает от кэша, и вендоры прямо перечисляют случаи, где включать его бессмысленно или вредно.
- Промпт короче порога. Ниже минимальной длины для модели кэш просто не включается, но и ошибки при этом не возникает.
- Изменчивый контент до точки останова. Таймстемп, свежий пользовательский ввод или счётчик, вставленные до точки cache_control или в неё, инвалидируют всё, что идёт после них в запросе.
- Разовые запросы. Без второго обращения в пределах TTL наценка на запись кэша просто не окупается.
- Сильно динамичные контексты. Если префикс меняется почти в каждом запросе, стабильной части, на которой можно сэкономить, для этого текста фактически нет.
Общее правило простое, кэш выигрывает у объёма стабильного текста перед точкой изменения, а не у общего размера промпта.
Практический замер переиспользования префикса на локальной модели
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Vendor-биллинг кэша недоступен локально, но тот же архитектурный эффект (переиспользование уже посчитанного состояния модели для неизменного префикса) воспроизводится и на модели без всякого биллинга. Эксперимент ниже прогнан на qwen2.5:7b через Ollama 0.32.13 (локальный раннер для LLM), пять вызовов подряд к одной модели с длинным статичным системным промптом на около 900 токенов (карточки тарифов вымышленного SaaS-продукта). Единственный надёжный сигнал переиспользования это prompt_eval_duration, реальное время обработки промпта. Счётчик prompt_eval_count сигналом не служит, он всегда равен полной длине промпта, даже когда бо́льшая её часть не пересчитывалась.
# ollama (python client) 0.6.2, сервер ollama 0.32.13, модель qwen2.5:7b, прогнано на стенде 2026-08-27
"""
Демонстрация того же механизма, который лежит в основе prompt caching у вендоров
(Anthropic, OpenAI): переиспользование уже посчитанного KV-состояния для повторяющегося
префикса запроса, без пересчёта токенов заново.

Локальный Ollama не биллингует кэш и не даёт явных cache_control-точек, как Anthropic, но
у него та же механика на уровне движка: если новый запрос продолжает ровно тот же префикс,
что был в предыдущем запросе к этой же модели, движок не пересчитывает префикс заново.
Единственный надёжный сигнал переиспользования в ответе Ollama - prompt_eval_duration (сколько
времени ушло на обработку промпта). Поле prompt_eval_count сигналом не служит: оно всегда равно
полной длине промпта, даже когда бо́льшая его часть не пересчитывалась заново. Скрипт не
воспроизводит биллинг вендоров, он показывает тот же факт архитектуры: повторный проход по
неизменному префиксу дешевле нового.

Пять вызовов подряд к одной и той же модели:
  1. turn1_cold_prefix            - длинный статичный системный промпт + первый вопрос, с нуля.
  2. turn2_continue_same_prefix   - тот же диалог продолжается вторым вопросом.
  3. turn3_continue_same_prefix   - тот же диалог продолжается третьим вопросом.
  4. turn4_prefix_changed_one_char - НОВЫЙ диалог, тот же системный промпт с изменением
     на один символ, отправлен сразу после turn3 (последним состоянием движка был turn3).
  5. turn5_original_prefix_out_of_sequence - тот же самый запрос, что и turn1 (оригинальный,
     неизменный префикс), но отправлен не сразу после себя, а после turn4.

Ожидание по документации: 2 и 3 быстрее 1 по prompt-стороне, потому что префикс уже обработан.
Что покажет turn4 и turn5 - не подгоняется заранее, это и есть предмет измерения (пилот).
"""

import json
import time

import ollama

MODEL = "qwen2.5:7b"
NUM_CTX = 8192
NUM_PREDICT = 30  # мало токенов на выходе, чтобы не смазывать замер на стороне промпта

# Реалистичный системный промпт агента поддержки: персона, правила, две карточки тарифов.
# Специально длинный и неизменяемый между ходами - ровно то, что в статье описано как
# сценарий с наибольшей выгодой от prompt caching (агентный/диалоговый сценарий).
LONG_SYSTEM_PROMPT = """Ты - агент поддержки продукта CloudMetrics (SaaS-платформа мониторинга
инфраструктуры). Отвечай кратко, по-русски, только на основании данных ниже. Если ответа нет
в данных - прямо скажи, что не знаешь, и предложи передать вопрос человеку. Не придумывай цены,
лимиты и даты, которых нет в карточках тарифов ниже. Не упоминай, что ты языковая модель. Дата
снимка данных: 2026-08-27.

Правила общения:
- Обращение на "вы", без канцелярита и лишних извинений.
- Один ответ - один прямой вывод, без пересказа вопроса клиента.
- Если вопрос касается сразу двух тарифов - сравнение таблицей из двух-трёх строк.
- Скидки, промокоды и индивидуальные условия - только если они прямо указаны в карточке тарифа.
- При вопросе про технические лимиты (retention, число агентов, частота опроса) - цитировать
  цифру из карточки дословно, единицы измерения не менять и не округлять.

Карточка тарифа Pro:
- Цена: 4 900 руб/мес за проект, без ограничения на число пользователей аккаунта.
- Retention метрик: 30 дней при разрешении 10 секунд, далее агрегация до 5 минут на 400 дней.
- Число агентов мониторинга: до 200 хостов на проект.
- Алерты: до 50 правил, каналы - email, Slack, Telegram, Webhook.
- SLA поддержки: ответ в течение 8 рабочих часов, канал - почта и чат в личном кабинете.
- Годовая оплата: скидка 15% от суммы 12 месяцев при оплате разом.
- Не входит: SSO, кастомные дашборды на API, выделенный TAM.

Карточка тарифа Enterprise:
- Цена: по индивидуальному расчёту, зависит от числа хостов и retention; агенту менеджера для
  расчёта не давать, всегда направлять на форму заявки на сайте.
- Retention метрик: настраиваемый, минимум 400 дней на полном разрешении.
- Число агентов мониторинга: без верхнего предела тарифа, лимит только по контракту.
- Алерты: без ограничения по числу правил, дополнительно PagerDuty и Opsgenie.
- SLA поддержки: ответ в течение 1 часа, круглосуточно, выделенный TAM.
- Годовая оплата: обязательна, помесячной оплаты на этом тарифе нет.
- Входит: SSO (SAML, OIDC), кастомные дашборды через API, аудит-лог действий команды.

Типовые вопросы, на которые уже есть точный ответ выше: цена Pro, что входит в Enterprise,
разница retention между тарифами, наличие SSO, условия годовой оплаты, число хостов на Pro.
Всё, чего нет в карточках (например точная цена Enterprise, наличие скидки для НКО, миграция
данных между тарифами) - эскалация на человека, а не предположение.
"""


def chat_turn(messages: list[dict], label: str) -> tuple[dict, dict]:
    t0 = time.time()
    resp = ollama.chat(
        model=MODEL,
        messages=messages,
        stream=False,
        options={"num_ctx": NUM_CTX, "temperature": 0, "num_predict": NUM_PREDICT},
    )
    wall_s = time.time() - t0
    stats = {
        "label": label,
        "wall_s": round(wall_s, 2),
        "prompt_eval_count": resp.prompt_eval_count,
        "prompt_eval_duration_s": round((resp.prompt_eval_duration or 0) / 1e9, 3),
        "eval_count": resp.eval_count,
        "eval_duration_s": round((resp.eval_duration or 0) / 1e9, 3),
        "total_duration_s": round((resp.total_duration or 0) / 1e9, 3),
        "load_duration_s": round((resp.load_duration or 0) / 1e9, 3),
    }
    print(f"\n--- {label} ---")
    print(json.dumps(stats, ensure_ascii=False, indent=2))
    return resp, stats


def main() -> None:
    print(f"=== Прогрев модели {MODEL} (короткий вызов без длинного префикса) ===")
    ollama.chat(model=MODEL, messages=[{"role": "user", "content": "ping"}], options={"num_ctx": NUM_CTX})

    q1 = "Клиент спрашивает: сколько стоит тариф Pro?"
    messages = [
        {"role": "system", "content": LONG_SYSTEM_PROMPT},
        {"role": "user", "content": q1},
    ]
    resp1, s1 = chat_turn(messages, "turn1_cold_prefix")
    messages.append({"role": "assistant", "content": resp1.message.content})

    messages.append({"role": "user", "content": "А что входит в тариф Enterprise?"})
    resp2, s2 = chat_turn(messages, "turn2_continue_same_prefix")
    messages.append({"role": "assistant", "content": resp2.message.content})

    messages.append({"role": "user", "content": "Есть ли SSO на тарифе Pro?"})
    resp3, s3 = chat_turn(messages, "turn3_continue_same_prefix")

    broken_prefix = LONG_SYSTEM_PROMPT.replace("2026-08-27", "2026-08-28", 1)
    messages_broken = [
        {"role": "system", "content": broken_prefix},
        {"role": "user", "content": q1},
    ]
    resp4, s4 = chat_turn(messages_broken, "turn4_prefix_changed_one_char")

    messages_original_again = [
        {"role": "system", "content": LONG_SYSTEM_PROMPT},
        {"role": "user", "content": q1},
    ]
    resp5, s5 = chat_turn(messages_original_again, "turn5_original_prefix_out_of_sequence")

    print("\n=== Итог: все замеры ===")
    print(json.dumps([s1, s2, s3, s4, s5], ensure_ascii=False, indent=2))

    print("\n=== Вывод по числам ===")
    print(f"turn1 (холодный префикс): prompt_eval_count={s1['prompt_eval_count']}, "
          f"prompt_eval_duration_s={s1['prompt_eval_duration_s']}")
    print(f"turn2 (продолжение):      prompt_eval_count={s2['prompt_eval_count']}, "
          f"prompt_eval_duration_s={s2['prompt_eval_duration_s']}")
    print(f"turn3 (продолжение):      prompt_eval_count={s3['prompt_eval_count']}, "
          f"prompt_eval_duration_s={s3['prompt_eval_duration_s']}")
    print(f"turn4 (сдвиг + 1 символ): prompt_eval_count={s4['prompt_eval_count']}, "
          f"prompt_eval_duration_s={s4['prompt_eval_duration_s']}")
    print(f"turn5 (тот же turn1, но не подряд): prompt_eval_count={s5['prompt_eval_count']}, "
          f"prompt_eval_duration_s={s5['prompt_eval_duration_s']}")


if __name__ == "__main__":
    main()
Результаты пяти вызовов первого прогона собраны в таблице.
| Вызов | prompt_ |
prompt_ |
Что произошло |
|---|---|---|---|
| turn1_ |
905 | 7.482 | холодный вызов, полный пересчёт префикса |
| turn2_ |
942 | 0.274 | тот же диалог, префикс уже посчитан |
| turn3_ |
994 | 0.275 | тот же диалог, префикс всё ещё в кэше |
| turn4_ |
905 | 6.202 | один символ в префиксе изменён, промах |
| turn5_ |
905 | 0.086 | точный повтор запроса №1, но не подряд |
Первая тройка предсказуема. Turn2 и turn3 обрабатываются на порядок быстрее turn1, хотя у них больше токенов в промпте, потому что бо́льшая часть уже посчитана в рамках того же диалога. Интереснее следующие два вызова. Turn4 меняет в 900-токенном префиксе ровно один символ и запускается новым диалогом сразу после turn3, а время возвращается к уровню холодного вызова, что подтверждает требование к точному посимвольному совпадению, документированное у обоих вендоров. Turn5 повторяет исходный запрос turn1 дословно, но отправлен не сразу после себя, а после turn4, то есть с двумя другими запросами между ними. Гипотеза «кэш хранит только последнее состояние» предсказывала бы здесь промах, но время у turn5 оказалось таким же низким, как у продолженного диалога. Значит у раннера Ollama сохраняется пул из нескольких состояний, а не одно последнее, и совпадение ищется по точному тексту префикса среди всех сохранённых вариантов, а не по порядку вызовов.
Это удобный контраст с вендорскими кэшами. У Anthropic и OpenAI попадание в кэш определяется явными точками cache_control или автоматическим хэшированием префикса с задокументированным TTL, это часть публичного контракта API. У локального раннера Ollama такое поведение это деталь реализации без явного контракта. Повторный прогон демо через несколько минут в рамках того же процесса Ollama показал, что оба варианта префикса, оригинальный и с одним изменённым символом, остались в кэше и на второй раз обработались быстро (0.087 и 0.085 секунды соответственно). Переживает ли это состояние выгрузку модели по keep_alive или перезапуск сервера, отдельно не проверялось, это осталось за пределами бюджета замера.
Заключение
Prompt caching превращает повторяющуюся часть промпта из постоянных расходов в разовые. У Anthropic и OpenAI это конкретная фича API с ценой на запись, скидкой на чтение и своим TTL, а не общая идея оптимизации. Экономия растёт вместе с числом ходов и долей стабильного текста в запросе, поэтому агентные циклы с повторяющимися инструментами и многоходовые диалоги с неизменным системным промптом получают от кэша больше всего. Практический вывод из документации и из собственного замера один. Стабильный контент стоит держать в начале промпта и не трогать его между вызовами, а изменчивые данные (даты, свежий пользовательский ввод, счётчики) размещать после точки кэша, а не до неё. Один изменённый символ в префиксе стоит вендору полной цены пересчёта, и локальный эксперимент на qwen2.5:7b показывает тот же эффект без единого доллара биллинга.