
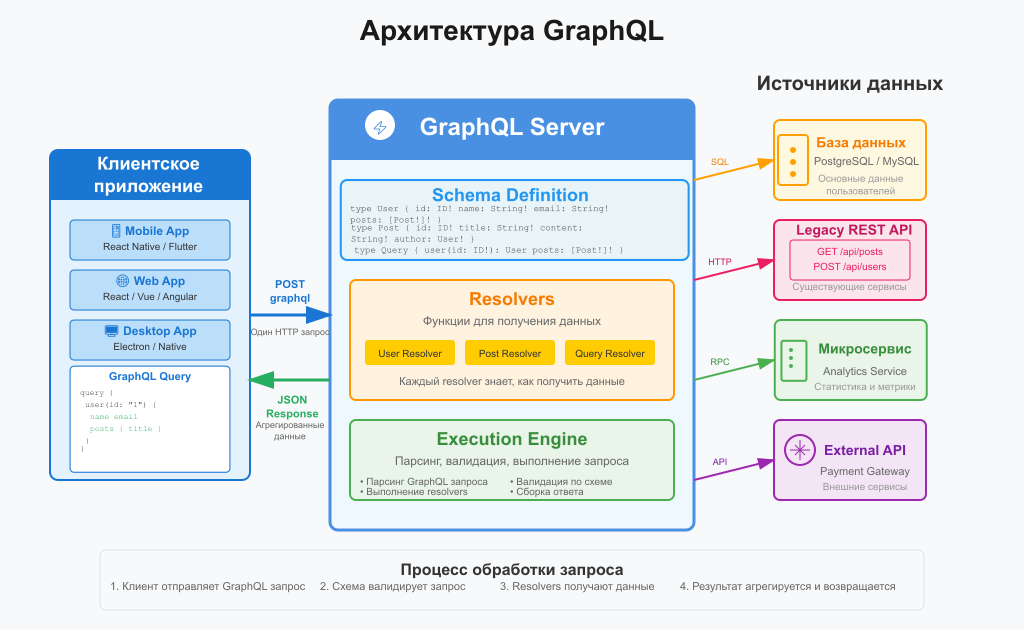
GraphQL — это язык запросов для API и среда выполнения на стороне сервера для обработки этих запросов. Он был разработан компанией Facebook в 2012 году и открыт для публичного использования в 2015 году. Основная цель GraphQL — предоставить клиентам возможность запрашивать только те данные, которые им действительно нужны, и...

GraphRAG (graph retrieval-augmented generation) это разновидность RAG, в которой контекст для языковой модели ищется не только по векторной близости текстовых фрагментов, но и по графу знаний с сущностями и связями между ними. Подход придумали в Microsoft Research, чтобы закрыть слабое место обычного поиска по эмбеддингам. Тот находит документы, похожие на...
Greenplum – open-source продукт, массивно-параллельная реляционная СУБД для хранилищ данных с гибкой горизонтальной масштабируемостью и столбцовым хранением данных на основе PostgreSQL. Благодаря своим архитектурным особенностям и мощному оптимизатору запросов, Гринплам отличается особой надежностью и высокой скоростью обработки SQL-запросов над большими объемами данных, поэтому эта MPP-СУБД широко применяется для аналитики Big...
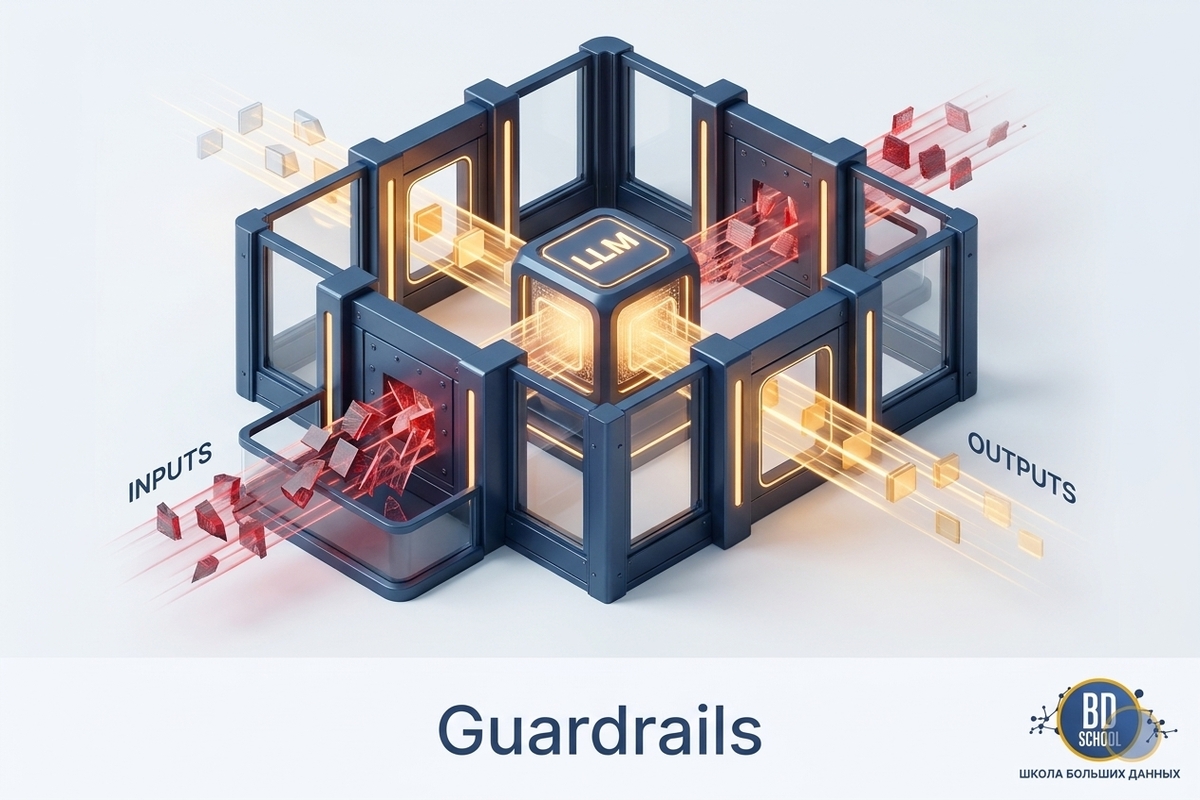
Guardrails (гардрейлы) это программируемые проверки вокруг вызова большой языковой модели (LLM, large language model), которые пропускают к модели и от неё только то, что разрешено политикой приложения. Запрос проверяется до модели, ответ после неё, а у ИИ-агента ещё и каждый вызов инструмента. Guardrail не меняет веса модели и не...
Hadoop – это свободно распространяемый набор утилит, библиотек и фреймворк для разработки и выполнения распределённых программ, работающих на кластерах из сотен и тысяч узлов. Эта основополагающая технология хранения и обработки больших данных (Big Data) является проектом верхнего уровня фонда Apache Software Foundation. Из чего состоит Hadoop: концептуальная архитектура Изначально проект...
Hallucination detection (Детекция галлюцинаций) - это не один инструмент с единой версией, а класс техник, которые проверяют ответ большой языковой модели (LLM) на соответствие исходному документу или извлечённому контексту. Термин объединяет разные по устройству подходы, а именно отдельный классификатор вроде Vectara HHEM, который выдаёт числовой скор доверия, и LLM-as-judge...
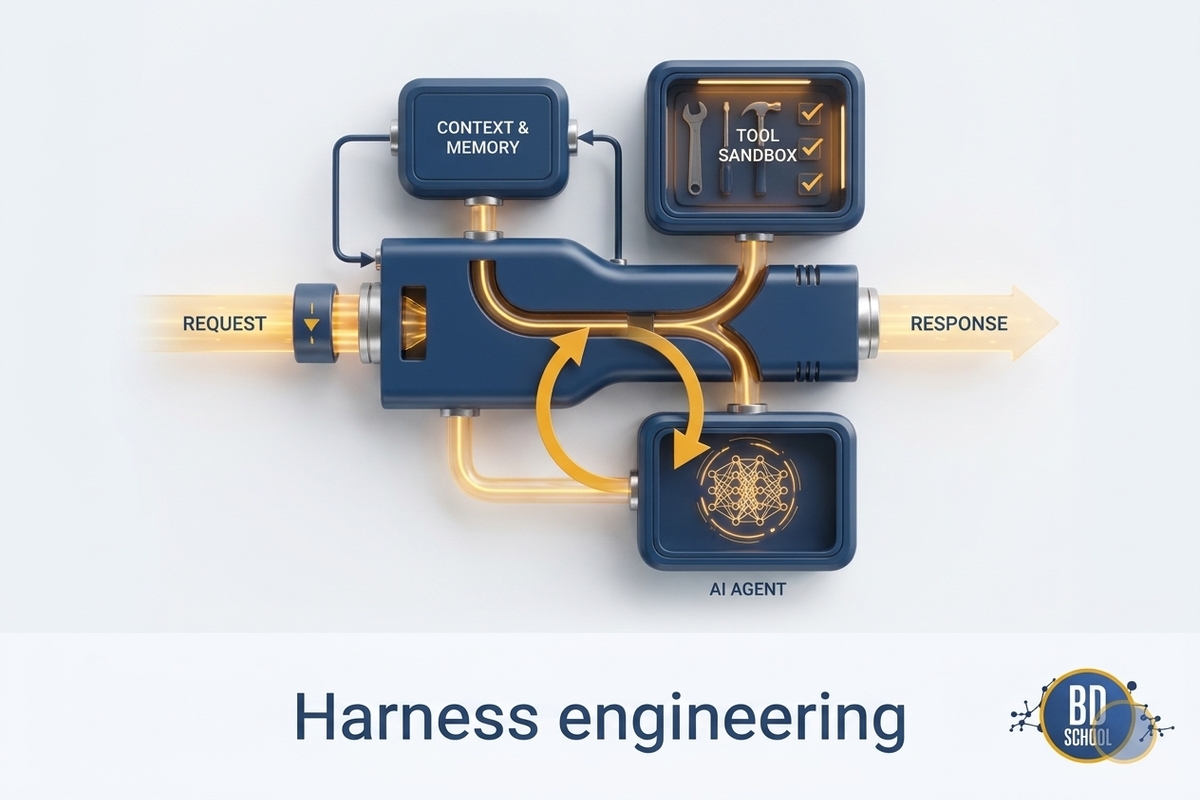
Harness engineering (инженерия среды агента) это проектирование всего, что окружает языковую модель в ИИ-агенте, а именно цикла вызовов, набора инструментов, контекста и памяти, песочницы и проверок, которые возвращают модели результат её действий. Модель отвечает за то, что сказать, а harness решает, что она увидит, что ей разрешено сделать и...
Apache HBase – это нереляционная, распределенная база данных с открытым исходным кодом, написанная на языке Java по аналогии BigTable от Google. Изначально эта СУБД класса NoSQL создавалась компанией Powerset в 2007 году для обработки больших объёмов данных в рамках поисковой системы на естественном языке. Проектом верхнего уровня Apache Software Foundation HBase стала...
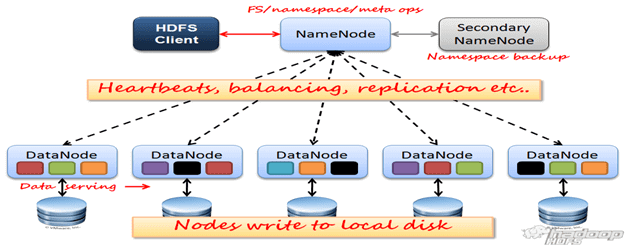
HDFS (Hadoop Distributed File System) — распределенная файловая система Hadoop для хранения файлов больших размеров с возможностью потокового доступа к информации, поблочно распределённой по узлам вычислительного кластера [1], который может состоять из произвольного аппаратного обеспечения [2]. Hadoop Distributed File System, как и любая файловая система – это иерархия каталогов с...
HDInsight - это корпоративный сервис с открытым кодом от Microsoft для облачной платформы Azure, позволяющий работать с кластером Apache Hadoop в облаке в рамках управления и аналитической работы с большими данными (Big Data). Экосистема HDInsight Azure HDInsight – это облачная экосистема компонентов Apache Hadoop на основе платформы данных Hortonworks Data Platform...
Apache Hive - это SQL интерфейс доступа к данным для платформы Apache Hadoop. Hive позволяет выполнять запросы, агрегировать и анализировать данные используя SQL синтаксис. Для данных в файловой системе HDFS используется схема доступа на чтение, позволяющая обращаться с данными, как с обыкновенной таблицей или реляционной СУБД. Запросы HiveQL транслируются в Java-код...
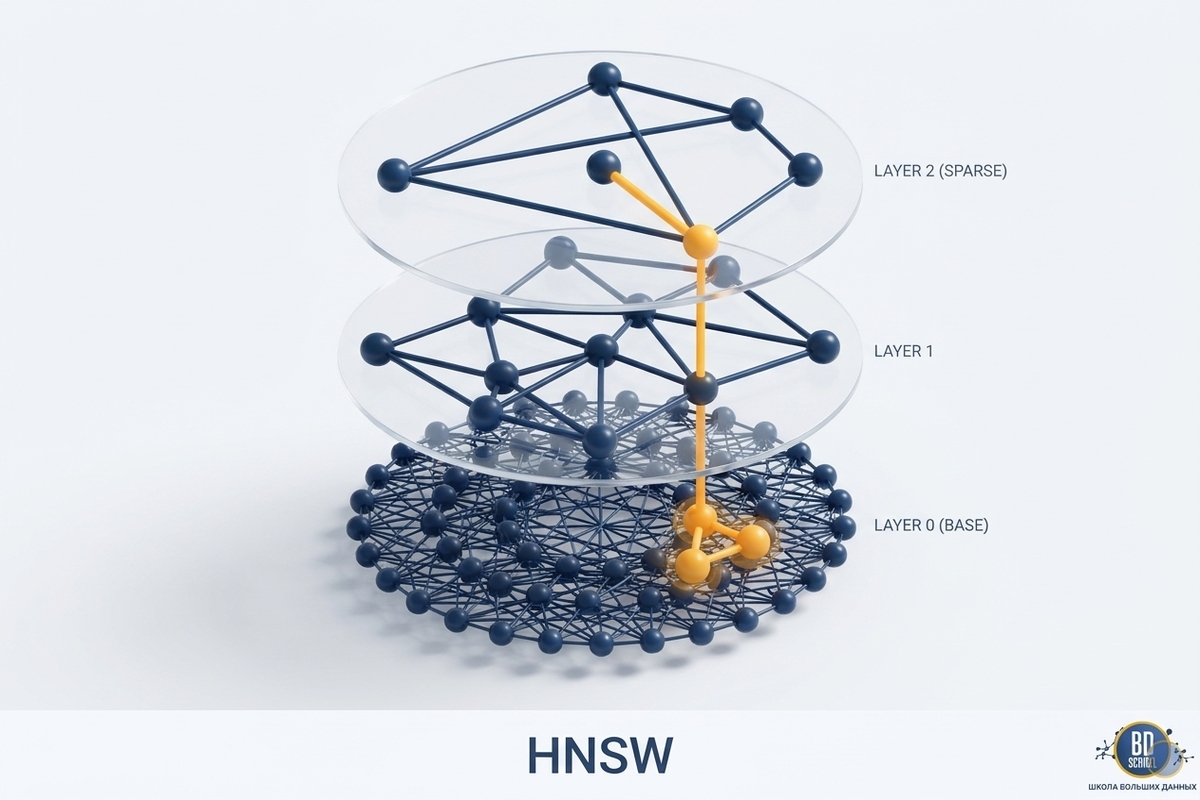
HNSW (Hierarchical Navigable Small World, иерархический навигируемый малый мир) это графовый алгоритм приближённого поиска ближайших соседей (Approximate Nearest Neighbor, ANN), который раскладывает векторы по вложенным слоям графа близости и ищет k ближайших к запросу, спускаясь по слоям сверху вниз и вычисляя расстояния лишь до малой доли базы. Алгоритм описали...
Hortonworks Data Platform (HDP) — дистрибутив Apache Hadoop с набором программ, библиотек и утилит Apache Software Foundation, адаптированных компанией Hortonworks для больших данных (Big Data) и машинного обучения (Machine Learning), бесплатно распространяемый и коммерчески поддерживаемый [1]. Помимо HDP, компания Hortonworks предлагает еще другие продукты для Big Data и Machine Learning,...
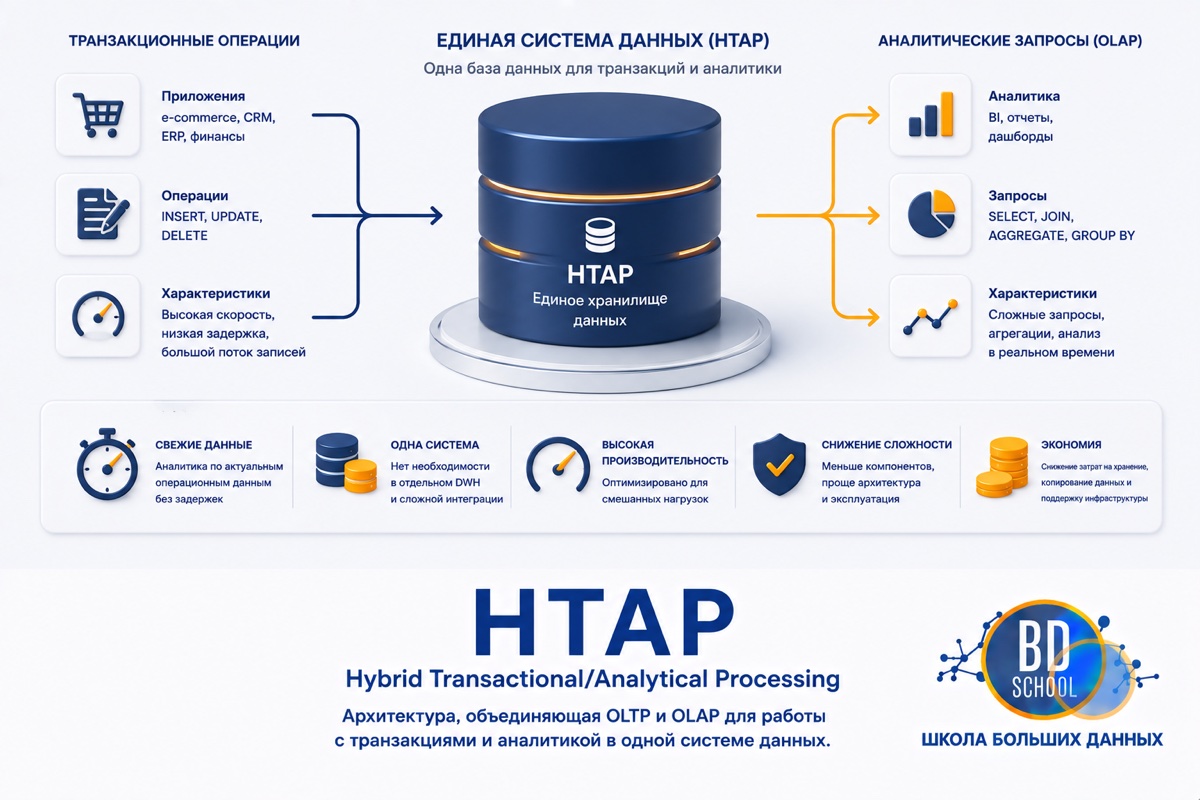
HTAP (Hybrid Transactional/Analytical Processing, гибридная транзакционно-аналитическая обработка) это архитектурный подход, при котором одна система обслуживает и короткие транзакции, и тяжёлую аналитику по тем же данным, без выгрузки их в отдельное хранилище. Термин ввела исследовательская компания Gartner в 2014 году, и с тех пор его носят и распределённые СУБД вроде...
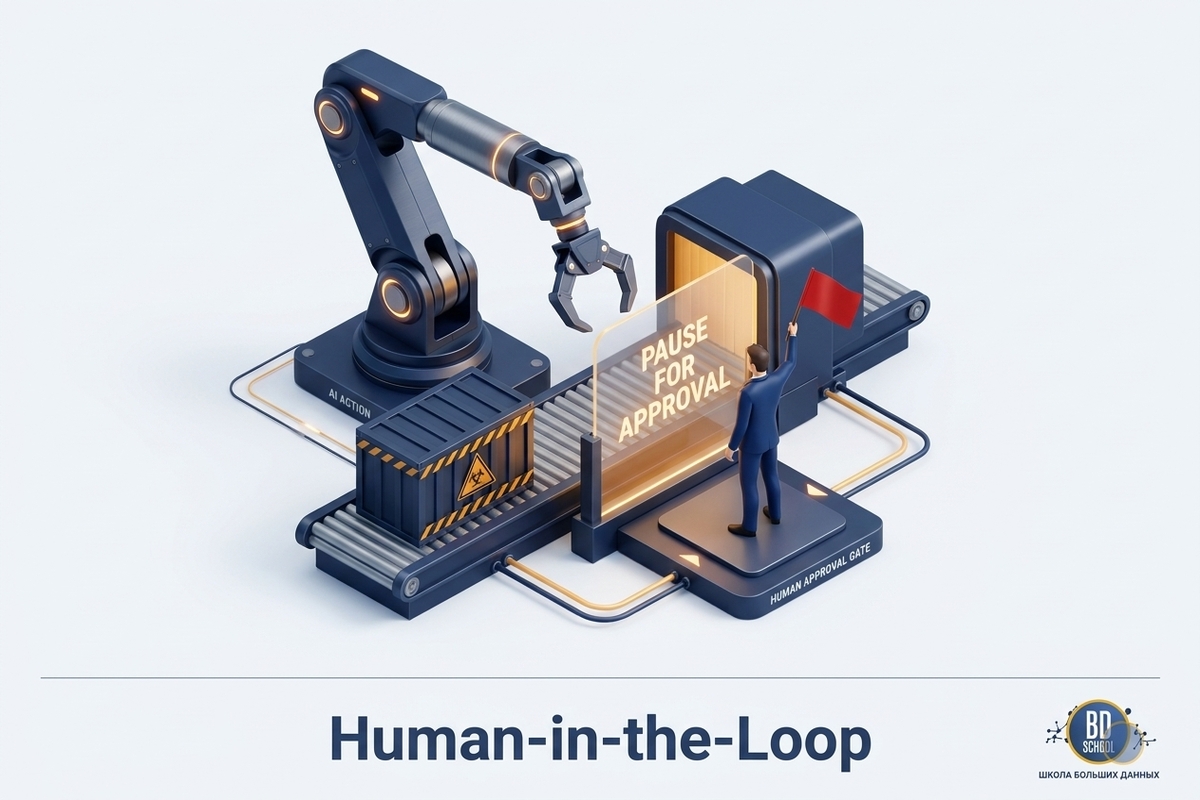
Human-in-the-Loop (HITL) это архитектурный паттерн, при котором автономный ИИ-агент перед рискованным действием останавливается и ждёт решения человека вместо того, чтобы выполнять его без контроля. В LangChain HITL реализован как middleware, которое сверяет каждый вызов инструмента (tool call) с настраиваемой политикой и приостанавливает выполнение агента, если политика требует проверки. AWS...
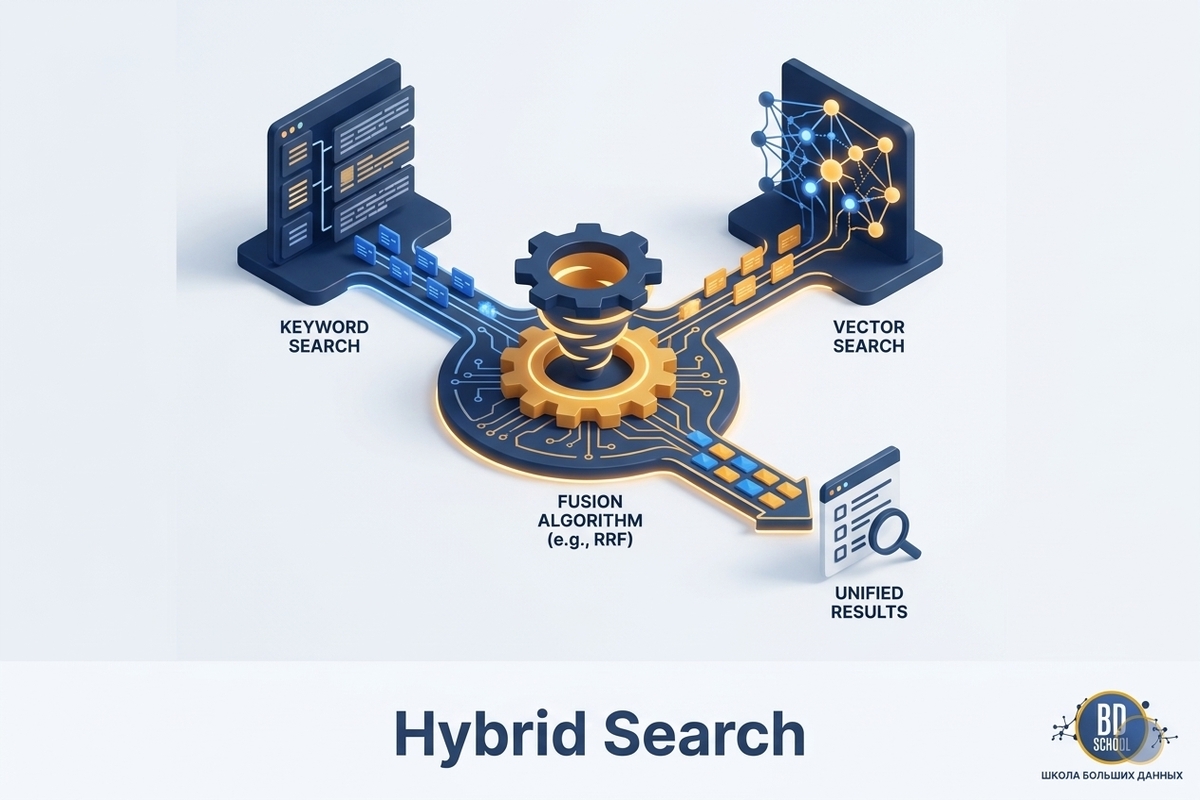
Hybrid search (гибридный поиск) объединяет два независимых способа найти нужный документ, точное совпадение слов и близость по смыслу, и сводит результаты обоих в один список ответом на один и тот же запрос. По отдельности эти методы регулярно ошибаются в разные стороны. Лексический поиск BM25 находит документ по совпадающему термину, но...
Iceberg - это открытый формат таблиц для огромных аналитических наборов данных в озерах данных (Data Lake). По своей сути, Apache Iceberg не является ни системой хранения, ни движком для обработки запросов; это спецификация, которая определяет, как организовать файлы данных (например, Parquet, Avro, ORC) и метаданные, чтобы обеспечить функциональность, присущую традиционным...
Impala – это массив-параллельный механизм интерактивного выполнения SQL-запросов к данным, хранящимся в Apache Hadoop (HDFS и HBase), написанный на языке С++ и распространяющийся по лицензии Apache 2.0. Также Импала называют MPP-движком (Massively Parallel Processing), распределенной СУБД и даже базой данных стека SQL-on-Hadoop. Как появился Apache Impala и чем это связано...
Internet of Things (Интернет вещей) означает сеть физических или виртуальных предметов (вещей) подключенных напрямую или опосредованно к интернету и взаимодействующие между собой и/или с внешней средой посредством сбора данных и обмена данных поступающих со встроенных сервисов. Интернет вещей (IoT) дает компаниям и организациям возможность контролировать удаленно расположенные «дешевые» вещи /объекты ...
IPython (Interactive Python) - это продвинутая интерактивная командная оболочка для языка Python, которая превращает процесс кодинга из монотонного ввода текста в динамическое исследование данных. В мире Big Data и Data Science стандартного интерпретатора Python (python.exe или просто python в терминале) часто недостаточно. Он аскетичен, не запоминает контекст и...