
Kubernetes (K8s) – это программное обеспечение для автоматизации развёртывания, масштабирования и управления контейнеризированными приложениями. Поддерживает основные технологии контейнеризации (Docker, Rocket) и аппаратную виртуализацию [1]. Зачем нужен Kubernetes Kubernetes необходим для непрерывной интеграции и поставки программного обеспечения (CI/CD, Continuos Integration/ Continuos Delivery), что соответствует DevOps-подходу. Благодаря «упаковке» программного окружения в контейнер,...
Kudu – это колоночное хранилище данных в экосистеме Apache Hadoop, нереляционная СУБД (NoSQL) с открытым исходным кодом от компании Cloudera для оперативной аналитики быстро меняющихся данных в режиме реального времени. Назначение, история разработки и развития Основное назначение Apache Kudu состоит в заполнении аналитического разрыва между 2-мя движками хранения данных Apache...
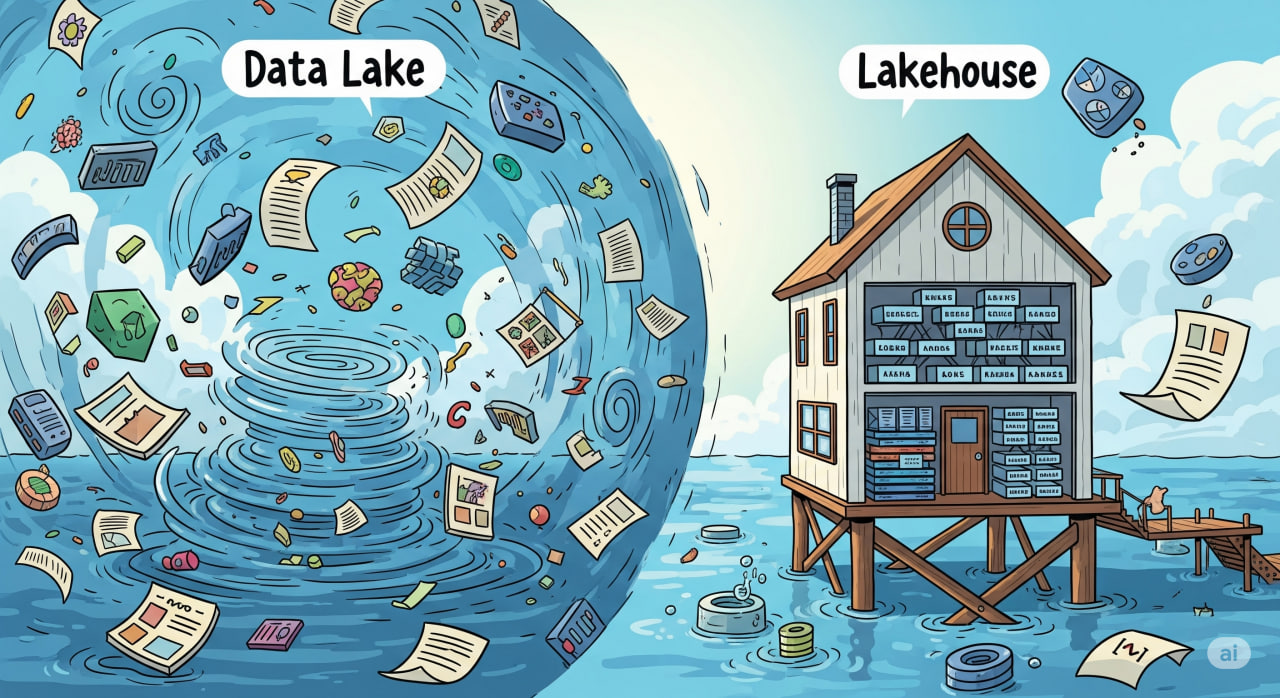
Lakehouse - это архитектурный подход к хранению и обработке данных, который объединяет гибкость Data Lake и надёжность Data Warehouse, обеспечивая единый слой для аналитики, машинного обучения и управления данными без дублирования. Архитектура Data LakeHouse представляет собой современный подход к управлению данными. Она объединяет лучшие характеристики озер данных (Data Lakes) и корпоративных...
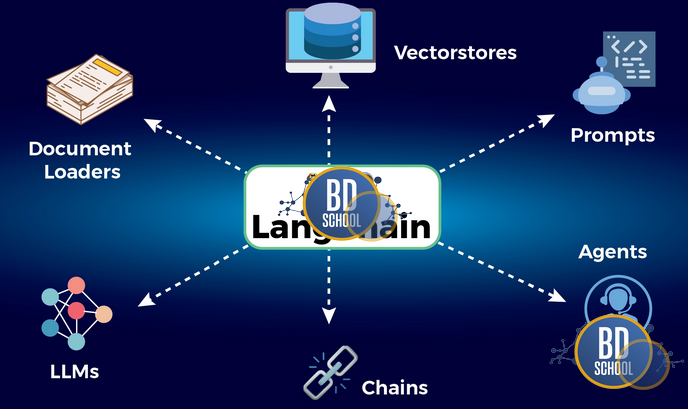
LangChain — это фреймворк с открытым исходным кодом для разработки приложений на базе больших языковых моделей (LLM). Его главная цель — решить фундаментальную проблему изолированности LLM. По умолчанию языковые модели, такие как GPT или Claude, ограничены статичными данными своего обучения. Они не могут получать актуальную информацию из интернета...

LangGraph это фреймворк для приложений и ИИ-агентов на базе больших языковых моделей (large language model, LLM), в котором процесс выполнения описан как граф состояний и переходов. Узлы графа выполняют работу, рёбра решают, куда идти дальше, а общее состояние живёт между шагами и переживает перезапуск процесса. Такой подход нужен там,...
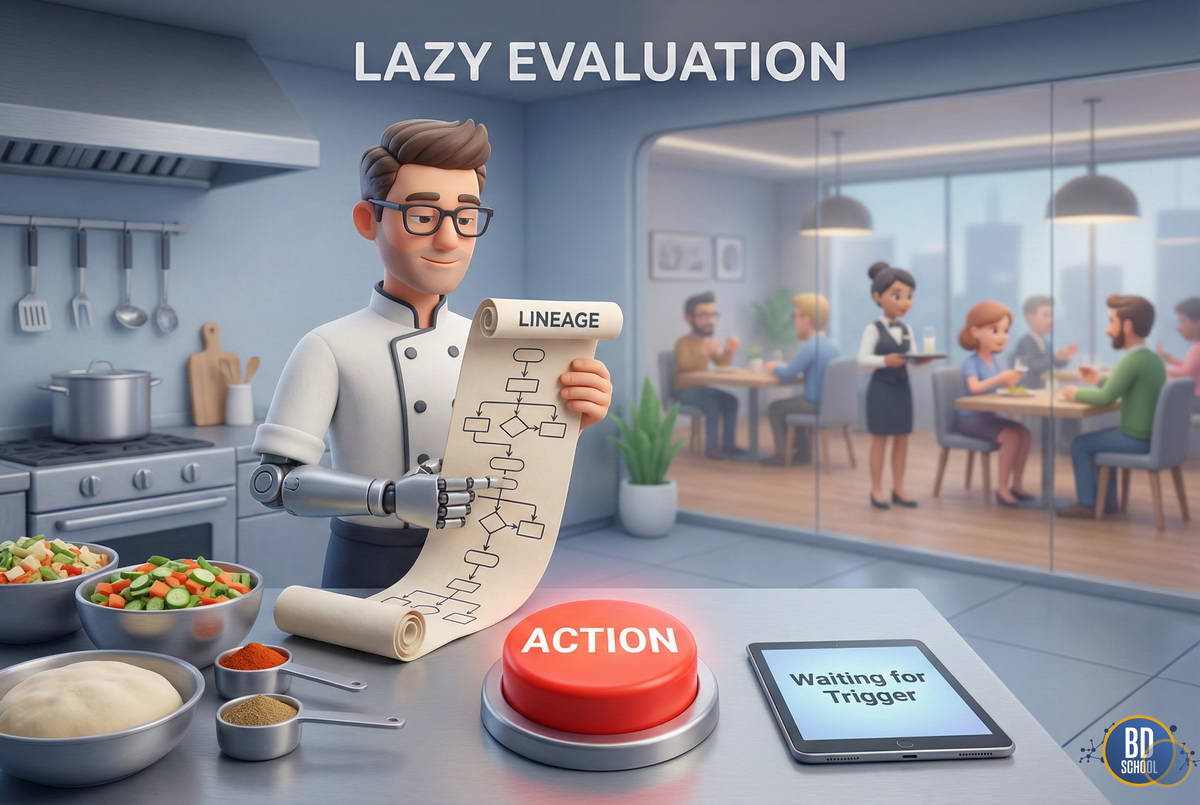
Lazy Evaluation (Ленивые вычисления) - это стратегия выполнения программного кода, при которой запуск вычислений откладывается до тех пор, пока их результат не потребуется явно (например, для вывода на экран или сохранения на диск). В экосистеме Big Data (в частности, в Apache Spark) этот подход является фундаментальным: он позволяет...
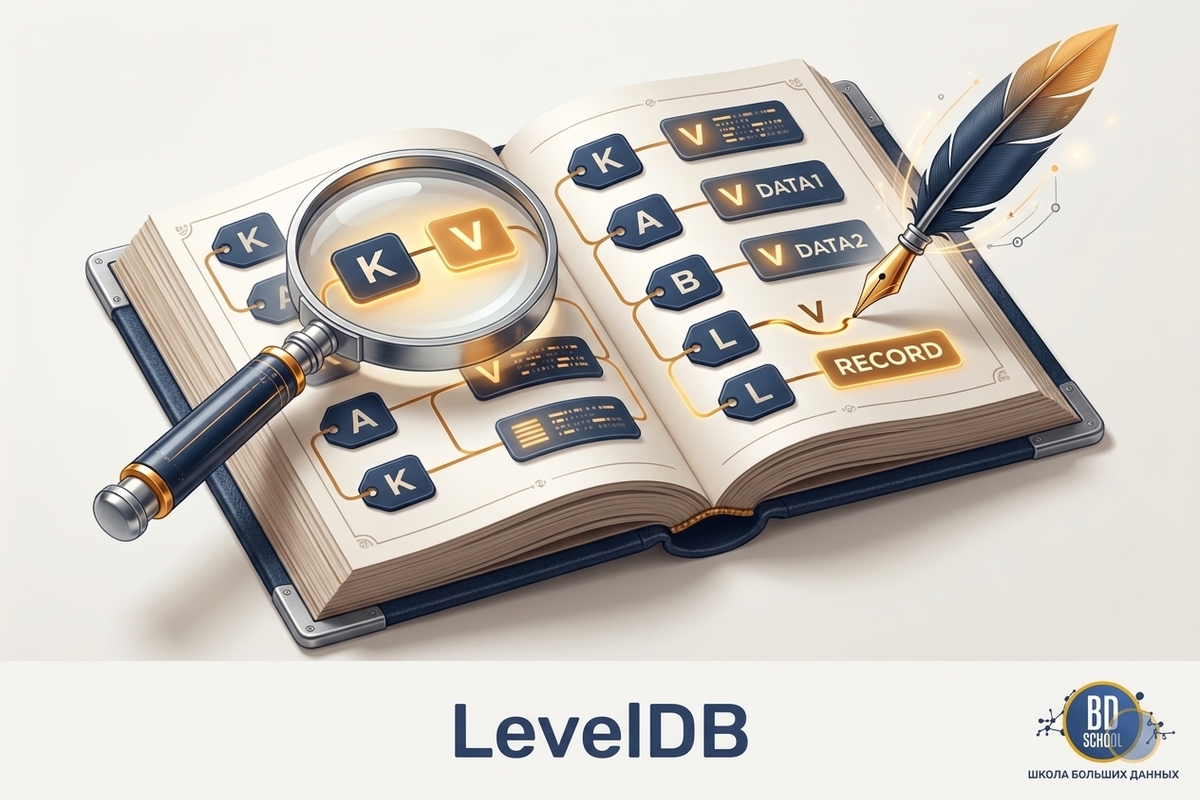
LevelDB - это встраиваемая (embedded) key-value библиотека на основе LSM-дерева (Log-Structured Merge-tree), которую в Google написали Sanjay Ghemawat и Jeff Dean (Санджай Гемават и Джефф Дин) для быстрого упорядоченного хранения пар ключ-значение внутри одного процесса. У LevelDB нет сервера и сетевого протокола, она подключается к приложению как обычная библиотека...
LLAMA (Large Language Model Meta AI) — это семейство больших языковых моделей, созданное компанией Meta AI. Эти модели являются фундаментальной технологией в области искусственного интеллекта. Они предназначены для понимания и генерации текста, похожего на человеческий. Ключевой особенностью LLAMA стал её открытый подход. Meta предоставила доступ к весам моделей...
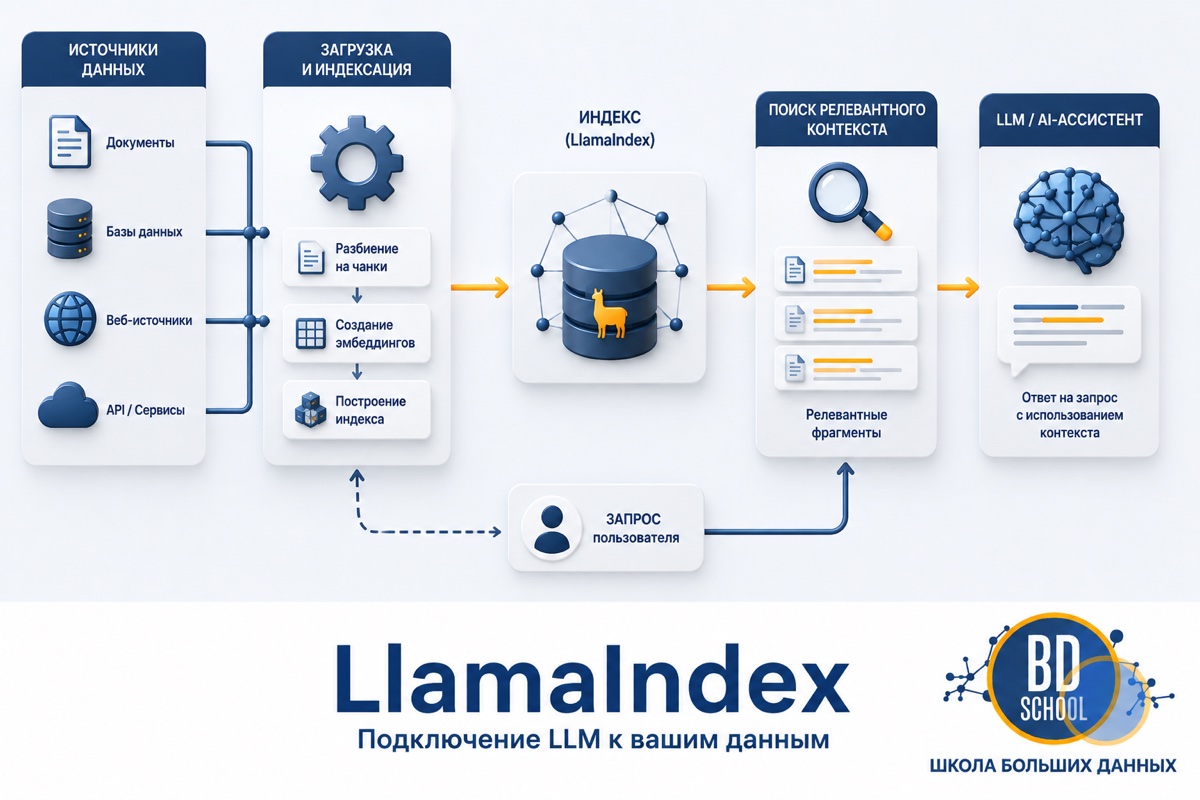
LlamaIndex - это фреймворк с открытым исходным кодом на Python, который подключает приватные и корпоративные данные к большим языковым моделям (LLM, Large Language Model). Задача LlamaIndex простая на словах и сложная на практике, потому что модель ничего не знает о внутренних документах компании, и фреймворк берёт на себя загрузку,...
LLM (Large Language Model) — это тип системы искусственного интеллекта (ИИ), обученный на огромных объемах текстовых данных для понимания, генерации и прогнозирования человеческого языка с высокой точностью. Эти модели являются основой для множества современных приложений. Они могут писать эссе, переводить языки, отвечать на вопросы и даже создавать программный код. По...
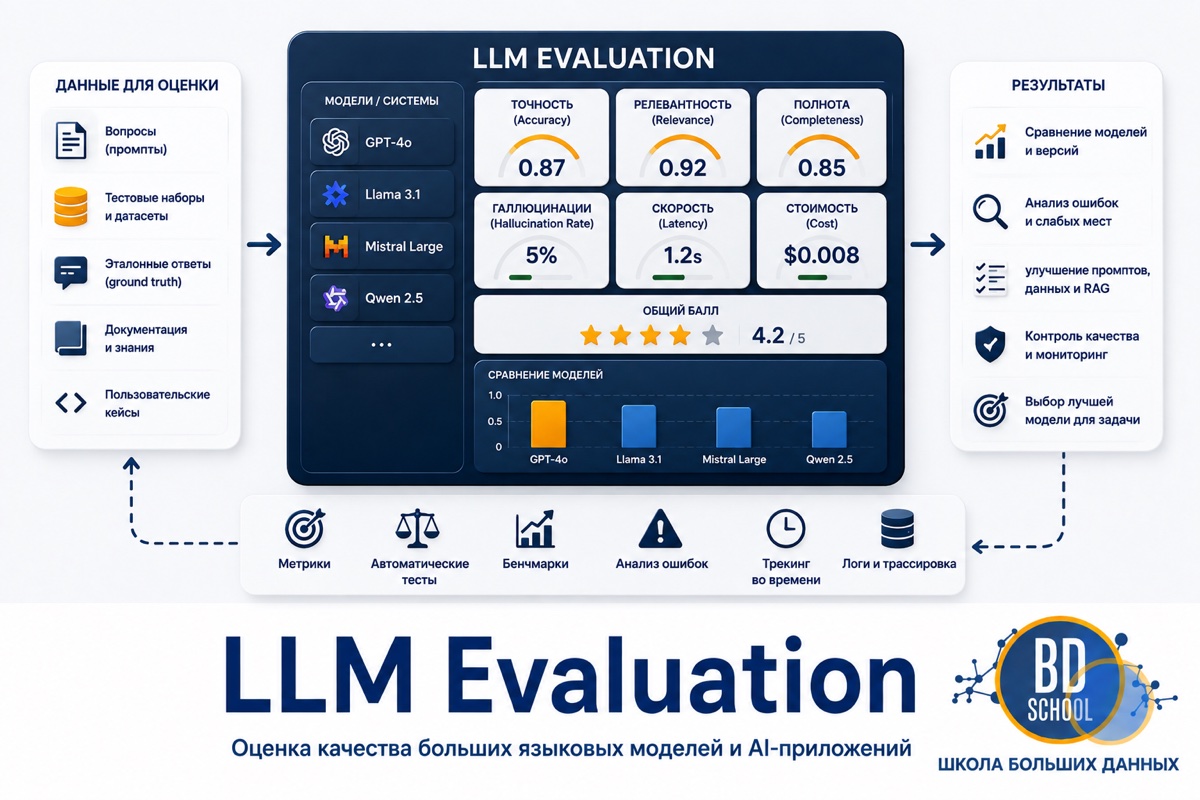
LLM Evaluation (Оценка качества LLM) это систематическая проверка ответов большой языковой модели (large language model, LLM) по заранее заданным критериям вместо разового просмотра результатов на глаз. Задача возникает из самой природы генеративной модели, потому что один и тот же промпт может дать разные по формулировке, но одинаково верные ответы,...
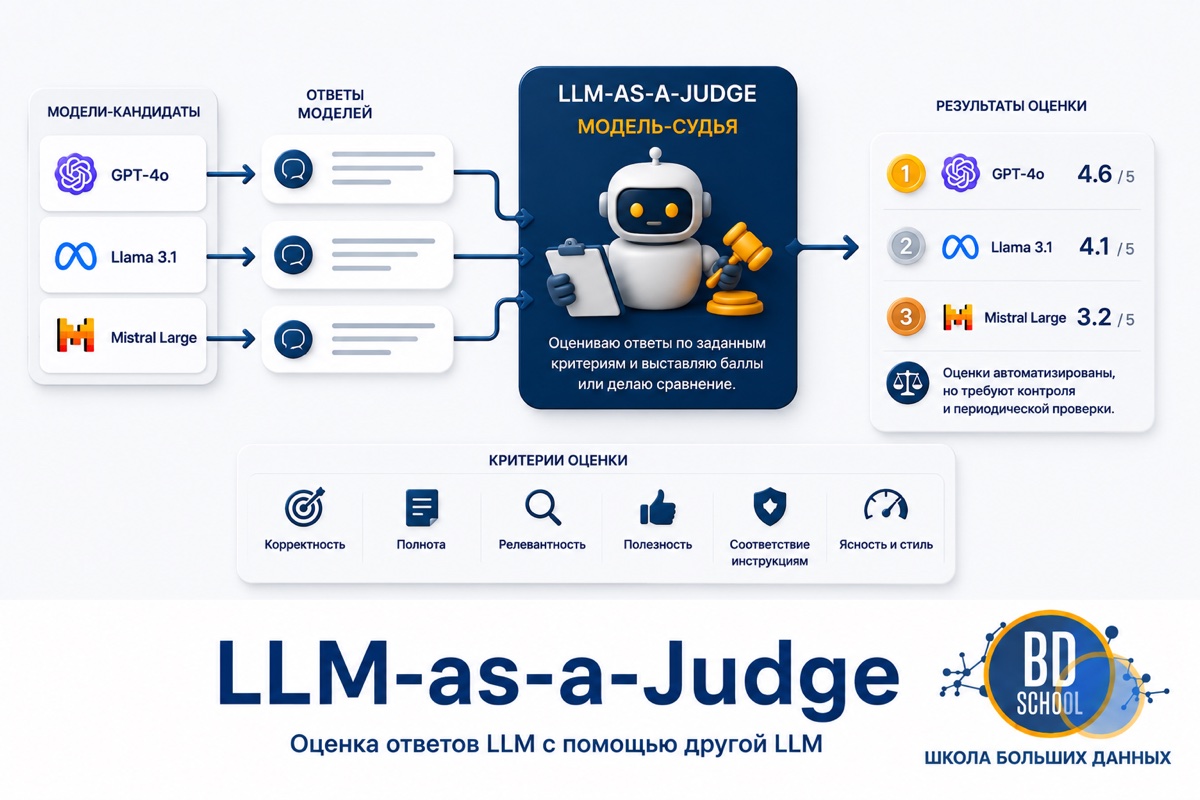
LLM-as-a-Judge, дословно «модель в роли судьи», это метод автоматизированной оценки ответов больших языковых моделей (large language model, LLM), при котором роль критика берёт на себя другая LLM, а не человек-эксперт и не классическая метрика вроде BLEU или ROUGE. Судья получает вопрос, ответ кандидата и явную рубрику критериев, а на...

LLMOps (Large Language Model Operations) это набор практик и инструментов для разработки, тестирования, развёртывания, мониторинга и сопровождения приложений на основе больших языковых моделей. Подход вырос из MLOps и добавил к нему то, чего в классической эксплуатации ML-моделей не было: управление промптами, поиском по документам, контекстом, ИИ-агентами, стоимостью запросов и...
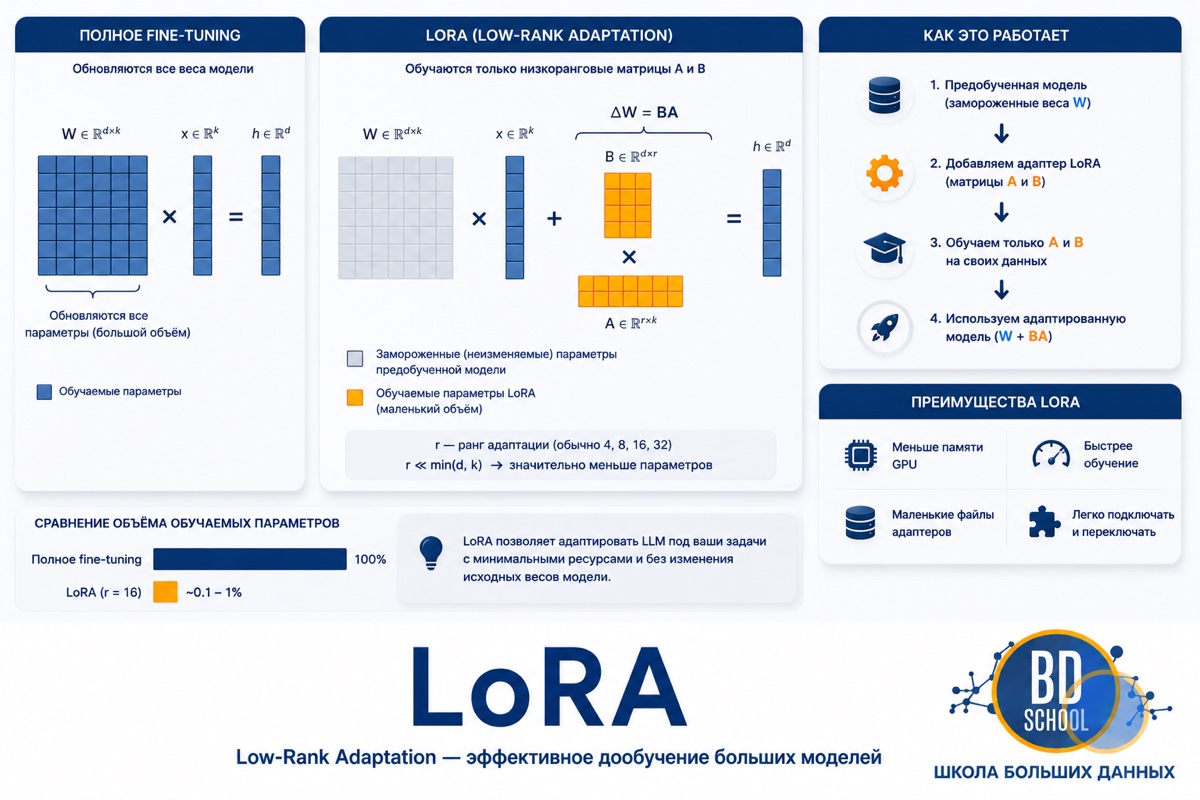
LoRA (Low-Rank Adaptation, низкоранговая адаптация) - способ дообучить большую языковую модель, не трогая её исходные веса, а обучая вместо этого лишь пару маленьких низкоранговых матриц поверх них. Что такое LoRA Идею предложила команда Microsoft Research в статье «LoRA - Low-Rank Adaptation of Large Language Models», Edward J. Hu...
Low Code - это подход к созданию программного обеспечения, который позволяет разрабатывать приложения с минимальным объемом ручного кодирования. Вместо написания тысяч строк кода на языках программирования, Low Code платформы предлагают "визуальный конструктор". Вы "собираете" приложение из готовых блоков, модулей и шаблонов в графическом интерфейсе, используя технологию Drag-and-drop...
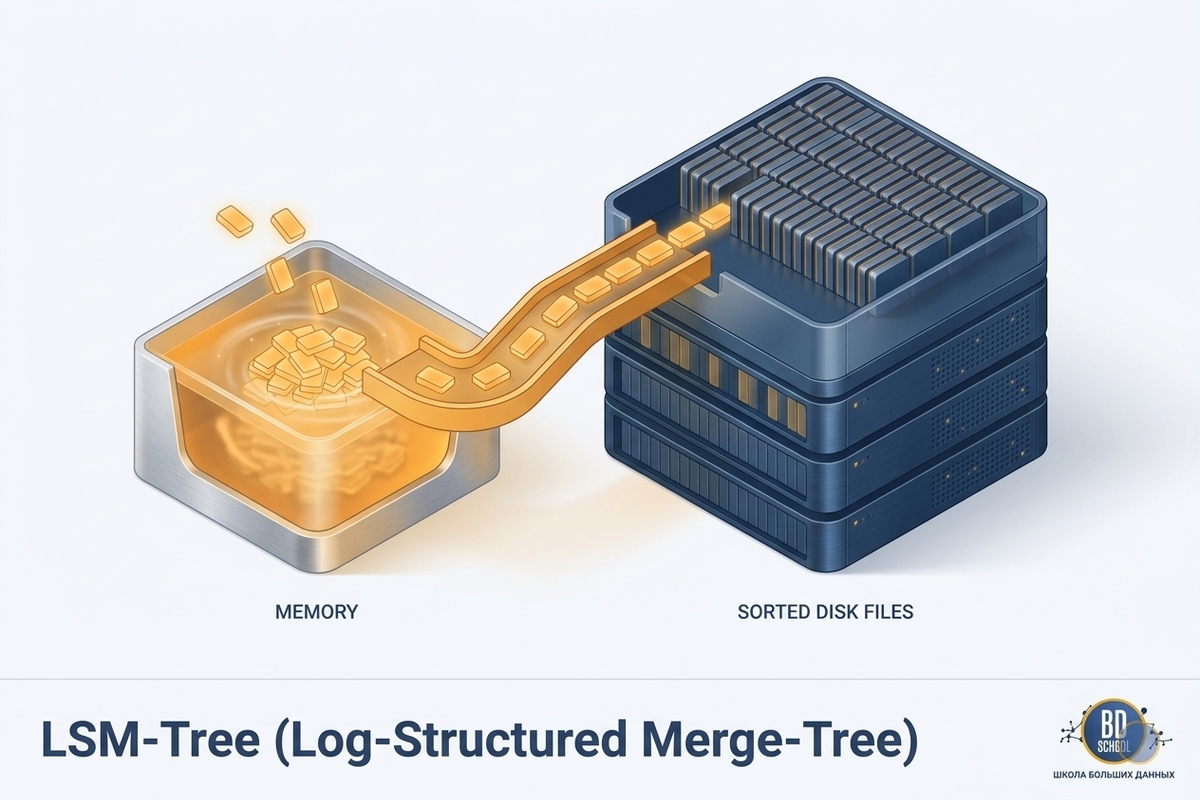
LSM дерево (LSM-tree) это структура данных для хранения пар ключ-значение, в которой новые записи сначала копятся в памяти, а на диск попадают уже отсортированными неизменяемыми файлами вместо изменения данных на месте. Расшифровывается название как Log-Structured Merge-Tree, термин восходит к статье Patrick E. O'Neil, Edward Cheng, Dieter Gawlick и Elizabeth...
LTV (Lifetime Value) — это совокупная прибыль компании, получаемая от одного клиента за все время сотрудничества с ним. Увеличивается при уменьшении уровня оттока клиентов (Churn Rate). Каждая компания стремится увеличить LTV, удерживая клиента с помощью различных мер повышения лояльности (скидки, акции, подарки и пр.), т.к. привлечение нового пользователя обходится в 8-10...
Machine learning - множество математических, статистических и вычислительных методов для разработки алгоритмов, способных решить задачу не прямым способом, а на основе поиска закономерностей в разнообразных входных данных. Что такое Machine Learning Общий термин «Machine Learning» или «машинное обучение» обозначает множество математических, статистических и вычислительных методов для разработки алгоритмов, способных решить...
Make, широко известный под своим предыдущим названием Integromat, — это мощная Low-Code платформа для автоматизации рабочих процессов, которая позволяет визуально проектировать, создавать и автоматизировать интеграции между тысячами веб-приложений. Make относится к классу iPaaS (Integration Platform as a Service), но его фундаментальное отличие от многих аналогов заключается в уникальном визуальном...
MapR Convergent Data Platform (MapRCDP) — дистрибутив Apache Hadoop с набором программ, библиотек и утилит Apache Software Foundation, а также средств собственной разработки американской компании MapR для больших данных (Big Data) и машинного обучения (Machine Learning) [1]. Существует три версии MapRCDP: Community Edition (M3) - бесплатная версия сообщества; Enterprise Edition...