 43
Содержание
- Что такое LoRA
- Архитектура и ключевые компоненты LoRA
- Формула масштабирования и rank-stabilized LoRA (rsLoRA)
- Принцип работы под капотом
- Семейство методов PEFT вокруг LoRA
- Выбор ранга - компромисс параметров и качества
- Сценарии использования и когда LoRA не подходит
- Практика - обучение, ранговая абляция и слияние адаптера
- Заключение
- Референсные ссылки
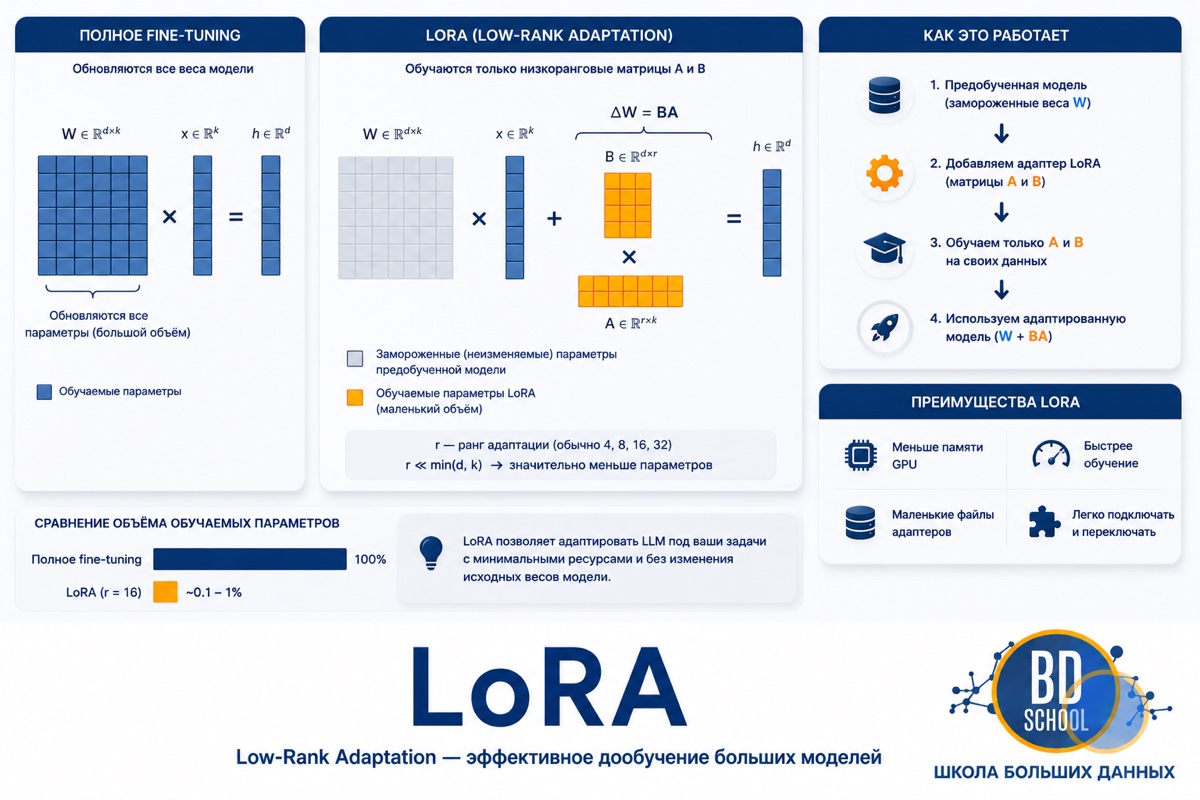
LoRA (Low-Rank Adaptation, низкоранговая адаптация) — способ дообучить большую языковую модель, не трогая её исходные веса, а обучая вместо этого лишь пару маленьких низкоранговых матриц поверх них.
Что такое LoRA
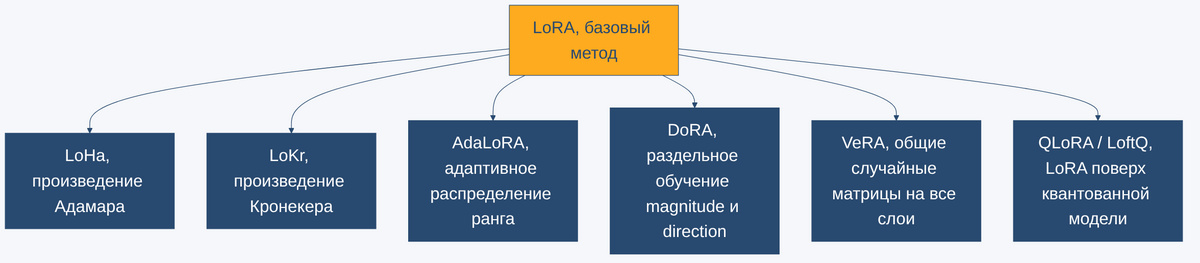
Идею предложила команда Microsoft Research в статье «LoRA — Low-Rank Adaptation of Large Language Models», Edward J. Hu (Эдвард Ху) с соавторами, опубликованной 17 июня 2021 года на arXiv под номером arXiv:2106.09685 и принятой на конференции ICLR 2022. На момент публикации это была одна конкретная техника, а именно заморозить веса предобученной модели и добавить к её attention-слоям обучаемую дельту в виде произведения двух малых матриц. Сегодня в официальной документации PEFT (Hugging Face) LoRA описана уже не как отдельный метод, а как базовый представитель целого семейства low-rank и adapter-техник — LoHa, LoKr, AdaLoRA, DoRA, VeRA и ещё больше двадцати вариантов перечислены как родственные или производные подходы.
LoRA относится к семейству PEFT (Parameter-Efficient Fine-Tuning, параметр-эффективное дообучение) — методов, которые обновляют небольшую долю параметров модели вместо полного дообучения. Механика самого обучения при этом не меняется, та же обратная связь через градиенты и оптимизатор, о которой рассказывает курс «Нейронные сети на Python», только градиент считается для маленькой части весов, а не для всей сети.
Архитектура и ключевые компоненты LoRA
В основе LoRA лежит простое наблюдение авторов статьи — при дообучении матрица изменений весов ΔW часто имеет низкий эффективный ранг, то есть её можно приближённо представить произведением двух гораздо меньших матриц. Это наблюдение и определяет всю архитектуру метода.
У связки LoraConfig и PeftModel из библиотеки PEFT несколько ключевых частей.
- Базовая модель с замороженными весами. Веса предобученной сети не обновляются во время дообучения, поэтому один и тот же чекпоинт можно переиспользовать под разные адаптеры.
- Пара обучаемых матриц A и B. Они добавляются параллельной низкоранговой веткой к целевым слоям и содержат почти все обучаемые параметры адаптера.
- target_modules. Список модулей, к которым применяется LoRA, обычно проекции внимания query, key, value и output (в коде демо ниже это q_proj, k_proj, v_proj, o_proj).
- LoraConfig. Объект конфигурации адаптера с параметрами ранга r, коэффициента масштабирования lora_alpha, target_modules, modules_to_save и других настроек.
- PeftModel. Обёртка над базовой моделью, которую создаёт функция get_peft_model() и через которую идёт обучение и сохранение адаптера.
Вместе эти части описывают ровно то, что нужно для сборки одного адаптера: где его веса, к каким слоям он подключён и как его обучать и сохранять. Отдельно от списка стоит modules_to_save — параметр LoraConfig, который помечает слои вне LoRA (например, кастомную голову классификатора), обучаемыми и сохраняемыми целиком, а не низкоранговой поправкой.
Формула масштабирования и rank-stabilized LoRA (rsLoRA)
Выход слоя с LoRA складывается из выхода замороженного слоя и масштабированного выхода низкоранговой ветки, формула такая — h = Wx + scale·(B·A)x, где scale зависит от alpha и ранга r. Классическая формула берёт scale = alpha / r, поэтому увеличение ранга при неизменном alpha ослабляет вклад адаптера в выход.
Более новый режим rank-stabilized LoRA (rsLoRA) меняет масштаб на scale = alpha / sqrt(r) и включается параметром use_rslora в LoraConfig. Документация PEFT называет rsLoRA предпочтительным вариантом для рангов заметно выше типичных значений, потому что классическая формула на больших r делает вклад адаптера слишком слабым и обучение идёт хуже.
Принцип работы под капотом
При инициализации адаптера матрица A заполняется случайными числами по схеме Kaiming-uniform, а матрица B заполняется нулями. Из-за этого в самом начале обучения произведение B·A равно нулю, и адаптер не меняет поведение модели ни на йоту — обучение стартует с тождественного преобразования, а не со случайного шума поверх весов.
Дальше при каждом forward-проходе слой считает выход базовой замороженной матрицы W и параллельно выход низкоранговой ветки, складывает их и передаёт результат дальше. Оба вычисления идут независимо, поэтому неслитый адаптер добавляет вычислительный оверхед на каждом целевом слое — лишний матричный проход, которого не было бы у исходной модели.
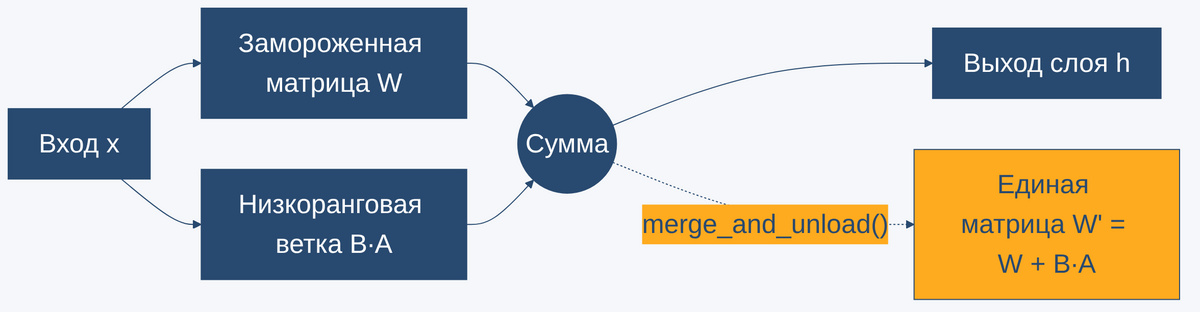
После обучения адаптер можно слить с базовой моделью методом merge_and_unload(). Он один раз складывает B·A с исходной матрицей и возвращает обычную модель без обвязки PEFT — дальше это просто более быстрый forward той же архитектуры, без отдельного прохода по низкоранговой ветке. Для сценариев, где слияние должно быть обратимым, в PEFT есть отдельная пара merge_adapter() и unmerge_adapter(), а для комбинирования нескольких обученных адаптеров с разными весами — метод add_weighted_adapter().
Отдельно в PEFT есть альтернативная инициализация LoftQ, которая минимизирует ошибку квантования и рассчитана на сценарий, где LoRA обучается поверх уже квантованной базовой модели — это тот же принцип, что лежит в основе связки QLoRA.
Семейство методов PEFT вокруг LoRA
Изначально LoRA была одной конкретной техникой, но документация PEFT давно описывает её как отправную точку для целого класса low-rank и adapter-методов. Часть из них меняет саму математику низкорангового представления, часть комбинирует LoRA с квантованием.
| Метод | Что меняет относительно классической LoRA |
|---|---|
| LoHa | Заменяет произведение матриц на произведение Адамара (Hadamard), увеличивая выразительность адаптера при том же числе параметров |
| LoKr | Строит дельту весов через произведение Кронекера вместо прямого матричного произведения |
| AdaLoRA | Динамически перераспределяет ранг между слоями во время обучения вместо фиксированного r для всех слоёв |
| DoRA | Разделяет веса на величину (magnitude) и направление (direction), обучая их раздельно поверх низкорангового обновления |
| VeRA | Делит одну пару случайных матриц на все слои и обучает только маленькие векторы масштабирования, урезая число параметров ещё сильнее |
| QLoRA / LoftQ | Обучает LoRA-адаптер поверх квантованной базовой модели, LoftQ дополнительно подбирает инициализацию под ошибку квантования |
Общая идея у всех методов одна — сохранить low-rank-адаптер, который дёшево обучать и хранить, но по-разному распределить бюджет параметров.
Выбор ранга — компромисс параметров и качества
Ранг r напрямую определяет, сколько обучаемых параметров получает адаптер и сколько места он займёт на диске. Ниже ранговая абляция на Qwen2.5-0.5B-Instruct, один и тот же набор target_modules (q_proj, k_proj, v_proj, o_proj), три значения ранга, alpha держится равной 2·r, чтобы масштаб alpha/r был одинаковым и сравнение зависело только от формы матриц.
| Ранг r | Обучаемых параметров | Доля от всех параметров модели | Размер адаптера на диске |
|---|---|---|---|
| 4 | 540,672 | 0.1093% | 2.1M |
| 8 | 1,081,344 | 0.2184% | 4.2M |
| 32 | 4,325,376 | 0.8679% | 17M |
Рост ровно пропорционален рангу — переход от r=4 к r=32 увеличивает и число параметров, и размер адаптера в 8 раз, без скачков и побочных эффектов. Это значит, что ранг работает как прямой рычаг между экономией и ёмкостью адаптера, без скрытых нелинейностей. Маленький ранг почти ничего не весит, но и переносит меньше информации о задаче, большой ранг приближается по гибкости к полному дообучению, но теряет часть выгоды LoRA в параметрах и памяти.
Сценарии использования и когда LoRA не подходит
Документация PEFT перечисляет LoRA прежде всего как способ дообучать большие языковые модели, но метод устроен универсально и применяется и вне LLM — официальные гайды разбирают LoRA поверх vision-моделей для классификации изображений, для семантической сегментации и для Dreambooth-файнтюнинга диффузионных моделей.
Главное практическое преимущество из документации в том, что заморозка базовых весов позволяет держать один базовый чекпоинт и переключать между собой множество лёгких LoRA-адаптеров под разные задачи, а также комбинировать LoRA с другими PEFT-методами — в документации это называют «ортогональностью» LoRA другим техникам.
Официальная документация PEFT не даёт отдельного раздела с явными «не рекомендуется» сценариями для LoRA, это стоит сказать прямо, а не додумывать за источник. Из механики метода при этом следуют разумные границы применимости. Низкоранговая поправка ΔW = B·A по построению беднее, чем полный набор весов, поэтому там, где нужен полный сдвиг возможностей модели, например смена языка генерации или радикально новый домен знаний, одной LoRA-адаптации может не хватить и потребуется более тяжёлое дообучение или обучение с нуля. На маленьких моделях, как в демо ниже, выигрыш от экономии параметров тоже частично съедается тем, что сама модель и так дёшева в полном дообучении.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Практика — обучение, ранговая абляция и слияние адаптера
Демо ниже прогнано локально на macOS (Apple Silicon, ускоритель MPS) с torch 2.13.0, transformers 5.15.1 и peft 0.20.0, базовая модель — Qwen2.5-0.5B-Instruct. Видеокарта NVIDIA не нужна, на модели такого масштаба всё считается на MPS или на CPU.
Первый скрипт трижды с нуля вешает на модель свежий LoRA-адаптер — с рангом 4, 8 и 32 на одних и тех же слоях внимания. Обучения тут нет — форма и размер LoRA-матриц зависят только от ранга и размерности слоя, а не от того, обучены веса или только что инициализированы, поэтому сравнить размер адаптеров можно и без прогона обучения.
# torch 2.13.0, transformers 5.15.1, peft 0.20.0, Qwen2.5-0.5B-Instruct,
# прогнано на macOS 26.5.2 (Apple Silicon, MPS) 2026-08-30
"""Ранговая абляция LoRA: как параметр r влияет на число обучаемых параметров
и на размер адаптера на диске.

Для трёх значений ранга (4, 8, 32) на одних и тех же target_modules собирается
свежий адаптер поверх базовой модели. Обучения тут нет - размер и число
параметров у LoRA-матриц зависят только от их формы (r и размерность слоя),
а не от того, обучены веса или только что инициализированы. Это позволяет
увидеть компромисс параметров сразу, без прогона обучения под каждый ранг.
"""

import os
import shutil
import subprocess

import torch
from peft import LoraConfig, get_peft_model
from transformers import AutoModelForCausalLM, AutoTokenizer

BASE_MODEL = "Qwen/Qwen2.5-0.5B-Instruct"
TARGET_MODULES = ["q_proj", "k_proj", "v_proj", "o_proj"]
RANKS = [4, 8, 32]
OUT_DIR = "rank_adapters"


def adapter_dir_size(path):
    result = subprocess.run(["du", "-sh", path], capture_output=True, text=True)
    return result.stdout.split()[0]


def main():
    device = "mps" if torch.backends.mps.is_available() else "cpu"
    print(f"устройство: {device}, torch {torch.__version__}")

    tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)

    if os.path.isdir(OUT_DIR):
        shutil.rmtree(OUT_DIR)
    os.makedirs(OUT_DIR)

    rows = []
    for r in RANKS:
        # Модель грузится заново на каждый ранг: одна и та же модель не может
        # нести два непересекающихся набора LoRA-матриц без явного переключения
        # адаптеров, а свежая загрузка на модели такого размера дёшева.
        model = AutoModelForCausalLM.from_pretrained(BASE_MODEL, dtype=torch.float32).to(device)

        # alpha держим равной 2*r, чтобы масштаб (alpha/r) был одинаковым для
        # всех рангов и абляция сравнивала только форму матриц, а не масштаб.
        config = LoraConfig(
            r=r,
            lora_alpha=2 * r,
            target_modules=TARGET_MODULES,
            task_type="CAUSAL_LM",
        )
        peft_model = get_peft_model(model, config)

        trainable = sum(p.numel() for p in peft_model.parameters() if p.requires_grad)
        total = sum(p.numel() for p in peft_model.parameters())

        adapter_path = os.path.join(OUT_DIR, f"r{r}")
        peft_model.save_pretrained(adapter_path)
        size_on_disk = adapter_dir_size(adapter_path)

        rows.append((r, trainable, 100 * trainable / total, size_on_disk))
        print(f"r={r:>2}: обучаемых параметров {trainable:>9,} "
              f"({100 * trainable / total:.4f}% от {total:,}), адаптер на диске {size_on_disk}")

        del model, peft_model

    print("\nсводка (ранг -> обучаемые параметры -> доля -> размер на диске):")
    for r, trainable, share, size_on_disk in rows:
        print(f"  r={r:>2}: {trainable:>9,} параметров, {share:.4f}%, {size_on_disk}")

    base_to_top = rows[-1][1] / rows[0][1]
    print(f"\nразница параметров между r={RANKS[0]} и r={RANKS[-1]}: {base_to_top:.1f}x")


if __name__ == "__main__":
    main()
устройство: mps, torch 2.13.0
r= 4: обучаемых параметров   540,672 (0.1093% от 494,573,440), адаптер на диске 2.1M
r= 8: обучаемых параметров 1,081,344 (0.2184% от 495,114,112), адаптер на диске 4.2M
r=32: обучаемых параметров 4,325,376 (0.8679% от 498,358,144), адаптер на диске 17M

сводка (ранг -> обучаемые параметры -> доля -> размер на диске):
  r= 4:   540,672 параметров, 0.1093%, 2.1M
  r= 8: 1,081,344 параметров, 0.2184%, 4.2M
  r=32: 4,325,376 параметров, 0.8679%, 17M

разница параметров между r=4 и r=32: 8.0x
Второй скрипт идёт дальше — обучает один адаптер ранга 8 и сравнивает задержку генерации до и после слияния через merge_and_unload(). Обучение короткое и без completion-only маскирования, цель тут не качество ответа, а получить адаптер с реально изменившимися весами, чтобы слияние было не косметическим.
# torch 2.13.0, transformers 5.15.1, peft 0.20.0, Qwen2.5-0.5B-Instruct,
# прогнано на macOS 26.5.2 (Apple Silicon, MPS) 2026-08-30
"""Задержка инференса до и после merge_and_unload().

Пока адаптер не слит, каждый forward-проход считает выход базового слоя и
отдельно выход низкоранговой ветки B·A, а потом складывает их - это лишние
операции на каждом из целевых слоёв. merge_and_unload() один раз складывает
B·A с исходной матрицей (W' = W + B·A) и возвращает обычную модель без
LoRA-обвязки: дальше это просто более быстрый forward той же архитектуры.

Обучение здесь короткое и без completion-only маскирования - цель не качество
ответа, а получить адаптер с реально изменившимися (не нулевыми) весами, чтобы
слияние было не косметическим.
"""

import time

import torch
from peft import LoraConfig, get_peft_model
from torch.optim import AdamW
from transformers import AutoModelForCausalLM, AutoTokenizer

BASE_MODEL = "Qwen/Qwen2.5-0.5B-Instruct"
EPOCHS = 5
GENERATE_REPEATS = 10

TRAIN_PAIRS = [
    ("Что такое LoRA?", "LoRA обучает две низкоранговые матрицы поверх замороженных весов вместо всей модели."),
    ("Что такое PEFT?", "PEFT - семейство методов дообучения, где обновляется малая доля параметров модели."),
    ("Что такое квантование?", "Квантование переводит веса модели в формат меньшей разрядности ради экономии памяти."),
    ("Что такое эмбеддинг?", "Эмбеддинг - числовой вектор фиксированной длины, кодирующий смысл текста."),
    ("Что такое батч?", "Батч - порция примеров, обрабатываемая за один шаг обучения перед обновлением весов."),
    ("Что такое переобучение?", "Переобучение - состояние модели, когда она запомнила выборку и хуже работает на новых данных."),
    ("Что такое градиентный спуск?", "Градиентный спуск сдвигает веса модели против направления градиента функции потерь."),
    ("Что такое токенизация?", "Токенизация разбивает текст на единицы словаря, которые модель получает вместо символов."),
]


def measure_generate(model, inputs, repeats):
    # Первый вызов на MPS всегда дороже: компиляция ядер и перенос весов
    # в исполняемое состояние. Его результат в замер не идёт.
    with torch.no_grad():
        model.generate(**inputs, max_new_tokens=30, do_sample=False)
    times = []
    for _ in range(repeats):
        started = time.time()
        with torch.no_grad():
            model.generate(**inputs, max_new_tokens=30, do_sample=False)
        times.append(time.time() - started)
    return times


def main():
    device = "mps" if torch.backends.mps.is_available() else "cpu"
    print(f"устройство: {device}, torch {torch.__version__}")

    tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
    model = AutoModelForCausalLM.from_pretrained(BASE_MODEL, dtype=torch.float32).to(device)
    model.config.use_cache = False  # несовместимо с расчётом градиентов при обучении

    config = LoraConfig(
        r=8,
        lora_alpha=16,
        target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
        task_type="CAUSAL_LM",
    )
    peft_model = get_peft_model(model, config)
    peft_model.print_trainable_parameters()

    examples = []
    for question, answer in TRAIN_PAIRS:
        text = f"Вопрос: {question}\nОтвет: {answer}{tokenizer.eos_token}"
        ids = tokenizer(text, return_tensors="pt").input_ids.to(device)
        examples.append(ids)

    optimizer = AdamW([p for p in peft_model.parameters() if p.requires_grad], lr=2e-4)

    peft_model.train()
    started = time.time()
    for epoch in range(EPOCHS):
        epoch_loss = 0.0
        for ids in examples:
            output = peft_model(input_ids=ids, labels=ids)
            output.loss.backward()
            optimizer.step()
            optimizer.zero_grad()
            epoch_loss += output.loss.item()
        print(f"эпоха {epoch + 1}: loss {epoch_loss / len(examples):.4f}")
    print(f"обучение {EPOCHS} эпох на {len(examples)} примерах: {time.time() - started:.1f} с")

    peft_model.eval()
    model.config.use_cache = True  # обратно на инференс: KV-кэш ускоряет генерацию

    prompt = "Вопрос: Что такое дообучение?\nОтвет:"
    inputs = tokenizer(prompt, return_tensors="pt").to(device)

    adapter_times = measure_generate(peft_model, inputs, GENERATE_REPEATS)
    adapter_avg = sum(adapter_times) / len(adapter_times)
    print(f"генерация с адаптером (не слитым): {adapter_avg:.3f} с в среднем по {GENERATE_REPEATS} прогонам")

    merged_model = peft_model.merge_and_unload()
    merged_times = measure_generate(merged_model, inputs, GENERATE_REPEATS)
    merged_avg = sum(merged_times) / len(merged_times)
    print(f"генерация после merge_and_unload: {merged_avg:.3f} с в среднем по {GENERATE_REPEATS} прогонам")

    print(f"ускорение после слияния: {adapter_avg / merged_avg:.2f}x")


if __name__ == "__main__":
    main()
устройство: mps, torch 2.13.0
trainable params: 1,081,344 || all params: 495,114,112 || trainable%: 0.2184
эпоха 1: loss 3.0268
эпоха 2: loss 2.8057
эпоха 3: loss 3.0092
эпоха 4: loss 3.0928
эпоха 5: loss 3.3289
обучение 5 эпох на 8 примерах: 7.1 с
генерация с адаптером (не слитым): 1.859 с в среднем по 10 прогонам
генерация после merge_and_unload: 1.811 с в среднем по 10 прогонам
ускорение после слияния: 1.03x
Loss по эпохам не падает монотонно (3.03 -> 2.81 -> 3.01 -> 3.09 -> 3.33) — на восьми примерах и пяти эпохах это ожидаемый шум, а не признак сломанного обучения: адаптер в этом прогоне нужен не ради качества ответа, а ради ненулевых весов, которые можно слить и замерить задержку до и после.
Ускорение всего 1.03x — на первый взгляд разочаровывающий результат для техники, которая должна убирать лишний матричный проход. Причина в масштабе — модель на 0.5 млрд параметров генерирует токен за токеном с уже включённым KV-кэшем, и основное время съедает сама авторегрессивная генерация, а не дополнительный проход по низкоранговой ветке адаптера. На модели крупнее или при пакетном (batched) инференсе эффект merge_and_unload() будет заметнее, а здесь честный вывод в том, что для маленьких моделей выигрыш в задержке не главная причина сливать адаптер, куда важнее получить обычную модель без обвязки PEFT для последующего деплоя.
Заключение
LoRA показала, что дообучение большой модели не обязано трогать все её веса — для многих задач достаточно найти низкоранговую поправку и обучить только её. За пять с лишним лет с публикации статьи это наблюдение превратилось в целое семейство методов PEFT, от LoHa и AdaLoRA до связки с квантованием в QLoRA, а ранг r остался главным рычагом, которым разработчик балансирует между размером адаптера и его ёмкостью.
Управлять таким набором адаптеров и версиями дообученных моделей в проде — отдельная задача жизненного цикла, о которой рассказывает статья «Как LLMOps расширяет MLOps». LoRA-адаптер снижает цену эксперимента, но количество версий, которые нужно тестировать и катить дальше, растёт вместе с числом адаптеров.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Референсные ссылки
- Conceptual guide LoRA в официальной документации Hugging Face PEFT — определение, архитектура, формулы масштабирования, инициализация, слияние адаптеров и список родственных методов.
- LoRA — Low-Rank Adaptation of Large Language Models — оригинальная статья Hu et al. на arXiv, первоисточник метода.
- Image classification with LoRA — прикладной гайд PEFT, сценарий применения LoRA вне языковых моделей.
- Install PEFT — официальная страница установки и версии библиотеки.