
 23
Содержание
Hybrid search (гибридный поиск) объединяет два независимых способа найти нужный документ, точное совпадение слов и близость по смыслу, и сводит результаты обоих в один список ответом на один и тот же запрос. По отдельности эти методы регулярно ошибаются в разные стороны. Лексический поиск BM25 находит документ по совпадающему термину, но не видит отрицания и синонимов. Векторный поиск находит документ по смыслу, но может пропустить точный термин, если он не встретился в достаточно похожем контексте. Гибридная схема не выбирает один метод вместо другого, а честно запускает оба и передаёт результат в отдельный fusion-слой, который решает, как слить два разных списка в один.
Что такое Hybrid Search и какую задачу решает
Документация Elasticsearch и Weaviate описывает одну и ту же идею с разным фокусом. Elasticsearch описывает Reciprocal Rank Fusion (RRF) как способ объединить несколько результирующих наборов с разными индикаторами релевантности в один набор, не требуя ручной калибровки весов между методами поиска. Weaviate формулирует шире: гибридный поиск это одновременный запуск векторного (similarity) поиска и keyword-поиска BM25F с последующим слиянием двух наборов по настраиваемому алгоритму. Разница формулировок неслучайна, RRF (см. следующий раздел) один из вариантов fusion, а не синоним гибридного поиска целиком.
Проблема, которую решает гибрид, легко воспроизводится на любом корпусе, разбор пайплайна векторного поиска на конкретных шагах есть в статье про ИИ и векторные базы данных. Возьмите запрос, где важное слово встречается буквально, но смысл запроса ему противоречит. BM25 подтянет документ по совпадению термина, векторный поиск подтянет документ по смыслу запроса в целом, и оба по отдельности могут ошибиться одинаково. В разделе про практику ниже это воспроизведено на реальном прогоне, а не на абстрактном примере.
Архитектура гибридного поиска
У обеих разобранных реализаций одна и та же трёхслойная схема. Запрос параллельно уходит в лексический индекс и в векторный индекс, каждый возвращает свой ранжированный список, а fusion-слой сливает два списка в один. В Elasticsearch это оформлено явно как RRF-ретривер, обёртка внутри search request, принимающая минимум два дочерних ретривера с равным весом каждый. Дочерним ретривером может быть стандартный BM25-запрос, семантический поиск через ELSER (Elastic Learned Sparse EncodeR, встроенная sparse-модель Elasticsearch для семантического поиска без внешнего эмбеддера) или KNN-ретривер по векторам. В Weaviate то же самое называется двумя параллельными ветками, keyword-веткой на BM25F и vector-веткой на similarity search, плюс отдельный слой fusion поверх них.
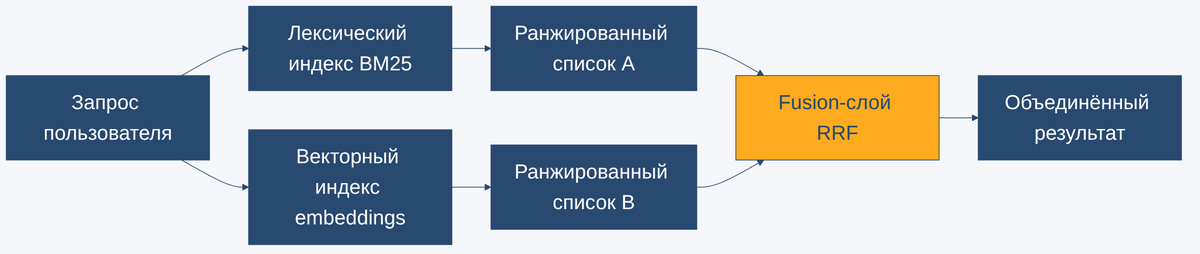
Различаются реализации в дополнительных слоях вокруг этой базовой схемы. Weaviate добавляет property-level weighting через синтаксис property^weight, реранкинг по метаданным вроде свежести и популярности, а также модуль MMR для диверсификации результатов, чтобы в топе не оказались пять почти одинаковых документов подряд. Векторная часть в обеих системах опирается на эмбеддинги, для которых нужна отдельная модель вроде nomic-embed-text, а не готовая поисковая система, эмбеддинги как основа dense-части разбираются в курсе про нейронные сети на Python.
Как считается RRF
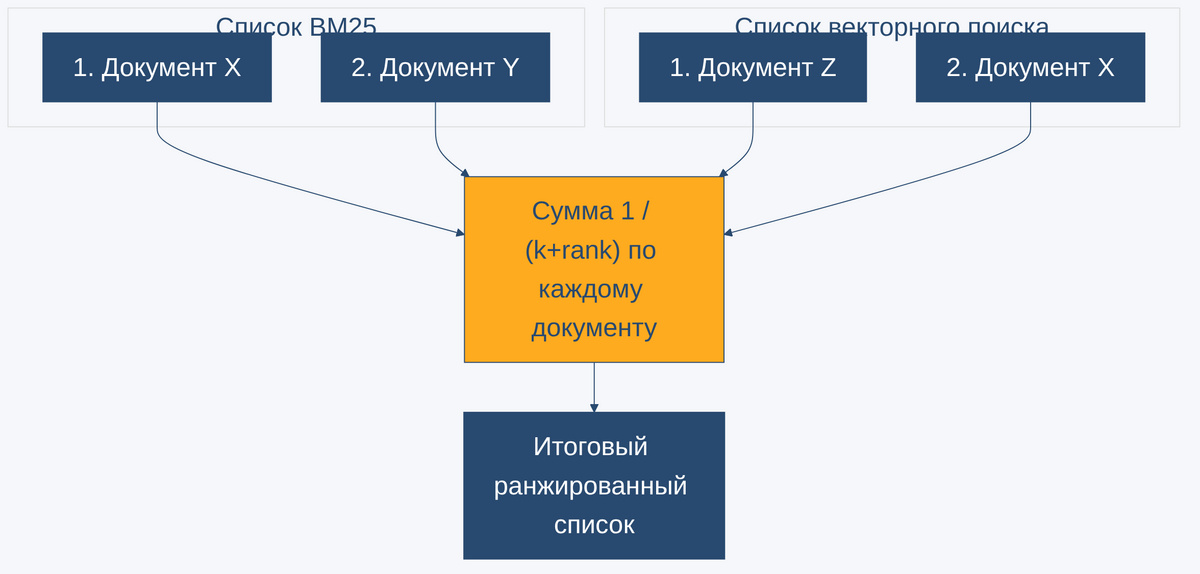
Reciprocal Rank Fusion не смотрит на исходные скоры, а работает только с позициями документа в каждом списке. Формула из документации Elasticsearch RRF retriever суммирует по всем ретриверам, в которых документ встретился, слагаемое 1 / (k + rank), где rank начинается с 1, а k это ранговая константа rank_constant с дефолтным значением 60. Документ, которого нет в списке вообще, просто не даёт вклада в сумму, поэтому нормализовать несравнимые шкалы BM25-скора и косинусного сходства не требуется. Именно это отличает RRF от score-based слияния, которому пришлось бы решать, как сопоставить разные единицы измерения.
Константа 60 не выбрана произвольно. В первоисточнике, работе Gordon Cormack, Charles Clarke и Stefan Buettcher (Гордон Кормак, Чарльз Кларк и Стефан Буттхер) «Reciprocal Rank Fusion outperforms Condorcet and Individual Rank Learning Methods», представленной на конференции SIGIR в 2009 году, значение C = 60 подобрано эмпирически как дающее лучший средний результат на тестовых наборах авторов. С тех пор оно перекочевало в дефолты промышленных реализаций почти без изменений.
У Weaviate альтернативный дефолт с версии 1.24, Relative Score Fusion, работающий не с позициями, а с реальными скорами похожести из обеих веток. Причина смены дефолта не в качестве ранжирования как таковом, а в совместимости с функцией autocut, которая отсекает результаты по величине скора, а чисто ранговое слияние для такого отсечения не подходит. Классический позиционный вариант остался доступен под именем Ranked Fusion.
| Параметр | Elasticsearch RRF retriever | Weaviate Hybrid Search |
|---|---|---|
| Что учитывается | только позиция документа (rank) | позиция (Ranked Fusion) либо реальный скор похожести (Relative Score Fusion, дефолт с 1.24) |
| Управляющий параметр | rank_constant, целое число, дефолт 60, минимум 1 | alpha, диапазон 0-1, 0 это чистый keyword, 1 это чистый вектор |
| Размер промежуточных списков | rank_ |
не документирован как отдельный параметр на уровне fusion |
| Несовместимо с | scroll-пагинацией, sort, rescore, подсветкой на векторных полях | MMR-диверсификация не работает на мультивекторных коллекциях |
Когда чистый поиск лучше гибрида
Документация Weaviate прямо советует не использовать гибридный режим, если с задачей лучше справляется чистый векторный или чистый keyword-поиск. Гибрид не позиционируется как универсальная замена, которая всегда не хуже, а как инструмент для случаев, когда точное совпадение и смысловая близость одинаково важны для качества выдачи. Роль параметра alpha именно в этом, он не меняет архитектуру, а лишь смещает вес одной ветки относительно другой, поэтому alpha = 0 фактически превращает гибридную схему обратно в чистый BM25F, а alpha = 1 в чистый similarity search.
Есть и жёсткие технические ограничения, а не только вопрос вкуса, причём заметный список несовместимостей есть и у Elasticsearch, и у Weaviate.
- RRF-ретривер несовместим со scroll-пагинацией и параметром sort. Итоговый порядок задаёт сам fusion-слой, повлиять на него через sort нельзя.
- Rescore и подсветка на векторных полях не поддерживаются. RRF создаёт собственный внутренний point-in-time контекст, и часть пайплайна поверх обычного поиска на него не натягивается.
- MMR-диверсификация в Weaviate не работает на мультивекторных коллекциях. Запрос с MMR на такой коллекции завершается ошибкой, а не деградирует тихо.
Ни одно из этих ограничений не критично для типового RAG-пайплайна, но все три стоит проверить до того, как гибридный поиск попадёт в продакшен, а не после.
Сценарии использования и когда не применять
Практический сценарий, для которого гибридный поиск придуман, это ретрив в RAG-системах, где пользователь может ввести и точный термин из документации, и вопрос своими словами. Курс «ИИ-агенты для оптимизации бизнес-процессов» разбирает именно эту связку, retrieval и индексацию для агентных пайплайнов, где качество выдачи по смешанным запросам напрямую влияет на качество ответа агента.
Обратная сторона тоже реальна. Если корпус состоит из коротких точных идентификаторов, кодов ошибок, артикулов, номеров версий, то векторная ветка почти всегда добавляет только шум, а чистый BM25 будет и быстрее, и точнее. Если же запросы почти всегда переформулированы своими словами и точных терминов в корпусе мало, гибрид платит дополнительными вызовами эмбеддера за выигрыш, которого лексика и так не даёт.
Локальное демо BM25, векторного поиска и RRF-слияния
Демо ниже не поднимает ни Elasticsearch, ни Weaviate, а показывает сам механизм расхождения и слияния на десяти коротких заметках из базы знаний дата-инженера. Лексический поиск сделан через rank-bm25 версии 0.2.2, векторный поиск через уже запущенную локально Ollama с моделью nomic-embed-text (768 измерений), слияние это собственная реализация RRF на Python с той же формулой 1 / (k + rank) и константой k = 60.
Запрос для обоих демо один и тот же, «как сделать модель быстрее на слабом оборудовании без GPU». Слово «GPU» в нём есть буквально, хотя смысл запроса просит способ обойтись без него, и это намеренная ловушка для проверки обоих методов.
# rank-bm25 0.2.2, ollama (python client) 0.6.2, модель nomic-embed-text (768 измерений),
# numpy 2.5.2, прогнано на стенде 2026-08-27
"""
Лексический поиск (BM25) и векторный поиск (эмбеддинги) по одному и тому же
корпусу и одному запросу. Показывает, почему их верхние строки расходятся:
BM25 ранжирует по совпадению слов и не видит отрицания и синонимов, векторный
поиск ранжирует по смыслу и не видит точного термина, если он не встретился
в достаточно похожем контексте. Это расхождение и есть причина, зачем нужен
fusion-слой гибридного поиска, см. rrf_fusion.py.
"""
import ollama
import numpy as np
from rank_bm25 import BM25Okapi

EMBED_MODEL = "nomic-embed-text"

# Корпус - короткие заметки из базы знаний дата-инженера
CORPUS = [
    "PostgreSQL использует WAL для журналирования изменений и восстановления после сбоя",
    "Apache Kafka хранит события в партициях топика и гарантирует порядок только внутри партиции",
    "Обучение нейронной сети на GPU ускоряется за счёт параллельных матричных вычислений",
    "Квантование весов модели снижает объём памяти и ускоряет инференс на слабом железе",
    "Docker Compose поднимает несколько контейнеров одной командой по файлу конфигурации",
    "Vector database хранит эмбеддинги и ищет ближайших соседей по косинусному расстоянию",
    "BM25 - вероятностная модель ранжирования, учитывающая частоту термина и длину документа",
    "Дистилляция модели переносит знания большой сети в компактную с сохранением качества",
    "Индекс HNSW строит граф ближайших соседей для быстрого приближённого поиска векторов",
    "Репликация PostgreSQL с wal_level=logical рассылает построчные изменения подписчикам",
]

# Запрос лексически пересекается с документом про обучение на GPU (слово "GPU"),
# хотя по смыслу спрашивает об обратном - как обойтись без GPU.
QUERY = "как сделать модель быстрее на слабом оборудовании без GPU"


def bm25_rank(query: str, corpus: list[str]) -> list[tuple[str, float]]:
    tokenized_corpus = [doc.lower().split() for doc in corpus]
    bm25 = BM25Okapi(tokenized_corpus)
    scores = bm25.get_scores(query.lower().split())
    ranked = sorted(zip(corpus, scores), key=lambda item: item[1], reverse=True)
    return ranked


def embed(text: str, task_prefix: str) -> np.ndarray:
    # nomic-embed-text асимметричная: без префикса задачи (search_query /
    # search_document) косинусное сходство запрос-документ считается некорректно.
    r = ollama.embed(model=EMBED_MODEL, input=f"{task_prefix}: {text}")
    return np.array(r["embeddings"][0], dtype=np.float32)


def cosine_similarity(a: np.ndarray, b: np.ndarray) -> float:
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)))


def vector_rank(query: str, corpus: list[str]) -> list[tuple[str, float]]:
    query_vec = embed(query, "search_query")
    corpus_vecs = [embed(doc, "search_document") for doc in corpus]
    ranked = sorted(
        zip(corpus, corpus_vecs),
        key=lambda item: cosine_similarity(query_vec, item[1]),
        reverse=True,
    )
    return [(doc, cosine_similarity(query_vec, vec)) for doc, vec in ranked]


def main():
    print(f"Запрос: {QUERY!r}\n")

    print("--- BM25 (лексический) топ-5 ---")
    for rank, (doc, score) in enumerate(bm25_rank(QUERY, CORPUS)[:5], start=1):
        print(f"{rank}. [{score:.3f}] {doc}")

    print("\n--- Векторный поиск (семантический) топ-5 ---")
    for rank, (doc, score) in enumerate(vector_rank(QUERY, CORPUS)[:5], start=1):
        print(f"{rank}. [{score:.3f}] {doc}")


if __name__ == "__main__":
    main()
Реальный вывод подтверждает ловушку. BM25 ставит на первое место документ про обучение на GPU со скором 3.044, а следующие два документа про квантование весов и BM25-теорию получают 2.923 и 1.831, при этом документы без общих слов с запросом получают ровно 0.000 и оказываются внизу списка. Векторный поиск тоже ставит на первое место тот же документ про GPU (косинус 0.809), но на втором месте у него документ про дистилляцию модели с косинусом 0.672, которого в топе BM25 нет вообще, потому что там ни одного общего слова с запросом.
Второй файл, rrf_fusion.py, берёт до пяти документов из каждого метода (BM25 в этом прогоне отдал только три, документы с нулевым скором отсекаются) и сливает их RRF по той же формуле, что в Elasticsearch.
# rank-bm25 0.2.2, ollama (python client) 0.6.2, модель nomic-embed-text (768 измерений),
# numpy 2.5.2, прогнано на стенде 2026-08-27; rank_constant=60 - дефолт RRF retriever
# в Elasticsearch, формула 1/(k+rank) - по Cormack, Clarke, Buettcher, SIGIR 2009
"""
Reciprocal Rank Fusion (RRF) на своей реализации: два независимых ранжированных
списка (BM25 и векторный поиск) сливаются в один по формуле 1/(k+rank), где
rank - позиция документа в исходном списке (с 1), а k - константа, гасящая
влияние низких позиций. Документ, которого нет в списке вообще, вклада в его
итоговый score не даёт, это и отличает RRF от score-based слияния, где
пришлось бы нормализовать несравнимые шкалы (BM25-score и косинус).
"""
import ollama
import numpy as np
from rank_bm25 import BM25Okapi

EMBED_MODEL = "nomic-embed-text"
RANK_CONSTANT = 60  # k в формуле RRF, дефолт Elasticsearch RRF retriever

CORPUS = [
    "PostgreSQL использует WAL для журналирования изменений и восстановления после сбоя",
    "Apache Kafka хранит события в партициях топика и гарантирует порядок только внутри партиции",
    "Обучение нейронной сети на GPU ускоряется за счёт параллельных матричных вычислений",
    "Квантование весов модели снижает объём памяти и ускоряет инференс на слабом железе",
    "Docker Compose поднимает несколько контейнеров одной командой по файлу конфигурации",
    "Vector database хранит эмбеддинги и ищет ближайших соседей по косинусному расстоянию",
    "BM25 - вероятностная модель ранжирования, учитывающая частоту термина и длину документа",
    "Дистилляция модели переносит знания большой сети в компактную с сохранением качества",
    "Индекс HNSW строит граф ближайших соседей для быстрого приближённого поиска векторов",
    "Репликация PostgreSQL с wal_level=logical рассылает построчные изменения подписчикам",
]

QUERY = "как сделать модель быстрее на слабом оборудовании без GPU"

# Сколько документов каждый ретривер отдаёт наружу до слияния, в проде это
# rank_window_size, а не полный размер корпуса.
TOP_K_PER_RETRIEVER = 5


def bm25_ranked_docs(query: str, corpus: list[str], top_k: int) -> list[str]:
    tokenized_corpus = [doc.lower().split() for doc in corpus]
    bm25 = BM25Okapi(tokenized_corpus)
    scores = bm25.get_scores(query.lower().split())
    ranked = sorted(zip(corpus, scores), key=lambda item: item[1], reverse=True)
    return [doc for doc, score in ranked[:top_k] if score > 0]


def embed(text: str, task_prefix: str) -> np.ndarray:
    r = ollama.embed(model=EMBED_MODEL, input=f"{task_prefix}: {text}")
    return np.array(r["embeddings"][0], dtype=np.float32)


def cosine_similarity(a: np.ndarray, b: np.ndarray) -> float:
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)))


def vector_ranked_docs(query: str, corpus: list[str], top_k: int) -> list[str]:
    query_vec = embed(query, "search_query")
    corpus_vecs = {doc: embed(doc, "search_document") for doc in corpus}
    ranked = sorted(corpus, key=lambda doc: cosine_similarity(query_vec, corpus_vecs[doc]), reverse=True)
    return ranked[:top_k]


def reciprocal_rank_fusion(ranked_lists: list[list[str]], k: int = RANK_CONSTANT) -> list[tuple[str, float]]:
    scores: dict[str, float] = {}
    for ranked_list in ranked_lists:
        for position, doc in enumerate(ranked_list, start=1):
            scores[doc] = scores.get(doc, 0.0) + 1.0 / (k + position)
    return sorted(scores.items(), key=lambda item: item[1], reverse=True)


def main():
    print(f"Запрос: {QUERY!r}, rank_constant={RANK_CONSTANT}\n")

    bm25_docs = bm25_ranked_docs(QUERY, CORPUS, TOP_K_PER_RETRIEVER)
    vector_docs = vector_ranked_docs(QUERY, CORPUS, TOP_K_PER_RETRIEVER)

    print("BM25 топ-5 (позиция важна, score - нет):")
    for rank, doc in enumerate(bm25_docs, start=1):
        print(f"  {rank}. {doc}")

    print("\nВекторный поиск топ-5:")
    for rank, doc in enumerate(vector_docs, start=1):
        print(f"  {rank}. {doc}")

    fused = reciprocal_rank_fusion([bm25_docs, vector_docs])

    print("\n--- После RRF-слияния ---")
    for rank, (doc, score) in enumerate(fused, start=1):
        bm25_pos = bm25_docs.index(doc) + 1 if doc in bm25_docs else "-"
        vector_pos = vector_docs.index(doc) + 1 if doc in vector_docs else "-"
        print(f"{rank}. [rrf={score:.5f}, bm25_rank={bm25_pos}, vector_rank={vector_pos}] {doc}")


if __name__ == "__main__":
    main()
Итог слияния наглядный. Документ про обучение на GPU остаётся первым (rrf = 0.03279), он был первым в обоих списках. А вот документ про дистилляцию модели, у которого нет ни одного общего слова с запросом и который BM25 вообще не видит, поднимается на четвёртое место в объединённом списке (rrf = 0.01613) исключительно благодаря второй позиции в векторном списке. Это ровно тот случай, ради которого fusion-слой существует, слабый сигнал одного метода компенсируется сильным сигналом другого.
У демо есть и честное ограничение. Оба метода независимо ставят на первое место документ про обучение «на GPU», хотя запрос буквально просит способ обойтись без GPU. Ни лексический, ни семантический сигнал сам по себе не распознаёт отрицание, и RRF-слияние двух методов эту проблему не решает, если оба метода одинаково слепы к конкретному явлению. Гибрид складывает сильные стороны двух ретриверов, но не создаёт нового сигнала, которого не было ни в одном из них.
Заключение
Hybrid search не заменяет ни BM25, ни векторный поиск, а даёт слой, который решает, как свести их результаты в один список без ручной калибровки весов. RRF делает это по позициям и не требует нормализации шкал, Relative Score Fusion делает то же по реальным скорам ради совместимости с отсечением по похожести. Выбор между чистым методом и гибридом зависит от корпуса и профиля запросов, а не от того, какой подход выглядит современнее. Ограничения по несовместимым фичам и честные слепые зоны вроде отрицания в запросе стоит проверить на своих данных до продакшена, а не после первого инцидента.