
 78
Содержание
- Что такое Hallucination Detection и какую задачу решает
- Архитектура и ключевые компоненты
- Классификатор-детектор (HHEM)
- LLM-as-judge метрика (RAGAS Faithfulness)
- Принцип работы под капотом
- Как считается Factual Consistency Score
- Claim extraction, verification и scoring в RAGAS
- Классификатор против LLM-as-judge
- Ограничения и подводные камни
- Сценарии использования и когда подход не подходит
- Считаем FCS и Faithfulness на практике
- HHEM scoring
- RAGAS Faithfulness с локальным судьёй Ollama
- Заключение
- Референсные ссылки
Hallucination detection (Детекция галлюцинаций) — это не один инструмент с единой версией, а класс техник, которые проверяют ответ большой языковой модели (LLM) на соответствие исходному документу или извлечённому контексту. Термин объединяет разные по устройству подходы, а именно отдельный классификатор вроде Vectara HHEM, который выдаёт числовой скор доверия, и LLM-as-judge метрику вроде RAGAS Faithfulness, где judge-модель сама решает, подтверждено ли каждое утверждение ответа. Разница между ними не терминологическая, а архитектурная, и она напрямую определяет, где подход работает надёжно, а где даёт сбой.
Что такое Hallucination Detection и какую задачу решает
Задача одна на всю категорию. Нужно отделить ответ LLM, который подтверждается источником, от ответа, который источником не подтверждается, то есть выдуман моделью. Для приложений на RAG (retrieval-augmented generation) источником служит извлечённый контекст, и тогда задача сужается до groundedness, вопроса, опирается ли ответ именно на найденные фрагменты, а не на общие знания модели. В open-domain-сценариях без retrieval сверять ответ попросту не с чем, поэтому техники детекции галлюцинаций там применимы плохо или не применимы вовсе.
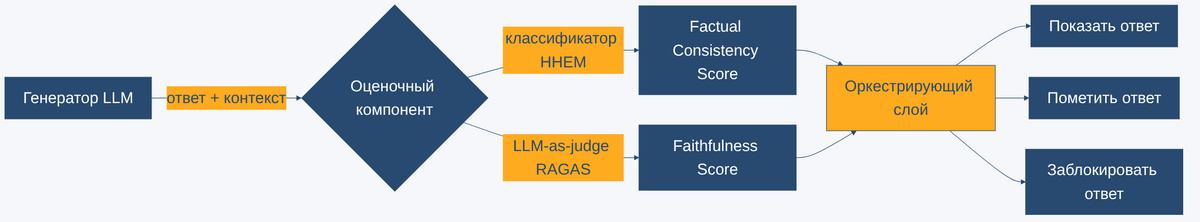
На практике задача решается на выходе пайплайна, уже после генерации ответа. Оценочный компонент получает пару из источника (или контекста) и сгенерированного текста и возвращает скор, а решение показать, пометить или заблокировать ответ принимает уже оркестрирующий слой приложения.
Архитектура и ключевые компоненты
Категория держится на нескольких архитектурных паттернах, а не на одном общем. Разберём два, для которых ниже есть реальный локальный прогон.
Классификатор-детектор (HHEM)
Vectara HHEM (Hughes Hallucination Evaluation Model) — компактная модель-классификатор на базе T5, которую выпускает Vectara. Модель принимает на входе пару текстов, источник и сгенерированный текст, и возвращает единственное число, Factual Consistency Score (FCS), в диапазоне от 0.0 до 1.0. Отдельная модель для оценки означает отдельный дополнительный вызов при инференсе, но и предсказуемую задержку, не зависящую от того, какая LLM сгенерировала проверяемый текст. Коммерческая версия HHEM-2.3 поддерживает 11 языков, включая русский, английский, немецкий, французский, португальский, испанский, арабский, упрощённый китайский, корейский, японский и хинди. Открытая версия HHEM-2.1-Open доступна на Hugging Face и Kaggle под лицензией Apache 2.0.
LLM-as-judge метрика (RAGAS Faithfulness)
RAGAS Faithfulness устроена принципиально иначе. Вместо отдельной специализированной модели роль оценщика играет сама LLM, называемая judge-моделью. Библиотека ragas, часть open-source-инструментария для оценки RAG-пайплайнов, разбивает эту роль на три последовательных шага, извлечение утверждений, их проверку против контекста и агрегацию в итоговый скор. Такой подход не требует отдельно обученной модели, но платит за это зависимостью от качества и стабильности judge-модели, а также заметно большей задержкой из-за нескольких вызовов LLM на один пример.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
25 января, 2027
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Принцип работы под капотом
Как считается Factual Consistency Score
HHEM выдаёт калиброванную вероятность, а не просто ранжирующий скор. Скор 0.95 в документации Vectara буквально означает, что с вероятностью 95% проверяемый текст не содержит галлюцинаций относительно источника. Vectara рекомендует стартовый порог 0.5, для отсева недостаточно надёжных ответов. Важное ограничение по документации в том, что FCS оценивает только фактическую точность сгенерированного текста относительно предоставленных результатов поиска, а не общее качество, релевантность или стиль ответа.
Claim extraction, verification и scoring в RAGAS
Faithfulness в RAGAS проходит три шага. Claim extraction разбивает сгенерированный ответ на атомарные утверждения, отдельные проверяемые факты. Verification проверяет каждое утверждение против извлечённого контекста, подтверждено оно там или нет. Scoring считает итоговый скор как долю подтверждённых утверждений от общего числа. Итоговое число в диапазоне от 0.0 до 1.0 сразу показывает, какая часть ответа опирается на найденный контекст, а какая додумана моделью сверх него.
Классификатор против LLM-as-judge
Оба подхода решают одну задачу, но по-разному распределяют затраты между обучением модели и инференсом. Таблица ниже сводит архитектурные различия, часть из них видна уже на маленьком локальном прогоне из раздела практики.
| Критерий | HHEM (классификатор) | RAGAS Faithfulness (LLM-as-judge) |
|---|---|---|
| Что оценивает | Пара источник-текст целиком | Каждое утверждение по отдельности |
| Нужна ли judge-LLM | Нет, отдельная небольшая модель | Да, любая LLM с ролью оценщика |
| Диапазон и природа скора | 0.0-1.0, калиброванная вероятность | 0.0-1.0, доля подтверждённых утверждений |
| Число вызовов модели на один пример | Один | Несколько, под каждый шаг конвейера |
| Задержка в демо этой статьи | Десятки миллисекунд на пару после прогрева весов | 27.4-33.0 секунды на пример |
| Чувствительность к перефразу | Высокая, видна на паре 4 в демо ниже | В демо этой статьи не проверялась, по конструкции оценивает отдельные утверждения через judge-модель |
Ограничения и подводные камни
Оба подхода задокументированно ограничены, и это не мелкие частности, а причины, по которым скор нельзя использовать вслепую.
- HHEM чувствителен к лексическому совпадению, а не только к смыслу. Модель калибрована на паттернах совпадения слов с источником, поэтому точный по фактам, но перефразированный текст может получить скор ниже точного дословного повторения того же факта. Это подтверждается прогоном в разделе практики.
- FCS не измеряет качество ответа целиком. Документация Vectara прямо оговаривает, что скор относится только к фактической точности относительно результатов поиска, а стиль, релевантность вопросу и полнота ответа остаются вне его области.
- Faithfulness работает только там, где есть retrieved-контекст. Метрика сравнивает ответ с контекстом, а не с внешним миром, поэтому в open-domain-сценариях без retrieval её попросту не с чем считать.
- LLM-as-judge наследует нестабильность LLM. Три шага, извлечение утверждений, их проверка и агрегация, выполняются той же самой моделью, которая подвержена собственным сбоям и колебаниям качества между версиями и провайдерами.
Из этого следует практический вывод. Числовой порог вроде рекомендованных Vectara 0.5 задаёт только отправную точку, а не универсальную границу истины, которую можно перенести в новый домен без проверки.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Сценарии использования и когда подход не подходит
Классификаторы вроде HHEM хорошо подходят для суммаризации и других задач, где источник и сгенерированный текст можно сопоставить напрямую, а задержка инференса критична, например для онлайн-фильтрации ответов перед показом пользователю. Faithfulness и похожие LLM-as-judge метрики органичнее вписываются в offline-оценку качества RAG-пайплайна на наборе тестовых примеров, где задержка в десятки секунд на пример не мешает, зато важна интерпретируемость, ведь конвейер extraction-verification-scoring можно разобрать по шагам и понять, какое именно утверждение не подтвердилось.
Ни один из двух подходов не годится для оценки открытой генерации без источника. Про надёжность RAG-агентов подробнее рассказано на курсе «AI-агенты для оптимизации бизнес-процессов», а про потоковую обработку данных и оценку качества LLM-систем в проде мы писали в материале о потоковой обработке и оценке качества LLM-систем. Официальное описание метода HHEM и порогов приведено в документации Vectara по оценке галлюцинаций.
Считаем FCS и Faithfulness на практике
По традиции весь код, использованный в статье, публикуем в нашем GitHub-репозитории.
HHEM scoring
Демо запускает HHEM-2.1-Open локально через Hugging Face Transformers и проверяет четыре пары текстов, от дословного повторения факта до явной галлюцинации и до точного пересказа другими словами.
# transformers 4.46.3, torch 2.13.0, модель vectara/hallucination_evaluation_model
# (HHEM-2.1-Open, Apache 2.0), прогнано на стенде 2026-09-03.
#
# Важно про версию transformers. Свежий transformers (проверено на 5.15.1) ломает загрузку
# этой модели: кастомный код HHEM (modeling_hhem_v2.py, тянется вместе с моделью через
# trust_remote_code) не обновлялся под внутренний рефакторинг transformers, который переименовал
# атрибут, отвечающий за tied weights. Падает так:
#   AttributeError: 'HHEMv2ForSequenceClassification' object has no attribute
#   'all_tied_weights_keys'. Did you mean: '_tied_weights_keys'?
# Рабочая версия - transformers==4.46.3, она же и указана ниже в требованиях.
#
# pip install "transformers==4.46.3" "torch==2.13.0"

from transformers import AutoModelForSequenceClassification

# trust_remote_code=True обязателен: HHEM хранит архитектуру модели в кастомном коде рядом
# с весами на Hugging Face, а не использует одну из стандартных архитектур transformers.
model = AutoModelForSequenceClassification.from_pretrained(
    "vectara/hallucination_evaluation_model",
    trust_remote_code=True,
)

# Каждая пара - это (источник, сгенерированный текст). HHEM возвращает Factual Consistency
# Score: 0.0 значит текст не подтверждается источником, 1.0 - полностью подтверждается.
# Vectara рекомендует порог 0.5 как отправную точку для отсева ненадёжных ответов.
pairs = [
    # 1. Дословное повторение факта из источника - ожидаемо высокий скор.
    (
        "Vectara HHEM - компактный классификатор на базе T5, который принимает пару текстов "
        "и выдаёт числовой Factual Consistency Score от 0.0 до 1.0.",
        "Vectara HHEM - компактный классификатор на базе T5, который принимает пару текстов "
        "и выдаёт числовой Factual Consistency Score от 0.0 до 1.0.",
    ),
    # 2. Явная галлюцинация: источник не говорит про GPU-ускорение, это выдумано.
    (
        "Python 3.12 вышел в октябре 2023 года и добавил улучшенный вывод типов, "
        "а также ускорение интерпретатора.",
        "Python 3.12 вышел в октябре 2023 года и добавил поддержку GPU-ускорения из коробки.",
    ),
    # 3. Явная галлюцинация: источник говорит про CPU и = 0.5 else "ниже порога 0.5"
    print(f"FCS={score:.4f} ({verdict})")
    print(f"  текст: {summary}")
    print()

print(
    "Наблюдение: пара 4 фактически точна (источник пересказан верно), но получает низкий "
    "скор - модель чувствительна к лексическому совпадению слов с источником, а не только "
    "к смыслу. Дословное повторение (пара 1) получает высокий скор увереннее, чем перефраз "
    "того же факта."
)
Реальный вывод с рабочего стенда, без изменений.
# вывод selfcheck.sh, стенд 2026-09-03, transformers 4.46.3
Factual Consistency Score по каждой паре (источник, сгенерированный текст):

FCS=0.9150 (выше порога 0.5)
  текст: Vectara HHEM - компактный классификатор на базе T5, который принимает пару текстов и выдаёт числовой Factual Consistency Score от 0.0 до 1.0.

FCS=0.0879 (ниже порога 0.5)
  текст: Python 3.12 вышел в октябре 2023 года и добавил поддержку GPU-ускорения из коробки.

FCS=0.0670 (ниже порога 0.5)
  текст: HHEM-2.1-Open требует более 8 ГБ оперативной памяти и работает только на GPU.

FCS=0.3180 (ниже порога 0.5)
  текст: Vectara советует использовать порог 0.5 как стартовую точку для отсева ненадёжных ответов по FCS.

Наблюдение: пара 4 фактически точна (источник пересказан верно), но получает низкий скор - модель чувствительна к лексическому совпадению слов с источником, а не только к смыслу. Дословное повторение (пара 1) получает высокий скор увереннее, чем перефраз того же факта.
Пара 4 наглядно подтверждает ограничение из раздела выше. Точный по смыслу, но перефразированный ответ получил FCS 0.318, ниже рекомендованного порога 0.5, тогда как дословное повторение того же класса факта (пара 1) дало 0.915. Классификатор в этой конкретной паре ложно пометил бы верный ответ как ненадёжный.
RAGAS Faithfulness с локальным судьёй Ollama
Второе демо считает Faithfulness через RAGAS 0.4.3 с локальной judge-моделью qwen2.5:7b через Ollama 0.32.13 — локальный рантайм для запуска LLM на своей машине, без обращения к внешним API. Пакет ragas 0.4.3 на дату прогона содержит баг, из-за которого импорт безусловно тянет клиент Google Vertex AI, которого нет в актуальном langchain-community, и падает ModuleNotFoundError даже у тех, кто Vertex AI не использует вовсе. Баг подтверждён в issue-трекере проекта (issues #2741, #2745, #2753), обход подставляет пустую заглушку модуля перед импортом ragas.
# ragas 0.4.3, langchain-ollama 1.1.0, локальный судья qwen2.5:7b через Ollama 0.32.13
# (http://localhost:11434), прогнано на стенде 2026-09-03.
#
# pip install ragas langchain-ollama
#
# Важно про баг ragas 0.4.3. Импорт `ragas` в этой версии безусловно тянет
# `from langchain_community.chat_models.vertexai import ChatVertexAI` в ragas/llms/base.py -
# и падает ModuleNotFoundError у всех, кто не работает с Google Vertex AI, включая пользователей
# Ollama/OpenAI/Anthropic. Баг подтверждён в трекере ragas (issues #2741, #2745, #2753 в
# репозитории vibrantlabsai/ragas), официальный фикс на дату прогона не выпущен. Обходной путь
# ниже - подставить в sys.modules пустую заглушку модуля до импорта ragas.
import sys
import types

_vertexai_stub = types.ModuleType("langchain_community.chat_models.vertexai")
_vertexai_stub.ChatVertexAI = None
sys.modules["langchain_community.chat_models.vertexai"] = _vertexai_stub

import asyncio

from langchain_ollama import ChatOllama
from ragas.dataset_schema import SingleTurnSample
from ragas.llms import LangchainLLMWrapper

# ragas.metrics.Faithfulness помечен в 0.4.3 как deprecated в пользу
# ragas.metrics.collections.Faithfulness, но у новой версии в документации нет примера
# с локальным судьёй через LangChain-обёртку (только через ragas.llms.llm_factory и клиент
# OpenAI). Берём документированную для Ollama связку LangchainLLMWrapper + ChatOllama, она
# работает с этим же классом Faithfulness.
from ragas.metrics import Faithfulness

# Судья - локальная модель через Ollama, обёрнутая для интерфейса ragas.
judge = ChatOllama(model="qwen2.5:7b", temperature=0)
evaluator_llm = LangchainLLMWrapper(judge)
scorer = Faithfulness(llm=evaluator_llm)

# Контекст один и тот же для всех трёх случаев - это то, что реально вернул бы retrieval
# в RAG-пайплайне. Faithfulness не проверяет сам факт против внешнего мира, только
# согласованность ответа с этим контекстом.
context = [
    "Первая игра чемпионата AFL-NFL (позже названная Суперкубком I) была сыграна 15 января "
    "1967 года на стадионе Los Angeles Memorial Coliseum в Лос-Анджелесе."
]

cases = {
    "полностью согласован с контекстом": SingleTurnSample(
        user_input="Когда был первый Суперкубок?",
        response="Первый Суперкубок состоялся 15 января 1967 года.",
        retrieved_contexts=context,
    ),
    "частично согласован (место верно, зрители выдуманы)": SingleTurnSample(
        user_input="Когда был первый Суперкубок и где он прошёл?",
        response=(
            "Первый Суперкубок прошёл 15 января 1967 года на стадионе Los Angeles Memorial "
            "Coliseum, его посетили более 100 000 зрителей."
        ),
        retrieved_contexts=context,
    ),
    "полностью выдуман (дата верна, город и посещаемость нет)": SingleTurnSample(
        user_input="Когда был первый Суперкубок и где он прошёл?",
        response=(
            "Первый Суперкубок прошёл 15 января 1967 года в Далласе, его посетили более "
            "100 000 зрителей."
        ),
        retrieved_contexts=context,
    ),
}


async def main() -> None:
    print("Faithfulness Score = доля утверждений ответа, подтверждённых контекстом.\n")
    for label, sample in cases.items():
        score = await scorer.single_turn_ascore(sample)
        print(f"{score:.3f} | {label}")
        print(f"  ответ: {sample.response}")
        print()


if __name__ == "__main__":
    asyncio.run(main())
Вывод подтверждает механизм из раздела про принцип работы.
# вывод selfcheck.sh, стенд 2026-09-03, ragas 0.4.3, судья qwen2.5:7b
1.000 | полностью согласован с контекстом
0.667 | частично согласован (место верно, зрители выдуманы)
0.000 | полностью выдуман (дата верна, город и посещаемость нет)
Первый ответ подтверждён контекстом целиком и получает максимальный скор. Третий ответ выдумывает город и посещаемость при верной дате и получает 0.000, полный провал по Faithfulness. Второй, где верно место, но выдуманы зрители, получает 0.667, ровно две из трёх атомарных claim-ов подтвердились контекстом. Это и есть разница между классификатором, который выдаёт один общий скор на всю пару, и LLM-as-judge, где скор считается по отдельным утверждениям и поэтому объясним по частям.
Заключение
Hallucination detection не сводится к одной метрике или одной модели, это выбор архитектуры под конкретное ограничение. Классификатор вроде HHEM быстрый и предсказуемый, но чувствителен к буквальному совпадению слов с источником, что показал прогон с перефразированной, но точной парой. LLM-as-judge метрика вроде RAGAS Faithfulness работает медленнее и требует judge-модели, зато объясняет скор по отдельным утверждениям. Правильный выбор зависит не от того, какой подход в принципе точнее, а от того, что важнее для конкретного приложения, задержка ответа или интерпретируемость решения.
Референсные ссылки
- Vectara. Hallucination Evaluation — определение HHEM и FCS, механизм работы, диапазон скора, поддерживаемые языки, рекомендованный порог 0.5.
- RAGAS. Faithfulness — определение и трёхшаговый механизм метрики, claim extraction, verification, scoring.
- Hugging Face. HHEM-2.1-Open — карточка открытой модели, требования к ресурсам, лицензия.
- Vectara. Hallucination Leaderboard — публичный лидерборд частоты галлюцинаций LLM при суммаризации.