
 12
Содержание
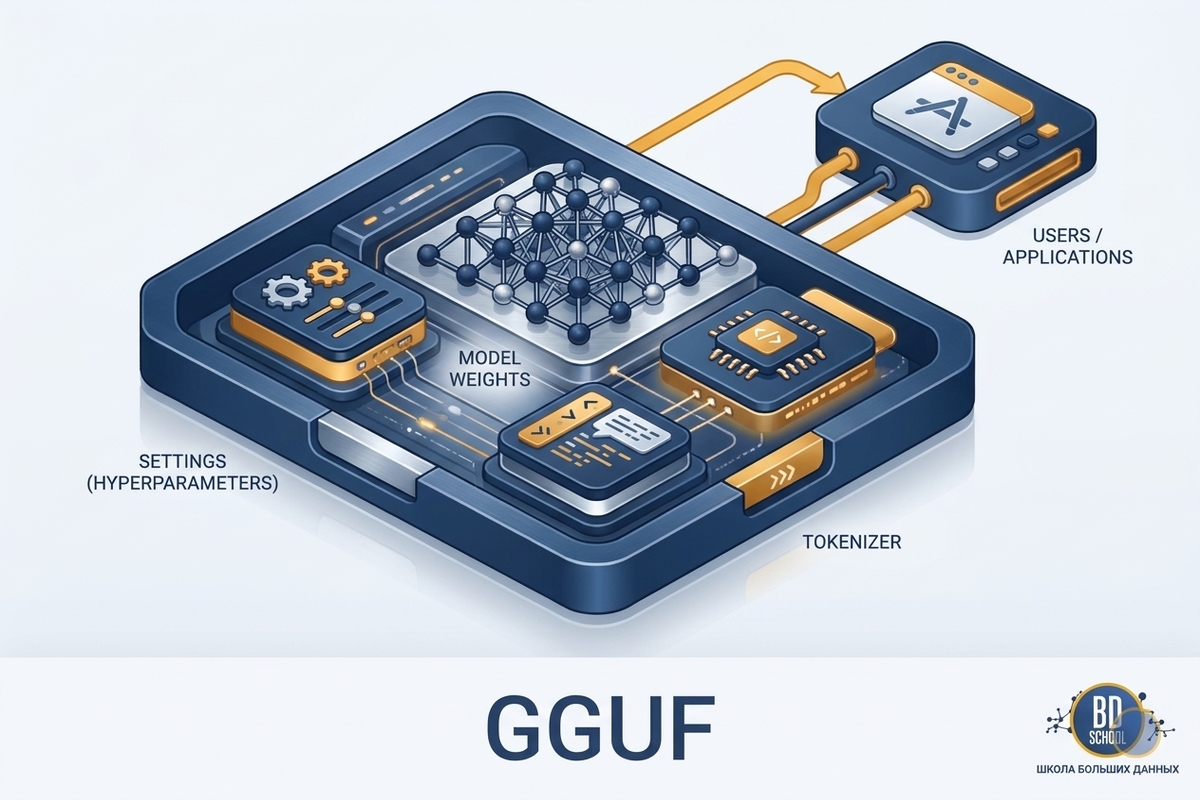
GGUF это бинарный формат файла (расширение .gguf), в котором веса большой языковой модели (large language model, LLM) лежат вместе со всем, что нужно для её запуска, а именно гиперпараметрами архитектуры, токенизатором и шаблоном чата. Формат создан для llama.cpp и тензорной библиотеки ggml, а сегодня GGUF-файлы читают Ollama, десктопные приложения для локального запуска моделей LM Studio и GPT4All, а также встроенный просмотрщик Hugging Face Hub. Когда пишут «скачал модель в gguf», имеют в виду один файл, который открывается без Python, PyTorch и папки с конфигами.
Что такое GGUF
Формат придумал Georgi Gerganov (Георги Герганов), автор проекта llama.cpp и библиотеки ggml для инференса нейросетей на CPU и потребительских GPU. Спецификация GGUF живёт в репозитории ggml и прямо говорит о цели, а именно хранить модели для исполнения в GGML и совместимых движках.
У GGUF были предшественники. Сначала llama.cpp писал файлы в формате GGML без номера версии, затем появился GGMF с версией и GGJT, где тензоры впервые выровняли под отображение в память. Все три страдали одной болезнью. Гиперпараметры лежали нетипизированным списком чисел, идентификатора архитектуры не было, и под каждую новую модель приходилось писать свой конвертер и свой загрузчик. GGUF заменил список на типизированные метаданные ключ-значение (key-value metadata), так что файл сам сообщает, какая в нём архитектура и как её собрать.
Текущая версия формата третья. Версия 2 перевела счётчики и длины с uint32 на uint64, версия 3 добавила поддержку big-endian.
Устройство файла GGUF
Файл читается строго последовательно, от начала к концу. В нём пять частей:
- Заголовок. Четыре байта magic со строкой GGUF, версия формата в uint32 и два счётчика uint64, число тензоров и число пар метаданных. Всего 24 байта.
- Метаданные. Пары ключ-значение, у каждого значения явный тип из тринадцати возможных, от UINT8 до FLOAT64, включая строки и массивы.
- Описания тензоров (tensor info). Для каждого тензора имя, число измерений, размеры, тип квантования и смещение.
- Выравнивающие нули. Паддинг до границы, кратной значению general.alignment.
- Блок данных. Сами веса, где начало каждого тензора тоже кратно выравниванию.
Порядок выбран так, чтобы загрузчику хватило одного прохода по началу файла и он узнал всё о модели до первого байта весов.
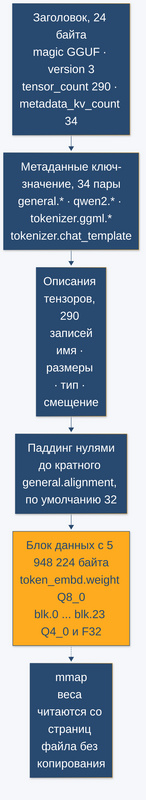
Ключи метаданных пишутся в ASCII, в нижнем регистре через подчёркивание, иерархия задаётся точкой. Общие сведения лежат в пространстве general.*, параметры архитектуры в пространстве с её именем (например, qwen2.context_length), словарь и правила токенизации в tokenizer.ggml.*, шаблон чата на языке шаблонов Jinja в tokenizer.chat_template. Спецификация относит general.alignment к обязательной группе ключей, но в реальном файле из Ollama, который мы разбираем ниже, этого ключа нет, и читатель подставляет значение по умолчанию 32 байта.
Выравнивание и есть главная инженерная идея формата. Раз каждый тензор начинается на границе, кратной 32 байтам, файл можно отобразить в память системным вызовом mmap (memory mapping) и работать с весами прямо со страниц файла, ничего не копируя. Загрузка модели в этом случае почти мгновенная, а страницы подтягиваются с диска по мере обращения. Ограничения у формата тоже есть. Имя тензора не длиннее 64 байт, измерений не больше четырёх, выравнивание должно быть кратно 8, а флага порядка байтов в файле нет, поэтому по умолчанию файл считается little-endian.
Как модель попадает в GGUF
Модели на Hugging Face обычно публикуют в safetensors, рядом лежат config.json и файлы токенизатора. Путь до квантованного GGUF проходит в два шага, оба инструмента входят в llama.cpp. Скрипт convert_hf_to_gguf.py читает папку или репозиторий модели (флаг —remote) и собирает GGUF в исходной точности, для этого обычно указывают —outtype bf16. Затем утилита llama-quantize берёт этот файл и пишет квантованную копию нужного типа, например Q4_K_M. На вход квантователю подаётся только GGUF, как правило в F32 или BF16.
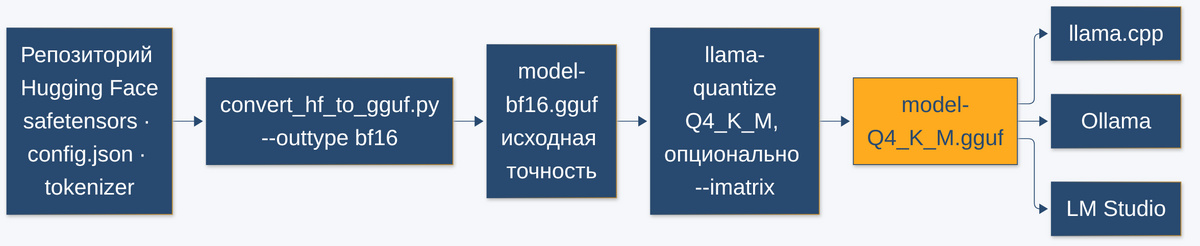
В README квантователя есть несколько честных предупреждений. Модель на время квантования целиком загружается в память, так что RAM и диска нужно примерно по размеру исходных весов плюс место под промежуточный файл. Повторное квантование уже квантованного файла (флаг —allow-requantize) может заметно испортить качество по сравнению с квантованием из 16 или 32 бит. Мультимодальная модель превращается в два файла, основной и проектор изображений mmproj, который обычно оставляют в BF16 или Q8_0.
Типы квантования и имена файлов
Суффикс в имени файла вроде model-Q4_K_M.gguf указывает на схему квантования (quantization) весов. Все схемы в ggml блочные. Веса режутся на небольшие блоки, и у каждого блока свой масштаб.
- Классические типы Q4_0, Q5_0, Q8_0. Блок из 32 весов и один масштаб в fp16 на блок. Для Q4_0 это 16 байт значений плюс 2 байта масштаба, отсюда 4,5 бита на вес, для Q8_0 по той же логике 8,5.
- K-кванты Q2_K…Q6_K. Суперблоки по 256 весов, внутри которых масштабы самих блоков тоже квантованы. У Q4_K выходит 4,5 бита на вес, у Q6_K 6,5625.
- IQ-типы. Те же суперблоки по 256 весов, но при квантовании используется матрица важности (importance matrix, флаг —imatrix). Это путь к 2 битам на вес и ниже.
Суффиксы _S, _M и _L спецификацией не определены. На практике это смесь типов по тензорам, когда llama-quantize одним слоям даёт больше бит, другим меньше, и флаг —pure эту смесь отключает. Путаницу добавляют два разных перечисления. Тип тензора Q4_K имеет код 12, а тип файла MOSTLY_Q4_K_M, записанный в ключ general.file_type, имеет код 15. Слово MOSTLY в названии честное и означает «преимущественно». Ниже размеры одной и той же модели Llama-3.1-8B из README квантователя llama.cpp.
| Тип | Бит на вес | Размер, ГиБ |
|---|---|---|
| Q2_K | 3,1593 | 2,95 |
| Q3_K_M | 3,9960 | 3,74 |
| Q4_K_S | 4,6672 | 4,36 |
| Q4_K_M | 4,8944 | 4,58 |
| Q5_K_M | 5,7036 | 5,33 |
| Q6_K | 6,5633 | 6,14 |
| Q8_0 | 8,5008 | 7,95 |
| F16 | 16,0005 | 14,96 |
Обратите внимание, что у Q4_K_M на вес приходится 4,89 бита, а не 4,5, как у типа Q4_K. Разница и есть та самая смесь. Данных о потере качества по каждому типу в этом источнике нет, поэтому выбор между Q4_K_M и Q5_K_M стоит проверять на своей задаче, а не по чужой таблице.
GGUF и другие форматы весов
Чаще всего GGUF сравнивают с safetensors, но у этих форматов разные задачи. Safetensors хранит только тензоры, конфиг и токенизатор лежат рядом отдельными файлами, а GGUF упаковывает модель целиком под конкретный движок исполнения. Ближе по духу к GGUF стоит ONNX, где модель тоже переносится одним артефактом, хотя внутри лежит граф вычислений, а не набор весов для заранее известной архитектуры.
| Формат | Что внутри | Токенизатор и гиперпараметры | Квантованные типы ggml | Основной исполнитель |
|---|---|---|---|---|
| GGUF | Типизированные метаданные и выровненные тензоры | В том же файле | Да, от IQ1 до Q8_0, плюс F16, BF16, F32 | llama.cpp, Ollama, LM Studio, GPT4All |
| GGML, GGMF, GGJT | Тензоры и нетипизированный список гиперпараметров | Частично, без идентификатора архитектуры | Да, но GGJT v3 несовместим со старыми квантами | Ранние версии llama.cpp |
| safetensors | Только тензоры | Нет, в соседних config.json и tokenizer.json | Нет | Transformers и другие PyTorch-стеки |
| ONNX | Граф вычислений с весами | Токенизатор отдельно | Через свои операторы, не типы ggml | ONNX Runtime |
Про перенос моделей между средами через ONNX у нас есть отдельный разбор в статье о контейнеризации ML-модели из Spark с помощью ONNX. Задача там та же, что решает GGUF, а именно упаковать модель так, чтобы её мог запустить чужой рантайм.
Когда выбирать GGUF, а когда нет
GGUF оправдан там, где модель нужно запустить локально и без тяжёлой обвязки.
- Локальный инференс. Ноутбук, Mac на Apple Silicon, сервер без мощной GPU, где работают llama.cpp, Ollama или LM Studio.
- Распространение модели одним файлом. Веса, словарь и шаблон чата не разъедутся по версиям.
- Быстрый старт. Благодаря mmap модель стартует без копирования весов в память процесса.
Обучение и дообучение в этот список не входят. Их ведут в PyTorch на весах в исходной точности, а GGUF собирают в конце как формат поставки. Для GPU-сервинга под высокой нагрузкой формат выбирают под конкретный сервер, и про поддержку GGUF лучше читать его документацию. Как выпускать и сопровождать модели в продакшене, разбирают на курсе MLOps. Подробнее о том, кто и как читает GGUF, можно узнать в документации GGUF на Hugging Face Hub.
Практика, читаем GGUF-файл модели из Ollama
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Скачивать GGUF отдельно не нужно, если у вас стоит Ollama. Модель, загруженная командой ollama pull, хранится как обычный GGUF-файл без расширения под именем вида sha256-хеш, а путь к нему указан в манифесте тега, в слое с типом application/vnd.ollama.image.model. Стенд для прогона это Ubuntu 24.04 с Python 3.12, Ollama 0.40.13 в Docker и пакет gguf 0.19.0, официальная Python-библиотека из репозитория llama.cpp. Подопытная модель qwen2.5:0.5b-instruct в двух вариантах квантования, q4_0 и q8_0. Ollama поднимается из файла docker-compose.yml.
# ollama 0.40.13 в Docker, стенд для статьи про GGUF
services:
  ollama:
    image: ollama/ollama:0.40.13
    container_name: gguf-ollama
    mem_limit: 4g
    ports:
      - "127.0.0.1:11434:11434"
    volumes:
      # каталог моделей на хосте: blob-файлы GGUF видны прямо отсюда
      - ./ollama:/root/.ollama
Модели скачиваются, пакет ставится в виртуальное окружение, переменная OLLAMA_MODELS показывает скриптам, где искать файлы.
# Ollama 0.40.13, gguf 0.19.0, команды из RUNBOOK.md, прогнано на стенде 2026-11-03
docker compose up -d
docker exec gguf-ollama ollama pull qwen2.5:0.5b-instruct-q4_0
docker exec gguf-ollama ollama pull qwen2.5:0.5b-instruct-q8_0
# каталог моделей, смонтированный из контейнера
export OLLAMA_MODELS=./ollama/models
python3 -m venv .venv
.venv/bin/pip install gguf==0.19.0
.venv/bin/python gguf_file_anatomy.py qwen2.5:0.5b-instruct-q4_0
.venv/bin/python gguf_quant_mix.py qwen2.5:0.5b-instruct-q4_0 qwen2.5:0.5b-instruct-q8_0
Первый скрипт, gguf_file_anatomy.py, читает 24 байта заголовка стандартным модулем struct, без сторонних библиотек, а потом открывает тот же файл классом GGUFReader и проходит по метаданным и описаниям тензоров.
# gguf 0.19.0, Ollama 0.40.13, модель qwen2.5:0.5b-instruct-q4_0, прогнано на стенде 2026-11-03
"""Что лежит внутри GGUF-файла: заголовок, метаданные и описания тензоров.

Файл берётся прямо из локального хранилища Ollama: модель, скачанная
командой `ollama pull`, лежит там обычным GGUF-файлом под именем-хешем.
"""
import json
import os
import struct
import sys
import time
from pathlib import Path

import gguf

TAG = sys.argv[1] if len(sys.argv) > 1 else "qwen2.5:0.5b-instruct-q4_0"
# каталог моделей Ollama: переменная OLLAMA_MODELS или путь по умолчанию
MODELS_DIR = Path(os.environ.get("OLLAMA_MODELS", Path.home() / ".ollama" / "models"))


def find_gguf_blob(tag: str) -> Path:
    """Путь к GGUF-файлу тега: манифест Ollama перечисляет слои модели."""
    name, _, version = tag.partition(":")
    manifest = (MODELS_DIR / "manifests" / "registry.ollama.ai" / "library"
                / name / (version or "latest"))
    layers = json.loads(manifest.read_text())["layers"]
    # веса модели лежат в слое image.model, остальное это шаблон, лицензия, параметры
    digest = next(l["digest"] for l in layers
                  if l["mediaType"] == "application/vnd.ollama.image.model")
    return MODELS_DIR / "blobs" / digest.replace(":", "-")


path = find_gguf_blob(TAG)
print(f"Модель: {TAG}")
print(f"Файл:   {path.name}  ({path.stat().st_size / 2**20:.1f} МиБ)")

# 1. Заголовок читается без всяких библиотек: 4 байта magic, uint32 версии,
#    два uint64 счётчика. Порядок байтов little-endian.
with open(path, "rb") as f:
    magic, version, n_tensors, n_kv = struct.unpack("<4sIQQ", f.read(24))
print("\n=== Заголовок (первые 24 байта) ===")
print(f"magic={magic!r} version={version} tensor_count={n_tensors} metadata_kv_count={n_kv}")

# 2. Тот же файл через официальный пакет gguf из репозитория llama.cpp
t = time.perf_counter()
reader = gguf.GGUFReader(path)
print(f"\nGGUFReader открыл файл за {time.perf_counter() - t:.2f} с")

print("\n=== Метаданные ключ-значение ===")
for key, field in reader.fields.items():
    if key.startswith("GGUF."):  # служебные поля заголовка, уже показаны выше
        continue
    vtype = field.types[0].name
    if field.types[0] == gguf.GGUFValueType.ARRAY:
        # массивы токенизатора огромные, печатаем только тип и длину
        print(f"{key:42} ARRAY[{field.types[-1].name}] x {len(field.data)}")
    elif key == "tokenizer.chat_template":
        print(f"{key:42} STRING, {len(field.contents())} символов шаблона Jinja")
    else:
        print(f"{key:42} {vtype:8} {field.contents()}")

# general.file_type хранит число, имя типа даёт перечисление LlamaFileType
file_type = reader.fields["general.file_type"].contents()
print(f"\ngeneral.file_type = {file_type} -> {gguf.LlamaFileType(file_type).name}")

# 3. Описания тензоров: имя, форма (в порядке ggml, первым идёт ne0),
#    тип квантования и смещение начала тензора от начала файла
print("\n=== Описания тензоров (первые 6 из", len(reader.tensors), ") ===")
for tensor in reader.tensors[:6]:
    print(f"{tensor.name:28} shape={str([int(d) for d in tensor.shape]):14} "
          f"type={tensor.tensor_type.name:5} offset={tensor.data_offset}")

# 4. Выравнивание: начало каждого тензора кратно general.alignment,
#    поэтому веса можно отобразить в память через mmap без копирования
alignment = reader.alignment
first = min(t.data_offset for t in reader.tensors)
aligned = sum(t.data_offset % alignment == 0 for t in reader.tensors)
print(f"\nВыравнивание: {alignment} байт (ключа general.alignment в файле "
      f"{'нет, взято значение по умолчанию' if 'general.alignment' not in reader.fields else 'есть'})")
print(f"Блок данных начинается со смещения {first} байт "
      f"({first / 2**20:.1f} МиБ ушло на заголовок, метаданные и описания тензоров)")
print(f"Тензоров с выровненным началом: {aligned} из {len(reader.tensors)}")
Вывод на стенде.
Модель: qwen2.5:0.5b-instruct-q4_0
Файл:   sha256-f67632e1c0f66d6fcb0622cb506c8f59f1e42a0ddaa4114ea072490f3557e4dc  (335.8 МиБ)

=== Заголовок (первые 24 байта) ===
magic=b'GGUF' version=3 tensor_count=290 metadata_kv_count=34

GGUFReader открыл файл за 10.01 с

=== Метаданные ключ-значение ===
general.architecture                       STRING   qwen2
general.type                               STRING   model
general.name                               STRING   Qwen2.5 0.5B Instruct
general.finetune                           STRING   Instruct
general.basename                           STRING   Qwen2.5
general.size_label                         STRING   0.5B
general.license                            STRING   apache-2.0
general.license.link                       STRING   https://huggingface.co/Qwen/Qwen2.5-0.5B-Instruct/blob/main/LICENSE
general.base_model.count                   UINT32   1
general.base_model.0.name                  STRING   Qwen2.5 0.5B
general.base_model.0.organization          STRING   Qwen
general.base_model.0.repo_url              STRING   https://huggingface.co/Qwen/Qwen2.5-0.5B
general.tags                               ARRAY[STRING] x 2
general.languages                          ARRAY[STRING] x 1
qwen2.block_count                          UINT32   24
qwen2.context_length                       UINT32   32768
qwen2.embedding_length                     UINT32   896
qwen2.feed_forward_length                  UINT32   4864
qwen2.attention.head_count                 UINT32   14
qwen2.attention.head_count_kv              UINT32   2
qwen2.rope.freq_base                       FLOAT32  1000000.0
qwen2.attention.layer_norm_rms_epsilon     FLOAT32  9.999999974752427e-07
general.file_type                          UINT32   2
tokenizer.ggml.model                       STRING   gpt2
tokenizer.ggml.pre                         STRING   qwen2
tokenizer.ggml.tokens                      ARRAY[STRING] x 151936
tokenizer.ggml.token_type                  ARRAY[INT32] x 151936
tokenizer.ggml.merges                      ARRAY[STRING] x 151387
tokenizer.ggml.eos_token_id                UINT32   151645
tokenizer.ggml.padding_token_id            UINT32   151643
tokenizer.ggml.bos_token_id                UINT32   151643
tokenizer.ggml.add_bos_token               BOOL     False
tokenizer.chat_template                    STRING, 2509 символов шаблона Jinja
general.quantization_version               UINT32   2

general.file_type = 2 -> MOSTLY_Q4_0

=== Описания тензоров (первые 6 из 290 ) ===
token_embd.weight            shape=[896, 151936]  type=Q8_0  offset=5948224
blk.0.attn_norm.weight       shape=[896]          type=F32   offset=150591296
blk.0.ffn_down.weight        shape=[4864, 896]    type=Q4_0  offset=150594880
blk.0.ffn_gate.weight        shape=[896, 4864]    type=Q4_0  offset=153046336
blk.0.ffn_up.weight          shape=[896, 4864]    type=Q4_0  offset=155497792
blk.0.ffn_norm.weight        shape=[896]          type=F32   offset=157949248

Выравнивание: 32 байт (ключа general.alignment в файле нет, взято значение по умолчанию)
Блок данных начинается со смещения 5948224 байт (5.7 МиБ ушло на заголовок, метаданные и описания тензоров)
Тензоров с выровненным началом: 290 из 290
Первые 24 байта подтверждают спецификацию дословно. Тридцать четыре ключа описывают модель полностью, от числа блоков и длины контекста до словаря на 151 936 токенов и шаблона чата на 2509 символов. Размеры тензора записаны в порядке ggml, где первым идёт ne0, число элементов вдоль самой внутренней оси, поэтому матрица эмбеддингов значится как [896, 151936], а не наоборот. Смещение в выводе считается от начала файла, тогда как в самой спецификации смещения отсчитываются от начала блока данных. Около 10 секунд на открытие уходят на разбор словаря в Python-объекты, а не на веса, которые отображаются через mmap.
Второй скрипт, gguf_quant_mix.py, проверяет, насколько суффикс в имени соответствует содержимому, и считает типы тензоров по факту.
# gguf 0.19.0, Ollama 0.40.13, модели qwen2.5:0.5b-instruct-q4_0 и q8_0, прогнано на стенде 2026-11-03
"""Из каких типов квантования на деле собран GGUF-файл.

Суффикс в имени (Q4_0, Q8_0, Q4_K_M) говорит о преобладающем типе, но
отдельные тензоры часто хранятся в другом. Скрипт считает это по факту.
"""
import json
import os
import sys
from collections import defaultdict
from pathlib import Path

import gguf

TAGS = sys.argv[1:] or ["qwen2.5:0.5b-instruct-q4_0", "qwen2.5:0.5b-instruct-q8_0"]
# каталог моделей Ollama: переменная OLLAMA_MODELS или путь по умолчанию
MODELS_DIR = Path(os.environ.get("OLLAMA_MODELS", Path.home() / ".ollama" / "models"))


def find_gguf_blob(tag: str) -> Path:
    """Путь к GGUF-файлу тега: манифест Ollama перечисляет слои модели."""
    name, _, version = tag.partition(":")
    manifest = (MODELS_DIR / "manifests" / "registry.ollama.ai" / "library"
                / name / (version or "latest"))
    layers = json.loads(manifest.read_text())["layers"]
    digest = next(l["digest"] for l in layers
                  if l["mediaType"] == "application/vnd.ollama.image.model")
    return MODELS_DIR / "blobs" / digest.replace(":", "-")


for tag in TAGS:
    path = find_gguf_blob(tag)
    reader = gguf.GGUFReader(path)
    file_type = gguf.LlamaFileType(reader.fields["general.file_type"].contents())

    # по каждому типу тензора: сколько тензоров, весов и байт на диске
    stats = defaultdict(lambda: [0, 0, 0])
    for t in reader.tensors:
        s = stats[t.tensor_type.name]
        s[0] += 1
        s[1] += int(t.n_elements)
        s[2] += int(t.n_bytes)

    total_w = sum(s[1] for s in stats.values())
    total_b = sum(s[2] for s in stats.values())
    print(f"\n=== {tag} ===")
    print(f"размер файла {path.stat().st_size / 2**20:.1f} МиБ, "
          f"general.file_type = {file_type.name}")
    print(f"{'тип':6} {'тензоров':>8} {'весов, млн':>11} {'доля весов':>11} {'бит на вес':>11}")
    for name, (n, w, b) in sorted(stats.items(), key=lambda kv: -kv[1][1]):
        print(f"{name:6} {n:8} {w / 1e6:11.1f} {w / total_w:11.2%} {8 * b / w:11.2f}")
    print(f"итого: {total_w / 1e6:.1f} млн весов, в среднем {8 * total_b / total_w:.2f} бит на вес")

    # какие тензоры хранятся не в «основном» типе файла
    main = max(stats, key=lambda k: stats[k][1])
    other = [t for t in reader.tensors if t.tensor_type.name != main]
    # имя вида blk.7.attn_q.bias сокращаем до attn_q.bias, номер слоя не важен
    kinds = sorted({t.name.split(".", 2)[2] if t.name.startswith("blk.") else t.name
                    for t in other})
    print(f"не в {main}: {len(other)} тензоров, виды: {', '.join(kinds)}")
Вывод на стенде.
=== qwen2.5:0.5b-instruct-q4_0 ===
размер файла 335.8 МиБ, general.file_type = MOSTLY_Q4_0
тип    тензоров  весов, млн  доля весов  бит на вес
Q4_0        168       357.8      72.43%        4.50
Q8_0          1       136.1      27.56%        8.50
F32         121         0.1       0.01%       32.00
итого: 494.0 млн весов, в среднем 5.61 бит на вес
не в Q4_0: 122 тензоров, виды: attn_k.bias, attn_norm.weight, attn_q.bias, attn_v.bias, ffn_norm.weight, output_norm.weight, token_embd.weight

=== qwen2.5:0.5b-instruct-q8_0 ===
размер файла 506.5 МиБ, general.file_type = MOSTLY_Q8_0
тип    тензоров  весов, млн  доля весов  бит на вес
Q8_0        169       494.0      99.99%        8.50
F32         121         0.1       0.01%       32.00
итого: 494.0 млн весов, в среднем 8.50 бит на вес
не в Q8_0: 121 тензоров, виды: attn_k.bias, attn_norm.weight, attn_q.bias, attn_v.bias, ffn_norm.weight, output_norm.weight
Файл с меткой Q4_0 собран из Q4_0 лишь на 72,43% весов. Матрица эмбеддингов, а это 27,56% всех весов, лежит в Q8_0, нормы и bias в F32, и в среднем выходит 5,61 бита на вес вместо 4,5. Тензора output.weight в файле нет вовсе, потому что 290 тензоров это одна матрица эмбеддингов, 24 блока по 12 тензоров и output_norm, и выходной слой делит веса с эмбеддингами. Почему квантователь поднял именно эту матрицу до Q8_0, мы по исходникам не проверяли, так что это наблюдение, а не правило.
Заключение
GGUF решил для локальных LLM ту же задачу, что контейнер решил для сервисов. Модель вместе с токенизатором, гиперпараметрами и шаблоном чата лежит в одном файле, который движок открывает через mmap без копирования. Читать такой файл несложно, заголовок разбирается одной строкой struct, а пакет gguf показывает метаданные и типы тензоров. Главный практический вывод прогона касается имён. Суффикс Q4_0 или Q4_K_M говорит о преобладающем типе, а не о каждом тензоре, и реальный размер модели стоит считать по содержимому файла.