
 16

Содержание
- Что такое витрина данных
- Архитектура витрин данных
- Как устроена витрина данных
- Витрина данных в современном стеке
- Подводные камни
- Когда нужна витрина данных, а когда нет
- Витрина продаж на dbt и DuckDB на практике
- Сырой слой и staging
- Звезда из измерения и факта
- Первая сборка витрины
- Опоздавший заказ и окно пересчёта
- Заключение
- Референсные ссылки
Витрина данных (Data Mart) это предметно-ориентированный срез аналитических данных, собранный под одну команду, отдел или бизнес-домен. Отдел продаж смотрит в витрину продаж, финансисты в финансовую, и никому не приходится искать нужное по всему хранилищу. Внутри витрины лежат уже очищенные, согласованные и агрегированные данные, которые BI-инструмент может читать напрямую. Поэтому витрина данных остаётся главным способом выдать аналитику готовые цифры, хотя сегодня её чаще называют слоем marts в dbt или золотым слоем озера данных.
Что такое витрина данных
Корпоративное хранилище данных (Data Warehouse, DWH) собирает историю всей компании и обслуживает всех сразу. Озеро данных (Data Lake) хранит сырые файлы в исходном виде и не рассчитано на бизнес-пользователя. Витрина данных устроена иначе. Она узкая по охвату, зато широкая по удобству, ведь таблицы в ней названы бизнес-терминами, метрики уже посчитаны, а лишние для конкретной команды поля отброшены.
Разница с хранилищем в первую очередь в масштабе и владельце. Хранилище проектирует центральная команда данных, а у витрины обычно есть конкретный заказчик, который формулирует вопросы и отвечает за смысл метрик. Как следствие, витрина живёт быстрее хранилища. Добавить метрику в витрину одной команды проще, чем менять общую модель DWH, от которой зависят все отделы.
Архитектура витрин данных
Классическая типология делит витрины по тому, откуда они берут данные.
- Зависимая витрина (dependent data mart). Питается только из корпоративного хранилища и представляет собой его логическое или физическое подмножество.
- Независимая витрина (independent data mart). Берёт данные напрямую из операционных систем и внешних источников, минуя хранилище.
- Гибридная витрина (hybrid data mart). Сочетает данные хранилища с источниками, которых в хранилище нет, например с выгрузкой рекламного кабинета.
Независимую витрину проще всего запустить и тяжелее всего сопровождать, потому что у каждого отдела появляется собственная версия правды.
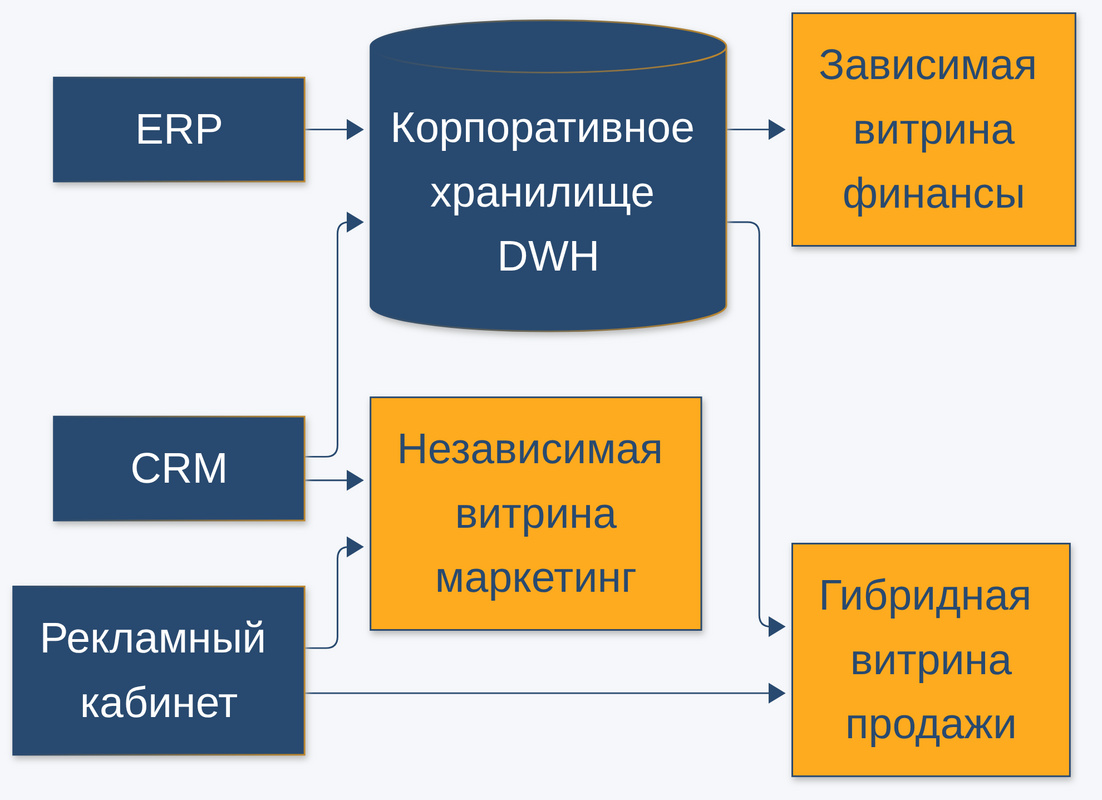
Место витрины в архитектуре зависит от школы проектирования. Bill Inmon (Билл Инмон), которого называют отцом корпоративного хранилища данных, ставит в центр нормализованное DWH, а витрины располагает на периферии как зависимые подмножества для отделов. Ralph Kimball (Ральф Кимбалл), автор методологии размерного моделирования (dimensional modeling), идёт от обратного. В его подходе хранилище и есть совокупность витрин, каждая из которых построена по схеме «звезда», а связывают их общие согласованные измерения (conformed dimensions), например единый справочник клиентов. Как эта идея доменных витрин перекликается с децентрализованным подходом Data Mesh, подробно разобрано в статье блога о хранилище по Кимбаллу и Data Mesh.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Как устроена витрина данных
Путь данных до витрины почти всегда проходит три шага. Сначала конвейер извлечения и загрузки (EL, Extract and Load) кладёт сырые строки из источников в отдельный слой. Затем слой staging приводит типы, переименовывает поля и отбрасывает мусор вроде отменённых заказов, причём бизнес-логики здесь ещё нет. Наконец, сама витрина соединяет очищенные таблицы и считает метрики.
Внутри витрины данные обычно лежат по схеме «звезда» (star schema). В центре находится таблица фактов (fact table) с числовыми показателями, например выручкой по дням. Вокруг неё стоят таблицы измерений (dimension tables), то есть клиенты, регионы, товары, по которым факты режут и фильтруют. Ключевое решение при проектировании это зерно (grain) таблицы фактов, а именно ответ на вопрос, что описывает одна строка. Если зерно «день × регион × сегмент», то в таблице не должно быть двух строк с одинаковой тройкой значений, и это проверяется тестом.
Вторая развилка касается того, как витрина хранится физически. Представление (view) ничего не хранит и считает запрос при каждом обращении. Таблица (table) пересобирается целиком при каждом запуске конвейера. Инкрементальная модель (incremental) дописывает или перезаписывает только свежую часть данных. Чем дальше по этому ряду, тем дешевле запуск и тем больше способов ошибиться.
Витрина данных в современном стеке
Слово «витрина» в документации современных инструментов встречается редко, хотя сама сущность никуда не делась. В dbt (data build tool, инструмент трансформаций на SQL от компании dbt Labs) витрины живут в папке models/marts/. Руководство dbt Labs по структуре проекта dbt описывает marts как модели бизнес-сущностей с понятными именами вроде customers и orders. Там же рекомендуется задавать table на уровне папки и переопределять её на incremental у отдельных моделей.
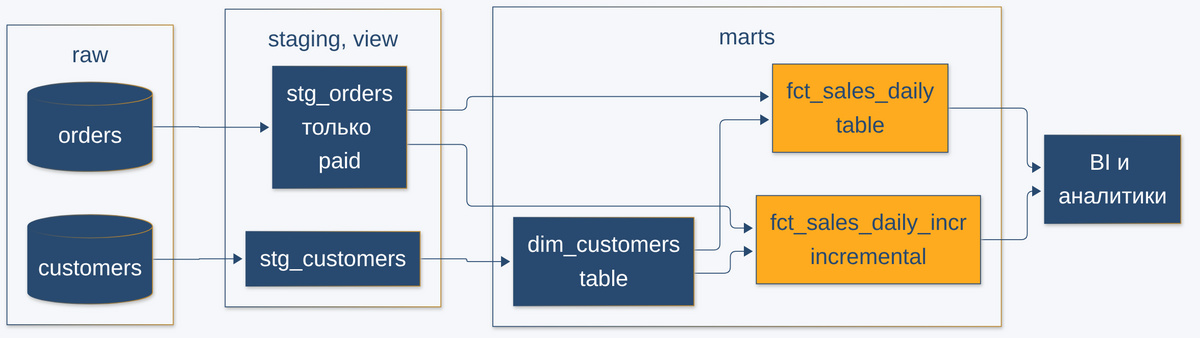
В медальонной архитектуре (medallion architecture), которую продвигает Databricks, компания-разработчик платформы lakehouse (озеро данных с таблицами и транзакциями хранилища), ту же роль играет золотой слой (gold). Данные проходят бронзовый слой с сырыми записями, серебряный с очищенными и проверенными и попадают в золотой, где агрегированы и смоделированы под отчёты. Databricks допускает несколько золотых слоёв для разных областей бизнеса, например HR и финансов, что по сути и есть набор доменных витрин.
Подводные камни
Большинство проблем с витринами возникает не при постройке, а через полгода эксплуатации.
- Зоопарк витрин. Каждая команда строит свою витрину из тех же источников, и через год никто не знает, какая из пяти таблиц с выручкой правильная.
- Расхождение метрик. Отдел продаж считает выручку с возвратами, финансы без них, и на совещании цифры не сходятся. Лечится общими измерениями и единым определением метрики.
- Свежесть. Витрина отстаёт от источника на интервал запуска конвейера, и пользователь должен видеть, на какой момент данные актуальны.
- Цена пересчёта. Полная пересборка большой таблицы фактов дорога, а инкрементальная может молча потерять данные, которые пришли с опозданием.
Последний пункт самый коварный, поэтому выбор материализации стоит делать осознанно.
| Материализация | Что хранит | Свежесть | Цена запуска | Главный риск |
|---|---|---|---|---|
| view | Только текст запроса | Всегда актуальна | Нулевая, платит каждый читатель | Медленные дашборды на больших объёмах |
| table | Полный результат | На момент запуска | Пересчёт всей истории | Растущее время и стоимость сборки |
| incremental | Полный результат, обновляется частями | На момент запуска | Только свежие данные | Потеря опоздавших строк за пределами окна |
| materialized view (материализованное представление) | Результат, который обновляет сама СУБД | Зависит от движка | Ложится на СУБД | Ограничения движка на допустимые запросы |
Для небольших витрин table почти всегда достаточно, а incremental оправдан, когда полный пересчёт уже не укладывается в окно конвейера.
Построение DWH на ClickHouse
Код курса
CLICH
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Когда нужна витрина данных, а когда нет
Витрина нужна, когда у данных есть постоянный потребитель с повторяющимися вопросами. Дашборд продаж, который открывают каждое утро, регулярный отчёт для руководства и признаки для модели машинного обучения выигрывают от заранее посчитанной таблицы. Витрина также отделяет аналитиков от изменений в источниках. Когда в CRM переименуют поле, править придётся staging, а запросы к витрине останутся прежними.
Отдельная витрина не нужна для разового исследования, которое проще выполнить запросом к хранилищу, и для данных, которые смотрит один человек раз в квартал. Не стоит строить её и раньше, чем понятно зерно и определения метрик, потому что переделка витрины, на которую уже подписаны дашборды, обходится дороже. Строить витрины в dbt по слоям, покрывать их тестами и выбирать материализацию учат на курсе по dbt для инженеров данных.
Витрина продаж на dbt и DuckDB на практике
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо собирает витрину продаж на dbt-core 1.12.6 с адаптером dbt-duckdb 1.11.1. Хранилищем служит DuckDB 2.0.0, встраиваемая аналитическая СУБД, поэтому база это один файл warehouse.duckdb в папке проекта, а сервер и Docker не нужны. Прогон выполнен на Ubuntu 24.04 с Python 3.12.3. Один и тот же факт продаж собран дважды, в материализациях table и incremental, чтобы на догрузке сравнить их результаты. dbt 1.12.6 при каждом запуске сообщает, что доступна линия v2 и для новых установок она уже по умолчанию. Демо проверено на линии v1.
Сырой слой и staging
Скрипт load_orders.py имитирует конвейер загрузки. Первая партия создаёт справочник из шести клиентов и десять заказов за 1-3 октября 2026 года, вторая дописывает заказы за 4 и 5 октября и один заказ за 2 октября, который пришёл с опозданием.
# duckdb 2.0.0, прогнано на стенде 2026-11-03
"""Имитация EL-загрузки: кладёт партию заказов в сырой слой raw хранилища DuckDB.

Запуск: python load_orders.py 1   (первая партия, слой raw создаётся заново)
        python load_orders.py 2   (догрузка: новые дни и один опоздавший заказ)
"""
import sys
from pathlib import Path

import duckdb

HERE = Path(__file__).resolve().parent
DB = HERE / "warehouse.duckdb"

batch = int(sys.argv[1]) if len(sys.argv) > 1 else 1
con = duckdb.connect(str(DB))
con.execute("CREATE SCHEMA IF NOT EXISTS raw")

if batch == 1:
    # Первая загрузка: справочник клиентов и заказы с нуля
    con.execute("CREATE OR REPLACE TABLE raw.customers AS SELECT * FROM read_csv_auto(?)",
                [str(HERE / "data" / "customers.csv")])
    con.execute("CREATE OR REPLACE TABLE raw.orders AS SELECT * FROM read_csv_auto(?)",
                [str(HERE / "data" / "orders_batch1.csv")])
else:
    # Догрузка: дописываем строки, как это делает ежедневный EL-конвейер
    con.execute("INSERT INTO raw.orders SELECT * FROM read_csv_auto(?)",
                [str(HERE / "data" / f"orders_batch{batch}.csv")])

rows, last_day = con.execute("SELECT count(*), max(order_date) FROM raw.orders").fetchone()
print(f"партия {batch}: в raw.orders строк={rows}, последний день={last_day}")
con.close()
Слои и материализации по умолчанию задаются в dbt_project.yml. Staging собран из представлений, витрины из таблиц, а переменная lookback_days задаёт, сколько уже загруженных дней инкрементальная модель пересчитывает заново.
# dbt-core 1.12.6, dbt-duckdb 1.11.1, прогнано на стенде 2026-11-03
name: 'data_mart_demo'
version: '1.0.0'
config-version: 2
profile: 'data_mart_demo'

model-paths: ["models"]
target-path: "target"
clean-targets: ["target"]

vars:
  # Сколько уже загруженных дней витрина пересчитывает при инкрементальном запуске.
  # 0 = только последний день и новые: опоздавшие заказы за прошлые дни потеряются.
  lookback_days: 0

models:
  data_mart_demo:
    staging:
      # Staging дешёвый и всегда свежий: представления поверх сырого слоя
      +materialized: view
      +schema: staging
    marts:
      # Витрины по умолчанию таблицы: BI читает их часто, считать на лету дорого
      +materialized: table
      +schema: marts
Модель stg_orders приводит типы и оставляет только оплаченные заказы, поэтому отменённые и возвращённые в выручку не попадают.
-- dbt-core 1.12.6, dbt-duckdb 1.11.1, прогнано на стенде 2026-11-03
-- Staging: типы, имена, фильтр мусора. Бизнес-логики здесь нет.
select
    order_id,
    customer_id,
    cast(order_date as date)          as order_date,
    cast(amount as decimal(12, 2))    as amount,
    status
from {{ source('raw', 'orders') }}
where status = 'paid'   -- отменённые и возвращённые заказы в выручку не идут
Звезда из измерения и факта
Измерение dim_customers хранит одну строку на клиента с регионом и сегментом.
-- dbt-core 1.12.6, dbt-duckdb 1.11.1, прогнано на стенде 2026-11-03
-- Измерение «клиент» витрины продаж: одна строка на клиента
select
    customer_id,
    customer_name,
    region,
    segment
from {{ ref('stg_customers') }}
Факт fct_sales_daily в материализации table при каждом запуске пересчитывает всю историю.
-- dbt-core 1.12.6, dbt-duckdb 1.11.1, прогнано на стенде 2026-11-03
-- Витрина продаж, материализация table: каждый запуск пересчитывает всю историю.
-- Зерно: день × регион × сегмент.
select
    o.order_date                    as sale_date,
    c.region,
    c.segment,
    count(*)                        as orders_cnt,
    count(distinct o.customer_id)   as customers_cnt,
    sum(o.amount)                   as revenue
from {{ ref('stg_orders') }} o
join {{ ref('dim_customers') }} c using (customer_id)
group by 1, 2, 3
Модель fct_sales_daily_incr считает тот же факт, но в материализации incremental со стратегией delete+insert. На повторном запуске dbt берёт дни начиная с последнего загруженного минус окно, удаляет из витрины строки с тем же ключом зерна и вставляет их заново.
-- dbt-core 1.12.6, dbt-duckdb 1.11.1, прогнано на стенде 2026-11-03
-- Та же витрина продаж, материализация incremental: пересчитываются только свежие дни.
-- delete+insert по ключу зерна: строки с ключами из новой выборки удаляются и вставляются заново.
{{ config(
    materialized='incremental',
    incremental_strategy='delete+insert',
    unique_key=['sale_date', 'region', 'segment']
) }}

select
    o.order_date                    as sale_date,
    c.region,
    c.segment,
    count(*)                        as orders_cnt,
    count(distinct o.customer_id)   as customers_cnt,
    sum(o.amount)                   as revenue
from {{ ref('stg_orders') }} o
join {{ ref('dim_customers') }} c using (customer_id)
{% if is_incremental() %}
-- Берём дни начиная с последнего загруженного минус окно lookback_days.
-- Заказ, опоздавший дальше этого окна, в витрину не попадёт до full-refresh.
where o.order_date >= (
    select max(sale_date) - {{ var('lookback_days') }} from {{ this }}
)
{% endif %}
group by 1, 2, 3
Тест зерна assert_sales_grain_unique падает, если на одну тройку «день, регион, сегмент» пришлось больше одной строки.
-- dbt-core 1.12.6, прогнано на стенде 2026-11-03
-- Тест зерна витрины: на день × регион × сегмент ровно одна строка. Вернул строки = упал.
select sale_date, region, segment, count(*) as dup
from {{ ref('fct_sales_daily_incr') }}
group by 1, 2, 3
having count(*) > 1
Скрипт compare_marts.py сверяет выручку по дням в обеих материализациях и выполняет типичный запрос аналитика к витрине.
# duckdb 2.0.0, прогнано на стенде 2026-11-03
"""Сверка двух материализаций одной витрины: table против incremental.

Печатает выручку по дням из обеих таблиц и дни, где они расходятся.
"""
from pathlib import Path

import duckdb

DB = Path(__file__).resolve().parent / "warehouse.duckdb"
con = duckdb.connect(str(DB), read_only=True)

rows = con.execute("""
    with t as (select sale_date, sum(revenue) as rev from marts.fct_sales_daily group by 1),
         i as (select sale_date, sum(revenue) as rev from marts.fct_sales_daily_incr group by 1)
    select coalesce(t.sale_date, i.sale_date) as day, t.rev as table_rev, i.rev as incr_rev
    from t full join i on t.sale_date = i.sale_date
    order by 1
""").fetchall()

print(f"{'день':12}{'incremental':>14}")
diff = 0
for day, t_rev, i_rev in rows:
    mark = "" if t_rev == i_rev else "   <-- расхождение"
    diff += mark != ""
    print(f"{day!s:12}{i_rev!s:>14}{mark}")

# Запрос аналитика к витрине: так её читает BI
print("\nвыручка по регионам (из витрины):")
for region, rev in con.execute(
        "select region, sum(revenue) from marts.fct_sales_daily group by 1 order by 2 desc").fetchall():
    print(f"  {region:<16}{rev}")

print(f"\nдней с расхождением: {diff}")
con.close()
Первая сборка витрины
# dbt-core 1.12.6, dbt-duckdb 1.11.1, прогнано на стенде 2026-11-03
# Окружение и профиль из папки проекта
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
export DBT_PROFILES_DIR=$PWD

# Первая партия в raw, затем вся сборка с тестами и сверка
.venv/bin/python load_orders.py 1
.venv/bin/dbt build
.venv/bin/python compare_marts.py
# вывод прогона на стенде 2026-11-03, dbt-core 1.12.6
партия 1: в raw.orders строк=10, последний день=2026-10-03
...
1 of 10 START sql view model staging.stg_customers ............................. [RUN]
3 of 10 START sql table model marts.dim_customers .............................. [RUN]
7 of 10 START sql incremental model marts.fct_sales_daily_incr ................. [RUN]
...
Finished running 1 incremental model, 2 table models, 5 data tests, 2 view models in 0 hours 0 minutes and 2.29 seconds (2.29s).
Done. PASS=10 WARN=0 ERROR=0 SKIP=0 NO-OP=0 REUSED=0 TOTAL=10

день               table   incremental
2026-10-01      22200.00      22200.00
2026-10-02      18500.00      18500.00
2026-10-03      11100.00      11100.00

выручка по регионам (из витрины):
  Москва          24200.00
  Казань          16600.00
  Санкт-Петербург 11000.00

дней с расхождением: 0
dbt построил модели по графу зависимостей, сначала представления staging, потом измерение и только после него оба факта. На первом запуске инкрементальная модель строится целиком, поэтому совпадает с таблицей.
Опоздавший заказ и окно пересчёта
# dbt-core 1.12.6, dbt-duckdb 1.11.1, прогнано на стенде 2026-11-03
# Догрузка: новые дни и заказ 1015 за 2026-10-02 на 5000.00
.venv/bin/python load_orders.py 2
.venv/bin/dbt run --select marts
# Какие дни взял incremental и сколько строк в каждой витрине
grep -A2 "^where" target/compiled/data_mart_demo/models/marts/sales/fct_sales_daily_incr.sql
.venv/bin/python -c "import duckdb; print('  строк в витринах:', duckdb.connect('warehouse.duckdb', read_only=True).execute('select (select count(*) from marts.fct_sales_daily), (select count(*) from marts.fct_sales_daily_incr)').fetchone())"
.venv/bin/python compare_marts.py
# Тесты на этом состоянии
.venv/bin/dbt test
# вывод прогона на стенде 2026-11-03, dbt-core 1.12.6
партия 2: в raw.orders строк=15, последний день=2026-10-05
...
where o.order_date >= (
    select max(sale_date) - 0 from "warehouse"."marts"."fct_sales_daily_incr"
)
  строк в витринах: (13, 12)

день               table   incremental
2026-10-01      22200.00      22200.00
2026-10-02      23500.00      18500.00   <-- расхождение
2026-10-03      11100.00      11100.00
2026-10-04      10700.00      10700.00
2026-10-05      13100.00      13100.00

выручка по регионам (из витрины):
  Москва          37300.00
  Казань          24200.00
  Санкт-Петербург 19100.00

дней с расхождением: 1
...
Done. PASS=5 WARN=0 ERROR=0 SKIP=0 NO-OP=0 REUSED=0 TOTAL=5
Таблица пересчитала всю историю и увидела опоздавший заказ. Инкрементальная модель с окном 0 взяла дни начиная с 3 октября и про 2 октября не узнала, поэтому выручка за этот день занижена на 5000.00. Опоздавший заказ принадлежит клиенту из Санкт-Петербурга в сегменте b2b, такой строки зерна за 2 октября раньше не было, и в инкрементальной витрине осталось 12 строк против 13 в таблице. Все пять тестов при этом зелёные, потому что проверяют ключи и уникальность зерна, а не полноту, и ошибку ловит только сверка с полным пересчётом. dbt-duckdb 1.11.1 записывает в run_results.json значение rows_affected=None, так что по артефактам dbt нельзя понять, сколько строк пересчитал инкрементальный запуск. Что именно попало в пересчёт, видно только в скомпилированном SQL в папке target/compiled.
# dbt-core 1.12.6, dbt-duckdb 1.11.1, прогнано на стенде 2026-11-03
# Тот же запуск с окном в три дня, затем тесты
.venv/bin/dbt run --select fct_sales_daily_incr --vars '{lookback_days: 3}'
# Какие дни взял incremental и сколько строк в каждой витрине
grep -A2 "^where" target/compiled/data_mart_demo/models/marts/sales/fct_sales_daily_incr.sql
.venv/bin/python -c "import duckdb; print('  строк в витринах:', duckdb.connect('warehouse.duckdb', read_only=True).execute('select (select count(*) from marts.fct_sales_daily), (select count(*) from marts.fct_sales_daily_incr)').fetchone())"
.venv/bin/python compare_marts.py
.venv/bin/dbt test
# вывод прогона на стенде 2026-11-03, dbt-core 1.12.6
Unable to do partial parsing because config vars, config profile, or config target have changed
...
where o.order_date >= (
    select max(sale_date) - 3 from "warehouse"."marts"."fct_sales_daily_incr"
)
  строк в витринах: (13, 13)

день               table   incremental
2026-10-01      22200.00      22200.00
2026-10-02      23500.00      23500.00
2026-10-03      11100.00      11100.00
2026-10-04      10700.00      10700.00
2026-10-05      13100.00      13100.00
...
дней с расхождением: 0
...
1 of 5 PASS assert_sales_grain_unique .......................................... [PASS in 0.11s]
...
Done. PASS=5 WARN=0 ERROR=0 SKIP=0 NO-OP=0 REUSED=0 TOTAL=5
С окном в три дня 2 октября попало в пересчёт, стратегия delete+insert удалила строки с теми же ключами зерна и вставила пересчитанные, и витрины сошлись без дублей. Строка зерна, которая за пересчитанный день исчезла из источника, например после возврата заказа, при этом осталась бы в витрине. Цена окна в том, что каждый запуск пересчитывает три лишних дня. Смена —vars отключает частичный разбор проекта (partial parsing). С ним разбор пяти моделей занимал около двух секунд, а полный без него от четырёх до шести.
Заключение
Витрина данных превращает хранилище в набор готовых ответов для конкретных команд. Тип витрины определяется источником данных, внутреннее устройство чаще всего задаёт схема «звезда», а в современном стеке витрины живут в слое marts dbt или в золотом слое lakehouse. Главное практическое правило из прогона в том, что инкрементальная витрина экономит время сборки, но без окна пересчёта молча теряет опоздавшие данные при зелёных тестах, поэтому окно нужно выбирать по реальной задержке источников и периодически сверять витрину с полным пересчётом.