
 1
Содержание
- Что изменилось в CTAS и RTAS для Iceberg
- Как Iceberg делает CTAS атомарным через staging
- SparkCatalog и SparkSessionCatalog в роли каталога
- CTAS, RTAS, INSERT OVERWRITE и два шага в сравнении
- Прогон на Spark и Iceberg с падением запроса и откатом
- Базовый CTAS и что он не наследует
- CTAS с падением посередине в двух каталогах
- RTAS со сменой схемы и партиционирования
- RTAS с падением и попытка отката
- Два шага и INSERT OVERWRITE для контраста
- RTAS и INSERT OVERWRITE на одном сценарии
- Ограничения и что вылезло на прогоне
- Когда применять RTAS, а когда INSERT OVERWRITE
- Заключение
- Референсные ссылки
9 ноября 2026 года Dremio, вендор lakehouse-платформы на базе Apache Iceberg, опубликовал разбор, в котором атомарные CTAS и RTAS в Apache Iceberg объясняются через выбор каталога и staging, а не через сам табличный формат. Для тех, кто собирает витрины на Spark, вывод неприятный. Одна и та же команда CTAS (CREATE TABLE AS SELECT, создание таблицы из запроса) в одном каталоге публикует таблицу единым коммитом, а в другом, если верить документации, атомарности не даёт. С RTAS (REPLACE TABLE AS SELECT, замена таблицы результатом запроса) ставки выше, ведь под ударом оказывается работающая витрина вместе с её историей. Мы подняли локальный Spark с двумя каталогами в одной сессии, именованным SparkCatalog и SparkSessionCatalog, уронили запросы посередине и посмотрели, что осталось в листинге, в метатаблицах snapshots и history и на диске. Часть результатов совпала с документацией, часть разошлась, и расхождения оказались полезнее совпадений.
Короткий ответ. Атомарный CTAS или RTAS в Apache Iceberg это создание или замена таблицы, при которой каталог публикует новую таблицу или новый snapshot одним коммитом метаданных только после записи всех data-файлов. Если запрос падает, таблица в каталоге остаётся прежней. Документация Iceberg гарантирует такое поведение для SparkCatalog и не гарантирует для SparkSessionCatalog.
Что изменилось в CTAS и RTAS для Iceberg
Повод для статьи это разбор Dremio об атомарных CTAS и RTAS, автор которого сверял документацию Iceberg в день публикации. Мы уже разбирали новость о CTAS и RTAS коротко, поэтому здесь только суть. Dremio утверждает три вещи. Атомарность CTAS и RTAS обеспечивает каталог, который умеет создавать таблицу в режиме staging. Неудачная запись не меняет таблицу, но оставляет на диске файлы-сироты до сборки мусора. Откат после RTAS возможен, пока прежний snapshot не удалён через expire (очистку старых snapshot по сроку хранения, в Spark это процедура expire_snapshots). Чисел в материале нет, ни латентности коммита, ни объёма orphan-файлов, и список метрик у автора качественный.
Новость не показывает, как именно таблица не попадает в каталог до коммита, чем RTAS отличается от INSERT OVERWRITE и двухшагового CREATE плюс INSERT, и что происходит, если запрос действительно падает. Это мы и проверили руками. Версионный контекст такой. Страница релизов Apache Iceberg называет последней версию 1.12.0, но дату её выхода не показывает. Подтверждённые даты оттуда же относятся к 1.10.1 (22 декабря 2025), 1.10.0 (11 сентября 2025) и 1.9.2 (16 июля 2025). Прочитанный раздел Spark DDL относится к nightly-документации, а не к тегу 1.12.0. Прогон мы делали на iceberg-spark-runtime 1.10.1, собранном под Spark 3.5, и это расхождение версий держим в уме при чтении результатов.
Как Iceberg делает CTAS атомарным через staging
Начнём с документации Iceberg по Spark DDL. Атомарность CTAS и RTAS определяется реализацией каталога в Spark, а не форматом таблицы. При SparkCatalog операция атомарна, при SparkSessionCatalog нет. Сам формат Iceberg уже умеет главное, состояние таблицы задаётся одним файлом metadata.json, и смена указателя на этот файл переключает всех читателей на новую версию целиком. Поэтому весь вопрос сводится к тому, когда таблица впервые появляется в каталоге, до записи данных или после неё.
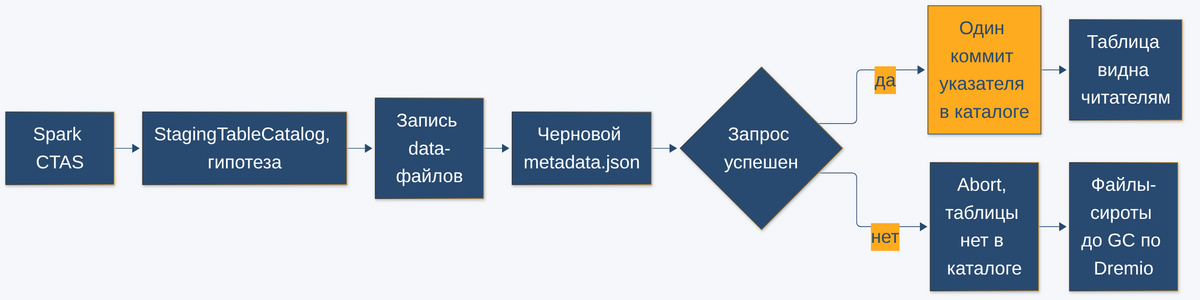
Dremio описывает конвейер staged commit в четыре шага. Это вендорский пересказ, а не спецификация, но он хорошо ложится на то, что мы увидим в прогоне.
- Writer пишет data-файлы в хранилище таблицы, пока ни один читатель о них не знает.
- Затем формируется черновой metadata-файл с новой схемой, partition spec (описание того, как таблица разбита на партиции) и snapshot.
- Каталог атомарно переключает указатель на этот metadata-файл, и только в этот момент таблица или её новая версия становится видимой.
- Если переключение не удалось или запрос упал раньше, таблица не меняется, а уже записанные data-файлы и временные метаданные остаются сиротами до garbage collection.
Отсюда ответ на главный практический вопрос. Полупустая таблица после CTAS появляется тогда, когда каталог регистрирует объект в начале операции, а данные приезжают потом. Если регистрация совпадает с финальным коммитом, промежуточного состояния снаружи просто нет. В терминах Spark DataSource V2 (второй версии API источников данных Spark, через который подключаются внешние каталоги и табличные форматы) за такое поведение, судя по названию, отвечает интерфейс StagingTableCatalog с методами stageCreate и stageReplace. Эту связь по первоисточнику мы не сверяли, поэтому держим её как рабочую гипотезу, а не как факт.
С RTAS механизм тот же, а последствия другие. По документации CREATE OR REPLACE TABLE … AS SELECT не удаляет таблицу и не создаёт её заново, а добавляет новый snapshot с результатом SELECT и сохраняет историю, поэтому откат к прежнему snapshot считается возможным. При этом RTAS заменяет schema и partition spec, если в DDL они другие или вовсе не указаны, а table properties сливает со старыми. CTAS, наоборот, ничего не берёт из источника, ни partition spec, ни TBLPROPERTIES, и всё это нужно задавать явно через PARTITIONED BY и TBLPROPERTIES. INSERT OVERWRITE оставляет schema и партиционирование нетронутыми, и документация прямо советует его вместо REPLACE TABLE, если layout трогать нельзя.
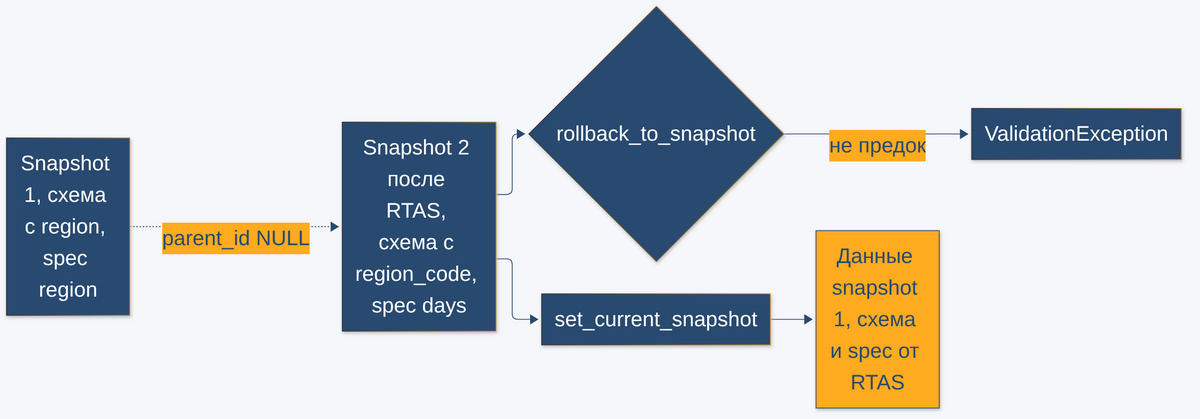
Схема уже учитывает то, что нашлось в прогоне. Новый snapshot после RTAS не ссылается на старый через parent_id, и это меняет механику отката сильнее, чем можно ожидать по документации. Подробности будут в разделе с практикой.
SparkCatalog и SparkSessionCatalog в роли каталога
В Spark каталог задаётся конфигурацией сессии. SparkCatalog регистрируется под собственным именем, в нашем стенде это lake, и таблицы в нём адресуются с префиксом каталога. SparkSessionCatalog встаёт на место встроенного spark_catalog и оборачивает его. Iceberg-таблицы он обслуживает сам, а остальные отдаёт исходному каталогу сессии, который в продакшене обычно связан с Hive Metastore. Поэтому он удобен при постепенном переходе, когда в одном пространстве имён живут и старые Hive-таблицы, и новые Iceberg-таблицы, а SQL не приходится переписывать под префиксы. Такой переход, то есть миграция с Hive на Iceberg, подробно разобран отдельно, и там таблицы переводятся как раз через CTAS и snapshot.
Платой за удобство становится атомарность. Документация говорит, что при SparkSessionCatalog CTAS и RTAS поддерживаются, но не атомарны. Для витрин, которые пересобираются по расписанию и читаются дашбордами, это означает возможное окно, когда потребитель видит таблицу без данных или с частью данных. Рекомендация из документации и из материала Dremio одна и та же, для атомарной записи держите отдельный именованный SparkCatalog и не смешивайте его с session catalog.
Тип каталога в стенде hadoop. Он хранит указатель на текущий metadata.json в файле version-hint.text рядом с таблицей и не требует никаких сервисов. Это учебный вариант, удобный для локального прогона. В продакшене роль каталога играют REST catalog, Hive Metastore, Nessie (каталог для Iceberg с git-подобными ветками и коммитами) или AWS Glue Data Catalog (управляемый каталог метаданных в AWS), и гарантии коммита там определяет конкретная реализация, а не наш стенд.
CTAS, RTAS, INSERT OVERWRITE и два шага в сравнении
Четыре способа получить или пересобрать таблицу различаются тем, где они работают и что видит потребитель в момент записи. Две последние строки таблицы заполнены по итогам прогона.
| Критерий | CTAS и RTAS в SparkCatalog | INSERT OVERWRITE | CREATE TABLE + INSERT INTO | CTAS и RTAS в Spark |
|---|---|---|---|---|
| Модель развёртывания | Отдельный именованный каталог Iceberg в Spark, в прогоне type hadoop | Тот же Spark и тот же каталог Iceberg, таблица уже существует | Любой каталог, включая Spark |
Iceberg поверх встроенного spark_catalog, обычно вместе с Hive Metastore (интерпретация) |
| Сильная сторона | Таблица или новая версия появляется одним коммитом, по документации операция атомарна | Не меняет schema и partitioning, документация рекомендует его вместо REPLACE TABLE | Schema и spec задаются явно, таблицу можно проверить до переключения трафика | Iceberg- и не-Iceberg-таблицы видны в одном пространстве имён без префикса |
| Слабая сторона | RTAS может незаметно сменить партиционирование, если PARTITIONED BY не указан | Таблица должна существовать, структуру он не меняет, атомарность по каталогам в разделе не описана | Между CREATE и INSERT видна пустая таблица, коммитов два | CTAS и RTAS поддерживаются, но по документации не атомарны |
| Связь нового snapshot с прежним | После RTAS parent_id пустой, rollback_ |
parent_id нового snapshot указывает на предыдущий | До успешного INSERT snapshot нет совсем, первый появляется с данными | Не проверялось |
| Что показал прогон | После сбоя таблицы нет, файлов 0, повторный CTAS с тем же именем прошёл | Упавший запрос ничего не изменил, новый snapshot ссылается на предыдущий | После упавшего INSERT пустая таблица осталась в каталоге | Неатомарность не воспроизвелась, успешная таблица не видна в SHOW TABLES |
CTAS и RTAS в SparkCatalog закрывают задачу опубликовать новую таблицу или новую версию одним движением, и прогон это подтвердил. INSERT OVERWRITE решает задачу уже, он заменяет данные без изменения структуры, зато с точки зрения отката ведёт себя аккуратнее RTAS, потому что сохраняет цепочку предков. Два шага нужны там, где каталог атомарности не даёт, но за это приходится платить видимым окном с пустой таблицей, и его закрывают организационно, например не переключают потребителей до проверки. SparkSessionCatalog выбирают ради совместимости со старыми таблицами, а не ради надёжной записи, и последняя ячейка его строки говорит скорее о нашем стенде, чем о гарантиях.
Прогон на Spark и Iceberg с падением запроса и откатом
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий.
Стенд локальный, без Docker и внешних сервисов. В requirements.txt зафиксированы pyspark 3.5.6, py4j 0.10.9.7 и install-jdk 1.1.0, а iceberg-spark-runtime-3.5_2.12 версии 1.10.1 Spark скачивает из Maven Central через spark.jars.packages при первом запуске. Java взята из локального кеша Temurin 17, точную сборку назвать не можем, потому что в журнале прогона версия замаскирована. Spark работает в режиме local[2]. В одной сессии живут два каталога, lake как SparkCatalog с type hadoop и spark_catalog как SparkSessionCatalog поверх in-memory session catalog. Каждый скрипт перед стартом удаляет свой каталог данных, так что прогоны независимы. Свойство владельца в демо называется team, а не owner, потому что в Spark 3.5 ключ owner зарезервирован и TBLPROPERTIES с ним падает. Все шесть сценариев завершились с кодом 0, итог прогона 6 из 6, порядок запуска и ожидаемый вывод описаны в RUNBOOK.md.
Базовый CTAS и что он не наследует
Первый сценарий создаёт источник lake.db.orders_src на 10 000 строк с партиционированием по region и двумя свойствами, затем делает две копии. Первая копия создаётся голым CTAS, вторая с явными PARTITIONED BY и TBLPROPERTIES.
# pyspark 3.5.6, iceberg-spark-runtime-3.5_2.12 1.10.1; код написан для статьи iceberg_ctas_rtas_atomicity по документации Iceberg spark-ddl (nightly), не копия сниппетов Dremio
"""Сценарий 1. Базовый CTAS в именованном каталоге SparkCatalog.

SHOW TABLES, метатаблица snapshots, файлы метаданных и проверка того,
что CTAS не переносит partition spec и TBLPROPERTIES источника.
"""
import os
import shutil
import sys
from pathlib import Path

from pyspark.sql import SparkSession

ICEBERG_VERSION = "1.10.1"
ICEBERG_PACKAGE = f"org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:{ICEBERG_VERSION}"
DEMO = "01_ctas_basic"
BASE = Path(__file__).resolve().parent
os.chdir(BASE)  # все пути дальше относительные, от каталога статьи
ROOT = Path("data") / DEMO
# 'owner' в Spark 3.5 зарезервированное свойство (UNSUPPORTED_FEATURE.SET_TABLE_PROPERTY), берём 'team'
KEYS = ("team", "history.expire.max-snapshot-age-ms", "quality")

SOURCE_SQL = """
CREATE TABLE lake.db.orders_src
USING iceberg
PARTITIONED BY (region)
TBLPROPERTIES ('team' = 'sales', 'history.expire.max-snapshot-age-ms' = '604800000')
AS SELECT
  id AS order_id,
  id % 500 AS customer_id,
  CAST(round(rand(42) * 1000, 2) AS DOUBLE) AS amount,
  timestamp_seconds(1767225600 + id * 60) AS order_ts,
  element_at(array('EU', 'US', 'APAC'), CAST(id % 3 AS INT) + 1) AS region
FROM range(0, {rows})
"""


def build_spark():
    # чистый стенд на каждый запуск: у каждого каталога свой warehouse внутри data/
    shutil.rmtree(ROOT, ignore_errors=True)
    ROOT.mkdir(parents=True)
    os.environ["PYSPARK_PYTHON"] = sys.executable
    os.environ["SPARK_LOCAL_IP"] = "127.0.0.1"
    spark = (
        SparkSession.builder.master("local[2]")
        .appName(DEMO)
        .config("spark.driver.memory", "2g")
        .config("spark.jars.packages", ICEBERG_PACKAGE)
        .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions")
        # lake: отдельный именованный каталог Iceberg (SparkCatalog); type=hadoop только для учебного стенда
        .config("spark.sql.catalog.lake", "org.apache.iceberg.spark.SparkCatalog")
        .config("spark.sql.catalog.lake.type", "hadoop")
        .config("spark.sql.catalog.lake.warehouse", (BASE / ROOT / "lake").as_uri())
        # spark_catalog: Iceberg поверх встроенного session catalog (SparkSessionCatalog)
        .config("spark.sql.catalog.spark_catalog", "org.apache.iceberg.spark.SparkSessionCatalog")
        .config("spark.sql.catalog.spark_catalog.type", "hadoop")
        .config("spark.sql.catalog.spark_catalog.warehouse", (BASE / ROOT / "session").as_uri())
        .config("spark.sql.catalogImplementation", "in-memory")
        .config("spark.sql.warehouse.dir", (BASE / ROOT / "spark").as_uri())
        .config("spark.driver.host", "127.0.0.1")
        .config("spark.driver.bindAddress", "127.0.0.1")
        .config("spark.ui.enabled", "false")
        .config("spark.ui.showConsoleProgress", "false")
        .config("spark.sql.shuffle.partitions", "4")
        .getOrCreate()
    )
    spark.sparkContext.setLogLevel("ERROR")
    return spark


def step(title):
    print(f"\n--- {title} ---", flush=True)


def partitioning(spark, table):
    # Spark 3.5: только identity-партиции идут в '# Partition Information' именами колонок,
    # с трансформами (days, bucket) — в '# Partitioning' строками 'Part N'
    rows = spark.sql(f"DESCRIBE TABLE {table}").collect()
    parts, section = [], None
    for r in rows:
        name = (r["col_name"] or "").strip()
        if not name:
            section = None
        elif name == "# Partition Information":
            section = "identity"
        elif name == "# Partitioning":
            section = "transform"
        elif name.startswith("# col_name"):
            continue
        elif name.startswith("#"):
            section = None
        elif section == "identity":
            parts.append(name)
        elif section == "transform" and name.startswith("Part "):
            parts.append(r["data_type"])
    return ", ".join(parts) if parts else "без партиционирования"


def props(spark, table):
    rows = {r["key"]: r["value"] for r in spark.sql(f"SHOW TBLPROPERTIES {table}").collect()}
    return {k: rows.get(k, "—") for k in KEYS}


def show_snapshots(spark, table):
    spark.sql(
        f"""SELECT snapshot_id, parent_id, operation,
                   summary['added-records'] AS added_records,
                   summary['total-records'] AS total_records
            FROM {table}.snapshots ORDER BY committed_at"""
    ).show(truncate=False)


def metadata_files(table_dir):
    meta = table_dir / "metadata"
    if not meta.exists():
        return []
    return sorted(
        p.name for p in meta.iterdir()
        if p.is_file() and (p.name.endswith(".metadata.json") or p.name == "version-hint.text")
    )


def main():
    spark = build_spark()
    try:
        step("1. CTAS исходной таблицы lake.db.orders_src: PARTITIONED BY (region), TBLPROPERTIES team")
        spark.sql("CREATE NAMESPACE IF NOT EXISTS lake.db")
        spark.sql(SOURCE_SQL.format(rows=10000))
        print("SHOW TABLES IN lake.db:")
        spark.sql("SHOW TABLES IN lake.db").show(truncate=False)
        print("Метатаблица snapshots после CTAS:")
        show_snapshots(spark, "lake.db.orders_src")
        src_dir = ROOT / "lake" / "db" / "orders_src"
        print(f"Каталог таблицы: {src_dir.as_posix()}")
        print(f"Файлы метаданных: {metadata_files(src_dir)}")

        step("2. CTAS-копия без PARTITIONED BY и TBLPROPERTIES")
        spark.sql("CREATE TABLE lake.db.orders_copy USING iceberg AS SELECT * FROM lake.db.orders_src")

        step("3. CTAS-копия, где spec и свойства заданы явно")
        spark.sql(
            """CREATE TABLE lake.db.orders_copy_explicit
               USING iceberg
               PARTITIONED BY (region)
               TBLPROPERTIES ('team' = 'sales', 'history.expire.max-snapshot-age-ms' = '604800000')
               AS SELECT * FROM lake.db.orders_src"""
        )

        step("4. Что унаследовали копии")
        for t in ("lake.db.orders_src", "lake.db.orders_copy", "lake.db.orders_copy_explicit"):
            n = spark.sql(f"SELECT count(*) AS n FROM {t}").first()["n"]
            print(f"{t}: строк {n}; партиционирование: {partitioning(spark, t)}; свойства: {props(spark, t)}")
        same = partitioning(spark, "lake.db.orders_copy") == partitioning(spark, "lake.db.orders_src")
        print("Вывод: CTAS без PARTITIONED BY " + ("сохранил spec источника" if same else "не перенёс spec источника"))
    finally:
        spark.stop()
    return 0


if __name__ == "__main__":
    sys.exit(main())
--- 1. CTAS исходной таблицы lake.db.orders_src: PARTITIONED BY (region), TBLPROPERTIES team ---
SHOW TABLES IN lake.db:
+---------+----------+-----------+
|namespace|tableName |isTemporary|
+---------+----------+-----------+
|db       |orders_src|false      |
+---------+----------+-----------+

Метатаблица snapshots после CTAS:
+-------------------+---------+---------+-------------+-------------+
|snapshot_id        |parent_id|operation|added_records|total_records|
+-------------------+---------+---------+-------------+-------------+
|1916259393187323803|NULL     |append   |10000        |10000        |
+-------------------+---------+---------+-------------+-------------+

Каталог таблицы: data/01_ctas_basic/lake/db/orders_src
Файлы метаданных: ['v1.metadata.json', 'version-hint.text']
…
Вывод: CTAS без PARTITIONED BY не перенёс spec источника
CTAS дал ровно один snapshot с операцией append и один v1.metadata.json рядом с version-hint.text, то есть таблица родилась одним коммитом. В пропущенных строках шага 4 видно остальное. У копии без PARTITIONED BY партиционирования нет, а оба свойства источника отсутствуют. У копии с явным DDL партиционирование по region и свойства team и history.expire.max-snapshot-age-ms на месте. Документация здесь подтвердилась полностью, CTAS копирует данные, но не layout и не настройки.
CTAS с падением посередине в двух каталогах
Второй сценарий регистрирует UDF (User-Defined Function, пользовательская функция) boom_at, которая бросает исключение на order_id=7000. Сбой задуман посреди записи, но промежуточное состояние на диске до него прогон не фиксировал, видно только итог после сбоя. Состояние после сбоя проверяется по трём независимым каналам, через SHOW TABLES, через SELECT count(*) и по файлам на диске.
# pyspark 3.5.6, iceberg-spark-runtime-3.5_2.12 1.10.1; код написан для статьи iceberg_ctas_rtas_atomicity по документации Iceberg spark-ddl (nightly), сценарий failure injection по мотивам Dremio
"""Сценарий 2. CTAS, который падает посередине, в двух каталогах одной сессии.

UDF бросает исключение на order_id=7000. После сбоя проверяем три канала:
SHOW TABLES, SELECT count(*) и файлы на диске.
"""
import os
import re
import shutil
import sys
from pathlib import Path

from pyspark.sql import SparkSession
from pyspark.sql.types import LongType

ICEBERG_VERSION = "1.10.1"
ICEBERG_PACKAGE = f"org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:{ICEBERG_VERSION}"
DEMO = "02_ctas_failure"
BASE = Path(__file__).resolve().parent
os.chdir(BASE)  # все пути дальше относительные, от каталога статьи
ROOT = Path("data") / DEMO
PATH_RE = re.compile(r"(file:|(?<![\w.])/[\w.\-]+/)")
FAIL_AT = 7000

# 'owner' в Spark 3.5 зарезервирован, свойство владельца называем 'team'
SOURCE_SQL = """
CREATE TABLE lake.db.orders_src
USING iceberg
PARTITIONED BY (region)
TBLPROPERTIES ('team' = 'sales', 'history.expire.max-snapshot-age-ms' = '604800000')
AS SELECT
  id AS order_id,
  id % 500 AS customer_id,
  CAST(round(rand(42) * 1000, 2) AS DOUBLE) AS amount,
  timestamp_seconds(1767225600 + id * 60) AS order_ts,
  element_at(array('EU', 'US', 'APAC'), CAST(id % 3 AS INT) + 1) AS region
FROM range(0, {rows})
"""

FAIL_SELECT = (
    "SELECT boom_at(order_id) AS order_id, customer_id, amount, order_ts, region "
    "FROM lake.db.orders_src"
)


def build_spark():
    # чистый стенд на каждый запуск: у каждого каталога свой warehouse внутри data/
    shutil.rmtree(ROOT, ignore_errors=True)
    ROOT.mkdir(parents=True)
    os.environ["PYSPARK_PYTHON"] = sys.executable
    os.environ["SPARK_LOCAL_IP"] = "127.0.0.1"
    spark = (
        SparkSession.builder.master("local[2]")
        .appName(DEMO)
        .config("spark.driver.memory", "2g")
        .config("spark.jars.packages", ICEBERG_PACKAGE)
        .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions")
        .config("spark.sql.catalog.lake", "org.apache.iceberg.spark.SparkCatalog")
        .config("spark.sql.catalog.lake.type", "hadoop")
        .config("spark.sql.catalog.lake.warehouse", (BASE / ROOT / "lake").as_uri())
        .config("spark.sql.catalog.spark_catalog", "org.apache.iceberg.spark.SparkSessionCatalog")
        .config("spark.sql.catalog.spark_catalog.type", "hadoop")
        .config("spark.sql.catalog.spark_catalog.warehouse", (BASE / ROOT / "session").as_uri())
        .config("spark.sql.catalogImplementation", "in-memory")
        .config("spark.sql.warehouse.dir", (BASE / ROOT / "spark").as_uri())
        .config("spark.driver.host", "127.0.0.1")
        .config("spark.driver.bindAddress", "127.0.0.1")
        .config("spark.ui.enabled", "false")
        .config("spark.ui.showConsoleProgress", "false")
        .config("spark.sql.shuffle.partitions", "4")
        .getOrCreate()
    )
    spark.sparkContext.setLogLevel("ERROR")
    return spark


def boom_at(order_id):
    # падаем на одной строке: другие задачи успевают записать свои data-файлы
    if order_id == FAIL_AT:
        raise RuntimeError(f"INJECTED_FAILURE at order_id={order_id}")
    return order_id


def short_err(e):
    # класс исключения и фраза до первого пути: без путей, PID и интерпретатора
    lines = [line.strip() for line in str(e).splitlines() if line.strip()]
    pick = next((line for line in lines if "INJECTED_FAILURE" in line), None)
    if pick is None:
        pick = next((line for line in lines if re.search(r"(Exception|Error)\b", line) and not line.startswith("at ")),
                    lines[0] if lines else "")
    pick = PATH_RE.split(pick, maxsplit=1)[0].strip()
    return f"{type(e).__name__}: {pick[:200]}"


def step(title):
    print(f"\n--- {title} ---", flush=True)


def disk_summary(path):
    if not path.exists():
        return f"на диске {path.as_posix()}: каталога нет"
    files = [p for p in path.rglob("*") if p.is_file()]
    parquet = sum(1 for p in files if p.suffix == ".parquet")
    meta = sum(1 for p in files if p.name.endswith(".metadata.json"))
    return f"на диске {path.as_posix()}: файлов {len(files)}, parquet {parquet}, metadata.json {meta}"


def probe(spark, catalog, ns, table, path):
    # три независимых канала: листинг каталога, чтение и файловая система
    names = {r["tableName"] for r in spark.sql(f"SHOW TABLES IN {catalog}.{ns}").collect()}
    listed = table in names
    try:
        n = spark.sql(f"SELECT count(*) AS n FROM {catalog}.{ns}.{table}").first()["n"]
        read, readable = f"читается, строк {n}", True
    except Exception as e:
        read, readable = f"не читается, {short_err(e)}", False
    print(f"  {catalog}.{ns}.{table}")
    print(f"    SHOW TABLES: {'есть' if listed else 'нет'}")
    print(f"    SELECT count(*): {read}")
    print(f"    {disk_summary(path)}")
    return listed or readable


def run_failing(spark, sql):
    try:
        spark.sql(sql)
        print("  запрос неожиданно прошёл")
        return False
    except Exception as e:
        print(f"  запрос упал: {short_err(e)}")
        return True


def main():
    spark = build_spark()
    try:
        step(f"0. Источник lake.db.orders_src и UDF boom_at, которая падает на order_id={FAIL_AT}")
        spark.sql("CREATE NAMESPACE IF NOT EXISTS lake.db")
        spark.sql(SOURCE_SQL.format(rows=10000))
        spark.udf.register("boom_at", boom_at, LongType())
        print("  строк в источнике:", spark.sql("SELECT count(*) AS n FROM lake.db.orders_src").first()["n"])

        step("1. Эталон: успешный CTAS в spark_catalog (SparkSessionCatalog)")
        spark.sql(
            "CREATE TABLE spark_catalog.default.ctas_ok_session USING iceberg "
            "AS SELECT * FROM lake.db.orders_src WHERE region = 'EU'"
        )
        probe(spark, "spark_catalog", "default", "ctas_ok_session", ROOT / "session" / "default" / "ctas_ok_session")
        print("  так выглядит успешная таблица в трёх каналах проверки, с этим сравниваем сбои ниже")

        cases = [
            ("lake", "db", "ctas_fail", "iceberg", ROOT / "lake" / "db" / "ctas_fail",
             "SparkCatalog, USING iceberg"),
            ("spark_catalog", "default", "ctas_fail_session", "iceberg",
             ROOT / "session" / "default" / "ctas_fail_session", "SparkSessionCatalog, USING iceberg"),
            ("spark_catalog", "default", "ctas_fail_parquet", "parquet",
             ROOT / "spark" / "ctas_fail_parquet", "SparkSessionCatalog, USING parquet (не Iceberg)"),
        ]
        for i, (catalog, ns, table, fmt, path, label) in enumerate(cases, start=2):
            step(f"{i}. CTAS с падением: {label}")
            run_failing(spark, f"CREATE TABLE {catalog}.{ns}.{table} USING {fmt} AS {FAIL_SELECT}")
            left = probe(spark, catalog, ns, table, path)
            print("  итог: " + ("после сбоя таблица видна, поведение неатомарное" if left
                               else "после сбоя таблицы нет ни в листинге, ни для SELECT"))

        step("5. Повторный CTAS с тем же именем в lake: имя свободно?")
        try:
            spark.sql("CREATE TABLE lake.db.ctas_fail USING iceberg AS SELECT * FROM lake.db.orders_src WHERE region = 'US'")
            print("  повторный CTAS прошёл")
        except Exception as e:
            print(f"  повторный CTAS упал: {short_err(e)}")
        probe(spark, "lake", "db", "ctas_fail", ROOT / "lake" / "db" / "ctas_fail")
    finally:
        spark.stop()
    return 0


if __name__ == "__main__":
    sys.exit(main())
--- 1. Эталон: успешный CTAS в spark_catalog (SparkSessionCatalog) ---
  spark_catalog.default.ctas_ok_session
    SHOW TABLES: нет
    SELECT count(*): читается, строк 3334
    на диске data/02_ctas_failure/session/default/ctas_ok_session: файлов 10, parquet 1, metadata.json 1
…
--- 2. CTAS с падением: SparkCatalog, USING iceberg ---
  запрос упал: PythonException: raise RuntimeError(f"INJECTED_FAILURE at order_id={order_id}")
  lake.db.ctas_fail
    SHOW TABLES: нет
…
    на диске data/02_ctas_failure/lake/db/ctas_fail: файлов 0, parquet 0, metadata.json 0
  итог: после сбоя таблицы нет ни в листинге, ни для SELECT

--- 3. CTAS с падением: SparkSessionCatalog, USING iceberg ---
  запрос упал: PythonException: raise RuntimeError(f"INJECTED_FAILURE at order_id={order_id}")
  spark_catalog.default.ctas_fail_session
    SHOW TABLES: нет
…
    на диске data/02_ctas_failure/session/default/ctas_fail_session: файлов 0, parquet 0, metadata.json 0
  итог: после сбоя таблицы нет ни в листинге, ни для SELECT
…
--- 5. Повторный CTAS с тем же именем в lake: имя свободно? ---
  повторный CTAS прошёл
  lake.db.ctas_fail
    SHOW TABLES: есть
    SELECT count(*): читается, строк 3333
    на диске data/02_ctas_failure/lake/db/ctas_fail: файлов 10, parquet 1, metadata.json 1
В SparkCatalog всё ровно так, как обещает staging. После сбоя таблицы нет в листинге, SELECT падает с TABLE_OR_VIEW_NOT_FOUND, а в каталоге таблицы на диске ноль файлов. Имя осталось свободным, и повторный CTAS с ним прошёл без ручной уборки. Неожиданность в другом. В SparkSessionCatalog упавший CTAS тоже не оставил ни таблицы, ни файлов, и то же случилось с обычной parquet-таблицей в пропущенном шаге 4. Неатомарность, о которой пишет документация, на связке in-memory session catalog и hadoop не воспроизвелась. Вероятно, она проявляется там, где session catalog регистрирует таблицу в Hive Metastore до записи данных, но это наша интерпретация, на HMS мы не проверяли. Второе наблюдение касается эталона. Успешно созданная Iceberg-таблица в spark_catalog читается и лежит на диске, но в SHOW TABLES её нет. Листинг SparkSessionCatalog нельзя считать надёжным способом проверить, существует ли таблица.
RTAS со сменой схемы и партиционирования
Третий сценарий берёт витрину lake.db.sales с партиционированием по region и делает CREATE OR REPLACE TABLE … AS SELECT, который убирает customer_id, переводит amount в DECIMAL(12,2), переименовывает region в region_code, меняет spec на days(order_ts) и добавляет свойство quality. Затем идёт REPLACE TABLE с тем же SELECT, но без PARTITIONED BY.
# pyspark 3.5.6, iceberg-spark-runtime-3.5_2.12 1.10.1; код написан для статьи iceberg_ctas_rtas_atomicity по документации Iceberg spark-ddl (nightly), не копия сниппетов Dremio
"""Сценарий 3. RTAS со сменой схемы и партиционирования.

Показывает схему, spec, свойства (слияние TBLPROPERTIES), history и snapshots,
а затем REPLACE TABLE ... AS SELECT без PARTITIONED BY, который снимает spec.
"""
import os
import shutil
import sys
from pathlib import Path

from pyspark.sql import SparkSession

ICEBERG_VERSION = "1.10.1"
ICEBERG_PACKAGE = f"org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:{ICEBERG_VERSION}"
DEMO = "03_rtas_schema_change"
BASE = Path(__file__).resolve().parent
os.chdir(BASE)  # все пути дальше относительные, от каталога статьи
ROOT = Path("data") / DEMO
# 'owner' в Spark 3.5 зарезервирован, свойство владельца называем 'team'
KEYS = ("team", "history.expire.max-snapshot-age-ms", "quality")
TABLE = "lake.db.sales"

SOURCE_SQL = """
CREATE TABLE lake.db.orders_src
USING iceberg
PARTITIONED BY (region)
TBLPROPERTIES ('team' = 'sales', 'history.expire.max-snapshot-age-ms' = '604800000')
AS SELECT
  id AS order_id,
  id % 500 AS customer_id,
  CAST(round(rand(42) * 1000, 2) AS DOUBLE) AS amount,
  timestamp_seconds(1767225600 + id * 60) AS order_ts,
  element_at(array('EU', 'US', 'APAC'), CAST(id % 3 AS INT) + 1) AS region
FROM range(0, {rows})
"""

CREATE_SALES = """
CREATE TABLE lake.db.sales
USING iceberg
PARTITIONED BY (region)
TBLPROPERTIES ('team' = 'sales', 'history.expire.max-snapshot-age-ms' = '604800000')
AS SELECT * FROM lake.db.orders_src
"""

# RTAS: убираем customer_id, меняем тип amount, переименовываем region, другой spec и новое свойство
RTAS_NEW_LAYOUT = """
CREATE OR REPLACE TABLE lake.db.sales
USING iceberg
PARTITIONED BY (days(order_ts))
TBLPROPERTIES ('quality' = 'checked')
AS SELECT order_id, CAST(amount AS DECIMAL(12, 2)) AS amount, order_ts, lower(region) AS region_code
FROM lake.db.orders_src WHERE amount > 100
"""

# тот же SELECT, но PARTITIONED BY забыли: spec заменится на пустой
RTAS_NO_SPEC = """
REPLACE TABLE lake.db.sales
USING iceberg
AS SELECT order_id, CAST(amount AS DECIMAL(12, 2)) AS amount, order_ts, lower(region) AS region_code
FROM lake.db.orders_src WHERE amount > 100
"""


def build_spark():
    # чистый стенд на каждый запуск: у каждого каталога свой warehouse внутри data/
    shutil.rmtree(ROOT, ignore_errors=True)
    ROOT.mkdir(parents=True)
    os.environ["PYSPARK_PYTHON"] = sys.executable
    os.environ["SPARK_LOCAL_IP"] = "127.0.0.1"
    spark = (
        SparkSession.builder.master("local[2]")
        .appName(DEMO)
        .config("spark.driver.memory", "2g")
        .config("spark.jars.packages", ICEBERG_PACKAGE)
        .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions")
        .config("spark.sql.catalog.lake", "org.apache.iceberg.spark.SparkCatalog")
        .config("spark.sql.catalog.lake.type", "hadoop")
        .config("spark.sql.catalog.lake.warehouse", (BASE / ROOT / "lake").as_uri())
        .config("spark.sql.catalog.spark_catalog", "org.apache.iceberg.spark.SparkSessionCatalog")
        .config("spark.sql.catalog.spark_catalog.type", "hadoop")
        .config("spark.sql.catalog.spark_catalog.warehouse", (BASE / ROOT / "session").as_uri())
        .config("spark.sql.catalogImplementation", "in-memory")
        .config("spark.sql.warehouse.dir", (BASE / ROOT / "spark").as_uri())
        .config("spark.driver.host", "127.0.0.1")
        .config("spark.driver.bindAddress", "127.0.0.1")
        .config("spark.ui.enabled", "false")
        .config("spark.ui.showConsoleProgress", "false")
        .config("spark.sql.shuffle.partitions", "4")
        .getOrCreate()
    )
    spark.sparkContext.setLogLevel("ERROR")
    return spark


def step(title):
    print(f"\n--- {title} ---", flush=True)


def partitioning(spark, table):
    # Spark 3.5: только identity-партиции идут в '# Partition Information' именами колонок,
    # с трансформами (days, bucket) — в '# Partitioning' строками 'Part N'
    rows = spark.sql(f"DESCRIBE TABLE {table}").collect()
    parts, section = [], None
    for r in rows:
        name = (r["col_name"] or "").strip()
        if not name:
            section = None
        elif name == "# Partition Information":
            section = "identity"
        elif name == "# Partitioning":
            section = "transform"
        elif name.startswith("# col_name"):
            continue
        elif name.startswith("#"):
            section = None
        elif section == "identity":
            parts.append(name)
        elif section == "transform" and name.startswith("Part "):
            parts.append(r["data_type"])
    return ", ".join(parts) if parts else "без партиционирования"


def props(spark, table):
    rows = {r["key"]: r["value"] for r in spark.sql(f"SHOW TBLPROPERTIES {table}").collect()}
    return {k: rows.get(k, "—") for k in KEYS}


def current_snapshot(spark, table):
    row = spark.sql(f"SELECT snapshot_id FROM {table}.refs WHERE name = 'main'").first()
    return row["snapshot_id"] if row else None


def describe(spark, table):
    n = spark.sql(f"SELECT count(*) AS n FROM {table}").first()["n"]
    print(f"  схема: {spark.table(table).schema.simpleString()}")
    print(f"  партиционирование: {partitioning(spark, table)}")
    print(f"  свойства: {props(spark, table)}")
    print(f"  строк: {n}; текущий snapshot: {current_snapshot(spark, table)}")


def show_history(spark, table):
    print("  history:")
    spark.sql(
        f"SELECT snapshot_id, parent_id, is_current_ancestor FROM {table}.history ORDER BY made_current_at"
    ).show(truncate=False)


def show_snapshots(spark, table):
    print("  snapshots:")
    spark.sql(
        f"""SELECT snapshot_id, parent_id, operation,
                   summary['added-records'] AS added_records,
                   summary['total-records'] AS total_records
            FROM {table}.snapshots ORDER BY committed_at"""
    ).show(truncate=False)


def main():
    spark = build_spark()
    try:
        step("1. Витрина lake.db.sales: PARTITIONED BY (region), TBLPROPERTIES team")
        spark.sql("CREATE NAMESPACE IF NOT EXISTS lake.db")
        spark.sql(SOURCE_SQL.format(rows=10000))
        spark.sql(CREATE_SALES)
        describe(spark, TABLE)
        before_spec = partitioning(spark, TABLE)

        step("2. CREATE OR REPLACE TABLE ... AS SELECT: новая схема, days(order_ts), свойство quality")
        spark.sql(RTAS_NEW_LAYOUT)
        describe(spark, TABLE)
        p = props(spark, TABLE)
        print("  свойство team после RTAS: " + ("сохранилось, свойства слились" if p["team"] != "—" else "пропало"))
        print(f"  spec: было {before_spec}, стало {partitioning(spark, TABLE)}")
        show_history(spark, TABLE)
        show_snapshots(spark, TABLE)

        step("3. REPLACE TABLE ... AS SELECT без PARTITIONED BY")
        spec_before = partitioning(spark, TABLE)
        spark.sql(RTAS_NO_SPEC)
        describe(spark, TABLE)
        print(f"  spec: было {spec_before}, стало {partitioning(spark, TABLE)}")
        show_history(spark, TABLE)
        show_snapshots(spark, TABLE)

        step("4. Время до RTAS доступно через time travel")
        first = spark.sql(f"SELECT snapshot_id FROM {TABLE}.snapshots ORDER BY committed_at LIMIT 1").first()["snapshot_id"]
        old = spark.sql(f"SELECT * FROM {TABLE} VERSION AS OF {first}")
        print(f"  snapshot {first}: строк {old.count()}, схема {old.schema.simpleString()}")
    finally:
        spark.stop()
    return 0


if __name__ == "__main__":
    sys.exit(main())
--- 2. CREATE OR REPLACE TABLE ... AS SELECT: новая схема, days(order_ts), свойство quality ---
  схема: struct<order_id:bigint,amount:decimal(12,2),order_ts:timestamp,region_code:string>
  партиционирование: days(order_ts)
  свойства: {'team': 'sales', 'history.expire.max-snapshot-age-ms': '604800000', 'quality': 'checked'}
  строк: 8982; текущий snapshot: 5157505787453439607
  свойство team после RTAS: сохранилось, свойства слились
  spec: было region, стало days(order_ts)
  history:
+-------------------+---------+-------------------+
|snapshot_id        |parent_id|is_current_ancestor|
+-------------------+---------+-------------------+
|1671683582699332689|NULL     |false              |
|5157505787453439607|NULL     |true               |
+-------------------+---------+-------------------+

  snapshots:
+-------------------+---------+---------+-------------+-------------+
|snapshot_id        |parent_id|operation|added_records|total_records|
+-------------------+---------+---------+-------------+-------------+
|1671683582699332689|NULL     |append   |10000        |10000        |
|5157505787453439607|NULL     |overwrite|8982         |8982         |
+-------------------+---------+---------+-------------+-------------+
…
  spec: было days(order_ts), стало без партиционирования
…
--- 4. Время до RTAS доступно через time travel ---
  snapshot 1671683582699332689: строк 10000, схема struct<order_id:bigint,customer_id:bigint,amount:double,order_ts:timestamp,region:string>
Документация подтвердилась в трёх пунктах. Схема и spec заменены целиком, свойство team пережило RTAS, а quality добавилось, то есть properties слились. Старый snapshot остался в метаданных и читается через VERSION AS OF со старой схемой и всеми 10 000 строк. Важная деталь видна в столбце parent_id. У snapshot после RTAS он пустой, а старый snapshot помечен is_current_ancestor false. История сохраняется как набор версий, но не как цепочка, и это аукнется на откате. Второй REPLACE без PARTITIONED BY молча снял партиционирование, ни предупреждения, ни ошибки. Если в ночной пересборке витрины кто-то забудет строку с PARTITIONED BY, layout изменится, а заметят это только по деградации запросов.
RTAS с падением и попытка отката
Четвёртый сценарий сначала роняет RTAS на той же строке 7000, затем выполняет успешный RTAS только по региону EU с новой схемой и spec и пытается вернуть витрину к исходному snapshot через CALL lake.system.rollback_to_snapshot. Если процедура откажет, скрипт пробует set_current_snapshot.
# pyspark 3.5.6, iceberg-spark-runtime-3.5_2.12 1.10.1; код написан для статьи iceberg_ctas_rtas_atomicity по документации Iceberg spark-ddl и spark-procedures (nightly), не копия сниппетов Dremio
"""Сценарий 4. RTAS с падением и откат после успешного RTAS.

Сначала RTAS падает посередине: проверяем, что snapshot, строки и схема те же.
Затем успешный RTAS и откат через CALL lake.system.rollback_to_snapshot.
Если процедура откажет, пробуем set_current_snapshot и печатаем, что случилось.
"""
import os
import re
import shutil
import sys
from pathlib import Path

from pyspark.sql import SparkSession
from pyspark.sql.types import LongType

ICEBERG_VERSION = "1.10.1"
ICEBERG_PACKAGE = f"org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:{ICEBERG_VERSION}"
DEMO = "04_rtas_failure_rollback"
BASE = Path(__file__).resolve().parent
os.chdir(BASE)  # все пути дальше относительные, от каталога статьи
ROOT = Path("data") / DEMO
PATH_RE = re.compile(r"(file:|(?<![\w.])/[\w.\-]+/)")
FAIL_AT = 7000
TABLE = "lake.db.sales"
TABLE_DIR = ROOT / "lake" / "db" / "sales"

# 'owner' в Spark 3.5 зарезервирован, свойство владельца называем 'team'
SOURCE_SQL = """
CREATE TABLE lake.db.orders_src
USING iceberg
PARTITIONED BY (region)
TBLPROPERTIES ('team' = 'sales', 'history.expire.max-snapshot-age-ms' = '604800000')
AS SELECT
  id AS order_id,
  id % 500 AS customer_id,
  CAST(round(rand(42) * 1000, 2) AS DOUBLE) AS amount,
  timestamp_seconds(1767225600 + id * 60) AS order_ts,
  element_at(array('EU', 'US', 'APAC'), CAST(id % 3 AS INT) + 1) AS region
FROM range(0, {rows})
"""

CREATE_SALES = """
CREATE TABLE lake.db.sales USING iceberg PARTITIONED BY (region)
AS SELECT * FROM lake.db.orders_src
"""

RTAS_FAIL = """
CREATE OR REPLACE TABLE lake.db.sales USING iceberg PARTITIONED BY (days(order_ts))
AS SELECT boom_at(order_id) AS order_id, amount, order_ts, lower(region) AS region_code
FROM lake.db.orders_src
"""

# успешный RTAS: только EU, без customer_id, с новой колонкой region_code; тип amount тот же
RTAS_OK = """
CREATE OR REPLACE TABLE lake.db.sales USING iceberg PARTITIONED BY (days(order_ts))
AS SELECT order_id, amount, order_ts, lower(region) AS region_code
FROM lake.db.orders_src WHERE region = 'EU'
"""


def build_spark():
    # чистый стенд на каждый запуск: у каждого каталога свой warehouse внутри data/
    shutil.rmtree(ROOT, ignore_errors=True)
    ROOT.mkdir(parents=True)
    os.environ["PYSPARK_PYTHON"] = sys.executable
    os.environ["SPARK_LOCAL_IP"] = "127.0.0.1"
    spark = (
        SparkSession.builder.master("local[2]")
        .appName(DEMO)
        .config("spark.driver.memory", "2g")
        .config("spark.jars.packages", ICEBERG_PACKAGE)
        .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions")
        .config("spark.sql.catalog.lake", "org.apache.iceberg.spark.SparkCatalog")
        .config("spark.sql.catalog.lake.type", "hadoop")
        .config("spark.sql.catalog.lake.warehouse", (BASE / ROOT / "lake").as_uri())
        .config("spark.sql.catalog.spark_catalog", "org.apache.iceberg.spark.SparkSessionCatalog")
        .config("spark.sql.catalog.spark_catalog.type", "hadoop")
        .config("spark.sql.catalog.spark_catalog.warehouse", (BASE / ROOT / "session").as_uri())
        .config("spark.sql.catalogImplementation", "in-memory")
        .config("spark.sql.warehouse.dir", (BASE / ROOT / "spark").as_uri())
        .config("spark.driver.host", "127.0.0.1")
        .config("spark.driver.bindAddress", "127.0.0.1")
        .config("spark.ui.enabled", "false")
        .config("spark.ui.showConsoleProgress", "false")
        .config("spark.sql.shuffle.partitions", "4")
        .getOrCreate()
    )
    spark.sparkContext.setLogLevel("ERROR")
    return spark


def boom_at(order_id):
    if order_id == FAIL_AT:
        raise RuntimeError(f"INJECTED_FAILURE at order_id={order_id}")
    return order_id


def short_err(e):
    lines = [line.strip() for line in str(e).splitlines() if line.strip()]
    pick = next((line for line in lines if "INJECTED_FAILURE" in line), None)
    if pick is None:
        causes = [line for line in lines if line.startswith("Caused by:")]
        pick = causes[-1] if causes else None
    if pick is None:
        pick = next((line for line in lines if re.search(r"(Exception|Error)\b", line) and not line.startswith("at ")),
                    lines[0] if lines else "")
    pick = PATH_RE.split(pick, maxsplit=1)[0].strip()
    return f"{type(e).__name__}: {pick[:200]}"


def step(title):
    print(f"\n--- {title} ---", flush=True)


def partitioning(spark, table):
    # Spark 3.5: только identity-партиции идут в '# Partition Information' именами колонок,
    # с трансформами (days, bucket) — в '# Partitioning' строками 'Part N'
    rows = spark.sql(f"DESCRIBE TABLE {table}").collect()
    parts, section = [], None
    for r in rows:
        name = (r["col_name"] or "").strip()
        if not name:
            section = None
        elif name == "# Partition Information":
            section = "identity"
        elif name == "# Partitioning":
            section = "transform"
        elif name.startswith("# col_name"):
            continue
        elif name.startswith("#"):
            section = None
        elif section == "identity":
            parts.append(name)
        elif section == "transform" and name.startswith("Part "):
            parts.append(r["data_type"])
    return ", ".join(parts) if parts else "без партиционирования"


def current_snapshot(spark, table):
    row = spark.sql(f"SELECT snapshot_id FROM {table}.refs WHERE name = 'main'").first()
    return row["snapshot_id"] if row else None


def safe(fn):
    try:
        return fn()
    except Exception as e:
        return f"ошибка, {short_err(e)}"


def state(spark):
    # снимок состояния таблицы: каталог, данные и файлы на диске
    files = [p for p in TABLE_DIR.rglob("*") if p.is_file()] if TABLE_DIR.exists() else []
    return {
        "текущий snapshot": safe(lambda: current_snapshot(spark, TABLE)),
        "строк": safe(lambda: spark.sql(f"SELECT count(*) AS n FROM {TABLE}").first()["n"]),
        "схема": safe(lambda: spark.table(TABLE).schema.simpleString()),
        "партиционирование": safe(lambda: partitioning(spark, TABLE)),
        "snapshots в метаданных": safe(lambda: spark.sql(f"SELECT count(*) AS n FROM {TABLE}.snapshots").first()["n"]),
        "metadata.json на диске": sum(1 for p in files if p.name.endswith(".metadata.json")),
        "parquet на диске": sum(1 for p in files if p.suffix == ".parquet"),
    }


def print_state(st):
    for k, v in st.items():
        print(f"  {k}: {v}")


def compare(before, after):
    for k in before:
        mark = "не изменилось" if before[k] == after[k] else "ИЗМЕНИЛОСЬ"
        print(f"  {k}: до {before[k]}, после {after[k]} ({mark})")


def show_history(spark):
    spark.sql(
        f"SELECT snapshot_id, parent_id, is_current_ancestor FROM {TABLE}.history ORDER BY made_current_at"
    ).show(truncate=False)


def main():
    spark = build_spark()
    try:
        step("1. Витрина lake.db.sales до экспериментов")
        spark.sql("CREATE NAMESPACE IF NOT EXISTS lake.db")
        spark.sql(SOURCE_SQL.format(rows=10000))
        spark.udf.register("boom_at", boom_at, LongType())
        spark.sql(CREATE_SALES)
        original = state(spark)
        print_state(original)
        original_snapshot = original["текущий snapshot"]

        step(f"2. RTAS, который падает на order_id={FAIL_AT}")
        try:
            spark.sql(RTAS_FAIL)
            print("  RTAS неожиданно прошёл")
        except Exception as e:
            print(f"  RTAS упал: {short_err(e)}")
        after_fail = state(spark)
        compare(original, after_fail)
        extra = after_fail["parquet на диске"] - original["parquet на диске"]
        print(f"  лишних parquet-файлов после сбоя: {extra} (кандидаты в orphan-файлы)")

        step("3. Успешный RTAS: только EU, другая схема и spec")
        spark.sql(RTAS_OK)
        print_state(state(spark))
        print("  history после RTAS:")
        show_history(spark)

        step(f"4. Откат на snapshot {original_snapshot} через rollback_to_snapshot")
        try:
            spark.sql(
                f"CALL lake.system.rollback_to_snapshot(table => 'db.sales', snapshot_id => {original_snapshot})"
            ).show(truncate=False)
            print("  rollback_to_snapshot выполнен")
        except Exception as e:
            print(f"  rollback_to_snapshot отказал: {short_err(e)}")
            print("  пробуем set_current_snapshot: он не требует, чтобы snapshot был предком текущего")
            try:
                spark.sql(
                    f"CALL lake.system.set_current_snapshot(table => 'db.sales', snapshot_id => {original_snapshot})"
                ).show(truncate=False)
                print("  set_current_snapshot выполнен")
            except Exception as e2:
                print(f"  set_current_snapshot тоже отказал: {short_err(e2)}")

        step("5. Состояние после отката")
        spark.sql(f"REFRESH TABLE {TABLE}")
        restored = state(spark)
        compare(original, restored)
        print("  первые строки текущего состояния:")
        try:
            spark.sql(f"SELECT * FROM {TABLE} ORDER BY order_id LIMIT 3").show(truncate=False)
        except Exception as e:
            print(f"  SELECT упал: {short_err(e)}")
        print("  те же строки через VERSION AS OF исходного snapshot:")
        old_sql = f"SELECT * FROM {TABLE} VERSION AS OF {original_snapshot} ORDER BY order_id LIMIT 3"
        try:
            spark.sql(old_sql).show(truncate=False)
        except Exception as e:
            print(f"  VERSION AS OF упал: {short_err(e)}")
            print("  повтор с spark.sql.iceberg.vectorization.enabled=false")
            spark.conf.set("spark.sql.iceberg.vectorization.enabled", "false")
            try:
                spark.sql(old_sql).show(truncate=False)
            except Exception as e2:
                print(f"  без векторизации тоже упал: {short_err(e2)}")
        print("  history после отката:")
        show_history(spark)
        # set_current_snapshot двигает указатель данных; схема и spec таблицы остаются текущими
        for key in ("строк", "схема", "партиционирование"):
            mark = "как до RTAS" if restored[key] == original[key] else "НЕ как до RTAS"
            print(f"  итог, {key}: {mark}")
    finally:
        spark.stop()
    return 0


if __name__ == "__main__":
    sys.exit(main())
--- 2. RTAS, который падает на order_id=7000 ---
  RTAS упал: PythonException: raise RuntimeError(f"INJECTED_FAILURE at order_id={order_id}")
  текущий snapshot: до 2409559062724504471, после 2409559062724504471 (не изменилось)
  строк: до 10000, после 10000 (не изменилось)
…
  партиционирование: до region, после region (не изменилось)
  snapshots в метаданных: до 1, после 1 (не изменилось)
  metadata.json на диске: до 1, после 1 (не изменилось)
  parquet на диске: до 3, после 3 (не изменилось)
  лишних parquet-файлов после сбоя: 0 (кандидаты в orphan-файлы)

--- 3. Успешный RTAS: только EU, другая схема и spec ---
  текущий snapshot: 3553416838579960883
  строк: 3334
  схема: struct<order_id:bigint,amount:double,order_ts:timestamp,region_code:string>
  партиционирование: days(order_ts)
…
  history после RTAS:
+-------------------+---------+-------------------+
|snapshot_id        |parent_id|is_current_ancestor|
+-------------------+---------+-------------------+
|2409559062724504471|NULL     |false              |
|3553416838579960883|NULL     |true               |
+-------------------+---------+-------------------+


--- 4. Откат на snapshot 2409559062724504471 через rollback_to_snapshot ---
  rollback_to_snapshot отказал: Py4JJavaError: : org.apache.iceberg.exceptions.ValidationException: Cannot roll back to snapshot, not an ancestor of the current state: 2409559062724504471
  пробуем set_current_snapshot: он не требует, чтобы snapshot был предком текущего
+--------------------+-------------------+
|previous_snapshot_id|current_snapshot_id|
+--------------------+-------------------+
|3553416838579960883 |2409559062724504471|
+--------------------+-------------------+

  set_current_snapshot выполнен
Упавший RTAS не тронул ничего, ни snapshot, ни строки, ни схему, ни число metadata.json. Лишних parquet-файлов тоже ноль, хотя Dremio предупреждает о сиротах. Почему их нет, прогон не показывает. Возможно, на локальном стенде Spark прибирает файлы упавших задач, но это наша догадка, а при убитом драйвере или в объектном хранилище картина может быть другой, это мы не проверяли. Дальше интереснее. Процедура rollback_to_snapshot отказала с ValidationException, потому что исходный snapshot не является предком текущего, ровно как подсказывал пустой parent_id в предыдущем сценарии. Сработал только set_current_snapshot, который, согласно документации процедур Iceberg для Spark, не требует родства. Что он вернул, видно на следующем шаге.
--- 5. Состояние после отката ---
  текущий snapshot: до 2409559062724504471, после 2409559062724504471 (не изменилось)
  строк: до 10000, после 10000 (не изменилось)
  схема: до struct<order_id:bigint,customer_id:bigint,amount:double,order_ts:timestamp,region:string>, после struct<order_id:bigint,amount:double,order_ts:timestamp,region_code:string> (ИЗМЕНИЛОСЬ)
  партиционирование: до region, после days(order_ts) (ИЗМЕНИЛОСЬ)
  snapshots в метаданных: до 1, после 2 (ИЗМЕНИЛОСЬ)
  metadata.json на диске: до 1, после 3 (ИЗМЕНИЛОСЬ)
  parquet на диске: до 3, после 10 (ИЗМЕНИЛОСЬ)
  первые строки текущего состояния:
+--------+------+-------------------+-----------+
|order_id|amount|order_ts           |region_code|
+--------+------+-------------------+-----------+
|0       |619.19|2026-01-01 00:00:00|NULL       |
|1       |509.6 |2026-01-01 00:01:00|NULL       |
|2       |832.53|2026-01-01 00:02:00|NULL       |
+--------+------+-------------------+-----------+

  те же строки через VERSION AS OF исходного snapshot:
  VERSION AS OF упал: Py4JJavaError: Caused by: java.lang.ClassCastException: class java.lang.String cannot be cast to class org.apache.spark.unsafe.types.UTF8String (java.lang.String is in module java.base of loader 'bootstrap'; org.apa
  повтор с spark.sql.iceberg.vectorization.enabled=false
  без векторизации тоже упал: Py4JJavaError: Caused by: java.lang.ClassCastException: class java.lang.String cannot be cast to class org.apache.spark.unsafe.types.UTF8String (java.lang.String is in module java.base of loader 'bootstrap'; org.apa
  history после отката:
+-------------------+---------+-------------------+
|snapshot_id        |parent_id|is_current_ancestor|
+-------------------+---------+-------------------+
|2409559062724504471|NULL     |true               |
|3553416838579960883|NULL     |false              |
|2409559062724504471|NULL     |true               |
+-------------------+---------+-------------------+

  итог, строк: как до RTAS
  итог, схема: НЕ как до RTAS
  итог, партиционирование: НЕ как до RTAS
Откат получился неполным. Указатель данных вернулся на исходный snapshot, и строк снова 10 000, но схема и spec таблицы остались от RTAS. Старые data-файлы теперь читаются через новую схему, колонки customer_id в выдаче нет, а region_code приходит пустой вместо значений region. Похоже, Iceberg сопоставляет колонки по field id, и у region_code он новый, но это наше объяснение, а не цитата из документации. Попытка прочитать тот же snapshot через VERSION AS OF, которая в третьем сценарии работала, после set_current_snapshot упала с ClassCastException даже с выключенной векторизацией. В history исходный snapshot теперь записан дважды, что легко принять за ошибку при разборе истории. Вывод практический. Документация права в том, что RTAS сохраняет историю, но вернуть витрину в прежний вид одной процедурой на этой связке не получилось.
Два шага и INSERT OVERWRITE для контраста
Пятый сценарий воспроизводит путь, который Dremio советует для неатомарных каталогов. Сначала CREATE TABLE с явной схемой и spec, потом INSERT INTO, который падает. После этого та же таблица проверяется на INSERT OVERWRITE с падением и без.
# pyspark 3.5.6, iceberg-spark-runtime-3.5_2.12 1.10.1; код написан для статьи iceberg_ctas_rtas_atomicity по документации Iceberg spark-ddl (nightly) и описанию двух шагов у Dremio
"""Сценарий 5. Контраст: CREATE TABLE + INSERT INTO и INSERT OVERWRITE с падением.

Два шага: между CREATE и INSERT потребитель видит пустую таблицу,
а после упавшего INSERT пустая таблица остаётся. INSERT OVERWRITE с падением
не трогает данные, схему и spec.
"""
import os
import re
import shutil
import sys
from pathlib import Path

from pyspark.sql import SparkSession
from pyspark.sql.types import LongType

ICEBERG_VERSION = "1.10.1"
ICEBERG_PACKAGE = f"org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:{ICEBERG_VERSION}"
DEMO = "05_two_step_and_overwrite"
BASE = Path(__file__).resolve().parent
os.chdir(BASE)  # все пути дальше относительные, от каталога статьи
ROOT = Path("data") / DEMO
PATH_RE = re.compile(r"(file:|(?<![\w.])/[\w.\-]+/)")
FAIL_AT = 7000
TABLE = "lake.db.mart_two_step"

# 'owner' в Spark 3.5 зарезервирован, свойство владельца называем 'team'
SOURCE_SQL = """
CREATE TABLE lake.db.orders_src
USING iceberg
PARTITIONED BY (region)
TBLPROPERTIES ('team' = 'sales', 'history.expire.max-snapshot-age-ms' = '604800000')
AS SELECT
  id AS order_id,
  id % 500 AS customer_id,
  CAST(round(rand(42) * 1000, 2) AS DOUBLE) AS amount,
  timestamp_seconds(1767225600 + id * 60) AS order_ts,
  element_at(array('EU', 'US', 'APAC'), CAST(id % 3 AS INT) + 1) AS region
FROM range(0, {rows})
"""

CREATE_EMPTY = """
CREATE TABLE lake.db.mart_two_step (
  order_id BIGINT, customer_id BIGINT, amount DOUBLE, order_ts TIMESTAMP, region STRING
) USING iceberg
PARTITIONED BY (region)
TBLPROPERTIES ('team' = 'sales')
"""

FAIL_SELECT = "SELECT boom_at(order_id), customer_id, amount, order_ts, region FROM lake.db.orders_src"
OK_SELECT = "SELECT order_id, customer_id, amount, order_ts, region FROM lake.db.orders_src"


def build_spark():
    # чистый стенд на каждый запуск: у каждого каталога свой warehouse внутри data/
    shutil.rmtree(ROOT, ignore_errors=True)
    ROOT.mkdir(parents=True)
    os.environ["PYSPARK_PYTHON"] = sys.executable
    os.environ["SPARK_LOCAL_IP"] = "127.0.0.1"
    spark = (
        SparkSession.builder.master("local[2]")
        .appName(DEMO)
        .config("spark.driver.memory", "2g")
        .config("spark.jars.packages", ICEBERG_PACKAGE)
        .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions")
        .config("spark.sql.catalog.lake", "org.apache.iceberg.spark.SparkCatalog")
        .config("spark.sql.catalog.lake.type", "hadoop")
        .config("spark.sql.catalog.lake.warehouse", (BASE / ROOT / "lake").as_uri())
        .config("spark.sql.catalog.spark_catalog", "org.apache.iceberg.spark.SparkSessionCatalog")
        .config("spark.sql.catalog.spark_catalog.type", "hadoop")
        .config("spark.sql.catalog.spark_catalog.warehouse", (BASE / ROOT / "session").as_uri())
        .config("spark.sql.catalogImplementation", "in-memory")
        .config("spark.sql.warehouse.dir", (BASE / ROOT / "spark").as_uri())
        # static: INSERT OVERWRITE без PARTITION заменяет всю таблицу
        .config("spark.sql.sources.partitionOverwriteMode", "static")
        .config("spark.driver.host", "127.0.0.1")
        .config("spark.driver.bindAddress", "127.0.0.1")
        .config("spark.ui.enabled", "false")
        .config("spark.ui.showConsoleProgress", "false")
        .config("spark.sql.shuffle.partitions", "4")
        .getOrCreate()
    )
    spark.sparkContext.setLogLevel("ERROR")
    return spark


def boom_at(order_id):
    if order_id == FAIL_AT:
        raise RuntimeError(f"INJECTED_FAILURE at order_id={order_id}")
    return order_id


def short_err(e):
    lines = [line.strip() for line in str(e).splitlines() if line.strip()]
    pick = next((line for line in lines if "INJECTED_FAILURE" in line), None)
    if pick is None:
        pick = next((line for line in lines if re.search(r"(Exception|Error)\b", line) and not line.startswith("at ")),
                    lines[0] if lines else "")
    pick = PATH_RE.split(pick, maxsplit=1)[0].strip()
    return f"{type(e).__name__}: {pick[:200]}"


def step(title):
    print(f"\n--- {title} ---", flush=True)


def partitioning(spark, table):
    # Spark 3.5: только identity-партиции идут в '# Partition Information' именами колонок,
    # с трансформами (days, bucket) — в '# Partitioning' строками 'Part N'
    rows = spark.sql(f"DESCRIBE TABLE {table}").collect()
    parts, section = [], None
    for r in rows:
        name = (r["col_name"] or "").strip()
        if not name:
            section = None
        elif name == "# Partition Information":
            section = "identity"
        elif name == "# Partitioning":
            section = "transform"
        elif name.startswith("# col_name"):
            continue
        elif name.startswith("#"):
            section = None
        elif section == "identity":
            parts.append(name)
        elif section == "transform" and name.startswith("Part "):
            parts.append(r["data_type"])
    return ", ".join(parts) if parts else "без партиционирования"


def current_snapshot(spark, table):
    row = spark.sql(f"SELECT snapshot_id FROM {table}.refs WHERE name = 'main'").first()
    return row["snapshot_id"] if row else None


def consumer_view(spark):
    # так таблицу видит потребитель, который пришёл в этот момент
    names = {r["tableName"] for r in spark.sql("SHOW TABLES IN lake.db").collect()}
    n = spark.sql(f"SELECT count(*) AS n FROM {TABLE}").first()["n"]
    snaps = spark.sql(f"SELECT count(*) AS n FROM {TABLE}.snapshots").first()["n"]
    v = {
        "в SHOW TABLES": "mart_two_step" in names,
        "строк": n,
        "snapshots": snaps,
        "текущий snapshot": current_snapshot(spark, TABLE),
        "схема": spark.table(TABLE).schema.simpleString(),
        "партиционирование": partitioning(spark, TABLE),
    }
    for k, val in v.items():
        print(f"  {k}: {val}")
    return v


def run_failing(spark, sql):
    try:
        spark.sql(sql)
        print("  запрос неожиданно прошёл")
    except Exception as e:
        print(f"  запрос упал: {short_err(e)}")


def main():
    spark = build_spark()
    try:
        spark.sql("CREATE NAMESPACE IF NOT EXISTS lake.db")
        spark.sql(SOURCE_SQL.format(rows=10000))
        spark.udf.register("boom_at", boom_at, LongType())

        step("1. Шаг первый: CREATE TABLE с явной схемой и spec")
        spark.sql(CREATE_EMPTY)
        consumer_view(spark)
        print("  между CREATE и INSERT витрина уже видна и пуста")

        step(f"2. Шаг второй: INSERT INTO, который падает на order_id={FAIL_AT}")
        run_failing(spark, f"INSERT INTO {TABLE} {FAIL_SELECT}")
        v = consumer_view(spark)
        print("  итог: " + ("пустая таблица осталась в каталоге" if v["в SHOW TABLES"] and v["строк"] == 0
                           else "состояние отличается от ожидаемого, см. строки выше"))

        step("3. Успешный INSERT INTO")
        spark.sql(f"INSERT INTO {TABLE} {OK_SELECT}")
        before = consumer_view(spark)

        step(f"4. INSERT OVERWRITE, который падает на order_id={FAIL_AT}")
        run_failing(spark, f"INSERT OVERWRITE {TABLE} {FAIL_SELECT}")
        after = consumer_view(spark)
        for k in ("строк", "текущий snapshot", "схема", "партиционирование"):
            print(f"  {k}: {'не изменилось' if before[k] == after[k] else 'ИЗМЕНИЛОСЬ'}")

        step("5. Успешный INSERT OVERWRITE только с EU")
        spark.sql(f"INSERT OVERWRITE {TABLE} {OK_SELECT} WHERE region = 'EU'")
        final = consumer_view(spark)
        print(f"  spec после INSERT OVERWRITE: {'сохранён' if final['партиционирование'] == before['партиционирование'] else 'изменился'}")
        spark.sql(
            f"""SELECT snapshot_id, parent_id, operation,
                       summary['added-records'] AS added_records,
                       summary['deleted-records'] AS deleted_records,
                       summary['total-records'] AS total_records
                FROM {TABLE}.snapshots ORDER BY committed_at"""
        ).show(truncate=False)
    finally:
        spark.stop()
    return 0


if __name__ == "__main__":
    sys.exit(main())
--- 1. Шаг первый: CREATE TABLE с явной схемой и spec ---
  в SHOW TABLES: True
  строк: 0
  snapshots: 0
  текущий snapshot: None
…
  между CREATE и INSERT витрина уже видна и пуста

--- 2. Шаг второй: INSERT INTO, который падает на order_id=7000 ---
  запрос упал: PythonException: raise RuntimeError(f"INJECTED_FAILURE at order_id={order_id}")
  в SHOW TABLES: True
  строк: 0
…
  итог: пустая таблица осталась в каталоге
…
--- 4. INSERT OVERWRITE, который падает на order_id=7000 ---
…
  строк: не изменилось
  текущий snapshot: не изменилось
  схема: не изменилось
  партиционирование: не изменилось

--- 5. Успешный INSERT OVERWRITE только с EU ---
…
  spec после INSERT OVERWRITE: сохранён
+-------------------+-------------------+---------+-------------+---------------+-------------+
|snapshot_id        |parent_id          |operation|added_records|deleted_records|total_records|
+-------------------+-------------------+---------+-------------+---------------+-------------+
|7959891112477379998|NULL               |append   |10000        |NULL           |10000        |
|8316820569271711297|7959891112477379998|overwrite|3334         |10000          |3334         |
+-------------------+-------------------+---------+-------------+---------------+-------------+
Двухшаговый путь ведёт себя так, как описывает Dremio, и именно поэтому он неудобен. Таблица видна в каталоге сразу после CREATE, у неё ноль snapshot и ноль строк, а упавший INSERT оставляет её в таком виде. Потребитель, пришедший в это окно, получит пустую витрину без всякой ошибки. INSERT OVERWRITE с падением не изменил ни строк, ни snapshot, ни схемы, ни spec. Успешный INSERT OVERWRITE сохранил партиционирование и, в отличие от RTAS, записал у нового snapshot parent_id предыдущего. Цепочка предков на месте, а значит rollback_to_snapshot формально должен работать, хотя на этой таблице мы откат отдельно не запускали.
RTAS и INSERT OVERWRITE на одном сценарии
Последний сценарий собирает одну и ту же агрегатную витрину по 300 000 строкам двумя способами. После прогрева каждый вариант выполняется трижды по очереди, затем сравниваются время, метаданные и сам результат.
# pyspark 3.5.6, iceberg-spark-runtime-3.5_2.12 1.10.1; замер написан для статьи iceberg_ctas_rtas_atomicity, цифры локального стенда, не бенчмарк
"""Сценарий 6. Один и тот же сценарий двумя способами: полная пересборка витрины.

RTAS (CREATE OR REPLACE TABLE ... AS SELECT) против INSERT OVERWRITE в готовую таблицу.
Замеряем время прогонов, считаем snapshots, смотрим parent_id, операции и spec.
"""
import os
import shutil
import statistics
import sys
import time
from pathlib import Path

from pyspark.sql import SparkSession

ICEBERG_VERSION = "1.10.1"
ICEBERG_PACKAGE = f"org.apache.iceberg:iceberg-spark-runtime-3.5_2.12:{ICEBERG_VERSION}"
DEMO = "06_compare_rtas_vs_overwrite"
BASE = Path(__file__).resolve().parent
os.chdir(BASE)  # все пути дальше относительные, от каталога статьи
ROOT = Path("data") / DEMO
ROWS = 300000
RUNS = 3

# 'owner' в Spark 3.5 зарезервирован, свойство владельца называем 'team'
SOURCE_SQL = """
CREATE TABLE lake.db.orders_src
USING iceberg
PARTITIONED BY (region)
TBLPROPERTIES ('team' = 'sales', 'history.expire.max-snapshot-age-ms' = '604800000')
AS SELECT
  id AS order_id,
  id % 500 AS customer_id,
  CAST(round(rand(42) * 1000, 2) AS DOUBLE) AS amount,
  timestamp_seconds(1767225600 + id * 60) AS order_ts,
  element_at(array('EU', 'US', 'APAC'), CAST(id % 3 AS INT) + 1) AS region
FROM range(0, {rows})
"""

MART_SELECT = """
SELECT region, CAST(order_ts AS DATE) AS day, count(*) AS orders, round(sum(amount), 2) AS revenue
FROM lake.db.orders_src
GROUP BY region, CAST(order_ts AS DATE)
"""

RTAS_SQL = f"CREATE OR REPLACE TABLE lake.db.mart_rtas USING iceberg PARTITIONED BY (region) AS {MART_SELECT}"
CREATE_OVERWRITE = """
CREATE TABLE lake.db.mart_overwrite (region STRING, day DATE, orders BIGINT, revenue DOUBLE)
USING iceberg PARTITIONED BY (region)
"""
OVERWRITE_SQL = f"INSERT OVERWRITE lake.db.mart_overwrite {MART_SELECT}"


def build_spark():
    # чистый стенд на каждый запуск: у каждого каталога свой warehouse внутри data/
    shutil.rmtree(ROOT, ignore_errors=True)
    ROOT.mkdir(parents=True)
    os.environ["PYSPARK_PYTHON"] = sys.executable
    os.environ["SPARK_LOCAL_IP"] = "127.0.0.1"
    spark = (
        SparkSession.builder.master("local[2]")
        .appName(DEMO)
        .config("spark.driver.memory", "2g")
        .config("spark.jars.packages", ICEBERG_PACKAGE)
        .config("spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions")
        .config("spark.sql.catalog.lake", "org.apache.iceberg.spark.SparkCatalog")
        .config("spark.sql.catalog.lake.type", "hadoop")
        .config("spark.sql.catalog.lake.warehouse", (BASE / ROOT / "lake").as_uri())
        .config("spark.sql.catalog.spark_catalog", "org.apache.iceberg.spark.SparkSessionCatalog")
        .config("spark.sql.catalog.spark_catalog.type", "hadoop")
        .config("spark.sql.catalog.spark_catalog.warehouse", (BASE / ROOT / "session").as_uri())
        .config("spark.sql.catalogImplementation", "in-memory")
        .config("spark.sql.warehouse.dir", (BASE / ROOT / "spark").as_uri())
        .config("spark.sql.sources.partitionOverwriteMode", "static")
        .config("spark.driver.host", "127.0.0.1")
        .config("spark.driver.bindAddress", "127.0.0.1")
        .config("spark.ui.enabled", "false")
        .config("spark.ui.showConsoleProgress", "false")
        .config("spark.sql.shuffle.partitions", "4")
        .getOrCreate()
    )
    spark.sparkContext.setLogLevel("ERROR")
    return spark


def step(title):
    print(f"\n--- {title} ---", flush=True)


def partitioning(spark, table):
    # Spark 3.5: только identity-партиции идут в '# Partition Information' именами колонок,
    # с трансформами (days, bucket) — в '# Partitioning' строками 'Part N'
    rows = spark.sql(f"DESCRIBE TABLE {table}").collect()
    parts, section = [], None
    for r in rows:
        name = (r["col_name"] or "").strip()
        if not name:
            section = None
        elif name == "# Partition Information":
            section = "identity"
        elif name == "# Partitioning":
            section = "transform"
        elif name.startswith("# col_name"):
            continue
        elif name.startswith("#"):
            section = None
        elif section == "identity":
            parts.append(name)
        elif section == "transform" and name.startswith("Part "):
            parts.append(r["data_type"])
    return ", ".join(parts) if parts else "без партиционирования"


def timed(spark, sql):
    t0 = time.perf_counter()
    spark.sql(sql)
    return (time.perf_counter() - t0) * 1000


def summary(spark, table, table_dir):
    snaps = spark.sql(
        f"SELECT snapshot_id, parent_id, operation FROM {table}.snapshots ORDER BY committed_at"
    ).collect()
    hist = spark.sql(f"SELECT count(*) AS n FROM {table}.history WHERE is_current_ancestor").first()["n"]
    meta = sum(1 for p in table_dir.rglob("*.metadata.json")) if table_dir.exists() else 0
    n = spark.sql(f"SELECT count(*) AS n FROM {table}").first()["n"]
    print(f"  {table}")
    print(f"    строк: {n}; партиционирование: {partitioning(spark, table)}")
    print(f"    snapshots: {len(snaps)}; операции: {[r['operation'] for r in snaps]}")
    print(f"    parent_id есть у {sum(1 for r in snaps if r['parent_id'] is not None)} из {len(snaps)}; "
          f"предков текущего в history: {hist}")
    print(f"    metadata.json в {table_dir.as_posix()}: {meta}")


def main():
    spark = build_spark()
    try:
        step(f"0. Источник: {ROWS} строк, витрина: выручка по region и дню")
        spark.sql("CREATE NAMESPACE IF NOT EXISTS lake.db")
        spark.sql(SOURCE_SQL.format(rows=ROWS))
        # прогрев: первая сборка обеих витрин в замер не входит
        spark.sql(RTAS_SQL)
        spark.sql(CREATE_OVERWRITE)
        spark.sql(OVERWRITE_SQL)

        step(f"1. Замер: {RUNS} прогона каждого варианта, по очереди")
        times = {"RTAS": [], "INSERT OVERWRITE": []}
        for _ in range(RUNS):
            times["RTAS"].append(timed(spark, RTAS_SQL))
            times["INSERT OVERWRITE"].append(timed(spark, OVERWRITE_SQL))
        header = "  вариант            " + "".join(f"прогон {i + 1:<4}" for i in range(RUNS)) + "медиана, мс"
        print(header)
        for name, vals in times.items():
            cells = "".join(f"{v:>8.0f}   " for v in vals)
            print(f"  {name:<19}{cells}{statistics.median(vals):>8.0f}")

        step("2. Что осталось в метаданных")
        summary(spark, "lake.db.mart_rtas", ROOT / "lake" / "db" / "mart_rtas")
        summary(spark, "lake.db.mart_overwrite", ROOT / "lake" / "db" / "mart_overwrite")

        step("3. Совпадает ли результат")
        diff = spark.sql(
            "SELECT count(*) AS n FROM (SELECT * FROM lake.db.mart_rtas EXCEPT SELECT * FROM lake.db.mart_overwrite)"
        ).first()["n"]
        print(f"  строк, которые есть в mart_rtas и нет в mart_overwrite: {diff}")
        print("  оговорка: local[2] и учебный каталог hadoop на локальном диске, цифры показывают порядок, не продакшен")
    finally:
        spark.stop()
    return 0


if __name__ == "__main__":
    sys.exit(main())
--- 1. Замер: 3 прогона каждого варианта, по очереди ---
  вариант            прогон 1   прогон 2   прогон 3   медиана, мс
  RTAS                    774        664        682        682
  INSERT OVERWRITE        674        619        666        666

--- 2. Что осталось в метаданных ---
  lake.db.mart_rtas
    строк: 627; партиционирование: region
    snapshots: 4; операции: ['overwrite', 'overwrite', 'overwrite', 'overwrite']
    parent_id есть у 0 из 4; предков текущего в history: 1
    metadata.json в data/06_compare_rtas_vs_overwrite/lake/db/mart_rtas: 4
  lake.db.mart_overwrite
    строк: 627; партиционирование: region
    snapshots: 4; операции: ['overwrite', 'overwrite', 'overwrite', 'overwrite']
    parent_id есть у 3 из 4; предков текущего в history: 4
    metadata.json в data/06_compare_rtas_vs_overwrite/lake/db/mart_overwrite: 5

--- 3. Совпадает ли результат ---
  строк, которые есть в mart_rtas и нет в mart_overwrite: 0
  оговорка: local[2] и учебный каталог hadoop на локальном диске, цифры показывают порядок, не продакшен
По времени варианты неразличимы, медианы 682 и 666 мс, и на local[2] такой разрыв меньше шума. Результат идентичен, 627 строк без расхождений. Разница в метаданных. У RTAS ни один из четырёх snapshot не имеет parent_id, и в истории предком текущего числится только он сам. У INSERT OVERWRITE связаны три из четырёх, первый snapshot закономерно без родителя, и вся четвёрка числится предками текущего. Лишний metadata.json у mart_overwrite, вероятно, появился от отдельного CREATE TABLE, но это наша интерпретация, прогон причину не показывает. Выбор между двумя способами определяется не скоростью, а тем, как вы собираетесь откатываться.
Ограничения и что вылезло на прогоне
Часть ограничений задаёт документация, часть обнаружилась только на живом стенде. Их стоит держать перед глазами до того, как строить на RTAS процедуру восстановления.
- Неатомарность CTAS при SparkSessionCatalog на связке in-memory session catalog и hadoop не воспроизвелась. Утверждение документации остаётся в силе, проверять его нужно на собственном Hive Metastore или REST catalog.
- Iceberg-таблица, созданная через SparkSessionCatalog, читается SELECT, но не видна в SHOW TABLES. Проверку существования таблицы в таком каталоге стройте на чтении, а не на листинге.
- После RTAS новый snapshot не ссылается на старый, и rollback_to_snapshot отказывает с ValidationException. Обходной путь через set_current_snapshot возвращает только данные, схема и spec остаются от RTAS, а переименованные колонки приходят пустыми.
- После set_current_snapshot чтение исходного snapshot через VERSION AS OF падает с ClassCastException, и отключение векторизации не помогает. Сравнить строки до и после отката на стенде не удалось.
- В history после отката один snapshot_id записан дважды. Скрипты, которые разбирают историю, должны быть к этому готовы.
- Откат вообще возможен только к snapshot, который ещё не удалён через expire. Значения retention и commit retry по умолчанию в этой работе не получены, а в демо срок хранения истории задан явно, 604800000 мс, то есть семь дней.
- Orphan-файлов после упавших CTAS и RTAS на локальном диске не осталось. Dremio утверждает обратное для неудачного коммита, но ни он, ни документация не дают замеров объёма сирот.
- Прогон сделан на iceberg-spark-runtime 1.10.1 и Spark 3.5.6, а прочитанная документация относится к nightly. Каталог hadoop учебный, а точная версия Java в журнале замаскирована.
Главное из списка в том, что атомарность публикации подтвердилась, а обратимость RTAS оказалась слабее, чем следует из фразы о сохранённой истории. Защищаться от неудачной записи RTAS умеет, защищаться от удачной, но ошибочной записи нужно другими средствами.
Когда применять RTAS, а когда INSERT OVERWRITE
Из документации и прогона складывается несколько рабочих правил. Они не универсальны, но покрывают типичную пересборку витрин в lakehouse на Spark.
- Новая таблица из запроса в именованном SparkCatalog создаётся через CTAS с явными PARTITIONED BY и TBLPROPERTIES, иначе копия выйдет без партиционирования и настроек.
- Полная пересборка с изменением схемы или spec делается через RTAS, но с PARTITIONED BY в каждом DDL и с пониманием, что вернуть прежнюю структуру rollback_to_snapshot не поможет.
- Ежедневная перезаливка данных с неизменным layout идёт через INSERT OVERWRITE, он сохраняет spec и цепочку предков для отката.
- В каталоге без атомарных CTAS и RTAS остаётся двухшаговый путь, и окно с пустой таблицей закрывается проверкой до переключения потребителей.
Если коротко, RTAS отвечает за смену структуры, INSERT OVERWRITE за смену данных, а выбор каталога решает, есть ли у вас атомарность вообще. Та же логика переносится на dbt. В основе материализации table в dbt по сути лежит CTAS или RTAS, и от атомарности этой операции зависит, увидят ли потребители пустую витрину во время пересборки.
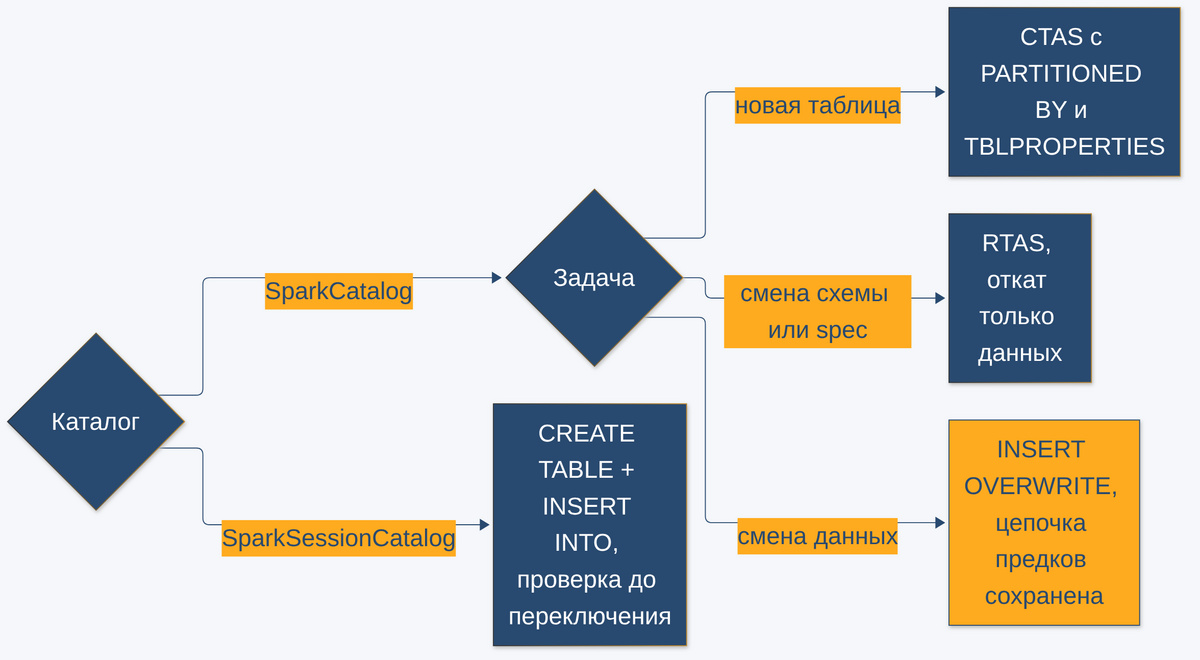
Заключение
Прогон подтвердил основную мысль Dremio и документации Iceberg. В именованном SparkCatalog CTAS и RTAS публикуют результат одним коммитом метаданных, и упавший запрос не оставляет ни полупустой таблицы, ни занятого имени. Сравнение со стратегией из двух шагов показало, от какого окна эта атомарность защищает. Но прогон добавил и то, о чём новость молчит. RTAS рвёт цепочку предков, поэтому штатный rollback_to_snapshot после него не работает, а set_current_snapshot возвращает данные без прежней схемы. Если витрине важна цепочка предков для отката, пересобирайте её через INSERT OVERWRITE, в прогоне он сохранил parent_id у трёх snapshot из четырёх, хотя сам откат на такой таблице мы не запускали. RTAS оставьте для осознанной смены структуры. Тем, кто ещё живёт на SparkSessionCatalog поверх Hive, стоит вернуться к разбору миграции с Hive на Iceberg, на который мы ссылались в разделе о каталогах, и спланировать переход на отдельный каталог Iceberg.