6
Содержание
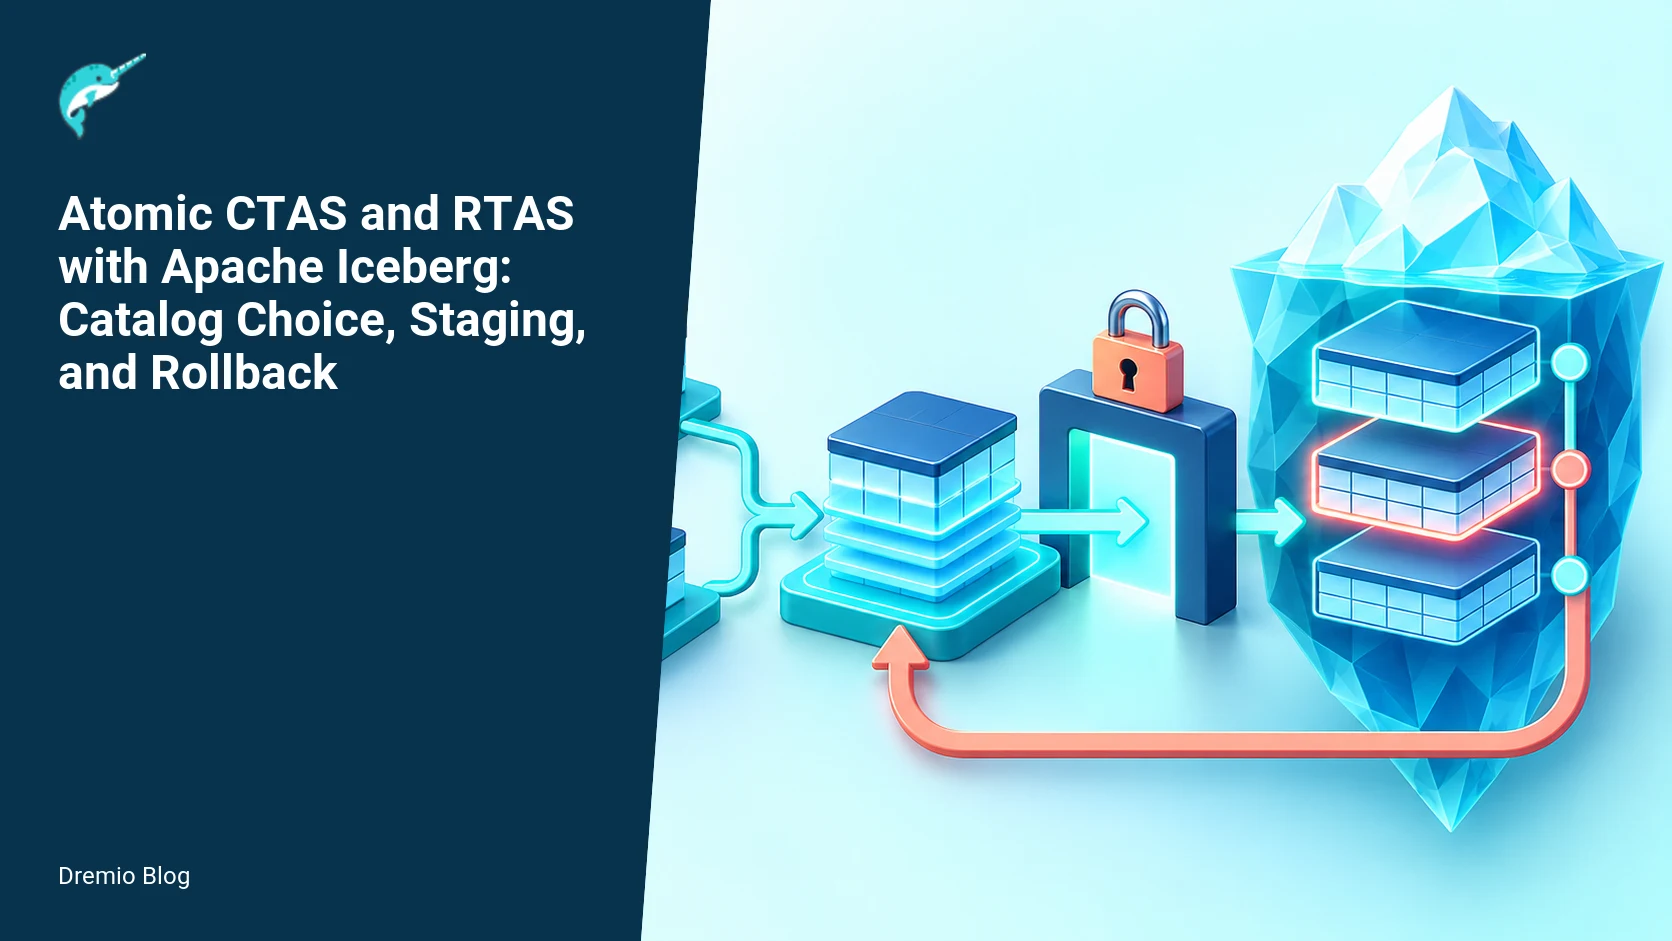
Dremio показала, как добиться атомарности при создании и замене таблиц через CTAS и RTAS поверх Apache Iceberg. CTAS означает создание новой таблицы на основе результата запроса, а RTAS — замену данных в уже существующей таблице без изменения её структуры. Раньше такие операции в Spark часто оставляли таблицу в промежуточном состоянии при сбое, что порождало проблемы с консистентностью. Теперь выбор каталога и механизм staging позволяют либо полностью применить изменения, либо откатить их без ручного вмешательства. Это важно для команд, которые строят конвейеры на Spark и нуждаются в предсказуемом поведении при больших вставках. Без атомарности возникает риск частично загруженных данных, что приводит к ошибкам в аналитике и требует дополнительных проверок и очисток. Выбор правильного подхода помогает сократить время на восстановление после сбоев и снизить нагрузку на инженеров данных.
Как каталог влияет на атомарность
SparkCatalog и SparkSessionCatalog по-разному обрабатывают метаданные Iceberg. Первый напрямую работает с каталогом Iceberg и поддерживает staging, поэтому операция либо фиксируется целиком, либо откатывается. Staging здесь выступает как временное хранилище изменений, которое становится видимым только после успешного завершения. Второй оборачивает сессионный контекст и в некоторых сценариях теряет атомарность, потому что промежуточные файлы могут остаться видимыми. Разница проявляется при одновременных запусках: SparkCatalog блокирует конфликты на уровне каталога, а SparkSessionCatalog полагается на механизм Spark, который не всегда успевает очистить артефакты. При принятии решения важно учитывать, что SparkCatalog лучше подходит для многопользовательских сред с высокой конкуренцией за ресурсы, тогда как SparkSessionCatalog может показаться проще в настройке, но увеличивает вероятность появления «осиротевших» файлов. Это особенно критично, когда конвейеры работают с большими объёмами данных и требуют строгой изоляции изменений.
Что сохраняет RTAS и как проверить откат
RTAS оставляет схему, партиционирование и свойства таблицы без изменений, меняя только данные. Это позволяет избежать пересоздания внешних зависимостей и политик доступа, что экономит время при частых обновлениях больших фактовых таблиц. Для проверки отката достаточно выполнить операцию с намеренным сбоем на стадии записи и убедиться, что предыдущая версия метаданных осталась активной. В Iceberg для этого используют snapshot-идентификаторы: после неудачной RTAS текущий snapshot не меняется, а новые файлы данных остаются изолированными до явной очистки. Такой механизм даёт уверенность, что откат не затронет уже работающие запросы. При оценке решения стоит обратить внимание на то, что сохранение метаданных снижает риск нарушения прав доступа и упрощает интеграцию с внешними инструментами мониторинга. Однако при частых откатах может потребоваться дополнительный контроль за накоплением временных файлов, чтобы не превысить лимиты хранилища.
Особенности внедрения в российских контурах
В изолированных установках без доступа к облачным каталогам выбор между SparkCatalog и Nessie-подобными решениями определяет, удастся ли получить атомарность без доработки. Nessie обеспечивает версионирование метаданных и помогает в распределённых командах, где важно отслеживать историю изменений. Команды чаще всего разворачивают Iceberg с собственным REST-каталогом или с Hive Metastore в режиме, совместимом со SparkCatalog. Это снижает риск частичных таблиц при пересоздании больших фактов, но требует мониторинга staging-директорий, чтобы избежать накопления мусора при частых откатах. В практике это особенно заметно на кластерах с жёсткими квотами на HDFS, где незавершённые файлы быстро съедают место. При выборе решения важно учитывать, что REST-каталог даёт большую гибкость в изолированных сетях, тогда как Hive Metastore проще интегрировать с уже существующими Hadoop-инфраструктурами, но может потребовать дополнительных настроек для полной атомарности. Это помогает оценить, оправданы ли затраты на миграцию каталога ради повышения надёжности конвейеров.
Ограничения и проверка в своём окружении
Атомарность работает только при записи через Iceberg-формат и при наличии каталога, поддерживающего атомарные коммиты. Если используется устаревший Hive-каталог без поддержки Iceberg, операция теряет гарантии. Перед массовым внедрением стоит протестировать сценарий с принудительным обрывом сети на стадии записи и измерить время отката. Дополнительно нужно проверить совместимость версий Spark и Iceberg, потому что поведение SparkSessionCatalog менялось между 3.3 и 3.5. После тестов можно оценить, оправдан ли переход на явный SparkCatalog ради сокращения ручных исправлений. Важно понимать, что без таких проверок риск неатомарного поведения остаётся высоким, особенно при работе с чувствительными данными или в средах с частыми сбоями. Это позволяет командам взвесить преимущества атомарности против возможных затрат на обновление инфраструктуры и тестирование.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Атомарность CTAS и RTAS в Apache Iceberg.
Курс по теме — Каталог курсов Школы Больших Данных