3
Содержание
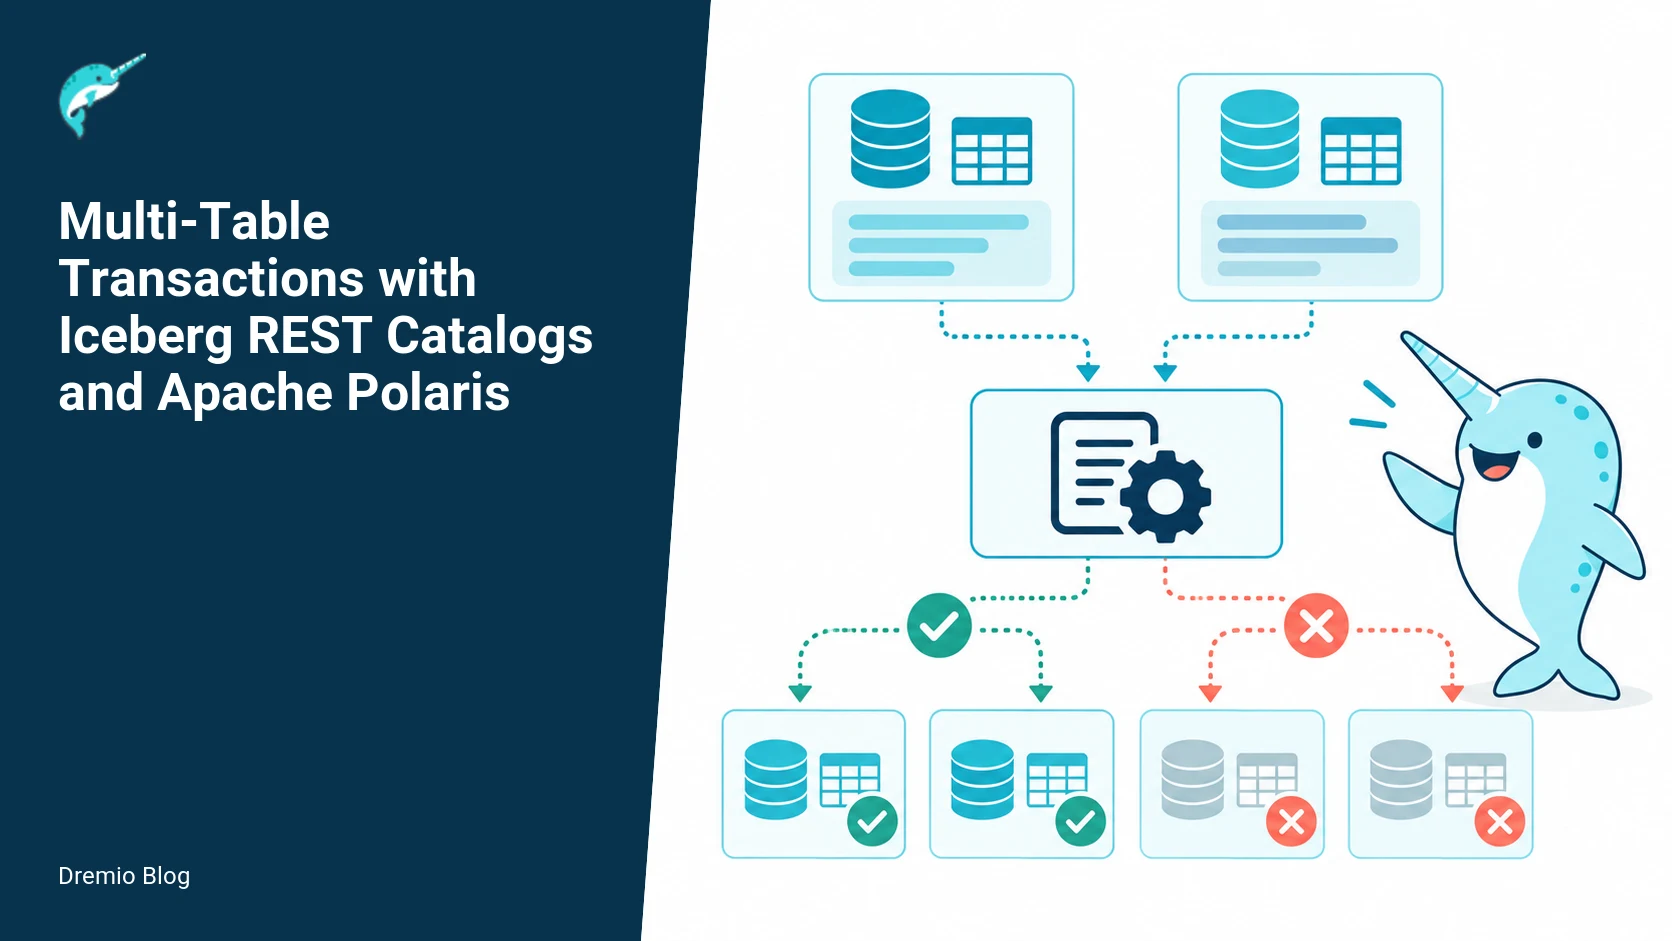
Dremio описал механизм многотабличных коммитов в Iceberg REST Catalog. Он позволяет менять несколько таблиц в одной атомарной операции, сохраняя транзакционность данных при параллельной работе. Это важно для пайплайнов, где обновление фактов и измерений должно происходить без частичных состояний. При выборе такого подхода стоит учитывать, что атомарность снижает риск появления промежуточных данных, видимых другим процессам, однако требует обновления клиентских библиотек и ограничивает гибкость при работе с несколькими независимыми хранилищами метаданных.
Семантика REST-коммитов нескольких таблиц
Механизм строится на расширении REST API каталога. Клиент отправляет один запрос, в котором перечислены все изменения: добавление файлов, обновление метаданных и удаление устаревших снапшотов. Сервер каталога проверяет, что все операции могут быть применены одновременно, и только после этого фиксирует результат. Если хотя бы одна таблица не проходит проверку, весь запрос отклоняется. REST-каталог здесь означает интерфейс управления метаданными таблиц через стандартные HTTP-запросы, что упрощает интеграцию разных движков обработки данных. Атомарная операция гарантирует, что либо все таблицы обновляются, либо ни одна не меняется, что критично при принятии решения о внедрении в ETL-процессы с высокими требованиями к целостности.
Раньше такие сценарии приходилось разбивать на последовательные коммиты, рискуя получить промежуточное состояние. Теперь атомарность гарантируется на уровне каталога. Это снижает сложность кода в ETL-процессах и уменьшает количество откатов при ошибках. Важно, что REST-эндпоинт не требует специального драйвера: достаточно клиента Iceberg, поддерживающего новую версию спецификации. При оценке целесообразности стоит помнить, что переход на многотабличные коммиты оправдан только тогда, когда количество таблиц в одной операции невелико и все они находятся в одном каталоге; в противном случае сложность отладки может вырасти.
При этом сохраняется совместимость с существующими таблицами. Старые клиенты продолжают работать через одиночные коммиты, а новые могут использовать расширенный формат запроса. Ограничение проявляется при использовании не-REST каталогов: Nessie или Hive Metastore пока не реализуют аналогичную семантику. Для команд, планирующих долгосрочное использование, это означает необходимость оценки текущего каталога и возможной миграции, если требуется сквозная атомарность.
Обработка конфликтов и требования к клиентам
При параллельных обновлениях сервер сравнивает текущие метаданные таблиц с теми, что прислал клиент. Если снапшот изменился, возвращается ошибка конфликта. Клиент может повторить операцию, заново прочитав актуальные метаданные. Такой подход похож на optimistic locking и не требует блокировок на стороне хранилища. Optimistic locking подразумевает проверку версии данных перед записью без предварительной блокировки, что повышает пропускную способность, но требует обработки ошибок на стороне приложения. При решении о внедрении важно понимать, что частые конфликты могут привести к дополнительным задержкам и необходимости доработки retry-логики.
Поддержка есть в клиентах Iceberg на Java, Python и Spark. Однако не все версии библиотек умеют собирать многотабличный запрос автоматически. Разработчикам нужно явно указывать несколько таблиц в API коммита или использовать обёртки, которые делают это под капотом. В противном случае приложение получит ошибку валидации формата запроса. Это ограничение влияет на выбор: если проект использует устаревшие версии клиентов, переход на многотабличные транзакции потребует обновления зависимостей и тестирования совместимости.
Конфликтная ситуация возникает чаще при высокой конкуренции за одни и те же таблицы. В таких случаях рекомендуется уменьшать размер транзакции или добавлять retry-логику с экспоненциальной паузой. Полностью исключить конфликты не получится, но их частоту можно снизить правильным дизайном партиционирования. При оценке стоит взвесить, насколько критична атомарность по сравнению с возможным ростом числа повторных попыток.
Роль Apache Polaris в координации
Apache Polaris выступает как реализация REST-каталога, способная обрабатывать многотабличные коммиты. Он хранит метаданные в отдельном слое и координирует изменения через собственный движок транзакций. Это позволяет использовать один и тот же каталог для Spark, Flink и Trino без изменения кода приложений. При выборе Polaris важно учитывать, что он обеспечивает единую точку управления правами и метаданными, что упрощает администрирование в гетерогенных средах.
Polaris также предоставляет модель прав доступа на уровне таблиц и веток. При многотабличном коммите проверяются права на каждую таблицу отдельно, но фиксация происходит только при успешной проверке всех. Если доступ к одной таблице отсутствует, вся операция отклоняется до начала записи данных. Такой механизм снижает риск несанкционированных изменений, однако требует тщательной настройки политик перед внедрением.
В российских контурах Polaris можно развернуть на собственных серверах без зависимости от облачных сервисов. Это важно для команд, которые уже используют Iceberg поверх S3-совместимых хранилищ. Интеграция не требует изменения формата данных, поэтому существующие таблицы можно подключить без миграции. Ограничением остаётся необходимость обновить клиенты Iceberg до версий с поддержкой REST multi-table API. При принятии решения о внедрении стоит проверить наличие ресурсов на самостоятельное сопровождение сервера.
Практические ограничения при внедрении
Механизм требует, чтобы все участвующие таблицы находились в одном каталоге. Перекрестные коммиты между разными каталогами пока не поддерживаются. Также отсутствует возможность отката только части таблиц: либо фиксируются все изменения, либо ни одно. Эти ограничения влияют на архитектуру: если данные распределены по нескольким каталогам, придётся выбирать между консолидацией или отказом от атомарности.
Производительность коммита падает при большом количестве таблиц в одном запросе. Каждый дополнительный объект увеличивает время валидации метаданных. На практике разумно ограничиваться 5-10 таблицами в одной транзакции. При необходимости больших атомарных операций стоит рассмотреть промежуточные staging-таблицы. Перед внедрением рекомендуется провести нагрузочное тестирование, чтобы оценить влияние на общую пропускную способность пайплайна.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Многотабличные транзакции Iceberg через REST-каталоги.
Курс по теме — Каталог курсов Школы Больших Данных