
 25

Содержание
vLLM представляет собой движок инференса и обслуживания больших языковых моделей (LLM inference and serving engine), который резко поднимает пропускную способность GPU-сервера по сравнению с наивной обработкой запросов по одному. Проект вырос из статьи Калифорнийского университета в Беркли (UC Berkeley Sky Computing Lab) на конференции SOSP 2023, с мая 2025 года развивается как проект PyTorch Foundation и стал одним из стандартных способов поднять production-сервис на базе открытой LLM. Разбираемся, что стоит за этим движком, как устроен конвейер обработки запроса и где vLLM уместен, а где нет.
Что такое vLLM
По собственному описанию проекта на GitHub, vLLM это «high-throughput and memory-efficient inference and serving engine for LLMs», то есть высокопроизводительный и экономный по памяти движок для инференса и обслуживания больших языковых моделей. Формально это библиотека и одновременно сервер. Она берёт уже обученную модель, например из Hugging Face, и разворачивает вокруг неё production-контур, который принимает параллельные запросы, эффективно распределяет память GPU под них и отдаёт ответы с максимально возможной для железа скоростью.
Задача, которую решает vLLM, возникает у любой команды, разворачивающей LLM в проде. Наивный сервинг, по одному запросу за раз или с фиксированным батчем, держит GPU простаивающим большую часть времени и тратит память на KV-кэш неэффективно. vLLM закрывает разрыв между теоретической мощностью GPU и её фактическим использованием под нагрузкой множества одновременных диалогов.
По тому же самоописанию в репозитории проекта, поверх движка инференса собран сетевой интерфейс сразу под три протокола. README описывает его как «OpenAI-compatible API server, plus Anthropic Messages API and gRPC support», то есть один развёрнутый сервер можно опрашивать протоколом OpenAI, протоколом Anthropic Messages или через gRPC, не меняя движок под капотом. Именно OpenAI-совместимый режим разобран ниже, в разделе про запуск сервера.
Архитектура и ключевые компоненты vLLM
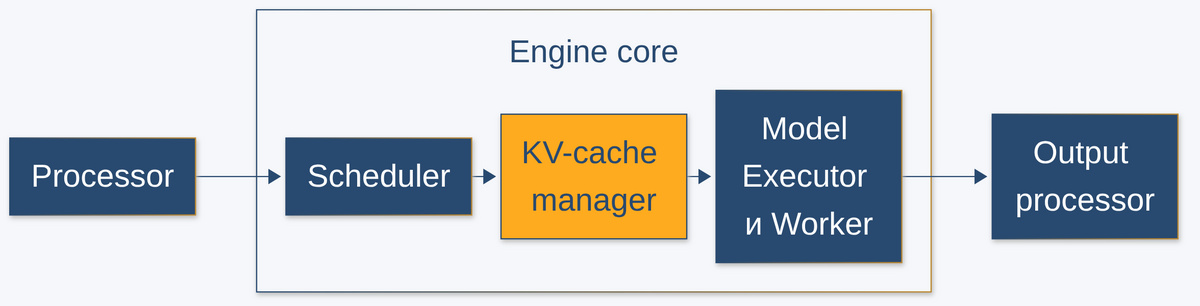
Подробный разбор архитектуры описан в официальном блоге проекта, «Inside vLLM. Anatomy of a High-Throughput LLM Inference System». В текущем движке V1 запрос проходит через три крупных блока, а центральный из них сам состоит из нескольких частей.
- Processor. Принимает запрос, токенизирует промпт и передаёт его в ядро движка.
- Engine core. Ядро движка. Внутри него Scheduler на каждом шаге решает, какие запросы войдут в батч, KV-cache manager выдаёт им блоки KV-кэша из общего пула, а Model Executor через процесс Worker выполняет forward pass модели на GPU.
- Output processor. Превращает сырой выход ядра в ответ, который видит клиент, и возвращает его вызывающей стороне.
Конвейер работает не на уровне запроса целиком, а на уровне отдельной итерации генерации токена, и это отличие лежит в основе прироста throughput, разобранного в следующем разделе.
Архитектура ML-систем
Код курса
ARML
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24/32 ак.часов
Стоимость обучения
76 800
Принцип работы PagedAttention и continuous batching
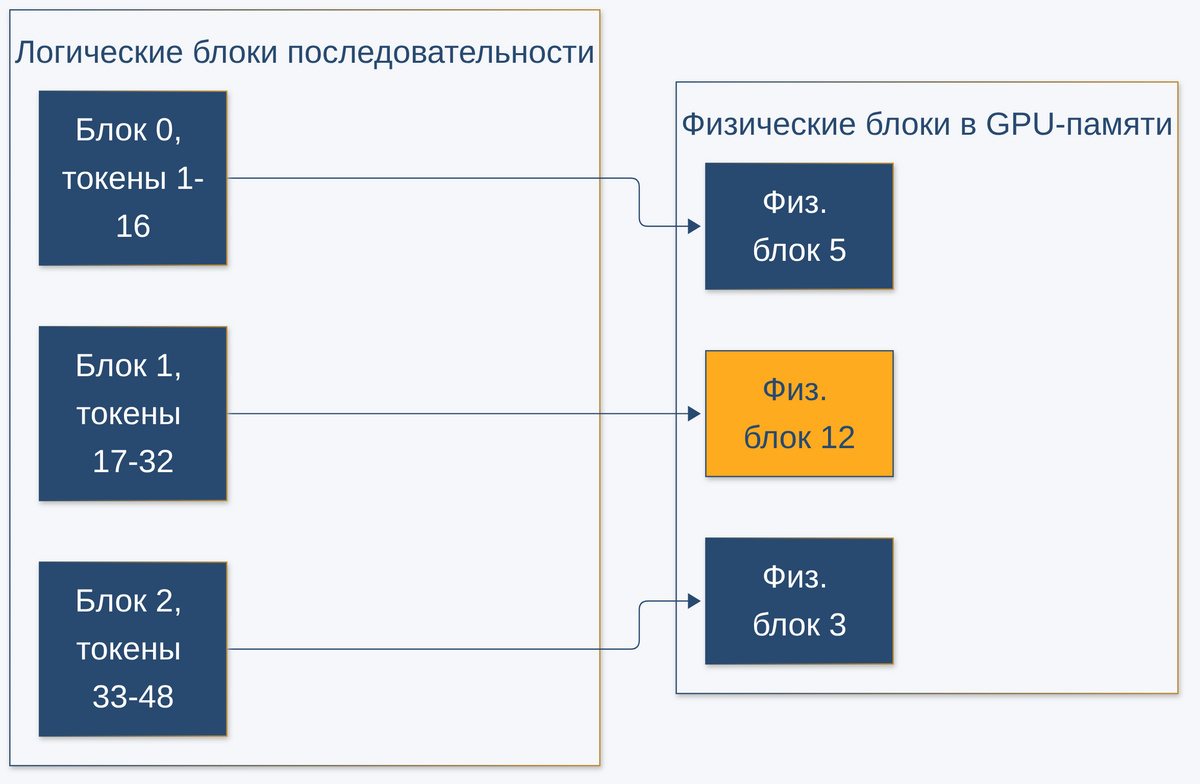
Два механизма конвейера отвечают за прирост производительности. PagedAttention решает проблему фрагментации памяти. KV-кэш каждой активной последовательности адресуется через таблицу логических блоков, block table, которая отображается на физические блоки в GPU-памяти, не обязательно смежные. Один физический блок по умолчанию хранит key/value-тензоры для 16 последовательных токенов, размер блока настраивается флагом —block-size. Идея заимствована из виртуальной памяти операционной системы, где процессу не нужен непрерывный кусок оперативной памяти, достаточно таблицы страниц.
Continuous batching решает проблему простоя GPU между запросами. После каждой итерации forward pass планировщик пересматривает две очереди. Waiting содержит запросы, ждущие начала prefill, running содержит те, что активно генерируют токены. Если KV-кэша не хватает, планировщик вытесняет часть запросов обратно в waiting. В текущем движке V1 такой запрос по умолчанию потом пересчитывается заново, а не выгружается в память CPU, как было в старом движке V0. Как только короткий запрос завершается, он немедленно покидает батч, а освободившееся место на следующем шаге занимает запрос из очереди, вместо того чтобы ждать, пока закончатся все запросы текущего батча целиком. Например, если из батча на восемь запросов три уже сгенерировали ответ и вышли из running, планировщик на следующем шаге подставляет на их место следующие три запроса из waiting, а не ждёт, пока завершатся оставшиеся пять. За счёт этого GPU почти никогда не простаивает в ожидании самого долгого запроса в батче.
В исходной статье SOSP 2023 авторы vLLM сообщают о росте throughput в 2-4 раза при той же задержке по сравнению с FasterTransformer и Orca, то есть с системами того времени, а не с наивной обработкой по одному запросу. Это результат бенчмарка на конкретных моделях и GPU, и на вашей нагрузке цифра будет своей.
Ограничения vLLM
Единственный документированный числовой параметр из разобранных выше это размер блока KV-кэша по умолчанию, 16 токенов. Максимальная длина контекста, минимальные требования к видеопамяти, поддерживаемые типы квантования и предельное число одновременных реплик зависят от конкретной версии, модели и GPU, и проект не публикует единую универсальную цифру на все конфигурации. Поэтому лимиты под свою модель и GPU проверяют нагрузочным тестом, а не берут из чужих бенчмарков.
Проект выпускает минорные версии часто, и между ними меняются поддерживаемые модели, флаги запуска и значения по умолчанию. Обновление vLLM в проде стоит планировать как отдельный релиз с прогоном регрессии, а не как рутинный апдейт зависимости.
vLLM и альтернативы
vLLM конкурирует не с фреймворками обучения моделей, а с другими inference-серверами, решающими ту же задачу обслуживания LLM в проде. Более широкое сравнение inference-серверов, MLServer, Triton, TensorFlow Serving и TorchServe, разбирается в курсе «Архитектура ML систем».
| Инструмент | Кто развивает | Ключевой механизм | Позиционирование |
|---|---|---|---|
| vLLM | Открытое сообщество, проект PyTorch Foundation | PagedAttention, continuous batching | Открытый движок для GPU-serving произвольных моделей с Hugging Face |
| Triton Inference Server | NVIDIA | Универсальный слой обслуживания моделей с бэкендами под разные фреймворки | Multi-framework сервинг, не только LLM, глубокая интеграция с экосистемой NVIDIA |
| SGLang | Открытое сообщество sgl-project | RadixAttention, переиспользование общего префикса в KV-кэше | Главный открытый конкурент vLLM, силён на агентных сценариях с общим длинным промптом |
| Text Generation Inference (TGI) | Hugging Face | Continuous batching, тесная интеграция с Hugging Face Hub | В режиме поддержки, Hugging Face советует перейти на vLLM или SGLang, а локально на llama.cpp или MLX |
| TensorRT-LLM | NVIDIA | Компиляция моделей в оптимизированные под конкретный GPU движки | Максимум производительности на NVIDIA-железе ценой шага компиляции под каждую модель |
У каждого варианта своя цена интеграции. TensorRT-LLM даёт максимальную скорость на конкретной видеокарте, но требует отдельный шаг компиляции модели под неё, и это время закладывается в процесс деплоя каждой новой модели или её версии. Triton Inference Server решает более широкую задачу, он обслуживает не только LLM, а любые модели за общим протоколом, и это оправдано, когда в проде уже работает несколько типов моделей за одним шлюзом. SGLang ближе всех к vLLM по задаче и выигрывает там, где много запросов делят общий префикс, например системный промпт агента. TGI на новые проекты брать уже не стоит, Hugging Face сам перевёл его в режим поддержки и принимает только мелкие исправления.
Выбор между ними определяется не отвлечённым «что лучше», а тем, какая часть стека уже есть в команде, агентная нагрузка с общими префиксами под SGLang, инфраструктура NVIDIA Triton или требование выжать максимум из конкретного GPU через TensorRT-LLM.
Когда применять vLLM, а когда нет
vLLM уместен там, где на одном GPU обслуживается много параллельных диалогов, а не один запрос за раз. Более широкий разбор паттернов обслуживания ML-моделей в проде, не только LLM, есть в материале про паттерны деплоя ML-моделей.
- Есть смысл применять. Production-сервис с множеством одновременных пользователей, где важна суммарная пропускная способность, а не задержка единственного запроса.
- Есть смысл применять. Развёртывание открытой модели из Hugging Face с OpenAI-совместимым API, чтобы не переписывать клиентский код под нестандартный протокол.
- Не подходит или избыточен. Единичные локальные эксперименты на слабом железе или без GPU. CPU-бэкенд у vLLM есть, но выигрыш движка раскрывается на GPU под потоком параллельных запросов, а для одного пользователя на ноутбуке проще локальные движки вроде llama.cpp.
- Не подходит или избыточен. Сценарий с одним пользователем и низкими требованиями к параллелизму, где выгода continuous batching не успевает проявиться.
Чем выше параллелизм и чем дороже GPU-час, тем быстрее окупается переход на vLLM вместо наивного serving. Разница особенно заметна на серверах с одной дорогой видеокартой, где простой GPU в ожидании единственного клиента стоит так же дорого, как обслуживание десятка параллельных пользователей, поэтому naive serving на таком железе означает переплату за неиспользуемую мощность.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
25 января, 2027
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Запуск OpenAI-совместимого сервера и клиентский вызов
Ниже приведён минимальный синтаксис запуска, без прогона на стенде. Основной сценарий vLLM это GPU, поэтому перед реальным развёртыванием стоит свериться с актуальным разделом quickstart на docs.vllm.ai для конкретной версии пакета.
# установка пакета vLLM, вариант через uv, синтаксис README, https://github.com/vllm-project/vllm
uv pip install vllm
# запуск OpenAI-совместимого сервера, синтаксис Quickstart, https://docs.vllm.ai/en/latest/getting_started/quickstart/
# block-size задаёт размер блока KV-кэша в токенах, по умолчанию 16
vllm serve Qwen/Qwen2.5-1.5B-Instruct --block-size 16
# клиентский вызов через официальную библиотеку openai, endpoint vLLM совместим с OpenAI API
# https://docs.vllm.ai/en/latest/getting_started/quickstart/
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="not-needed")
response = client.chat.completions.create(
    model="Qwen/Qwen2.5-1.5B-Instruct",
    messages=[{"role": "user", "content": "Объясни, что такое PagedAttention"}],
)
print(response.choices[0].message.content)
По документации Quickstart, поднятый сервер реализует эндпоинты list models, create chat completion и create completion, то есть тот же набор, что и API OpenAI. Существующий клиентский код, написанный под официальную библиотеку openai, поэтому обычно достаточно переключить на локальный base_url без переписывания логики запроса.
Модель в примере взята из официального Quickstart, для реального сервиса подставляется путь до модели, доступной на вашем стенде.
Заключение
vLLM закрывает конкретный разрыв в production-serving LLM, разрыв между теоретической мощностью GPU и её фактическим использованием под потоком параллельных запросов. PagedAttention убирает фрагментацию KV-кэша, continuous batching убирает простой GPU между запросами, а вместе они дали в исходной работе прирост throughput в 2-4 раза относительно систем того времени. Точные числовые лимиты и требования к железу меняются от релиза к релизу, поэтому перед продакшен-внедрением стоит свериться с актуальной версией docs.vllm.ai.
Референсные ссылки
- github.com/vllm-project/vllm, официальный репозиторий и самоописание проекта.
- Inside vLLM. Anatomy of a High-Throughput LLM Inference System, официальный блог проекта, архитектура и механизм PagedAttention.
- docs.vllm.ai, Quickstart, синтаксис запуска сервера и состав эндпоинтов OpenAI-совместимого API.
- docs.vllm.ai, Optimization and Tuning, вытеснение запросов и режим RECOMPUTE в движке V1.
- github.com/huggingface/text-generation-inference, репозиторий TGI и статус режима поддержки.