 58
Содержание
- Что такое Human-in-the-Loop
- Архитектура и ключевые компоненты
- Риск-ориентированная классификация против тотальной проверки
- Механизм паузы и возобновления агента (interrupt и checkpoint)
- Принцип работы и жизненный цикл решения человека
- Четыре типа ответа человека на паузу агента
- Таймауты и эскалация решения
- Эволюция смысла от разметки данных к контролю рантайма агентов
- Реализации паттерна в LangChain, AWS Bedrock и Step Functions
- Сценарии применения и границы применимости
- Пример конфигурации паузы на подтверждение
- Заключение
- Референсные ссылки
Human-in-the-Loop (HITL) это архитектурный паттерн, при котором автономный ИИ-агент перед рискованным действием останавливается и ждёт решения человека вместо того, чтобы выполнять его без контроля. В LangChain HITL реализован как middleware, которое сверяет каждый вызов инструмента (tool call) с настраиваемой политикой и приостанавливает выполнение агента, если политика требует проверки. AWS Well-Architected Framework, свод архитектурных рекомендаций AWS, в разделе Agentic AI Lens (правило AGENTSEC04-BP02) описывает тот же паттерн шире, как риск-ориентированное одобрение (risk-tiered approval), при котором пауза ставится не перед каждым действием агента, а только перед теми решениями, где вмешательство человека реально меняет исход.
Что такое Human-in-the-Loop
Такое различие принципиально. HITL часто путают с обычной кнопкой подтверждения перед любым действием агента, но AWS Well-Architected прямо называет тотальную проверку анти-паттерном. Ревьюер, который подтверждает сотни однотипных операций подряд, быстро переходит к формальному нажатию «одобрить» без реального анализа, это явление называют усталостью ревьюера (reviewer fatigue), и оно обесценивает саму идею контроля. Рабочий паттерн строится на двух опорах, а именно на риск-классификаторе, который решает, какие действия вообще требуют паузы, и на типизированном решении человека с четырьмя вариантами ответа вместо единственного «да» или «нет».
Архитектура и ключевые компоненты
Практическая реализация HITL опирается на три компонента, которые встречаются в любом фреймворке под разными именами. Первый решает, какие действия агента вообще требуют паузы. Второй останавливает выполнение и сохраняет его состояние. Третий обеспечивает возврат к прерванному шагу после решения человека.
Риск-ориентированная классификация против тотальной проверки
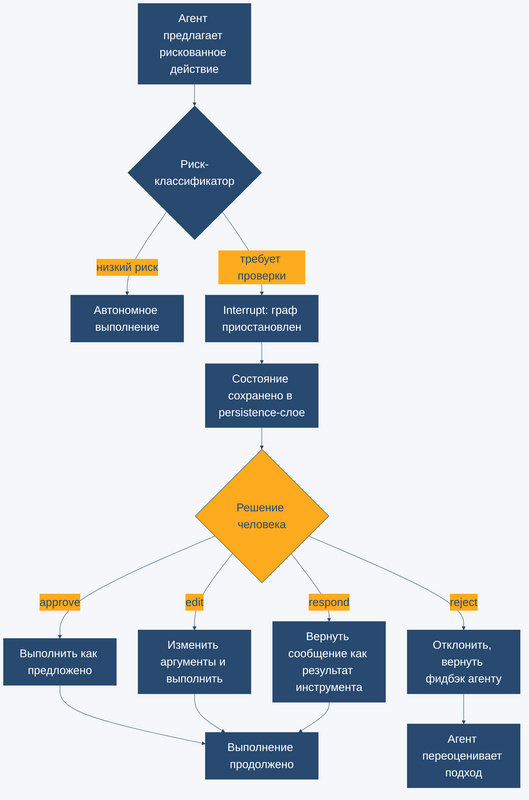
AWS Well-Architected требует, чтобы классификатор риска был детерминированным, то есть построенным на явных правилах, а не на LLM. Причина в безопасности. LLM-классификатор обрабатывает тот же недоверенный входной контент, что и сам запрос агента, поэтому враждебные данные способны манипулировать оценкой риска и занижать её. Классификатор относит операцию к одному из трёх уровней. Первый уровень выполняется автономно без участия человека. Второй требует одобрения одним ревьюером. Третий, самый рискованный, требует многоуровневого одобрения нескольких ревьюеров.
Read-only операции по этой же логике не должны проходить через HITL вообще. Документация AWS прямо называет тотальную проверку каждого шага агента анти-паттерном, который ведёт к рутинным формальным одобрениям вместо содержательного контроля.
Механизм паузы и возобновления агента (interrupt и checkpoint)
В LangChain за остановку выполнения отвечает примитив interrupt в LangGraph, графовом движке оркестрации, на котором построены агенты LangChain. Когда вызов инструмента совпадает с политикой одобрения, граф агента прерывается, а его текущее состояние сохраняется через persistence-слой LangGraph. Для продакшна нужен персистентный checkpointer, например AsyncPostgresSaver или MongoDBSaver, потому что без него граф не может безопасно приостановиться и возобновиться между вызовами модели.
Amazon Bedrock AgentCore Runtime решает ту же задачу на уровне инфраструктуры, а не кода агента. У него есть отдельный синхронный и асинхронный API с методами add_async_task и complete_async_task, а состояние runtime отражается статусами Healthy и HealthyBusy, пока ожидается решение ревьюера.
Принцип работы и жизненный цикл решения человека
Жизненный цикл паузы в LangChain состоит из четырёх шагов. Агент предлагает вызов инструмента, например запись в файл или выполнение SQL-запроса. Middleware сверяет вызов с политикой, и если требуется проверка, граф прерывается. Человек выносит решение одним из четырёх типов ответа. После решения агент либо продолжает выполнение с учётом ответа, либо получает фидбэк и переоценивает свой следующий шаг.
Четыре типа ответа человека на паузу агента
LangChain определяет ровно четыре типа решения, и это не взаимозаменяемые синонимы «да» и «нет».
- Approve. Выполнить вызов инструмента точно так, как предложил агент.
- Edit. Изменить аргументы вызова перед выполнением. Документация LangChain отдельно предупреждает, что значительное изменение аргументов может заставить модель переоценить весь свой подход и выполнить инструмент повторно или предпринять неожиданное действие, поэтому edit не нейтральная операция.
- Reject. Не выполнять вызов и вернуть агенту фидбэк для дальнейшего рассуждения.
- Respond. Вернуть сообщение человека напрямую как результат работы инструмента, обычно в сценарии «спросить пользователя». Документация прямо предупреждает не использовать respond как способ отклонить инструмент с побочными эффектами, для этого предназначен reject.
Ещё одно практическое ограничение касается порядка. Если агент одновременно запросил несколько действий, решения по ним должны подаваться в том же порядке, в каком действия перечислены в запросе на прерывание.
Таймауты и эскалация решения
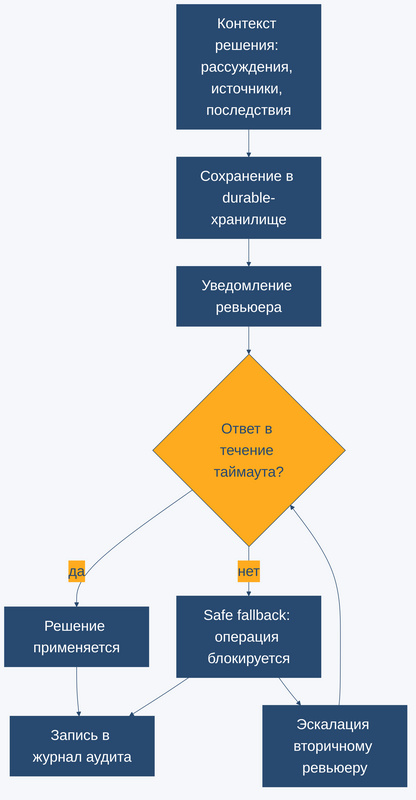
AWS Well-Architected добавляет к этой схеме уровень операционной дисциплины: документация LangChain описывает сам механизм паузы, но не задаёт политику вокруг уведомления ревьюера. Полный контекст решения, включая цепочку рассуждений агента, источники данных и последствия действия, сохраняется в durable-хранилище до отправки уведомления ревьюеру, иначе уведомление физически не вмещает нужный объём контекста. Если ревьюер не отвечает в заданное окно времени, система переходит в safe fallback, обычно это блокировка операции, и эскалирует запрос вторичному ревьюеру. Каждое решение логируется вместе с личностью ревьюера и таймстемпом для последующего аудита.
Отдельное числовое ограничение относится к Amazon Bedrock AgentCore Runtime. Блокирующее ожидание ответа ревьюера обязано выполняться в отдельном потоке или асинхронно, иначе оно блокирует эндпоинт /ping, и после 15 минут неотвечающих пингов runtime-сессия завершается принудительно.
Эволюция смысла от разметки данных к контролю рантайма агентов
Классическое понимание Human-in-the-Loop сложилось задолго до автономных ИИ-агентов и относилось к разметке данных для обучения моделей, когда человек проверял или исправлял метки в цикле итеративного обучения. В контексте агентного ИИ 2025-2026 годов акцент сместился на runtime-контроль над действиями уже обученного и работающего агента, то есть на approve, edit, reject или respond конкретного вызова инструмента в момент его исполнения. Это смещение видно по обоим источникам этой статьи, ни LangChain, ни AWS не описывают разметку датасетов, оба говорят исключительно о контроле исполнения. Прямой формулировки «было одно, стало другое» ни один источник не даёт, поэтому такой сдвиг стоит воспринимать как наблюдение по сопоставлению документации, а не как зафиксированный факт истории термина.
Подробнее о том, как агентные архитектуры вообще эволюционировали от простых чат-ботов к автономным рабочим процессам, написано в статье «От LLM до ИИ-агентов, эволюция чат-ботов и шаблоны рабочих процессов», где HITL уже упоминается как один из паттернов управления агентами.
Реализации паттерна в LangChain, AWS Bedrock и Step Functions
Одна и та же идея паузы на человеке реализована в разных фреймворках на разных уровнях абстракции, от кода конкретного агента до managed-сервиса без единой строчки собственной оркестрации.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
| Реализация | Уровень абстракции | Механизм паузы | Решение человека |
|---|---|---|---|
| LangChain middleware | код агента | interrupt LangGraph, состояние в persistence-слое | approve, edit, reject, respond |
| AWS Step Functions | оркестрация workflow | задача ждёт токен через waitForTaskToken, приложение вызывает SendTaskSuccess или SendTaskFailure | по сути approve или reject через отдельное приложение одобрения |
| Amazon Bedrock Agents, user confirmation | managed-агент | простая пауза перед одной функцией | да или нет |
| Amazon Bedrock Agents, Return of control | managed-агент, вся action group | агент возвращает вызов функции приложению целиком | обработка целиком на стороне приложения, конкретный набор решений платформа не специфицирует |
| Amazon Bedrock AgentCore Runtime | runtime длительных процессов | асинхронный API, add_async_task и complete_async_task, статусы Healthy и HealthyBusy, пока решение не получено | формируется приложением при вызове complete_async_task, конкретный набор типов решения источник не детализирует |
Выбор реализации зависит от того, где уже живёт агент. Если агент написан на LangGraph, естественнее остаться в middleware LangChain, потому что состояние графа и так проходит через persistence-слой. Если агент собран на Amazon Bedrock Agents, пауза встроена в платформу через user confirmation для простых да-нет решений или через Return of control для сложной обработки на стороне собственного приложения. Для процессов, которые оркеструются вне агентного фреймворка, например длительный approval workflow с несколькими системами, подходит паттерн Step Functions с ожиданием токена задачи.
Требования к эксплуатации таких паттернов в проде, включая безопасность автономных ИИ-пилотов, разбираются в курсе «ИИ-агенты для оптимизации бизнес-процессов».
Сценарии применения и границы применимости
HITL оправдан не для любого действия агента, а для операций с побочными эффектами и высокой ценой ошибки.
- Запись и изменение данных. Запись файлов, выполнение SQL-запросов, изменение конфигурации.
- Финансовые и необратимые операции. Транзакции, удаление данных, коммуникация от имени агента с внешними сторонами.
- Интерактивные сценарии с пользователем как ревьюером. Здесь подходят встроенные паттерны Bedrock Agents, user confirmation или Return of control, в отличие от асинхронного callback-паттерна Step Functions с отдельной ролью ревьюера.
Read-only операции, наоборот, должны выполняться автономно без паузы. AWS отдельно перечисляет анти-паттерны, которые превращают HITL из инструмента контроля в формальность.
- Тотальная маршрутизация через ревью. Проверка каждого действия агента независимо от уровня риска, а не только рискованных.
- Урезанный контекст в уведомлении. Ревьюер получает только предлагаемое действие без цепочки рассуждений и источников данных.
- Отсутствие таймаутов и эскалации. Выполнение агента зависает бессрочно, если ревьюер недоступен.
- Wildcard-доверие. Одобрение всех будущих операций данного типа без параметрического ограничения, документация AWS называет эту практику недопустимой.
Каждый из этих четырёх пунктов сводится к одному и тому же: HITL перестаёт работать не тогда, когда его нет, а тогда, когда он превращается в ритуал без реального анализа риска.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Пример конфигурации паузы на подтверждение
Ниже фрагмент из официальной документации LangChain по Human-in-the-loop. Показанная конфигурация не использует conditional interrupts, поэтому привязки к версии langchain>=1.3.3 у неё нет, эта версия нужна только для более узкого сценария с условным предикатом паузы. Агент получает три инструмента, и middleware настроено так, что запись файла требует одобрения на каждый вызов, выполнение SQL требует одобрения только с возможностью approve или reject, а чтение данных выполняется автономно без паузы.
# langchain, минимальная версия для этой конфигурации не указана (>=1.3.3 нужна только для conditional interrupts), источник https://docs.langchain.com/oss/python/langchain/human-in-the-loop
from langchain.agents import create_agent
from langchain.agents.middleware import HumanInTheLoopMiddleware
from langgraph.checkpoint.memory import InMemorySaver

# write_file требует одобрения на каждый вызов
# execute_sql можно только одобрить или отклонить, без edit
# read_data выполняется автономно, без паузы
agent = create_agent(
    model="gpt-5.5",
    tools=[write_file, execute_sql, read_data],
    middleware=[
        HumanInTheLoopMiddleware(
            interrupt_on={
                "write_file": True,
                "execute_sql": {"allowed_decisions": ["approve", "reject"]},
                "read_data": False,
            },
            description_prefix="Tool execution pending approval",
        ),
    ],
    checkpointer=InMemorySaver(),
)
Когда агент пытается удалить старые записи из базы данных, граф приостанавливается и возвращает объект прерывания. Возобновление выполнения для каждого из четырёх типов решения выглядит так.
# langchain, минимальная версия для этой конфигурации не указана (>=1.3.3 нужна только для conditional interrupts), источник https://docs.langchain.com/oss/python/langchain/human-in-the-loop
from langgraph.types import Command

config = {"configurable": {"thread_id": "some_id"}}

# approve, выполнить вызов инструмента как предложил агент
agent.invoke(
    Command(resume={"decisions": [{"type": "approve"}]}),
    config=config,
    version="v2",
)

# edit, изменить аргументы перед выполнением
agent.invoke(
    Command(
        resume={
            "decisions": [
                {
                    "type": "edit",
                    "edited_action": {
                        "name": "new_tool_name",
                        "args": {"key1": "new_value", "key2": "original_value"},
                    }
                }
            ]
        }
    ),
    config=config,
    version="v2",
)

# reject, не выполнять вызов и вернуть агенту фидбэк
agent.invoke(
    Command(
        resume={
            "decisions": [
                {
                    "type": "reject",
                    "message": "User rejected this action. Do not retry this tool call.",
                }
            ]
        }
    ),
    config=config,
    version="v2",
)

# respond, вернуть сообщение человека напрямую как результат инструмента
agent.invoke(
    Command(
        resume={
            "decisions": [
                {
                    "type": "respond",
                    "message": "Blue.",
                }
            ]
        }
    ),
    config=config,
    version="v2",
)
Заключение
Human-in-the-Loop работает как инструмент контроля только тогда, когда пауза ставится избирательно, на основе детерминированного риск-классификатора, а не перед каждым действием агента подряд. Четыре типа решения дают ревьюеру более точный инструмент, чем бинарное да или нет, а требования к контексту решения, таймаутам и аудиту превращают отдельную кнопку подтверждения в полноценный операционный процесс. Больше материалов про агентный ИИ и машинное обучение собрано в рубрике блога о машинном обучении.