
 18
Содержание
Durable Execution это архитектурный паттерн, при котором длительный процесс переживает крах воркера, обрыв сети или падение целого сервера и на следующем запуске продолжается ровно с места сбоя, не повторяя уже случившиеся побочные эффекты. У паттерна нет одного вендора-владельца и единой официальной страницы термина, его реализуют конкурирующие платформы Temporal, Restate и DBOS, а также встроенные механизмы вроде AWS Step Functions и Azure Durable Functions. Опорой для определения в статье взят Temporal как самая известная и задокументированная реализация паттерна, со сверкой по независимым источникам.
Что такое Durable Execution
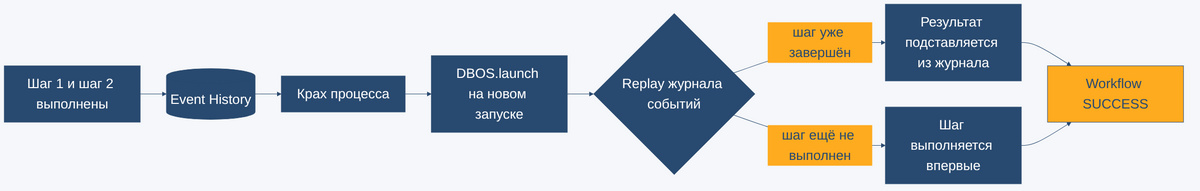
Отличие от обычного перезапуска процесса принципиальное. Классический retry после сбоя начинает выполнение заново с первой строки функции, и если один из шагов уже успел списать оплату, отправить письмо клиенту или дёрнуть внешний API, этот шаг выполнится ещё раз. Durable execution устраняет именно эту проблему. Платформа хранит журнал уже завершённых шагов и при восстановлении подставляет их результат вместо повторного выполнения, доигрывая только то, что не успело случиться до сбоя.
По независимому разбору (devstarsj.github.io, апрель 2026), Temporal и Restate за 2025 и 2026 годы закрепились как отдельный класс инфраструктуры для длительных распределённых процессов, каждый со своей моделью развёртывания. Иными словами, термин описывает уже не просто свойство отдельной функции, а категорию платформ, построенных вокруг одной гарантии, а именно довести процесс до конца через восстановление, эквивалентное повторному запуску, но без повторения уже завершившихся побочных эффектов.
Архитектура и ключевые компоненты durable execution
По официальной карте документации Temporal паттерн держится на пяти компонентах. Temporal Service это инфраструктурный слой платформы. Workers это процессы-исполнители, которые забирают задачи и выполняют код workflow и activity. Task Queues распределяют задачи между воркерами. SDK это клиентские библиотеки, через которые код workflow пишется на конкретном языке программирования. Ядром механизма восстановления служит Event History, структурированный журнал событий выполнения, по которому платформа определяет, что уже произошло, а что нет.
Три платформы реализуют одну и ту же гарантию тремя разными архитектурами. Temporal выносит durable-логику в отдельный процесс-воркер, которым управляет выделенный кластер Temporal Service. Restate работает похожим образом, но без отдельного процесса-воркера, разворачивается как sidecar или отдельный HTTP-native сервер и заявляет более низкую операционную нагрузку. DBOS встраивает durable-логику прямо в приложение и хранит состояние workflow в обычном PostgreSQL, без выделенного кластера, именно эта модель использована в демо статьи (сравнение архитектур подтверждено независимым разбором devstarsj.github.io, апрель 2026).
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Принцип работы durable execution
Журнал Event History фиксирует границы каждого завершённого шага workflow. Когда процесс восстанавливается после сбоя, платформа заново проходит код workflow с начала, но вместо повторного выполнения уже случившегося шага подставляет результат из журнала и переходит дальше. Такой проход называется replay, и у него есть жёсткое требование, а именно детерминизм кода workflow. Если код на повторном проходе примет другое решение, чем в первый раз, например из-за случайного числа или текущего времени внутри функции, журнал перестанет соответствовать реальному ходу выполнения, и восстановление сломается. Отдельный независимый разбор (jack-vanlightly.com, 24.11.2025) целиком посвящён именно этому требованию, детерминизму как условию корректного replay.
Для управления длинными процессами Temporal использует механизм Continue-As-New, который продолжает workflow новым исполнением вместо накопления одного бесконечно растущего журнала событий. Retry Policies задают, сколько раз и с какой задержкой платформа повторяет упавший шаг, прежде чем считать его окончательно провалившимся. Обмен сообщениями с уже запущенным workflow идёт через сигналы (Signals), запросы состояния (Queries) и обновления (Updates), что позволяет влиять на длительный процесс, не останавливая его.
Durable Execution vs checkpointing
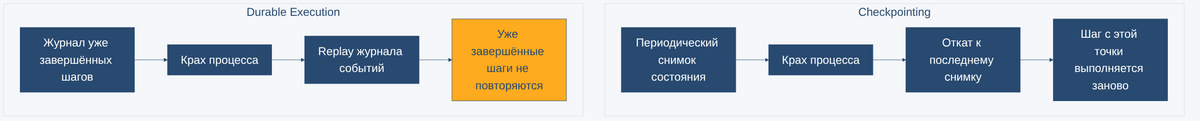
Checkpointing (чекпойнтинг) на первый взгляд решает ту же задачу, тоже переживает крах процесса, но другим способом. Чекпоинтер периодически сохраняет снимок текущего состояния, например состояния графа в LangGraph (фреймворк для построения графов ИИ-агентов), и при восстановлении откатывается к последнему снимку. Durable execution вместо снимка ведёт журнал уже выполненных шагов и восстанавливает процесс без повторного прохода уже случившихся побочных эффектов.
Разница не абстрактная, она проверена прогоном двух демо этого wiki-раздела. Демо-код статьи про checkpointing (checkpointing_langgraph_crash_resume.py) показывает, что узел графа, прерванный посреди работы, при восстановлении выполняется заново целиком, включая уже случившийся побочный эффект, лог внешнего вызова после resume содержит две строки вместо одной. Демо этой статьи на DBOS показывает обратное, каждый шаг workflow, зафиксированный в журнале, при восстановлении не выполняется повторно ни разу, счётчик побочных эффектов остаётся равен единице на шаг.
| Аспект | Checkpointing | Durable Execution |
|---|---|---|
| Что сохраняется | снимок состояния целиком на контрольной точке | журнал уже завершённых шагов |
| Что происходит при восстановлении | откат к последнему снимку, шаг с этой точки выполняется заново | replay пропускает уже завершённые шаги, доигрывается только оставшееся |
| Гарантия для побочных эффектов шага | не гарантирована, шаг может повториться | шаг не повторяется, если он уже был завершён и записан в журнал |
| Типичная реализация | LangGraph checkpointer, снимки в базе | Temporal Event History, шаги DBOS в PostgreSQL |
Устойчивое выполнение для ИИ-агентов
За 2025 и 2026 годы применение паттерна заметно сдвинулось. Раньше durable execution ассоциировался прежде всего с бизнес-процессами и оркестрацией микросервисов, а сейчас в официальной документации Temporal появились отдельные разделы Durable AI и AI Cookbook, посвящённые именно ИИ- и агентным приложениям. Тот же сдвиг видно и в независимых материалах zylos.ai, статьи «Durable Execution Patterns for AI Agents» (17.02.2026) и «Durable Execution for AI Agent Runtimes, Checkpointing, Replay, and Recovery» (24.04.2026) описывают ту же идею применительно к агентным рантаймам.
Механика переносится один в один. Агент, который вызывает внешние инструменты, отправляет платёж или пишет во внешнюю систему, а потом падает из-за сбоя LLM-провайдера или обрыва сети, при durable execution не повторяет уже выполненные вызовы инструментов. Платформа восстанавливает сессию с того шага рассуждения, на котором она остановилась, и не отправляет клиенту второе письмо только потому, что процесс упал через секунду после первой отправки.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Сценарии использования и отличительные черты
Паттерн применяется там, где процесс длится долго, состоит из нескольких шагов с внешними побочными эффектами, и повторение уже случившегося эффекта недопустимо. Даже у зрелых оркестраторов вроде Apache Airflow (курс «Apache Airflow для инженеров данных») крах воркера обычно означает retry задачи целиком, а не восстановление с внутреннего шага, подробный разбор причин такого сбоя есть в статье 4 причины SIGTERM в Apache Airflow. Durable execution решает ту же задачу на уровень глубже, восстанавливая процесс изнутри, а не перезапуская его целиком.
- Обработка заказов и платежей. Списание оплаты, резервирование товара и отправка подтверждения должны произойти ровно по разу каждое, даже если процесс упадёт между шагами.
- Долгие бизнес-процессы с ожиданием человека. Workflow может неделями ждать подтверждения от менеджера, не занимая ресурсы всё это время.
- Оркестрация внешних API с повторными попытками. Повторный вызов внешнего сервиса после сбоя не должен дублировать уже случившийся побочный эффект на его стороне.
- Долгие сессии ИИ-агентов. Многошаговое рассуждение с вызовами инструментов переживает падение процесса без повторения уже выполненных действий.
Общая черта всех сценариев одна, а именно недопустимость повторного побочного эффекта, а не просто требование в конце концов довести процесс до завершения.
Паттерн даётся не бесплатно. Код workflow обязан быть детерминированным, а значит существующую функцию с прямым обращением к случайным числам, текущему времени или внешнему API нельзя просто обернуть, шаги приходится выносить в отдельные вызовы. У Temporal и Restate это ещё и отдельная инфраструктура, кластер Temporal Service или sidecar-процесс, и для короткого запроса без риска повторного побочного эффекта такая архитектура не окупается. Официальная документация Temporal подтверждает существование отдельного раздела об ограничениях на размер журнала событий и payload, но точные цифры лимитов для этой статьи не проверялись.
Практика durable execution на DBOS
Демо построено на DBOS 2.31.0, потому что эта платформа не требует отдельного кластера и хранит состояние workflow прямо в уже поднятом PostgreSQL. Весь код статьи выложен на наш GitHub репозиторий.
Workflow process_order состоит из трёх шагов, списание оплаты, резервирование товара на складе и отправка подтверждения клиенту, с намеренной паузой между вторым и третьим шагом, чтобы было куда прицелиться краху процесса. Каждый шаг пишет в прикладную таблицу side_effects одну строку, это единственный источник правды о том, сколько раз реально выполнился побочный эффект. Полный код ниже, файл workflow_recovery_demo.py, база готовится вспомогательным скриптом db_setup.py.
# dbos 2.31.0, PostgreSQL 18.4 (Homebrew), psycopg 3.3.4, прогнано на стенде 2026-09-04
"""
Ядро durable execution на примере DBOS: workflow из трёх шагов переживает
жёсткий крах процесса (kill -9 снаружи, между шагом 2 и шагом 3) и на
следующем запуске программы доигрывается сам - без единой строки кода вида
"восстанови меня с такого-то места".

Механика восстановления: DBOS.launch() при старте процесса сам находит
незавершённые workflow, которые ранее исполнял этот же executor
(по умолчанию executor_id == "local", стабилен между перезапусками), и
доигрывает их с прерванного места в фоновом потоке.

Проверяемое отличие от чекпоинтинга снимком состояния: шаги 1 и 2 не
выполняются повторно. Это видно по таблице side_effects - после краха и
восстановления там ровно одна строка на каждый шаг, а не две на первые два.

Запуск (подробности и вывод по шагам в RUNBOOK.md):
    python3 workflow_recovery_demo.py start &
    PID=$!
    sleep 2 && kill -9 $PID        # жёсткий крах между шагом 2 и шагом 3
    python3 workflow_recovery_demo.py recover
"""

import os
import sys
import time

import psycopg
from dbos import DBOS, DBOSConfig, SetWorkflowID

DEMO_DSN = "postgresql://techfriends@localhost:5432/durable_execution_demo"
WORKFLOW_ID = "order-42"  # фиксированный id, чтобы "recover" нашёл тот же workflow
ORDER_ID = "42"
SLEEP_WINDOW_SECONDS = 5  # окно, в которое снаружи прилетает kill -9

config: DBOSConfig = {
    "name": "durable_execution_demo",
    "system_database_url": DEMO_DSN,
}
DBOS(config=config)


def _log_side_effect(step_name: str) -> None:
    """Реальный побочный эффект шага - строка в прикладной таблице, а не
    просто возврат значения из функции. Повторное выполнение шага добавило
    бы вторую строку, и это станет видно в count_side_effects()."""
    with psycopg.connect(DEMO_DSN, autocommit=True) as conn:
        conn.execute(
            "INSERT INTO side_effects (workflow_id, step_name, order_id) "
            "VALUES (%s, %s, %s)",
            (DBOS.workflow_id, step_name, ORDER_ID),
        )


@DBOS.step()
def charge_payment() -> None:
    print("шаг 1: списываем оплату", flush=True)
    _log_side_effect("charge_payment")


@DBOS.step()
def reserve_inventory() -> None:
    print("шаг 2: резервируем товар на складе", flush=True)
    _log_side_effect("reserve_inventory")


@DBOS.step()
def send_confirmation() -> None:
    print("шаг 3: отправляем подтверждение клиенту", flush=True)
    _log_side_effect("send_confirmation")


@DBOS.workflow()
def process_order() -> None:
    charge_payment()
    reserve_inventory()
    # DBOS.sleep, а не time.sleep: длительность паузы тоже часть durable-
    # состояния workflow, при восстановлении DBOS не будет спать заново то
    # время, что уже прошло с исходного старта.
    DBOS.sleep(SLEEP_WINDOW_SECONDS)
    send_confirmation()


def count_side_effects() -> dict[str, int]:
    with psycopg.connect(DEMO_DSN) as conn:
        rows = conn.execute(
            "SELECT step_name, count(*) FROM side_effects "
            "WHERE workflow_id = %s GROUP BY step_name ORDER BY step_name",
            (WORKFLOW_ID,),
        ).fetchall()
    return dict(rows)


def main() -> None:
    mode = sys.argv[1] if len(sys.argv) > 1 else "start"
    DBOS.launch()

    if mode == "start":
        print(f"PID={os.getpid()}", flush=True)
        with SetWorkflowID(WORKFLOW_ID):
            handle = DBOS.start_workflow(process_order)
        # Дожидаемся результата в первом процессе только если его не убьют
        # снаружи в течение SLEEP_WINDOW_SECONDS - по сценарию демо так и
        # происходит, эта ветка для контрольного запуска без kill -9.
        handle.get_result()
        print("workflow завершился без сбоя (контрольный прогон)", flush=True)
    elif mode == "recover":
        # DBOS.launch() уже поставил фоновое восстановление незавершённых
        # workflow предыдущего процесса. Ждём его исхода и проверяем результат.
        time.sleep(SLEEP_WINDOW_SECONDS + 2)
        status = DBOS.get_workflow_status(WORKFLOW_ID)
        print("статус workflow после восстановления:", status.status if status else None, flush=True)
        print("побочные эффекты по шагам:", count_side_effects(), flush=True)
    else:
        raise SystemExit(f"неизвестный режим: {mode} (start | recover)")


if __name__ == "__main__":
    main()
Контрольный прогон без сбоя проходит все три шага подряд и завершается штатно. Сценарий с крахом выглядит так, база пересоздаётся скриптом db_setup.py, workflow запускается в фоне, а через 2 секунды процесс убивается сигналом kill -9 прямо во время намеренной паузы между шагом 2 и шагом 3.
запущен PID=84846, ждём 2с и убиваем kill -9 (крах между шагом 2 и 3)
процесс убит, проверяем побочные эффекты ДО восстановления
     step_name     | count
-------------------+-------
 charge_payment    |     1
 reserve_inventory |     1
(2 rows)

=== ДЕМО 4: следующий запуск процесса - автоматическое восстановление ===
20:06:38 [INFO] Recovering 1 workflows from application version ...
шаг 3: отправляем подтверждение клиенту
статус workflow после восстановления: SUCCESS
побочные эффекты по шагам: {'charge_payment': 1, 'reserve_inventory': 1, 'send_confirmation': 1}
После краха в базе ровно по одной строке на charge_payment и reserve_inventory, строки send_confirmation нет вообще, потому что процесс убит раньше третьего шага. На следующем запуске процесса, в режиме recover, DBOS.launch() сам находит незавершённый workflow order-42 и доигрывает его в фоновом потоке. В выводе печатается только строка шага 3, шаги 1 и 2 не выполняются заново, а их результат просто подставляется из журнала. Итоговый счётчик побочных эффектов равен единице на каждый шаг, несмотря на жёсткий крах между шагом 2 и шагом 3, это и есть главный проверяемый факт статьи.
Заключение
Durable execution даёт длительному процессу гарантию, которой не хватает обычному retry, а именно довести процесс до конца, восстановившись ровно с места сбоя и не повторив уже случившиеся побочные эффекты. Temporal, Restate и DBOS реализуют эту гарантию тремя разными архитектурами, но опираются на один и тот же принцип, журнал уже завершённых шагов вместо снимка всего состояния. Прогон демо на DBOS показал разницу с checkpointing не в теории, а в счётчике побочных эффектов, после жёсткого краха процесса каждый шаг workflow остаётся выполненным ровно один раз. В 2025 и 2026 годах тот же принцип переносится на ИИ-агентов, где durable execution избавляет от повторных вызовов инструментов после сбоя LLM-провайдера так же надёжно, как избавляет от повторного списания оплаты в обычном workflow.