1
Содержание
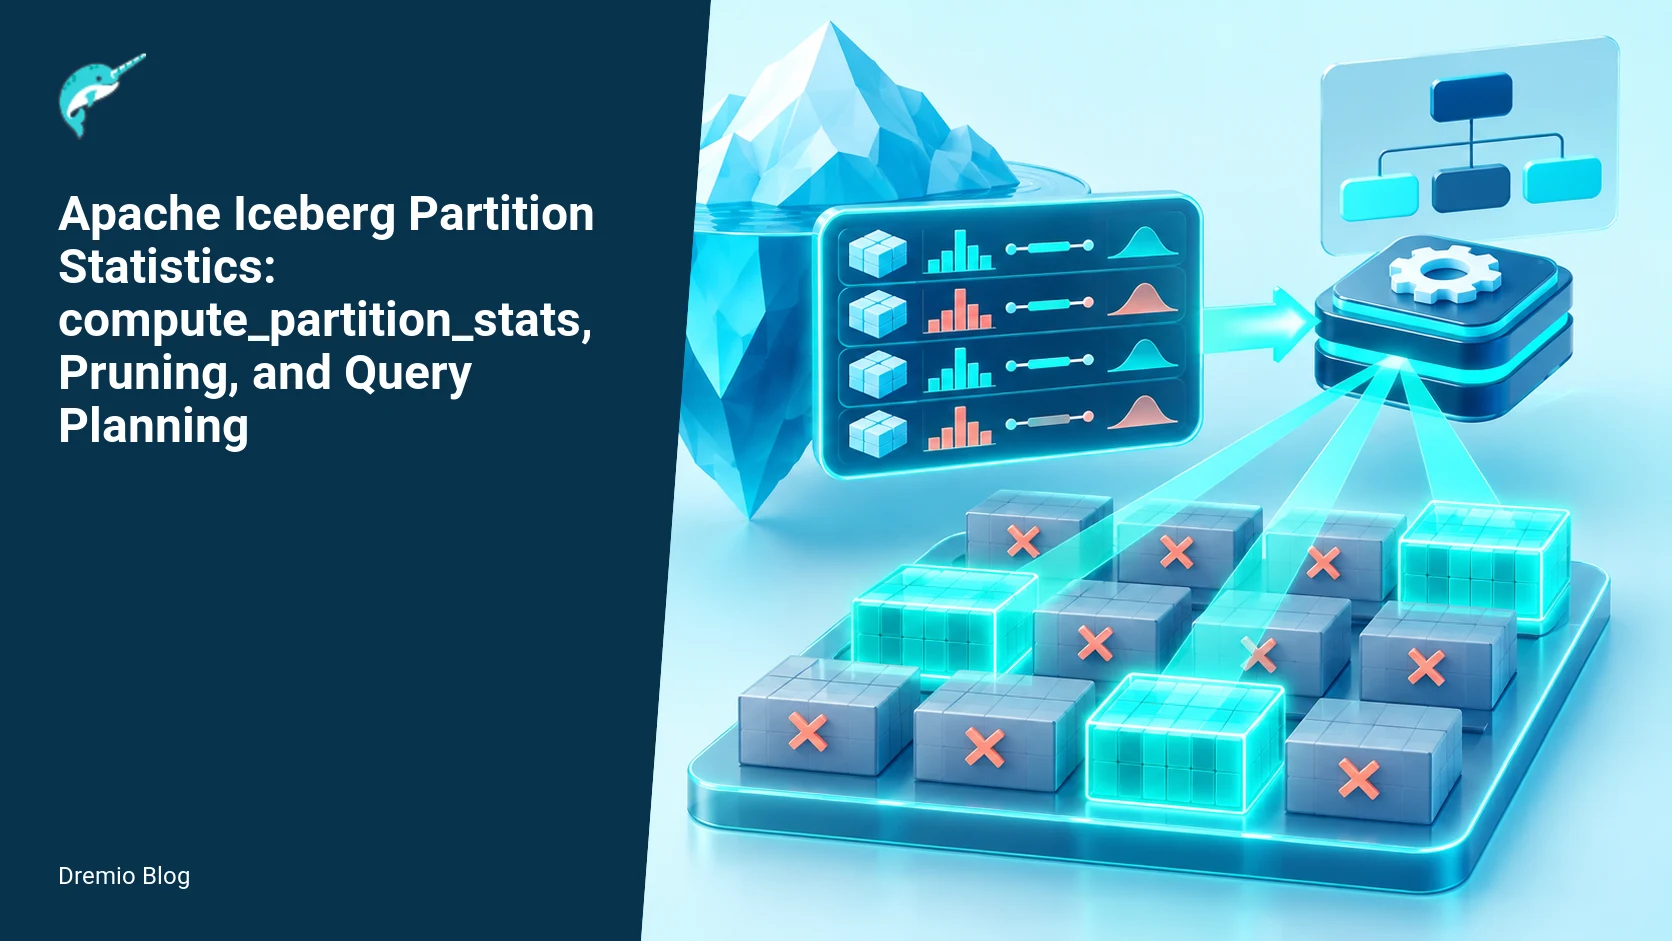
Apache Iceberg получил механизм инкрементального подсчёта статистики по партициям. Это позволяет движкам запросов точнее оценивать объём данных перед сканированием и сильнее сокращать объём чтения. Изменение особенно заметно при работе со Spark, где планировщик раньше опирался только на общую статистику колонок. Теперь появляется отдельный слой метаданных, который описывает распределение значений внутри каждой партиции.
Как устроена модель метаданных
Новые метаданные хранятся отдельно от обычных файлов манифеста. Для каждой партиции записывается набор агрегатов: минимальные и максимальные значения, количество строк и объём данных. Эти записи обновляются только при появлении новых файлов в партиции, поэтому пересчёт не затрагивает уже обработанные данные. Такой подход снижает нагрузку на каталог и ускоряет операции commit.
Партиции в Iceberg представляют собой логические сегменты таблицы, сформированные по значениям одной или нескольких колонок. Статистика по ним помогает понять, какие диапазоны данных реально присутствуют в каждом сегменте. При чтении планировщик получает эти агрегаты до того, как начнёт просматривать файлы данных. Это даёт возможность сразу отбросить целые партиции, если их диапазоны не пересекаются с условиями фильтра. В отличие от прежней статистики NDV по колонкам, партиционная статистика учитывает физическое размещение данных и потому даёт более точные оценки selectivity. NDV показывает, сколько уникальных значений встречается в колонке в целом, но не учитывает, как эти значения распределены по физическим файлам. Selectivity в свою очередь измеряет долю строк, которые удовлетворяют условию запроса; чем точнее эта оценка, тем меньше лишних данных попадёт в обработку.
Влияние на pruning и планирование
Раньше планировщик Spark часто переоценивал объём чтения, потому что опирался на глобальные метрики. С новой статистикой он может сравнивать условия запроса с диапазонами внутри каждой партиции и исключать нерелевантные файлы ещё на этапе планирования. В результате уменьшается количество задач и снижается время ожидания.
Pruning здесь означает механизм отсечения ненужных данных ещё до чтения файлов. Отдельное преимущество проявляется при запросах с несколькими фильтрами по разным колонкам. Партиционная статистика позволяет комбинировать оценки по нескольким полям одновременно, чего раньше добиться было сложно. Однако точность зависит от того, насколько равномерно данные распределены внутри партиций. При сильном перекосе оценки могут оставаться консервативными, и планировщик всё равно будет читать больше данных, чем теоретически необходимо. Это важно учитывать при решении о внедрении: если таблица имеет выраженный перекос по ключевым колонкам, прирост от новой статистики окажется modest.
Ограничения и вопросы интеграции
Функция требует явного вызова compute_partition_stats и не работает автоматически при каждой записи. Кроме того, статистика не обновляется при удалении или перезаписи файлов, поэтому в сценариях с частыми изменениями нужно планировать периодический пересчёт. Отсутствие поддержки в старых версиях каталогов может привести к ошибкам чтения, если кластер использует смешанные версии клиентов.
В российских контурах, где Iceberg чаще всего запускают на собственном Spark без облачных каталогов, эта возможность даёт заметный прирост при работе с крупными таблицами событий. Командам стоит проверить совместимость используемой версии Iceberg и добавить вызов статистики в пайплайны инкрементальной загрузки. При этом важно учитывать, что дополнительная запись метаданных увеличивает размер каталога и требует мониторинга. Перед внедрением стоит оценить, как часто происходят операции удаления и перезаписи: если такие операции регулярны, накладные расходы на поддержание актуальности статистики могут нивелировать выигрыш от более точного pruning.
Практические выводы для внедрения
Перед включением статистики стоит оценить, насколько текущие запросы страдают от избыточного сканирования. Если pruning уже даёт хорошие результаты за счёт хорошо выбранных ключей партиционирования, эффект может оказаться modest. В обратном случае новая метрика помогает быстрее получить выигрыш без изменения схемы таблиц.
Разделение партиционной статистики от NDV позволяет включать их независимо и контролировать overhead. Для команд, которые уже используют Iceberg с Spark 3.3+, это изменение стоит протестировать на копии продакшн-таблиц, чтобы измерить реальное сокращение прочитанных данных и время планирования. Решение о внедрении имеет смысл принимать после анализа типичных запросов: если фильтры часто затрагивают колонки партиционирования и данные внутри партиций распределены относительно равномерно, статистика даст ощутимый эффект. В противном случае прирост может оказаться незначительным по сравнению с затратами на поддержку дополнительных метаданных.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Статистика партиций Iceberg ускоряет планирование запросов.
Курс по теме — Каталог курсов Школы Больших Данных