
Cloudera CDH (Cloudera’s Distribution including Apache Hadoop) — дистрибутив Apache Hadoop с набором программ, библиотек и утилит, разработанных компанией Cloudera для больших данных (Big Data) и машинного обучения (Machine Learning), бесплатно распространяемый и коммерчески поддерживаемый для некоторых Linux-систем (Red Hat, CentOS, Ubuntu, SuSE SLES, Debian) [1]. Состав и архитектура Клаудера...
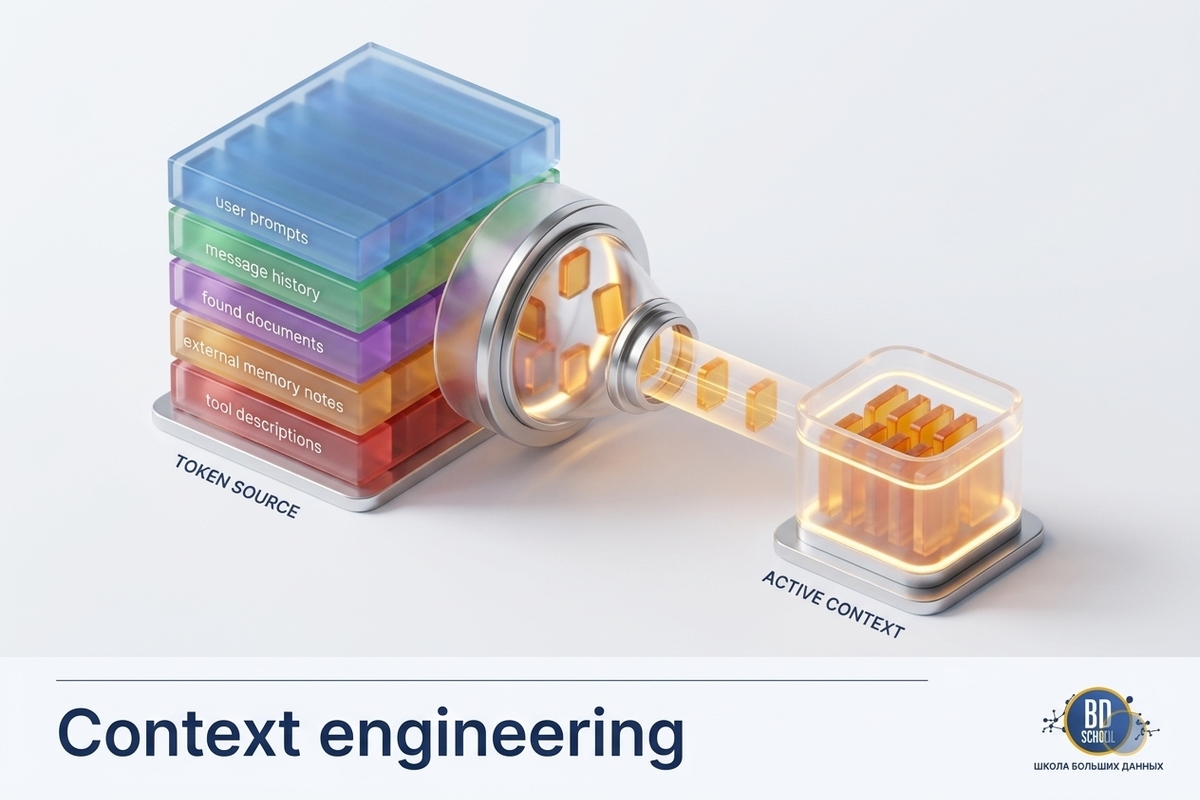
Context engineering (контекст инжиниринг) это инженерная практика, которая решает, какие токены попадут в контекстное окно большой языковой модели (LLM, large language model) на каждом шаге работы приложения или ИИ-агента. В окно идут не только промпт и вопрос пользователя, но и описания инструментов, история сообщений, результаты вызовов, найденные документы и...
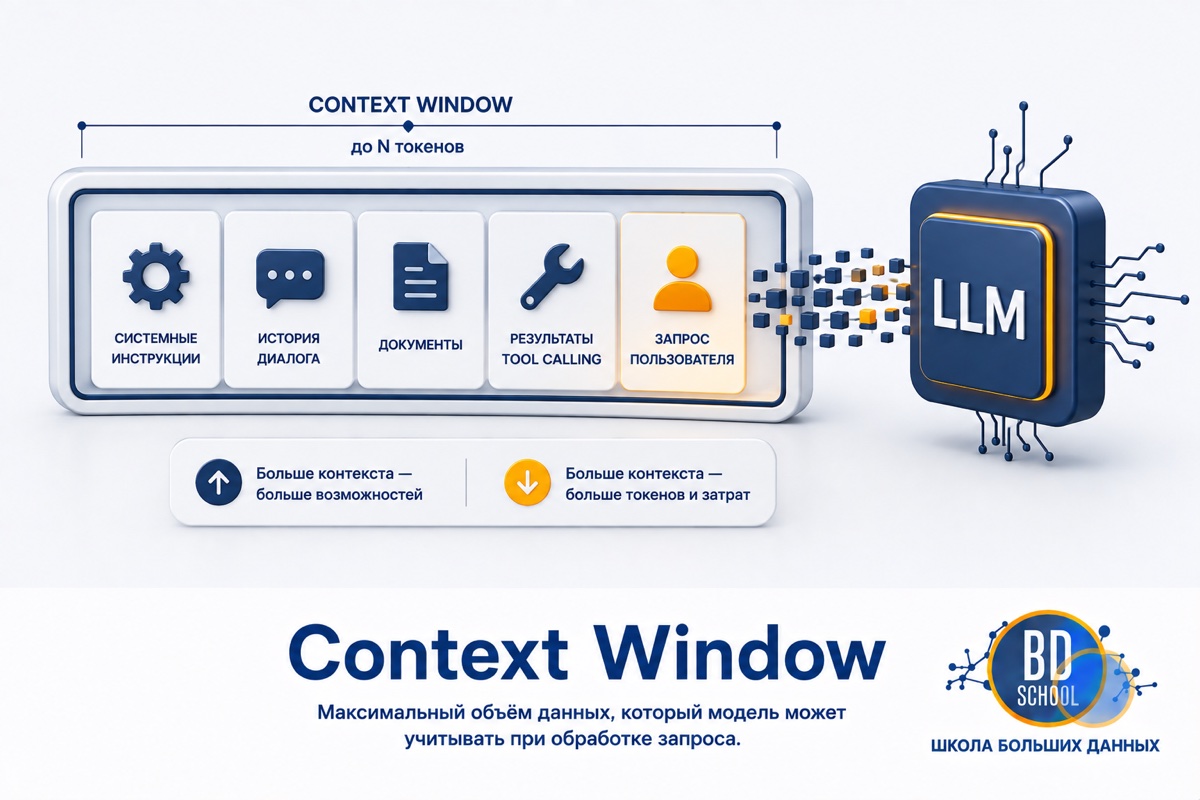
Context window (Контекстное окно) это максимальное число токенов, которое языковая модель обрабатывает за один вызов. В этот бюджет входит всё сразу, а именно системный промпт, история переписки, подложенные документы и сам ответ, который модель ещё только собирается написать. Отсюда два следствия, о которых чаще всего забывают. Заявленный размер окна...
COFA (Copy on First Access) - это стратегия управления памятью, при которой данные копируются только при первом обращении к ним, что позволяет отложить накладные расходы и снизить избыточное копирование по сравнению с немедленным дублированием данных. COFA (Copy on First Access) - это аппаратный алгоритм отложенного копирования блоков данных на уровне...
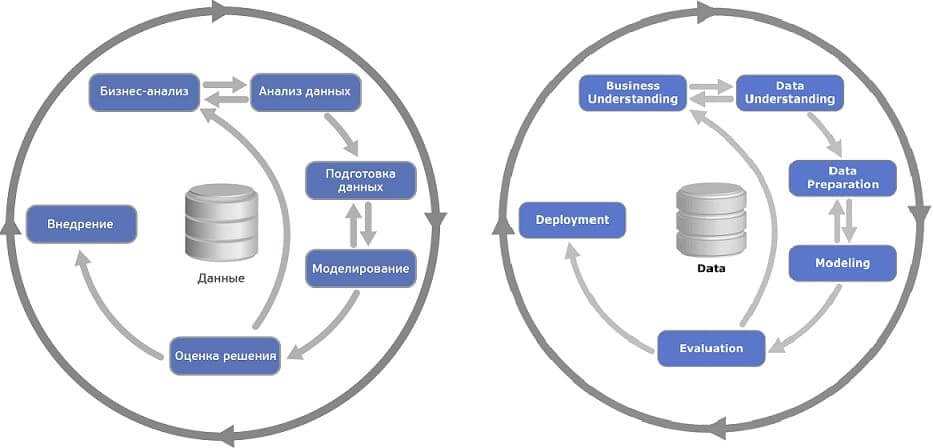
CRISP-DM (от английского Cross-Industry Standard Process for Data Mining) — межотраслевой стандартный процесс исследования данных. Это проверенная в промышленности и наиболее распространённая методология, первая версия которой была представлена в Брюсселе в марте 1999 года, а пошаговая инструкция опубликована в 2000 году [1]. CRISP-DM описывает жизненный цикл исследования данных, состоящий из...

Cursor — это интеллектуальная интегрированная среда разработки (IDE), созданная на основе VS Code, которая использует передовые большие языковые модели (LLM) для глубокого анализа, написания и отладки программного кода. Cursor позиционируется не как дополнение, а как самостоятельный инструмент с нативной поддержкой ИИ1. Главная особенность редактора заключается в его способности...
DAG (Directed Acyclic Graph) - это ориентированная ацикличная структура, используемая для формального описания зависимостей и упорядочивания вычислительных процессов таким образом, чтобы исключить циклы и обеспечить строго определённую последовательность выполнения. В отличие от простых списков дел, DAG позволяет моделировать сложные нелинейные процессы, где одни задачи могут выполняться параллельно, а...
Dagster — это оркестратор данных, предназначенный для разработки, выполнения и мониторинга пайплайнов обработки данных на основе DAG, с акцентом на типизацию данных, тестируемость и прозрачность выполнения. Главная цель этого инструмента состоит в управлении активами данных. Активы включают таблицы, файлы и модели машинного обучения. Традиционные оркестраторы фокусируются исключительно на порядке...
Dask — это гибкая библиотека для параллельных вычислений на Python, которая позволяет масштабировать привычные инструменты, такие как NumPy, Pandas и Scikit-learn, для работы с большими данными. Dask: Что это такое Привет! Сегодня поговорим о Dask. Если ты хоть раз сталкивался с ситуацией, когда твой любимый Pandas падал с...
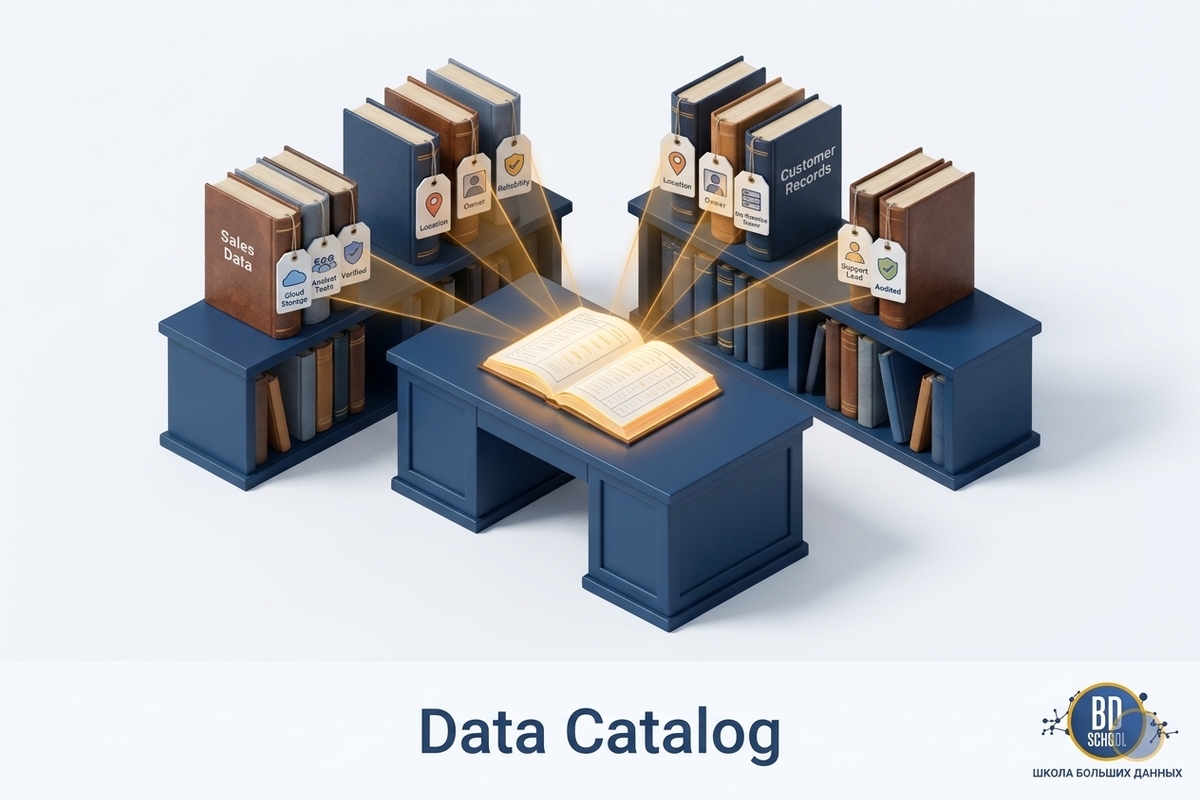
Data Catalog (каталог данных) это централизованный реестр метаданных, который отвечает на четыре вопроса про данные организации, а именно какие они есть, где лежат, кто за них отвечает и можно ли им доверять. Каталог собирает описания таблиц, файлов, витрин, дашбордов и пайплайнов, связывает их между собой и отдаёт через поиск,...
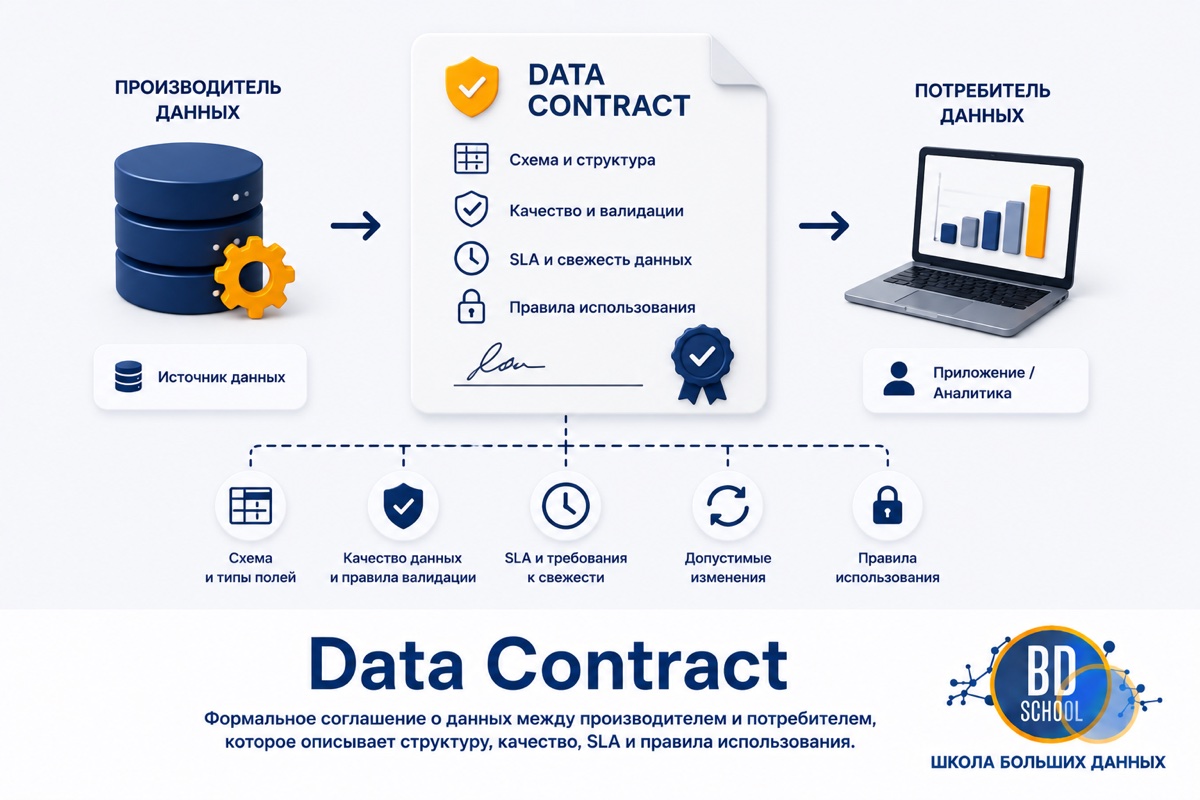
Data contract (Контракт данных) это машиночитаемое соглашение между поставщиком и потребителем набора данных, где зафиксированы схема, типы полей, правила качества и сроки поставки. Ключевое слово здесь машиночитаемое. Страница в корпоративной вики о том, что сумма заказа обязана быть числом, никому не мешает поменять тип колонки на текстовый в ближайший вторник....
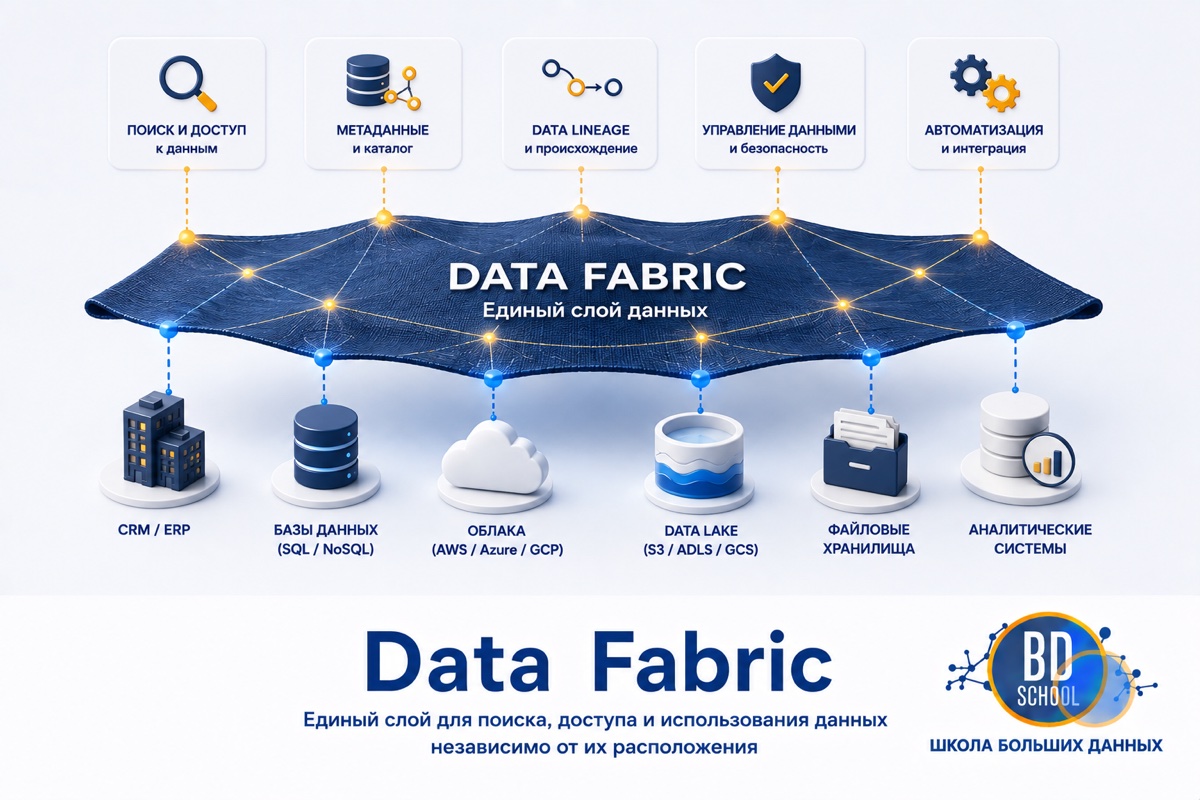
Data Fabric (data fabric) это архитектурная концепция управления данными, которую как отдельную категорию ввела аналитическая компания Gartner. Концепция описывает архитектуру, где непрерывно собираемый и анализируемый слой активных метаданных (active metadata) автоматически связывает разрозненные источники данных в гибридных, мультиоблачных и edge-средах, не перемещая сами данные физически в единое хранилище. Что...
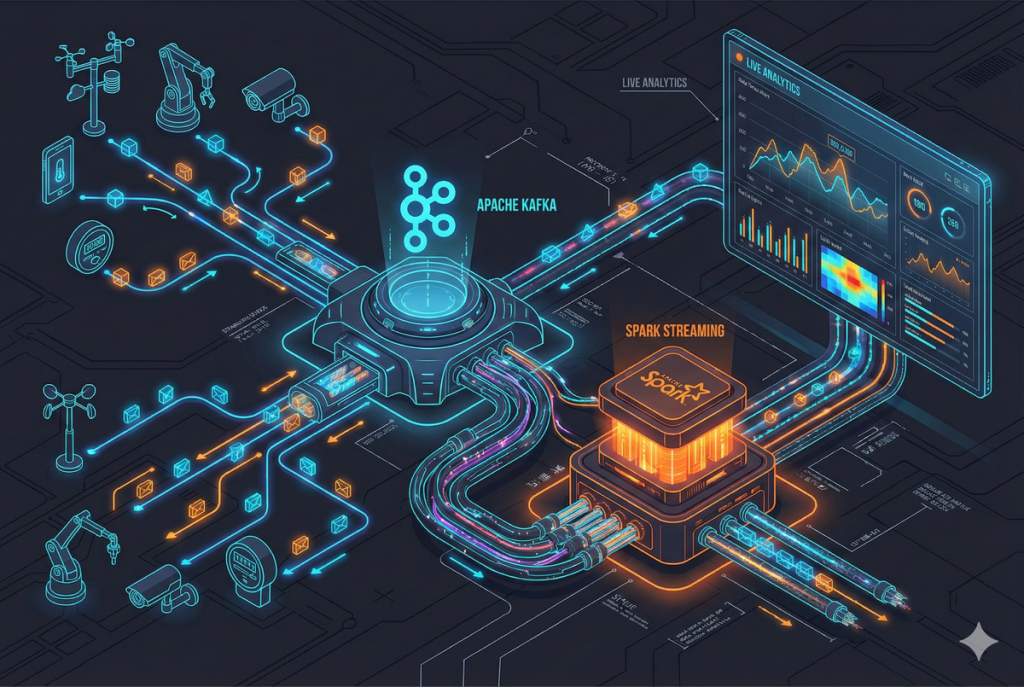
Dataflow, или поток данных, представляет собой концепцию, важную для понимания того, как данные перемещаются и обрабатываются в программном коде. Эта концепция играет ключевую роль в различных областях программирования, включая параллельное программирование, асинхронное выполнение и обработку событий. В программировании поток данных представляет собой направление перемещения данных от одного участка кода к...
Data Governance (DG) — это организация стратегического управления данными в компании. На практике она реализуется через фреймворк, который включает в себя систему правил, процессов, политик и зон ответственности. Этот фреймворк определяет, как организация управляет своими данными на протяжении всего их жизненного цикла — от создания до архивации или удаления...
Data Lake (озеро данных) — это логическая совокупность репозиториев данных, предназначенных для хранения и анализа больших данных в их исходном формате. В отличие от традиционного понимания централизованного хранилища, Data Lake может быть распределенным по множеству физических местоположений, включая облачные платформы, on-premises инфраструктуру или гибридные среды. Концепция озера данных...
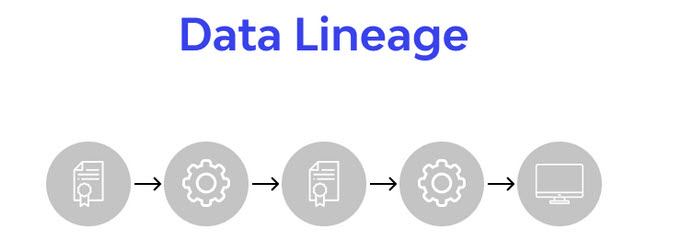
Data Lineage (линейность данных) — это процесс отслеживания, визуализации и понимания пути данных от их источника до конечного потребителя. Он включает в себя все точки остановки и трансформации на этом пути, отвечая на ключевые вопросы: откуда пришли данные, что с ними произошло и куда они направляются. Если представить все данные...
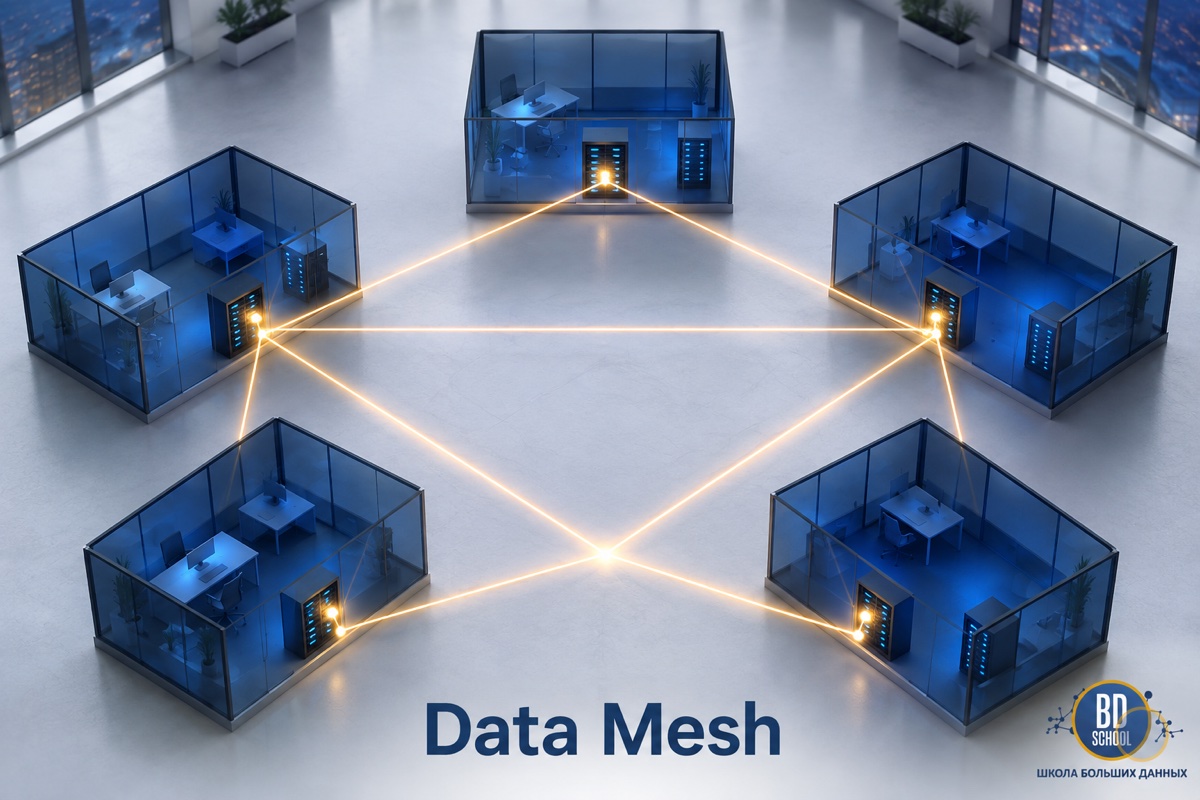
Data Mesh (дословно «сетка данных») это архитектурный и организационный подход к управлению корпоративными данными. Ответственность за аналитические данные здесь распределяется между бизнес-доменами, а не концентрируется в одной центральной команде. Термин ввела Zhamak Dehghani в 2019 году. С тех пор Data Mesh остаётся одним из самых обсуждаемых и одновременно самых...
Data Mining - процесс поиска в сырых необработанных данных интересных, неизвестных, нетривиальных взаимосвязей и полезных знаний, позволяющих интерпретировать и применять результаты для принятия решений в любых сферах человеческой деятельности. Представляет собой совокупность методов визуализации, классификации, моделирования и прогнозирования, основанные на применении деревьев решений, искусственных нейронных сетей, генетических алгоритмов, эволюционного программирования, ассоциативной памяти, нечёткой логики. Дополнительно о...
Data observability (Наблюдаемость данных) это практика непрерывного сбора метаданных о датасетах и конвейерах, при которой состояние витрины оценивается не по фиксированному порогу, а по её собственной истории. Термин пришёл из наблюдаемости в эксплуатации приложений, где по метрикам, логам и трассировкам восстанавливают поведение системы, которую нельзя остановить и разобрать. С данными...
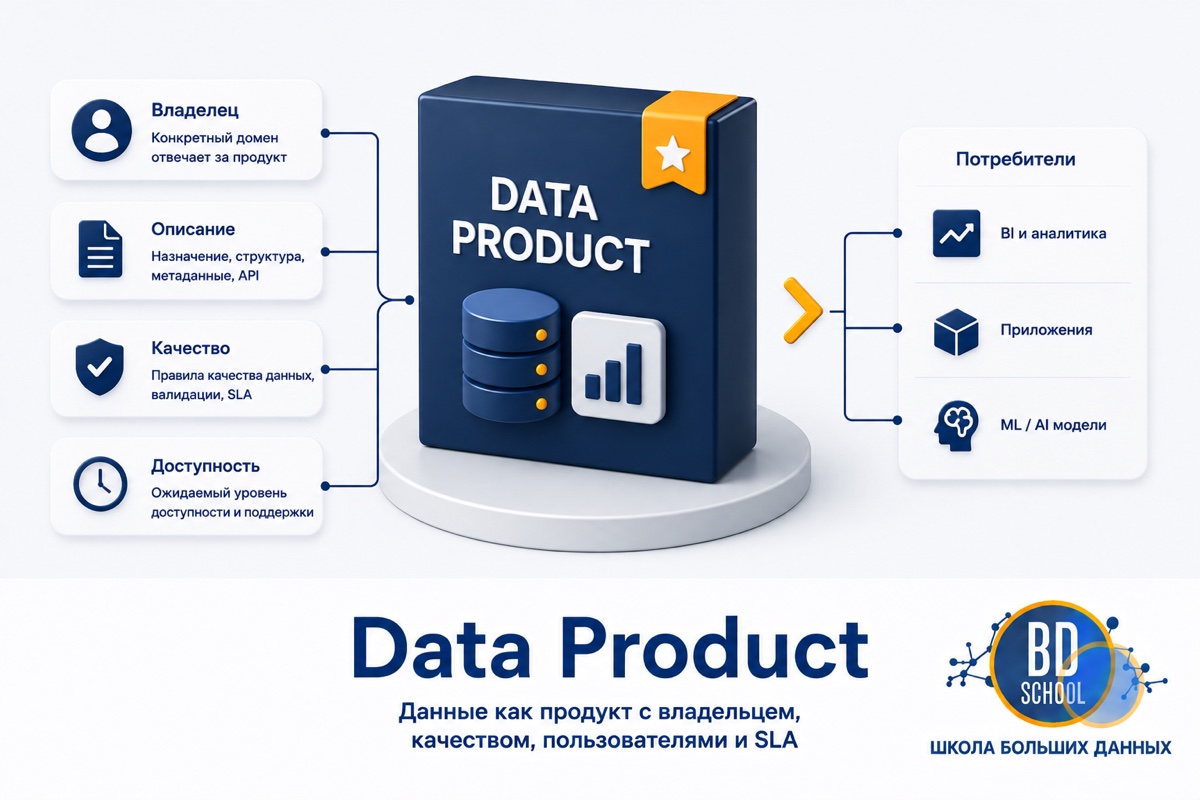
Data Product (дата-продукт) это самостоятельная единица данных, которую домен-производитель отдаёт другим командам через явный интерфейс с гарантиями качества, а не сырой выгрузкой из таблицы. Подход вырос из архитектуры Data Mesh, но применяется и там, где никакого mesh нет, везде, где команда хочет, чтобы её данные находили, понимали и использовали без...