 6
Содержание
- Что такое качество данных и зачем оно нужно
- Дименсии качества данных
- Классический набор дименсий accuracy, completeness, consistency, validity, timeliness, uniqueness
- Новые дименсии AI-эпохи integrity и auditability
- Как качество данных проверяют на практике
- Архитектура GX Core от Data Context до Expectation
- Validation Definition и Checkpoint запускают проверку и формируют отчёт Data Docs
- Data Quality и Data Observability не одно и то же
- Когда автоматизировать проверку качества, а когда не стоит
- Практика проверки качества данных в PostgreSQL с Great Expectations
- Заключение
- Референсные ссылки
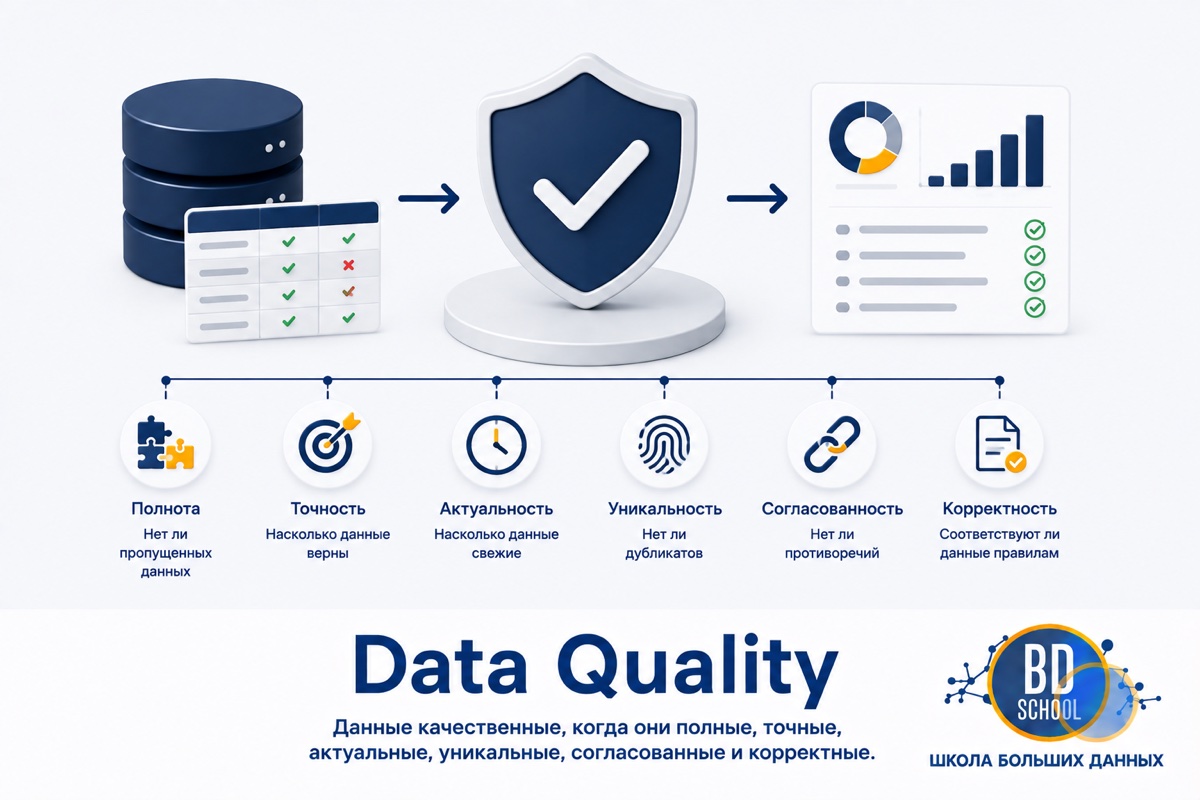
Data quality (Качество данных) это степень пригодности данных для конкретной задачи, будь то аналитический отчёт, обучение модели или работа AI-агента. Плохое качество редко видно сразу. Оно проявляется позже, когда отчёт расходится с реальностью, модель обучается на противоречивых примерах или агент принимает решение на основе пустого поля.
Что такое качество данных и зачем оно нужно
Данные попадают в компанию из десятков источников. Транзакционная база, форма на сайте, внешний API партнёра, лог событий приложения, файл, который прислал контрагент. У каждого источника свой набор дефектов, пропуски в обязательных полях, дубли записей, неверный формат, значения, которые давно устарели. По отдельности такой дефект выглядит мелочью. В агрегате на тысячах и миллионах строк он искажает отчёт, ломает джойн (join) в аналитической витрине или подаёт модели противоречивый сигнал.
Качество данных как практика занимается тем, чтобы такие дефекты не доходили до аналитика, модели или бизнес-процесса незамеченными. Это не разовая чистка перед релизом, а повторяемая проверка, встроенная в конвейер данных так же, как модульные тесты встроены в сборку кода. Смежные дисциплины, Data Governance (управление данными как активом организации), Data Contract (контракт между поставщиком и потребителем данных) и свод знаний DAMA-DMBOK (Data Management Body of Knowledge, отраслевое руководство по управлению данными), задают более широкую рамку управления данными, её целиком разбирает курс «Архитектура данных». Качество данных внутри этой рамки отвечает на узкий вопрос, можно ли доверять конкретному набору строк прямо сейчас.
Дименсии качества данных
Качество данных не сводится к одному числу. Практика data engineering раскладывает его на измеримые характеристики, дименсии (dimensions), каждая из которых проверяется отдельным правилом и может отдельно проваливаться, пока остальные держатся в норме.
Классический набор дименсий accuracy, completeness, consistency, validity, timeliness, uniqueness
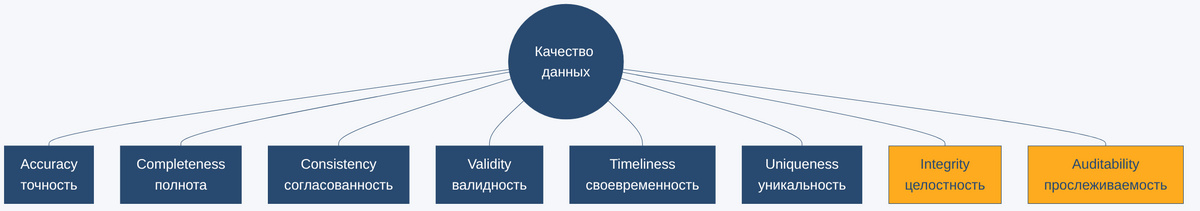
По совокупности источников эти шесть дименсий считаются общепринятым базовым набором индустрии и встречаются в большинстве материалов на тему, хотя единого официального стандарта, который бы их фиксировал, нет.
- Accuracy (точность). Значение соответствует реальному положению дел, а не просто имеет правильный тип и формат.
- Completeness (полнота). Обязательные поля заполнены, в записи нет незапланированных пропусков.
- Consistency (согласованность). Одно и то же понятие записано одинаково во всех местах, без разнобоя регистра, синонимов или единиц измерения.
- Validity (валидность). Значение проходит формат и бизнес-правило, email похож на email, сумма заказа не отрицательна.
- Timeliness (своевременность). Данные актуальны на момент использования, а не устарели или не пришли из будущего по ошибке источника.
- Uniqueness (уникальность). Одна сущность представлена одной записью, без случайных дублей.
Эти шесть дименсий покрывают классические проблемы batch-загрузок и OLTP-источников (Online Transaction Processing, системы обработки транзакций), с которыми data engineering работает десятилетиями.
Новые дименсии AI-эпохи integrity и auditability
По совокупности источников рост конвейеров с участием LLM и AI-агентов подталкивает добавлять к классическому набору две дименсии, на которые раньше обращали меньше внимания.
Integrity (структурная целостность) описывает связи между таблицами, а не значения внутри одной колонки. Внешний ключ заказа должен указывать на реально существующего клиента, иначе агрегация по клиентам молча теряет часть заказов. Auditability (прослеживаемость) требует, чтобы для любого числа в отчёте можно было восстановить путь от источника через все трансформации. Когда решение принимает автономный агент, а не человек, который может пересчитать вручную и заметить нестыковку, восстановление этого пути становится не факультативной возможностью, а условием доверия к результату вообще.
Аналитика больших данных для руководителей
Код курса
BDAM
Ближайшая дата курса
28 сентября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Как качество данных проверяют на практике
Дименсии описывают, что именно проверять. Механизм проверки в data engineering обычно строится вокруг expectation-фреймворка, инструмента, который превращает правило качества в исполняемый код и прогоняет его против реальных данных по расписанию или на каждом шаге конвейера. Open-source представитель этого класса, Great Expectations (GX Core), описан в официальной документации GX Core и даёт удобный пример архитектуры, устроенной вокруг понятия «утверждение о данных».
Архитектура GX Core от Data Context до Expectation
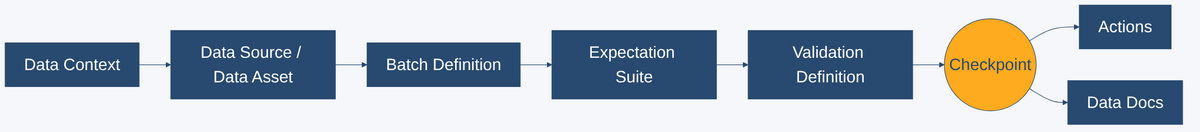
GX Core собирает проверку из нескольких понятий, каждое из которых отвечает за свой слой задачи.
- Data Context. Центральный объект, который хранит конфигурацию, подключения и результаты прошлых прогонов.
- Data Source и Data Asset. Data Source описывает конкретное хранилище, база, облако или файловая система. Data Asset выделяет внутри него объект проверки, обычно таблицу.
- Batch Definition. Правило, по которому из Data Asset берётся конкретный срез данных для прогона, вся таблица целиком или часть по фильтру.
- Expectation. Одно проверяемое утверждение о данных, аналог assertion в модульном тесте, «значения колонки не пустые» или «значения входят в заданный список».
- Expectation Suite. Набор Expectation, применяемых к одному Batch как единое целое.
В демо ниже каждый Expectation в suite закрывает одну дименсию качества по замыслу автора, а не по требованию самого GX Core, и по коду видно, какая проверка отвечает за полноту, а какая за согласованность.
Validation Definition и Checkpoint запускают проверку и формируют отчёт Data Docs
Validation Definition связывает Batch Definition с Expectation Suite, отвечая на вопрос, какие данные проверяются каким набором правил. Checkpoint это уровень выше, производственный механизм, который запускает список Validation Definition с общими параметрами и настроенными действиями. К действиям относится, например, автоматическое обновление отчёта Data Docs, человекочитаемой HTML-страницы с результатом каждого Expectation. Такое разделение позволяет держать одну и ту же связку «данные плюс правила» и переиспользовать её в разных Checkpoint с разным набором действий, для алерта в канал мониторинга или для блокировки последующего шага конвейера при провале.
Data Quality и Data Observability не одно и то же
Термины часто путают, потому что оба говорят о доверии к данным, но решают разные задачи. Качество данных это точечная проверка по заранее заданным правилам, аналог модульного теста, который либо проходит, либо нет. Наблюдаемость данных (Data Observability) это непрерывный мониторинг метрик конвейера, объёма строк, задержки доставки, схемы таблицы, с целью заметить аномалию, для которой правило заранее не писали.
| Признак | Data Quality | Data Observability |
|---|---|---|
| Что проверяет | Заданные правила по дименсиям | Метрики конвейера во времени |
| Когда срабатывает | В момент запуска проверки | Постоянно, в фоне |
| Что ловит | Известный заранее дефект | Незнакомую аномалию |
| Типичный вывод | Success или Fail по Expectation | Алерт об отклонении от нормы |
На практике обе дисциплины дополняют друг друга. Наблюдаемость сигнализирует, что с конвейером что-то не так, а проверка качества по конкретным правилам подтверждает или опровергает подозрение и указывает точную строку с дефектом.
Когда автоматизировать проверку качества, а когда не стоит
Автоматическая проверка качества окупается там, где одни и те же данные проходят через конвейер регулярно и ошибка в них дорого стоит. Аналитическая витрина, на которую смотрит руководство, слой перед обучением модели, где грязный пример портит всю выборку, и вход в биллинг, где ошибка бьёт по деньгам клиента, все три сценария оправдывают затраты на написание и поддержку Expectation Suite.
Смысла в такой автоматизации меньше там, где данные проверяются один раз и больше не используются, или где объём настолько мал, что дешевле проверить глазами. Отдельная ловушка это избыточная строгость. Suite из полусотни жёстких правил на источнике, который меняется каждую неделю, превращается в постоянный источник ложных срабатываний, и команда быстро перестаёт обращать на них внимание, а это хуже отсутствия проверки вообще. Инструменты и практики выбора между ними разбирает статья блога о процессах и инструментах обеспечения качества данных.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
14 сентября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Практика проверки качества данных в PostgreSQL с Great Expectations
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо строится на таблице orders в PostgreSQL 18.4 на 5000 строк, куда намеренно внесены дефекты по пяти дименсиям из восьми, полноте, уникальности, валидности, согласованности и своевременности: дубли идентификатора заказа, пустые обязательные поля, отрицательные суммы, некорректный формат email, разнобой регистра статуса и даты заказа в будущем. Accuracy на одной таблице без внешнего источника правды не проверить, а integrity и auditability требуют внешних ключей и истории трансформаций, которых у однотабличного демо нет. Сначала таблица создаётся и наполняется.
# PostgreSQL 18.4 (Homebrew), psycopg 3.3.4, прогнано на стенде 2026-08-30
"""
Создаёт демо-базу data_quality_demo с таблицей orders (5000 строк) и намеренными
дефектами качества данных: дубли order_id, NULL в обязательных полях, отрицательные
суммы, некорректный формат email, разнобой регистра в status, даты заказа в будущем.
Скрипт идемпотентен: базу можно удалять, повторный запуск пересоздаёт её с нуля.
"""

import random
from datetime import date, timedelta

import psycopg

DB_NAME = "data_quality_demo"
ADMIN_DSN = "dbname=postgres user=techfriends host=localhost"
DEMO_DSN = f"dbname={DB_NAME} user=techfriends host=localhost"
TOTAL_ROWS = 5000
DUPLICATE_IDS = 30
NULL_EMAIL_ROWS = 26
NULL_AMOUNT_ROWS = 26
NEGATIVE_AMOUNT_ROWS = 20
BAD_EMAIL_ROWS = 15
CASE_MISMATCH_ROWS = 40
FUTURE_DATE_ROWS = 12

STATUS_VARIANTS = {
    "paid": ["paid", "PAID", "Paid"],
    "pending": ["pending", "PENDING"],
    "cancelled": ["cancelled", "Cancelled"],
}


def ensure_database() -> None:
    # CREATE DATABASE не идёт внутри транзакции, поэтому подключение в autocommit
    with psycopg.connect(ADMIN_DSN, autocommit=True) as conn:
        exists = conn.execute(
            "select 1 from pg_database where datname = %s", (DB_NAME,)
        ).fetchone()
        if not exists:
            conn.execute(f"create database {DB_NAME}")


def build_rows() -> list[tuple]:
    random.seed(42)
    base_date = date(2026, 1, 1)
    rows = []
    for i in range(1, TOTAL_ROWS + 1):
        order_id = i
        email = f"user{i}@example.com"
        amount = round(random.uniform(10, 5000), 2)
        status_key = random.choice(list(STATUS_VARIANTS))
        status = STATUS_VARIANTS[status_key][0]
        order_date = base_date + timedelta(days=random.randint(0, 240))
        rows.append([order_id, email, amount, status, order_date])

    # дубли order_id: копируем id соседней строки, остальные поля живые
    for i in random.sample(range(TOTAL_ROWS), DUPLICATE_IDS):
        rows[i][0] = rows[(i + 1) % TOTAL_ROWS][0]

    # полнота (completeness): пропуски в обязательных полях
    for i in random.sample(range(TOTAL_ROWS), NULL_EMAIL_ROWS):
        rows[i][1] = None
    for i in random.sample(range(TOTAL_ROWS), NULL_AMOUNT_ROWS):
        rows[i][2] = None

    # валидность (validity): сумма вне допустимого диапазона
    for i in random.sample(range(TOTAL_ROWS), NEGATIVE_AMOUNT_ROWS):
        if rows[i][2] is not None:
            rows[i][2] = -abs(rows[i][2])

    # валидность (validity): email не проходит формат адреса
    for i in random.sample(range(TOTAL_ROWS), BAD_EMAIL_ROWS):
        if rows[i][1] is not None:
            rows[i][1] = "not-an-email"

    # согласованность (consistency): один и тот же статус в разном регистре
    mismatch_idx = random.sample(range(TOTAL_ROWS), CASE_MISMATCH_ROWS)
    for i in mismatch_idx:
        key = next(k for k, variants in STATUS_VARIANTS.items() if rows[i][3] == variants[0])
        rows[i][3] = random.choice(STATUS_VARIANTS[key][1:])

    # своевременность (timeliness): дата заказа в будущем относительно дня прогона
    today = date.today()
    for i in random.sample(range(TOTAL_ROWS), FUTURE_DATE_ROWS):
        rows[i][4] = today + timedelta(days=random.randint(1, 30))

    return [tuple(r) for r in rows]


def load_rows(rows: list[tuple]) -> None:
    with psycopg.connect(DEMO_DSN) as conn:
        with conn.cursor() as cur:
            cur.execute("drop table if exists orders")
            cur.execute(
                """
                create table orders (
                    order_id integer,
                    customer_email text,
                    amount numeric(10, 2),
                    status text,
                    order_date date
                )
                """
            )
            with cur.copy(
                "copy orders (order_id, customer_email, amount, status, order_date) from stdin"
            ) as copy:
                for row in rows:
                    copy.write_row(row)
        conn.commit()


if __name__ == "__main__":
    ensure_database()
    demo_rows = build_rows()
    load_rows(demo_rows)
    print(f"orders: {len(demo_rows)} строк загружено в базу {DB_NAME}")
Дальше подключаем GX Core, собираем Expectation Suite из семи проверок, по одной-две на дименсию, и запускаем Checkpoint.
# Great Expectations (GX Core) 1.11.1, PostgreSQL 18.4, прогнано на стенде 2026-08-30
"""
Проверяет таблицу orders из data_quality_demo (см. db_setup.py) через GX Core:
Data Context -> Data Source/Asset -> Batch Definition -> Expectation Suite ->
Validation Definition -> Checkpoint -> результат и Data Docs.

Каждый Expectation в suite закрывает одну дименсию качества данных — комментарий
у каждого называет её явно, чтобы связь "дименсия -> проверка в коде" была видна
напрямую, а не только в тексте статьи.
"""

import shutil
import time
from datetime import date

import great_expectations as gx
from great_expectations.checkpoint.actions import UpdateDataDocsAction
from great_expectations.expectations import (
    ExpectColumnValuesToBeBetween,
    ExpectColumnValuesToBeUnique,
    ExpectColumnValuesToBeInSet,
    ExpectColumnValuesToMatchRegex,
    ExpectColumnValuesToNotBeNull,
)

CONNECTION_STRING = "postgresql+psycopg2://techfriends@localhost:5432/data_quality_demo"
EMAIL_REGEX = r"^[^@\s]+@[^@\s]+\.[^@\s]+$"

# file-режим Data Context, а не ephemeral: только он пишет отчёт Data Docs на диск
shutil.rmtree("gx", ignore_errors=True)
context = gx.get_context(mode="file", project_root_dir=".")

data_source = context.data_sources.add_postgres(
    "orders_postgres", connection_string=CONNECTION_STRING
)
data_asset = data_source.add_table_asset(
    "orders_asset", table_name="orders", schema_name="public"
)
batch_definition = data_asset.add_batch_definition_whole_table("orders_batch")

suite = gx.ExpectationSuite(name="orders_quality_suite")

# полнота (completeness): обязательные поля не должны быть пустыми
suite.add_expectation(ExpectColumnValuesToNotBeNull(column="customer_email"))
suite.add_expectation(ExpectColumnValuesToNotBeNull(column="amount"))

# уникальность (uniqueness): order_id — первичный ключ заказа
suite.add_expectation(ExpectColumnValuesToBeUnique(column="order_id"))

# валидность (validity): формат email и допустимый диапазон суммы
suite.add_expectation(
    ExpectColumnValuesToMatchRegex(column="customer_email", regex=EMAIL_REGEX, mostly=1.0)
)
suite.add_expectation(
    ExpectColumnValuesToBeBetween(column="amount", min_value=0, max_value=5000, mostly=1.0)
)

# согласованность (consistency): статус только в каноническом написании,
# а не "PAID"/"Paid"/"paid" одновременно
suite.add_expectation(
    ExpectColumnValuesToBeInSet(
        column="status", value_set=["paid", "pending", "cancelled"], mostly=1.0
    )
)

# своевременность (timeliness): дата заказа не может быть в будущем относительно прогона
suite.add_expectation(
    ExpectColumnValuesToBeBetween(
        column="order_date", min_value="2000-01-01", max_value=date.today().isoformat()
    )
)

suite = context.suites.add(suite)

validation_definition = context.validation_definitions.add(
    gx.ValidationDefinition(name="orders_validation", data=batch_definition, suite=suite)
)

checkpoint = context.checkpoints.add(
    gx.Checkpoint(
        name="orders_checkpoint",
        validation_definitions=[validation_definition],
        actions=[UpdateDataDocsAction(name="update_data_docs")],
    )
)

t0 = time.time()
result = checkpoint.run()
elapsed = time.time() - t0

print(f"Checkpoint выполнен за {elapsed:.2f} с, общий success={result.success}")
print()

for validation_result in result.run_results.values():
    for expectation_result in validation_result.results:
        config = expectation_result["expectation_config"]
        column = config["kwargs"].get("column")
        status = "OK" if expectation_result["success"] else "FAIL"
        unexpected = expectation_result["result"].get("unexpected_count", "-")
        print(f"[{status}] {config['type']:<32} column={column:<16} unexpected={unexpected}")

print()
docs_urls = context.get_docs_sites_urls()
print(f"Data Docs: {docs_urls[0]['site_url']}")
Реальный прогон на стенде дал следующий результат.
orders: 5000 строк загружено в базу data_quality_demo
Checkpoint выполнен за 0.38 с, общий success=False

[FAIL] expect_column_values_to_not_be_null column=customer_email   unexpected=26
[FAIL] expect_column_values_to_match_regex column=customer_email   unexpected=15
[FAIL] expect_column_values_to_not_be_null column=amount           unexpected=26
[FAIL] expect_column_values_to_be_between column=amount           unexpected=20
[FAIL] expect_column_values_to_be_unique column=order_id         unexpected=60
[FAIL] expect_column_values_to_be_in_set column=status           unexpected=40
[FAIL] expect_column_values_to_be_between column=order_date       unexpected=12

Data Docs: file:///.../gx/uncommitted/data_docs/local_site/index.html
Все семь Expectation провалились ожидаемо, потому что таблица испорчена намеренно, и каждое нашло именно те дефекты, под которые оно писалось. Число 60 у проверки уникальности заметно больше, чем 30 внесённых дублей, потому что уникальность нарушает каждая строка пары, а не только вторая копия. Полный Checkpoint из семи Expectation против 5000 строк занял 0.38 секунды, то есть на таком объёме проверка не создаёт заметной задержки в конвейере.
Отдельного внимания стоят две особенности GX Core 1.11.1, которые не сразу очевидны по документации. Режим Data Context по умолчанию, EphemeralDataContext, не пишет отчёт Data Docs на диск вообще, для локального HTML-отчёта нужен режим file с явным project_root_dir. И объект результата у каждого Validation Definition, ExpectationSuiteValidationResult, отдаёт поля success и results напрямую как атрибуты, а не как вложенный словарь с ключом validation_result, как можно ожидать по части источников в вебе.
Заключение
Качество данных превращает общее ощущение «данным нельзя доверять» в конкретный список проваленных проверок по конкретным дименсиям. Классический набор из шести характеристик покрывает большинство дефектов batch-загрузок, а integrity и auditability становятся обязательными там, где решения по данным принимает автономный агент. Инструменты вроде GX Core переносят эти правила из головы дата-инженера в исполняемый код, который прогоняется на каждом изменении данных так же предсказуемо, как модульные тесты прогоняются на каждом коммите.
Референсные ссылки
- Официальная документация GX Core, архитектура и workflow валидации.
- Официальный репозиторий Great Expectations, исходный код проекта.
- Материал Dagster о дименсиях качества данных.
- Материал Atlan о дименсиях integrity и auditability.
- Официальный сайт проекта Great Expectations, общее позиционирование платформы.