
ClickHouse исправил причину лишней задержки в 32 мс на простых SELECT-запросах через Native-протокол. После простоя соединения больше двух секунд окно перегрузки TCP сбрасывалось, а несколько мелких пакетов метаданных не помещались в него сразу. Это вызывало дополнительный круг о
Статья на Habr сравнивает практические варианты мониторинга и логирования корпоративного хранилища. Авторы показывают, как инструменты закрывают конкретные уровни контроля - от состояния серверов до качества данных и влияния сбоев на downstream. Разбор помогает инженерам понять,
Разработчики распределённых аналитических баз часто сталкиваются с ситуацией, когда тяжёлый запрос внезапно зависает. План EXPLAIN показывает структуру, но не даёт ответа, на каком этапе сейчас находится выполнение и что именно тормозит: перекос данных, spill на диск или ожидание
В корпоративных хранилищах данных сбой может возникнуть на любом участке конвейера: при выгрузке из источников, во время трансформаций или на уровне СУБД. Техническая доступность кластера ещё не означает, что данные приходят вовремя и в полном объёме. Observability позволяет соби
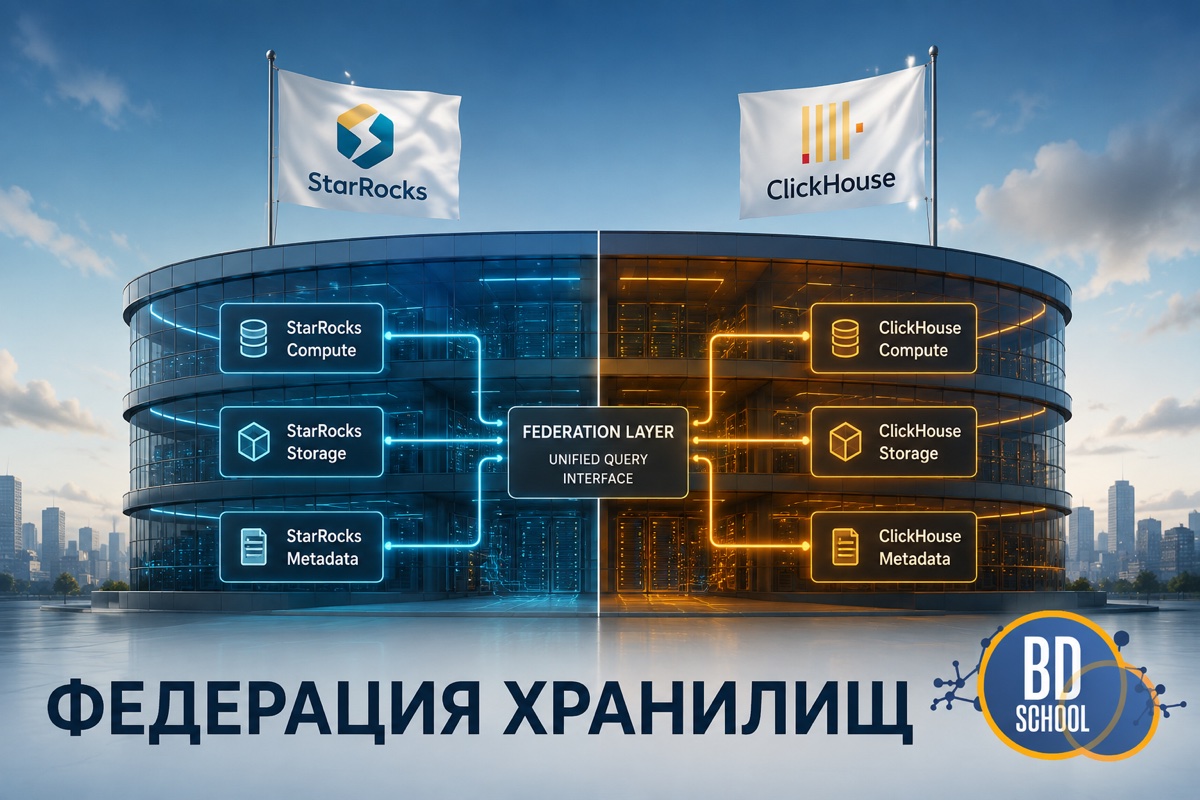
Выбор между StarRocks и ClickHouse часто ставят как или-или. Но зрелый ландшафт данных строят иначе: две базы не конкурируют, а дополняют друг друга. ClickHouse отлично держит холодные петабайты логов и событий, а StarRocks выступает вычислительным слоем для сложных ad-hoc запросов BI. Связать их позволяет федерация данных. В этой статье...
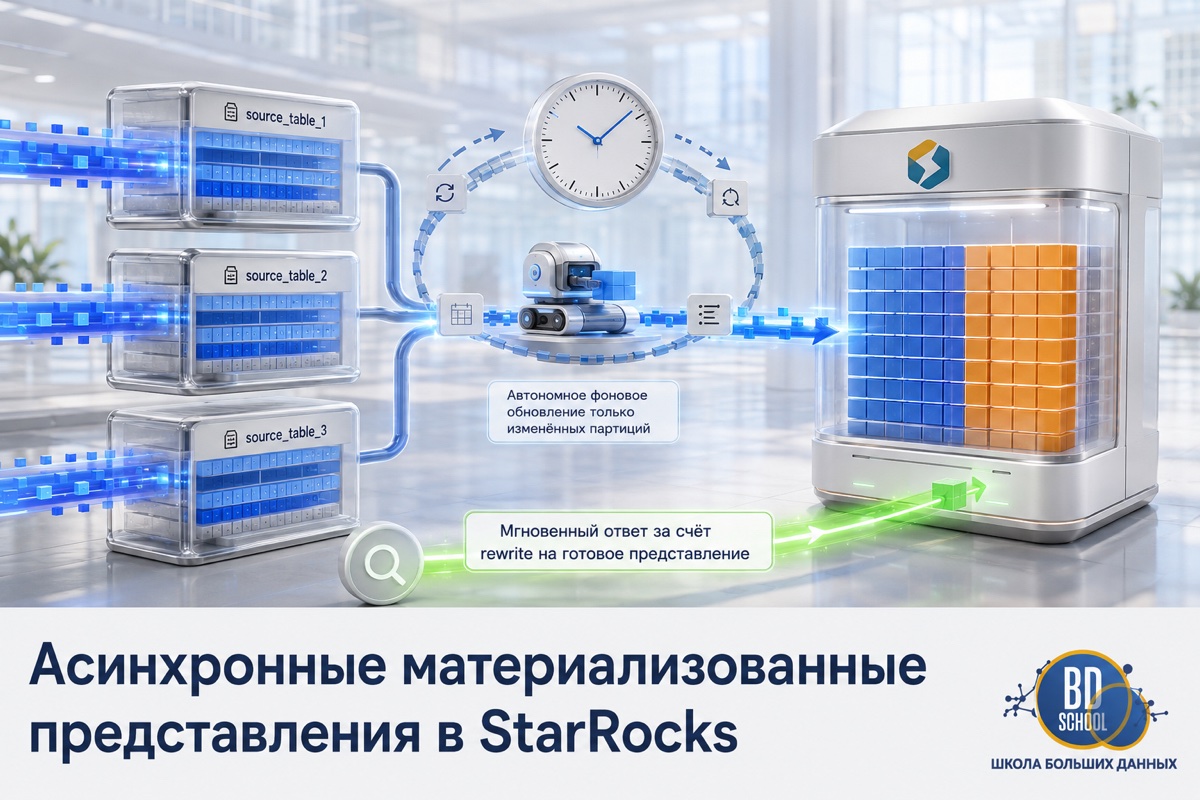
Типичное хранилище со временем обрастает зоопарком витрин. Десятки скриптов на cron пересчитывают агрегаты, гоняют одни и те же джойны по кругу и жгут процессорное время. Часть этой работы можно убрать внутрь самой СУБД. В StarRocks для этого есть асинхронные материализованные представления, которые обновляются по расписанию и инкрементально, по одной партиции....
Аналитика реального времени начинается с того, что данные попадают в хранилище с минимальной задержкой после появления в источнике. Для StarRocks таким мостом из Apache Kafka служит Routine Load, встроенный механизм непрерывной загрузки потока прямо в таблицу. В этой статье соберем рабочий пайплайн: продюсер шлет JSON-события заказов в Kafka, а StarRocks...
Наша школа проводит открытый вебинар по теме: "On‑line аналитика: как строить хранилище, которое пишет и считает одновременно" . Узнайте, как объединить потоковую загрузку и быстрые аналитические запросы без компромиссов, какие технологии реально работают в production и как строится потоковая архитектура (CDC → Kafka → Flink → StarRocks → BI). Приглашаем...
Инженеры данных часто спорят, какая колоночная СУБД быстрее. Спор бессмысленный без контекста нагрузки. ClickHouse и StarRocks решают разные задачи, хотя обе относятся к классу аналитических OLAP-движков. В этой статье мы разберем их архитектуру, покажем разницу в обработке соединений таблиц и соберем локальный стенд для честного нагрузочного теста на нормализованной...
До этого момента все наши DAG-и жили по расписанию. schedule_interval='@daily' - это классика. Но современный бизнес не хочет ждать "утреннего отчета". Если данные прилетели в 14:00, отчет должен быть готов в 14:10, а не на следующее утро. Здесь мы сталкиваемся с фундаментальным конфликтом: Airflow - это Batch-инструмент (запускает задачи...
В прошлой статье мы научили Airflow работать со структурированными данными в Postgres. Но в мире Big Data базы данных - это лишь верхушка айсберга. Основная масса данных (логи, картинки, JSON-выгрузки, бэкапы) хранится в виде файлов. Хранить эти файлы на локальном диске сервера, где крутится Airflow - плохая идея. Диск не...
Оркестратор сам по себе бесполезен. Apache Airflow - это дирижер, а не музыкант. Его задача - не хранить данные и не (всегда) обрабатывать их, а говорить другим системам, что делать. "Postgres, выполни этот запрос", "Spark, посчитай эту витрину", "S3, отдай файл". Но чтобы сказать "Postgres, выполни запрос", Airflow должен...
В предыдущих статьях мы узнали, что семейство движков MergeTree — это основа для хранения аналитических данных в ClickHouse. Мы создавали таблицы с помощью базового MergeTree и даже упоминали о его специализированных версиях. Теперь пришло время для глубокого погружения. Эти движки — не просто вариации, а мощные инструменты, которые выполняют часть...
Добро пожаловать в четвертую статью нашего курса по ClickHouse! В прошлый раз мы научились основам: вставлять, выбирать и агрегировать данные. Теперь, когда вы можете получать базовую статистику, пришло время углубить свои навыки и научиться "разговаривать" с данными на более сложном языке. Сегодня мы изучим мощные инструменты, которые позволят вам преобразовывать,...
Приветствуем вас в третьей части нашего гида по ClickHouse! В предыдущих статьях мы заложили прочный фундамент: разобрались, что такое ClickHouse (далее CH), почему он так хорош для аналитики, а также глубоко погрузились в типы данных и движки таблиц, научившись создавать оптимизированные таблицы. Теперь пришло время перейти от теории к самой...
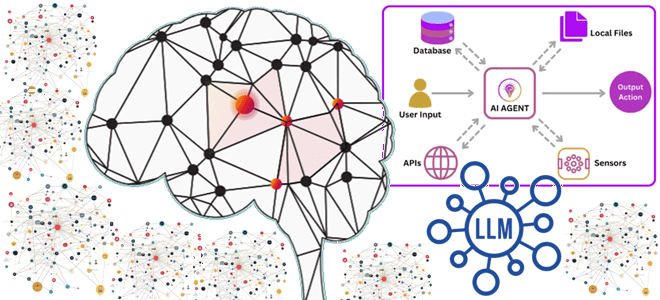
Что не так с векторным RAG: обогащение LLM данными из графовых баз с помощью MCP-протокола, вычислительных движков и коннекторов для построения ML-системы агентского ИИ. Что такое графовый RAG для LLM и ИИ-агентов Большие языковые модели (LLM, Large Language Model) и основанные на них системы агентского ИИ активно используют векторные базы...
Вместо Trino и ClickHouse: что такое StarRocks и как оно устроено, архитектура и принципы работы, сценарии использования и место в корпоративной архитектуре данных. Архитектура и принципы работы StarRocks Хотя ClickHouse сегодня считается одним из наиболее популярных колоночных хранилищ для аналитики больших объемов данных в реальном времени, это не единственный представитель...
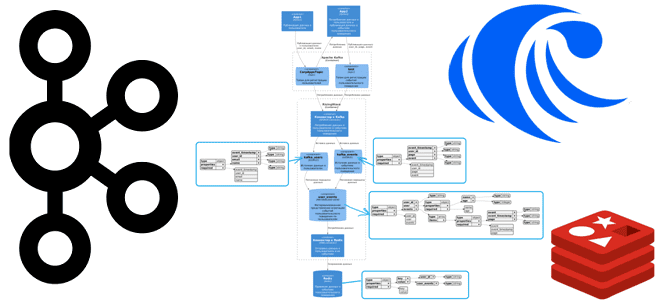
Как SQL-запросами соединить потоки из разных топиков Apache Kafka и отправить результаты в Redis: демонстрация ETL-конвейера на материализованных представлениях в RisingWave. Постановка задачи и проектирование потоковой системы Продолжая недавний пример потоковой агрегации данных из разных топиков Kafka с помощью SQL-запросов, сегодня расширим потоковый конвейер в RisingWave, добавив приемник данных –...
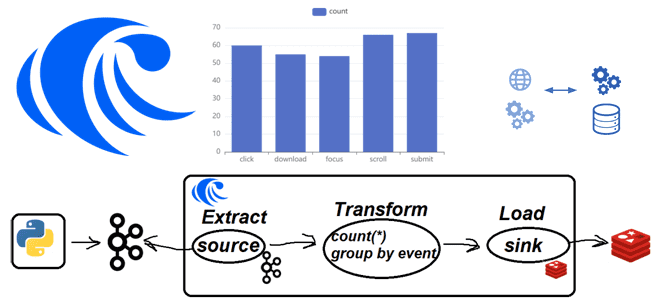
Практическая демонстрация потоковой агрегации событий пользовательского поведений из Apache Kafka с записью результатов в Redis на платформе RisingWave: примеры Python-кода и конвейера из SQL-инструкций. Постановка задачи Одной из ярких тенденций в современном стеке Big Data сегодня стали платформы данных, которые позволяют интегрировать разные системы между собой, поддерживая как пакетную, так...
Практическая демонстрация потокового SQL-конвейера, который преобразует данные, потребленные из Apache Kafka, и записывает результаты в Elasticsearch, используя Debezium-коннекторы и задания Apache Flink в облачной платформе Decodable. Потребление сообщений из Apache Kafka Я уже показывала пример интеграции Apache Kafka и Elasticsearch с помощью sink-коннектора, а также конвейер с ClickHouse Cloud. Сегодня...