
Сегодня поговорим про бакетирование таблиц в Apache Spark для оптимизации производительности заданий и снижения затрат на кластер при их выполнении. Читайте далее, что такое Bucketing в Spark SQL и как это предотвращает операции перетасовки в приложениях аналитики больших данных. Что такое Bucketing и зачем это нужно в Big Data Бакетирование...
Недавно мы уже рассказывали про ускорение целых аналитических конвейеров на Apache Spark и отдельных задач, а также рассматривали способы оптимизации Shuffle-операций в SQL-модуле этого Big Data фреймворка. Сегодня разберем, какие факторы провоцируют задержки в Spark-приложениях, и как дата-инженер может их найти, чтобы устранить причины и следствия этих проблем. Задержки Spark-приложений...
Хорошие курсы инженеров данных – это не просто обучение отдельной Big Data технологии, такой как Apache Hadoop, Spark или Kafka, а жизненные примеры их практического использования в реальном бизнесе. Поэтому сегодня мы приготовили для вас кейс оптимизации стоимости и скорости OLAP-аналитики больших данных в облачном Delta Lake на Amazon Web...
В этой статье рассмотрим, как сделать SQL-запросы к колоночному хранилищу больших данных с поддержкой ACID-транзакций Delta Lake еще быстрее с помощью Apache Presto. Читайте далее про синергию совместного использования Apache Spark и Presto в Delta Lake для ускорения OLAP-процессов при работе с Big Data. Еще раз об OLAP: схема звезды...
Продвигая наши курсы для разработчиков Spark с примерами реальных систем аналитики больших данных, сегодня рассмотрим библиотеку для чтения файлов формата DICOM от индийской компании Abzooba. Читайте далее, как автоматизировать поиск по миллиардам медицинских изображений с помощью машинного обучения и технологий Big Data: Apache Spark, Hadoop, Kafka, Elasticsearch и Kibana. Что...
Поскольку курсы инженеров Big Data предполагают практическое обучение на реальных кейсах, сегодня поговорим про тестирование конвейеров обработки и аналитики больших данных и разберем несколько прикладных примеров для компонентов экосистемы Apache Hadoop. Читайте далее про проверку работоспособности, а также поиск ошибок в Spark-заданиях и DAG-цепочках Airflow. Конвейер для конвейера: сложности тестирования...
Чтобы показать, насколько разной бывает аналитика больших данных, сегодня рассмотрим кейс международной компании Spidertracks, которая с помощью технологий Big Data создает ИТ-решения для отслеживания, связи и управления безопасностью воздушных судов. Читайте далее, почему для потоковой обработки событий был выбран Kinesis Analytics for SQL, а не конвейер из Apache Kafka и...
Сегодня продолжим разбираться с реализацией CDC-подхода в современных Big Data решениях и погрузимся в Databricks Delta Lake – облачный уровень хранения и аналитики больших данных с поддержкой ACID-транзакций. Читайте далее про переход от ночных ETL-пакетов с Informatica к быстрому обновлению данных в Amazon S3 на конвейере Spark и Kafka. Возможности...
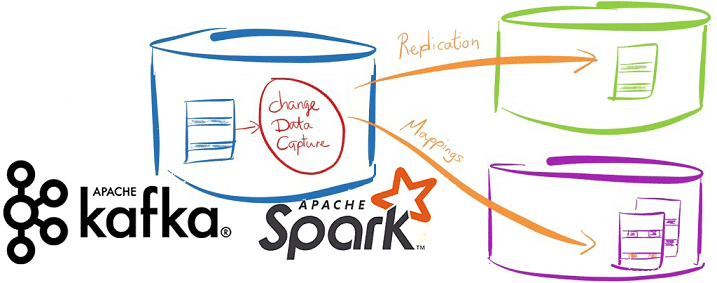
Вчера мы упоминали про CDC-подход в проектировании транзакционных систем аналитики больших данных на базе Apache Kafka и Spark Streaming. Сегодня рассмотрим подробнее примеры такого применения технологий Big Data и лучшие практики Change Data Capture в потоковой обработке финансовых и других транзакций. Зачем нужны потоковые конвейеры транзакционной обработки Big Data на...
В этой статье рассмотрим особенности совместного использования Apache Kafka и Spark Streaming для обработки финансовых транзакций в режиме онлайн. Читайте далее про типовые кейсы практического применения конвейера аналитики больших данных на базе Kafka и Spark, а также проблемы или технологические особенности такой Big Data системы и пути обхода этих ограничений....
Продолжая разговор про оптимизацию Apache Spark и повышение эффективности Big Data приложений, сегодня рассмотрим способы ускорения Shuffle-операций в Spark SQL, разберем, чем хороши широковещательные JOIN-операции и как количество разделов влияет на производительность запросов в распределенных приложениях аналитики больших данных. 4 способа оптимизации Shuffle-операций При аналитике больших данных с помощью Apache...
Недавно мы рассматривали, как повысить производительность конвейеров Apache Spark и повысить скорость распределенных приложений для аналитики больших данных. Сегодня разберемся, почему тормозят отдельные Spark-задачи и как их ускорить. Читайте далее про инициализацию Спарк-контекста, предзагрузку артефактов и применение клиентского режима. Почему некоторые задачи в быстром Apache Spark выполняются так медленно Напомним,...
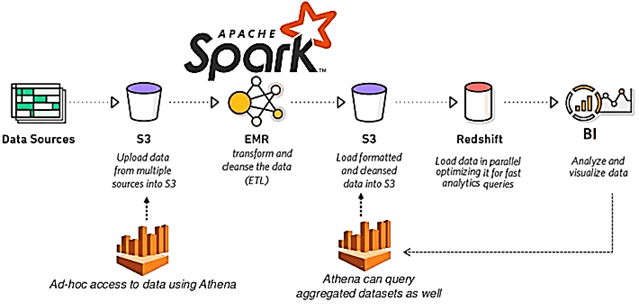
Мы уже рассказывали, почему качество данных является важнейшим аспектом разработки и эксплуатации Big Data систем. Приемлемое для эффективного использования качество массивов информации достигается не только с помощью процессов подготовки датасета к машинному обучению и профилирования данных, но и за счет их согласования. Читайте далее, что такое Data reconciliation, зачем это...
Вчера мы говорили про ускорение аналитики больших данных в конвейере из множества заданий Apache Spark. Продолжая речь про обучение инженеров данных, сегодня рассмотрим, как снизить стоимость выполнения Spark-приложений, сократив накладные расходы на обработку Big Data и повысив эффективность использования кластерной инфраструктуры. Экономика Big Data систем: распределенная разработка и операционные затраты...
Сегодня рассмотрим несколько простых способов ускорить обработку больших данных в рамках конвейера задач Apache Spark. Читайте далее про важность тщательной оценки входных и выходных данных, рандомизацию рабочей нагрузки Big Data кластера и замену JOIN-операций оконными функциями. Оптимизируй это: почему конвейеры аналитической обработки больших данных с Apache Spark замедляются Обычно со...
Недавно мы уже рассматривали выполнение Join-операций в Apache Spark SQL. Сегодня поговорим про особенности потокового соединения в модуле Structured Streaming этого популярного фреймворка аналитики больших данных. Читайте далее, в чем специфика внешних и внутренних соединений потоков Big Data в Apache Spark Structured Streaming, а также как и зачем Inner/Outer Join...
Совместное использование Apache Kafka и Spark очень часто встречается в потоковой аналитике больших данных, например, в прогнозировании пользовательского поведения, о чем мы рассказывали вчера. Однако, временные метки (timestamp) в приложении Spark Structured Streaming могут отличаться от времени события в топике Kafka. Читайте далее, почему это случается и какие подходы к...
В продолжение разговора о применении технологий Big Data и Machine Learning в рекламе и маркетинге, сегодня рассмотрим архитектуру системы прогнозирования конверсии рекламных объявлений. Читайте далее, как организовать предиктивную аналитику больших данных на Apache Kafka и компонентах ELK-стека (Elasticsearch, Logstash, Kibana), почему так важно тщательно подготовить данные к машинному обучению, какие...
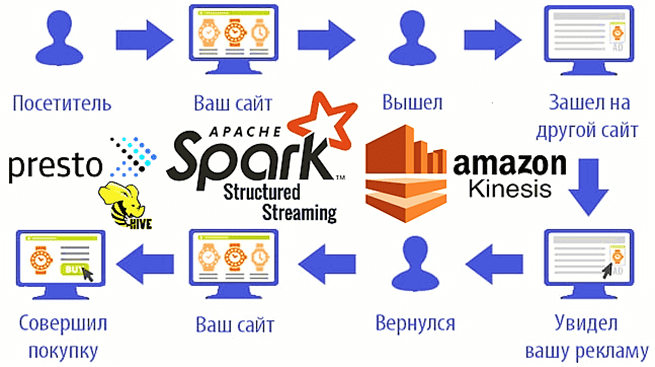
Мы уже рассказывали о возможностях ретаргетинга и использовании Apache Spark Structured Streaming для реализации этого рекламного подхода на примере Outbrain. Такое применение технологий Big Data сегодня считается довольно распространенным. Чтобы понять, как это работает на практике, рассмотрим кейс маркетинговой ИТ-компании MIQ, которая запускает Spark-приложения на платформе Qubole и сервисах Amazon,...
Продолжая разговор про фиксацию заданий Apache Spark при работе с облачными хранилищами больших данных, сегодня подробнее рассмотрим, насколько эффективны commit-протоколы экосистемы Hadoop, предоставляемые по умолчанию, и почему известный разработчик Big Data решений, компания Databricks, разработала собственный алгоритм. Читайте далее про сравнение протоколов фиксации заданий в Spark-приложениях: результаты оценки производительности и...