
Свершилось. 19 апреля вышел долгожданный релиз Apache Kafka за номером 2.8.0 в котором вы наконец можете начать избавляться от использования Apache Zookeeper кластера ( см. подробности в KIP-500 и нашей статье от 30 января Зачем Apache Kafka и другие Big Data системы используют Zookeeper и чем его заменить ) Приглашаем...
Дополняя наши курсы по Apache Kafka практическими примерами, сегодня рассмотрим, как загрузить в топик данные из ответа REST API или HTTP-запроса. Читайте далее, что такое cURL и какие команды нужно отправить через эту утилиту, чтобы записать в Kafka сообщения из JSON-файла. REST API, HTTP и сURL Импорт данных из REST...
Сегодня рассмотрим преимущества потоковой обработки данных с Apache Kafka и Flink над пакетными Big Data технологиями в виде Hadoop, Spark и Oozie. В качестве примера разберем реальный кейс аналитики больших данных по пользовательским сеансам в музыкальном онлайн-сервисе Spotify, а также возможность замены Apache Flink на Spark Structured Streaming. От рекламы...
Однажды мы уже разбирали, способна ли Apache Kafka заменить собой базы данных в мире Big Data. Сегодня рассмотрим обратную постановку этой задачи: можно ли реализовать постоянный обмен сообщениями в стиле Kafka с помощью СУБД. Читайте далее, что общего у Kafka с базой данных, чем они отличаются и почему попытки заменить...
В этой статье поговорим про практическое обучение Apache Kafka и рассмотрим, как сделать продюсеров еще более отказоустойчивыми, чтобы улучшить общую надежность всей Big Data системы. Читайте далее про наиболее важные конфигурации продюсеров Kafka и эффективные рекомендации по их настройке. 10 самых важных параметров продюсера Apache Kafka Из множества конфигурационных параметров...
В рамках обучения дата-инженеров, сегодня рассмотрим проблему роста числа операций ввода-вывода в секунду (IOPS) при обработке большого количества данных в потоках Apache NiFi и способы ее решения. Читайте далее, как перемещение репозиториев NiFi с жесткого диска в оперативную память снижает IOPS, а также зачем при этом в Big Data систему...
Обновляя наши курсы для администраторов Apache Kafka, в этой статье разберем полезные средства, которые помогут вам следить за состоянием кластера, чтобы вовремя заметить существующие и предупредить возможные проблемы. Читайте далее, как отследить снижение производительности всей Big Data системы и сбои на отдельных брокерах с помощью дэшбордов в различных инструментах администрирования....
Продолжая вчерашний разговор про потоковую аналитику больших данных на Apache Kafka и Pinot, сегодня рассмотрим особенности интеграции этих систем. Читайте далее, как входные данные Kafka разделяются, реплицируются и индексируются в Pinot, каким образом выполняется обработка данных через распределенные SQL-запросы. Также разберем, почему управление памятью серверов Pinot, потребляющих данные из Kafka,...
В этой статье разберем несколько популярных сценариев потоковой аналитики больших данных на Kafka, CDC-платформе Debezium и быстром OLAP-хранилище Apache Pinot. Читайте далее, почему все эти Big Data технологии отлично подходят для консолидации и интеграции данных из разных источников в реальном времени, включая аналитический аудит изменений, отслеживание событий в распределенном домене...
Вчера мы упоминали, как долгожданный KIP-500, реализованный в марте 2021 года, позволяет не только отказаться от Zookeeper в кластере Apache Kafka, но и снимает ограничение числа разделов, чтобы масштабировать брокеры практически до бесконечности. Однако, не все так просто: читайте далее, какие важные функции еще не поддерживаются в этом экспериментальном режиме...
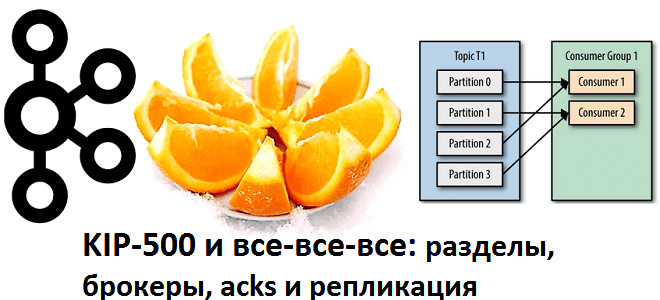
Сегодня рассмотрим важную практическую задачу из курсов Kafka для разработчиков и администраторов кластера – разделение топиков по брокерам. Читайте далее, как пропускная способность всей Big Data системы зависит от числа разделов, коэффициента репликации и ответного ack-параметра, а также при чем здесь KIP-500, позволяющий отказаться от Zookeeper. Что такое партиционирование в...
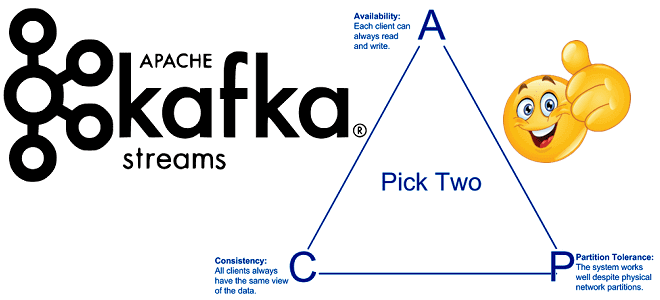
Продолжая включать интересные практические примеры в наши курсы Apache Kafka для разработчиков, сегодня поговорим о согласованности в распределенных системах с высокой доступностью. Читайте далее, что такое eventual consistency, почему это важно для микросервисной архитектуры, при чем здесь ограничения CAP-теоремы и как решить проблемы обеспечения конечной согласованности с Kafka Streams. ...
Чтобы сделать наши курсы по Apache Kafka еще более полезными, сегодня мы поговорим про базовые и расширенные возможности обеспечения информационной безопасности этой Big Data платформы. А в качестве практического примера разберем кейс международной финтех-компании BlackRock, которая разработала собственное security-решение для Kafka на базе протокола OAuth и серверов единого доступа KeyCloak....
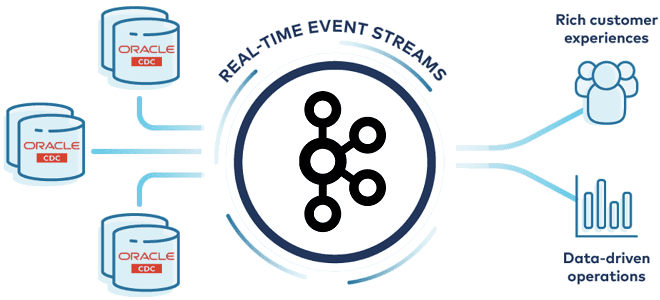
В феврале 2021 года разработчики корпоративной версии Apache Kafka с коммерческой поддержкой, компания Confluent, выпустили премиум-коннектор к Oracle – одной из главных реляционных баз данных мира enterprise. Разбираемся, кому и зачем это нужно, а также как устроена такая интеграция SQL-СУБД и потоковой аналитики Big Data с применением CDC-подхода. Реляционный монолит...
Постоянно добавляя в наши курсы Apache Kafka для разработчиков интересные и практические примеры, сегодня мы разберем кейс тревел-площадки Trainline, которая агрегирует данные от 270 железнодорожных и автобусных компаний в 45 странах, предлагая выгодные билеты на европейские поезда и автобусы. Читайте далее, почему пакетный режим работы озера данных перестал отвечать требованиям...
Сегодня рассмотрим пример построения системы аналитики больших данных для мониторинга финансовых транзакций в реальном времени на базе облачного Delta Lake и конвейера распределенных приложений Apache Kafka, Spark Structured Streaming и других технологий Big Data. Читайте далее о преимуществах облачного Delta Lake от Databricks над традиционным Data Lake. Постановка задачи: финансовая...
В этой статье рассмотрим типичные проблемы топиков Apache Kafka, с которыми сталкивается каждый администратор Big Data кластера. Читайте далее, почему топики чрезмерно разрастаются, как работает очистка логов, когда старые сообщения могут остаться в почищенных сегментах и какие параметры конфигураций помогут справиться со всем этим. Брокеры и разделы: как устроены топики...
Чтобы дополнить наши курсы по Spark для разработчиков распределенных приложений и инженеров данных практическими примерами, сегодня рассмотрим кейс американской ИТ-компании ThousandEyes, которая разрабатывает программное обеспечение для анализа производительности локальных и глобальных сетей. Читайте далее, как создать надежный конвейер и устойчивое озеро данных (Data Lake) для быстрой аналитики Big Data в...
Спустя пару месяцев с выпуска Apache Kafka 2.7.0, Confluent анонсировал новый релиз этой платформы потоковой передачи событий, в котором, наконец, случится долгожданный отказ от Zookeeper. Читайте далее, как это облегчит жизнь администратору Kafka-кластера и разработчику распределенных приложений потоковой аналитики больших данных, а также как подготовить свою Big Data инфраструктуру к...
В конце декабря 2020 года вышел новый релиз Apache Kafka – главной Big Data технологии для потоковой передачи событий, интеграции распределенных систем и аналитики больших данных. Читайте далее о новых функциональных возможностях и исправленных ошибках в свежей версии 2.7.0: еще один шаг к отказу от Zookeeper, генерация уведомительных исключений и улучшения...