Какие инфраструктурные компоненты самые дорогие в эксплуатации популярной платформы потоковой передачи сообщений и как снизить затраты на сетевые ресурсы и хранилища данных при использовании Apache Kafka. TCO для Apache Kafka: что учитывать в расчете затрат Поскольку Apache Kafka используется для интеграции информационных систем в режиме реального времени, она становится критически...
Школа Больших Данных продолжает серию митапов по Apache Spark. Митап состоится 14 февраля 2024 года в 17:00 МСК. Мероприятие рассчитано на инженеров данных, разработчиков и просто интересующихся. Будучи мощным фреймворком разработки распределенных приложений, Apache Spark позволяет писать код на нескольких языках программирования: Scala, Java, R, Python. Сам фреймворк написан на...
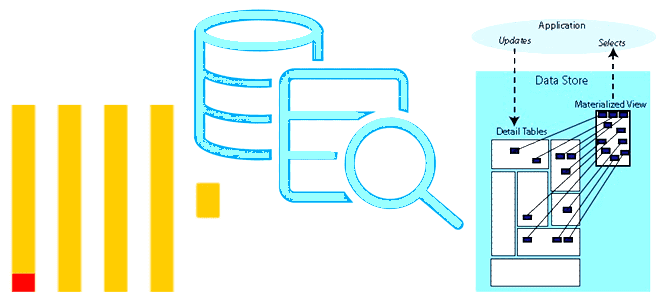
Чем материализованное представление в ClickHouse отличается от обычного, зачем нужны LIVE-представления и как их использовать. Примеры SQL-запросов с VIEW для самой популярной колоночной аналитической СУБД. Представления vs словари в ClickHouse Поскольку ClickHouse, как типовая колоночная СУБД, используется для аналитической обработки огромных объемов данных в реальном времени, вопрос ускорения вычислений для...
Коллеги, в конце 2023 годы мы запустили новую услугу - консалтинг для проектов Big Data. Теперь вы можете быстро воспользоваться опытом и знаниями наших экспертов, не расширяя штат своей компании. Наши преподаватели помогут вам в решении следующих задач: анализ возможностей улучшения вашего бизнеса, процессов и систем с помощью технологий Big...
Продолжая разговор про рассмотренные в прошлой статье принципы взаимодействия процессов Python с Java, на которой написан Apache NiFi, сегодня разберем, как использовать это на практике. Пишем свои процессоры, используя классы FlowFileTransform и RecordTransform. Python-процессор Apache NiFi на базе FlowFileTransform Хотя Apache NiFi предоставляет более 300 процессоров для вычислительных операций и...
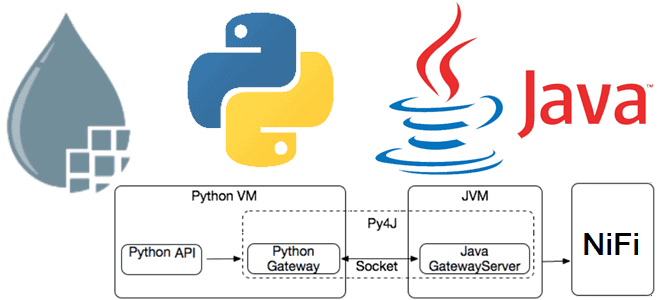
Недавно мы писали про Nifi-Python-Api —клиентский SDK, поддерживающий Python для работы с Apache NiFi. Сегодня на примере разработки процессоров более подробно разберем принципы взаимодействия процессов Python с Java, на которой написан Apache NiFi. Принципы работы Python-кода в Java-среде Apache NiFi Поскольку Apache NiFi написан на Java, именно этот язык предпочтителен...
Большинство ETL-конвейеров извлекают данные из реляционных баз в пакетном или микропакетном режиме. Читайте далее, по каким шаблонам реализовать операции извлечения. Моментальные снимки: периодическая выгрузка данных из исходных таблиц Полная периодическая выгрузка данных из одной или нескольких таблиц – это, пожалуй, самый простой метод извлечения изменяемых данных. По своей сути результат полной...
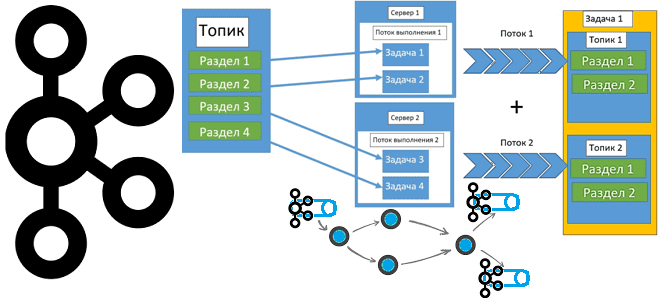
Почему нельзя просто взять и соединить потоки Kafka Streams с разным числом разделов, и как это все-таки сделать без изменения конфигурации топика. Почему нельзя просто взять и соединить потоки Kafka Streams с разным числом разделов Kafka Streams – это клиентская Java-библиотека для разработки потоковых приложений, которые работают с данными, хранящимися...
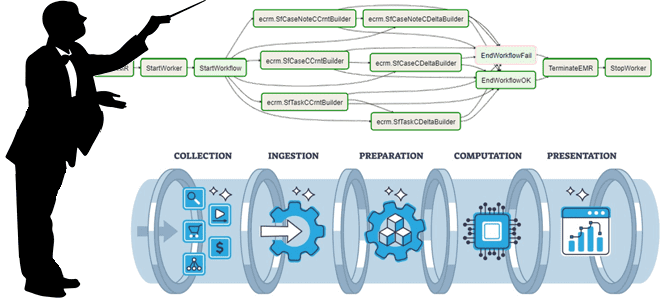
Как организовать упрощенное и продвинутое управление зависимостями между разными ETL-конвейерами, когда нужна централизованная оркестрация рабочих процессов и чем хороша стандартизация активов данных, отчетов и вычислительных процедур. Лучшие практики проектирования конвейеров для дата-инженера. Проектирование дата-конвейеров с минимальными зависимостями Для многих компаний, выстроивших процессы обработки данных в виде конвейеров, актуальна проблема управления...
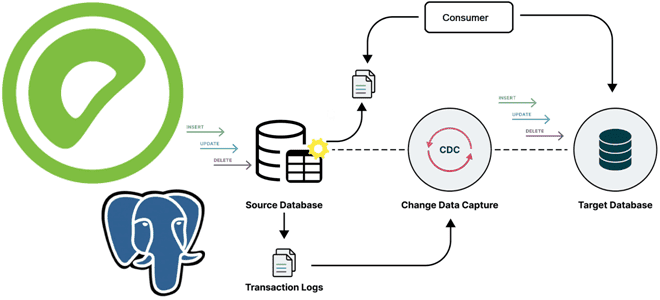
Методы отслеживания изменений в реляционных базах данных: столбцы аудиты, триггеры DDL-событий и WAL-журналы. Плюсы и минусы этих подходов, а также примеры реализации в Greenplum и PostgreSQL. 3 подхода к извлечению данных из реляционных баз Извлечение данных из реляционных баз является наиболее распространенной операцией в ETL-процессах. Поэтому при проектировании конвейеров обработки...
Вот и закончился очередной год. Спасибо нашим дорогим слушателям, партнерам и коллегам за активное сотрудничество! Мы очень рады работать с вами и будем стараться для вас все следующие 12 месяцев. Желаем всем нашим слушателям, коллегам и партнерам энергии, процветания и профессионального развития в новом 2024 году! К 1 января 2024...
В конце декабря принято строить планы на следующие 12 месяцев. Посмотрим, что разработчики Apache Flink обещают реализовать в релизе 2.0, который должен выйти к концу 2024 года. Внедрение многоуровневой системы хранения состояний В Apache Flink 2.0 будет улучшена система управления хранилищем состояния путем перехода к полностью разделенной архитектуре хранения и...
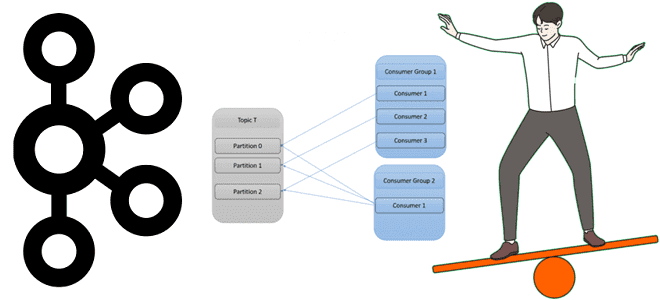
Чем group.instance.id отличается от group.id, зачем нужен member.id, каковы преимущества статического членства в группе потребителей перед динамическим и какие механизмы Kafka обеспечивают ребалансировку клиентских приложений. Еще раз про группы потребителей Apache Kafka Напомним, группы потребителей в Apache Kafka нужны для логического объединения нескольких потребителей с целью повышения надежности потоковой системы....
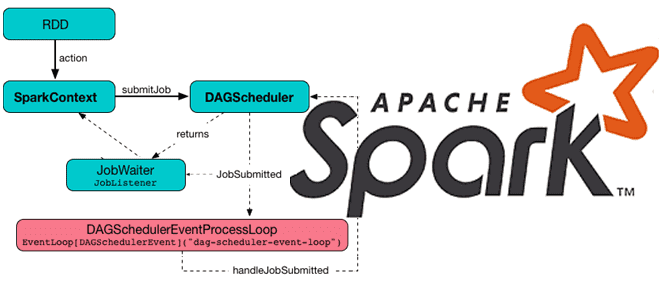
Какие механизмы и компоненты позволяют Apache Spark планировать задания и эффективно утилизировать ресурсы кластера. Чем статическое разделение ресурсов отличается от динамического, и как настроить планировщик для ускорения вычислений. Планирование заданий в Apache Spark Распределенный характер Apache Spark предполагает наличие инструментов для разделения ресурсов между вычислениями. В режиме кластера каждое приложение...
14 декабря 2023 года вышел очередной релиз Apache AirFlow, который содержит более 20 новых фичей, 60 улучшений и 50 исправлений. Знакомимся с самыми главными для дата-инженера новинками выпуска 2.8. ТОП-10 новинок Apache AirFlow 2.8 Многие обновления в версии 2.8 направлены на расширение возможностей создания DAG, улучшение ведения журналов и исправление...
Сегодня познакомимся с возможностями и ограничениями open-source проект Diskquota, направленного на оптимизацию управления дисковым пространством базы данных Greenplum. Зачем ограничивать использование диска в Greenplum и как это сделать Эффективная утилизация аппаратных ресурсов, в т.ч. жесткого диска – один из факторов, позволяющих ускорить работу любой СУБД, в т.ч. Greenplum. Будучи популярным...
Анализ временных рядов нужен не только в Data Science, но и в мониторинге системных событий. Чем столбец с отметками времени в ClickHouse отличается от гипертаблиц в PostgreSQL и Greenplum c расширением TimescaleDB, и что выбирать для аналитики больших данных. ClickHouse для анализа временных рядов ClickHouse является колоночной СУБД для аналитической...
Что лучше: один или несколько кластеров Apache Kafka, когда и зачем разворачивать новый кластер вместо масштабирования существующего, какие задачи администрирования поручить локальным DevOps-инженерам, а что решать централизовано. Один или несколько кластеров Apache Kafka? Продолжая разговор про эффективное управление корпоративным кластером Apache Kafka, сегодня рассмотрим, когда и зачем нужно разворачивать новый...
Сегодня разберем, как повысить эффективность использования объектов XCom в Apache AirFlow и сделать свои конвейеры обработки данных еще более гибкими с помощью настройки триггерных правил. Возможности TaskFlow API для XCom Объекты XCom позволяют задачам DAG в Apache AirFlow обмениваться данными. Это очень удобно для реализации конвейера с атомарными задачами, которые...
Зачем размещать задания Apache Spark на узлах HDFS, какую пропускную способность сети передачи данных выбрать, почему не рекомендуется использовать RAID для жестких дисков, сколько выделить памяти и ядер ЦП. Рекомендации по настройке оборудования для Spark-приложений На практике большинство заданий Spark считывает входные данные из внешней системы хранения, например, файловой системы...