Как устроен планировщик заданий Apache AirFlow, от чего зависит его производительность и какие конфигурации помогут ее улучшить: настройки, приемы, рекомендуемые значения и лучшие практики. Как работает планировщик Apache AirFlow Apache AirFlow как фреймворк оркестрации пакетных процессов включает несколько компонентов. Одним из них является планировщик (scheduler), который отслеживает все задачи и...
Аналитика данных из топиков Kafka с помощью SQL-запросов: обращение к ksqlDB в Docker через CLI-интерфейс и REST API в Postman с SSH-тунелированием сервера потоковой базы данных. Практическое руководство с примерами и иллюстрациями. CLI-интерфейс ksqldb Docker-образ Confluent Kafka включает дополнительные компоненты этой платформы: ksqlDB, Kafka Connect, REST Proxy, Schema Registry). Сегодня...
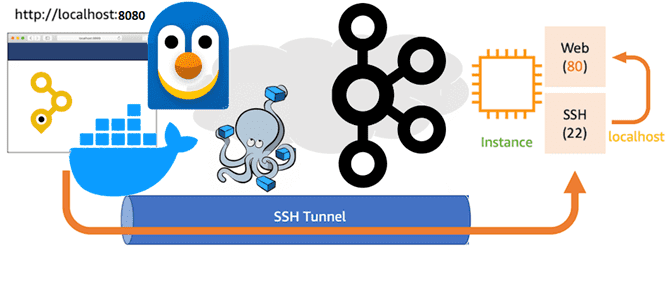
Как туннелировать порты Docker-контейнеров для доступа к Kafka на WSL в Windows с внешнего клиента: переадресация HTTP- и TCP-соединений с помощью SSH-сервера serveo. Поиск средства тунелирования и настройка портов Собственное развертывание платформы Kafka от Confluent в виде набора связанных Docker-контейнеров в WSL на Windows с GUI-интерфейсом AKHQ, о чем я...
Как настроить YAML-файл Docker Compose для доступа к Kafka на WSL в Windows: открытие портов в конфигурации развертывания с примерами (продолжение). Настройка конфигурационного YAML-файла для запуска Docker-контейнеров с компонентами Kafka на Windows в WSL Как я рассказывала вчера, для работы с компонентами платформы Kafka от Confluent, развернутой как набор связанных...
WSL и Docker для локального развертывания Apache Kafka с GUI и всеми компонентами в контейнере: моя реальная история поиска веб-интерфейса и настройки портов (начало). Развертывание Kafka на Windows с Docker в WSL В конце августа 2024 года команда serverless-платформы Upstash, на которой у меня есть рабочий инстанс Apache Kafka, разослала...
Зачем нужна автоматическая очистка таблиц системного каталога Greenplum, почему команда AUTOVACUUM выполняется локально на каждом сегменте и как ее настроить для максимальной эффективности старых кортежей в распределенной базе данных с массовой-параллельной обработкой. Параметры автоматической очистки в Greenplum О том, зачем нужна команда автоочистки в Greenplum и как она работает, мы...
Чем планирование запуска DAG в Apache AirFlow с объектом timedelta отличается от использования cron-выражений, в чем разница CronTriggerTimetable и CronDataIntervalTimetable, а также как создать собственный класс расписания. Объект timedelta vs cron-выражение: задание расписания запуска DAG в Apache AirFlow Apache AirFlow идеально подходит для классических пакетных ETL-сценариев, например, когда надо извлечь...
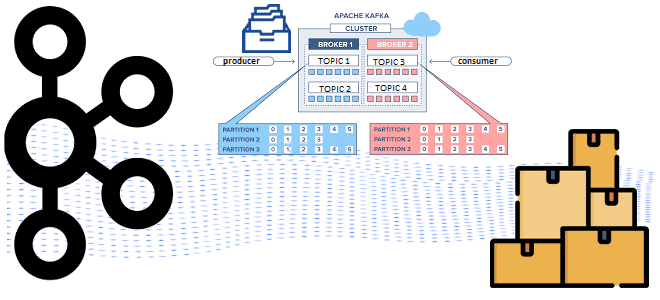
Какие конфигурации настроить на продюсере для эффективной публикации сообщений в Apache Kafka: упаковка записей в пакеты, взаимодействие с брокерами и метрики мониторинга этих процессов. Пакетирование сообщений при их публикации в Kafka и мониторинг этого процесса Хотя Apache Kafka поддерживает потоковую парадигму обработки информации, она активно использует пакетные технологии. В частности,...
Как сделать крупное обновление, вставку или удаление данных в Neo4j без OOM-ошибки и APOC-процедур при выполнении транзакции с параллельным выполнением подзапросов: функция CICT, ее возможности, ограничения и отличия от конструкции CALL IN TRANSACTIONS. Подзапросы в транзакциях Neo4j: CIT-запросы Cypher vs процедуры APOC Параллельная обработка данных быстрее последовательной. Поэтому многие фреймворки...
Как решать задачи машинного обучения в Greenplum с агентом gpMLBot и расширением PostgresML: возможности, ограничения и примеры. Что такое gpMLBot: Greenplum Automated Machine Learning Agent Чтобы использовать Greenplum как хранилище данных в задачах машинного обучения, в этой БД поддерживаются соответствующие механизмы. Одним из них является библиотека Apache MADlib, о которой...
Что такое проблема недетерминированного поведения, почему она так важна в потоковой обработке данных и как Apache Flink борется с ней: недетерминированные и динамические функции, а также changelog stateful-операторов. Недетерминированные функции в Apache Flink В потоковой обработке данных, на которую ориентирован Apache Flink, все завязано на отметку времени события (timestamp). Однако,...
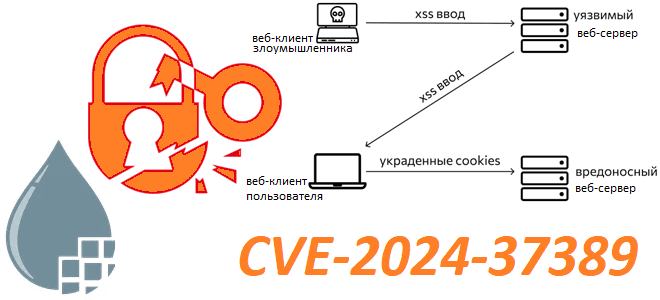
Как уязвимость CVE-2024-37389 может привести к выполнению произвольного кода в Apache NiFi: контекст параметров и межсайтовый скриптинг в веб-приложении для визуального проектирования конвейера обработки данных. Параметры свойств и их контекст в Apache NiFi 8 июля 2024 года в мажорном релизе Apache NiFi обнаружена уязвимость средней степени серьезности, связанная с неправильной...
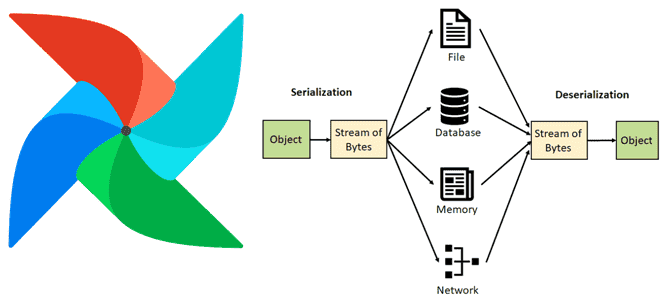
Как Apache AirFlow сериализует и десериализует данные, зачем с версии 2 включена обязательная сериализация DAG в JSON, почему для пользовательской сериализации рекомендуются словари или примитивы и что поможет сократить нагрузку на базу данных метаданных через настройку параметров сериализации в конфигурационном файле фреймворка. Сериализация данных в Apache AirFlow Чтобы сохранить данные...
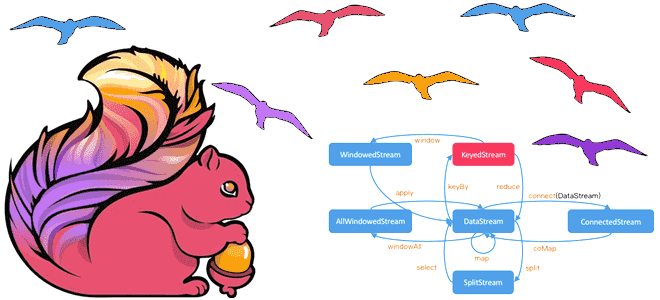
Чем DataSet API отличается от DataStream, зачем переходить с наборов на потоки данных в Apache Flink и как это сделать: эквивалентные и неподдерживаемые методы преобразования данных. Разница между DataStream и DataSet API Исторически в Apache Flink было 3 высокоуровневых API: DataStream/DataSet, Table и SQL. О возможностях и ограничениях каждого из...
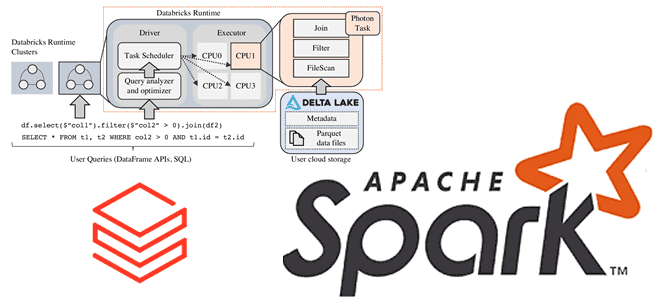
Зачем Databricks выпустила новый движок выполнения запросов Spark SQL для ML-приложений, как он работает и где его настроить: возможности и ограничения Photon Engine. Преимущества Photon Engine для ML-нагрузок Spark-приложений Чтобы сделать Apache Apark еще быстрее, разработчики Databricks выпустили новый движок выполнения запросов - Photon Engine. Это высокопроизводительный механизм запросов, который...
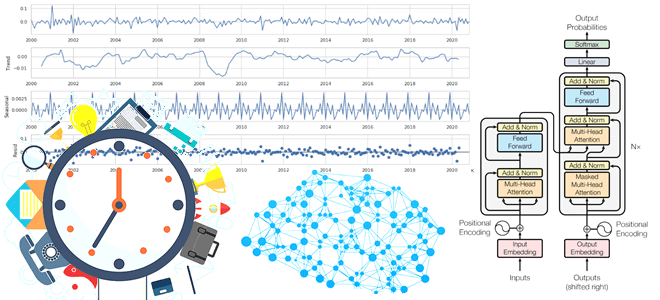
Почему генеративный ИИ хорошо подходит для прогнозирования временных рядов, как архитектура трансформеров учитывает влияние внешних переменных и сезонных факторов на измерения, и какие нейросетевые модели можно попробовать для этих задач. Проблемы прогнозирования временных рядов и их нейросетевые решения Прогнозирование временных рядов всегда было востребованной задачей в различных отраслях бизнеса. Временной...
24 августа вышел новый релиз Apache AirFlow. Знакомимся с новинками версии 2.10: гибкая настройка исполнителей для всей среды, конкретного DAG и отдельных задач, а также динамическое планирование набора данных и улучшения GUI. Гибкая настройка исполнителей Одной из самых главных новинок Apache AirFlow 2.10 стала конфигурация гибридного исполнения, позволяющая использовать несколько...
Зачем хранить данные в Apache Kafka постоянно и как это сделать: варианты использования и пример архитектурного решения Infinite Storage от Confluent Cloud, который лег в основу Tiered Storage. Infinite Storage от Confluent Cloud для бесконечного хранения данных в Apache Kafka Изначально Apache Kafka, как и любой другой брокер сообщений, не...
Школа Больших Данных проводит еще один бесплатный митап для архитекторов платформ данных, инженеров данных, разработчиков, DevOps-, DataOps-инженеров и просто интересующихся о модели Dataflow, API Apache Beam, а также паттернах управления приложениями распределенной обработки данных на Kubernetes. Apache Beam – унифицированный API с открытым исходным кодом, реализующий модель Dataflow, предоставляет единый...
Разработчики ClickHouse с завидной регулярностью радуют новыми релизами. Не прошло и месяца, как опубликован очередной выпуск этой колоночной СУБД, версия 24.8 LTS от 20 августа 2024. О ее главных новинках читайте далее. Несовместимые изменения Начнем с самых важных и несовместимых изменений. В релизе ClickHouse 24.8 LTS для clickhouse-client и clickhouse-local...