
Разберёмся, как генерировать изображения и аудио через OpenRouter одним ключом, а заодно распознавать речь и запускать генерацию видео. Идея та же, что и с текстом: один базовый адрес, один ключ, разные модальности. Не нужно поднимать отдельный Whisper-сервер, плодить SDK и держать по счёту у каждого поставщика. В статье пройдём...

Разберёмся, как использовать tool calling в OpenRouter, чтобы модель не просто болтала, а вызывала ваши функции и отвечала строго по схеме. Это тот шаг, после которого из чат-бота получается рабочий агент. В статье соберём вызов функций, многошаговый цикл и строгий JSON по схеме. Покажем и Response Healing, который чинит...
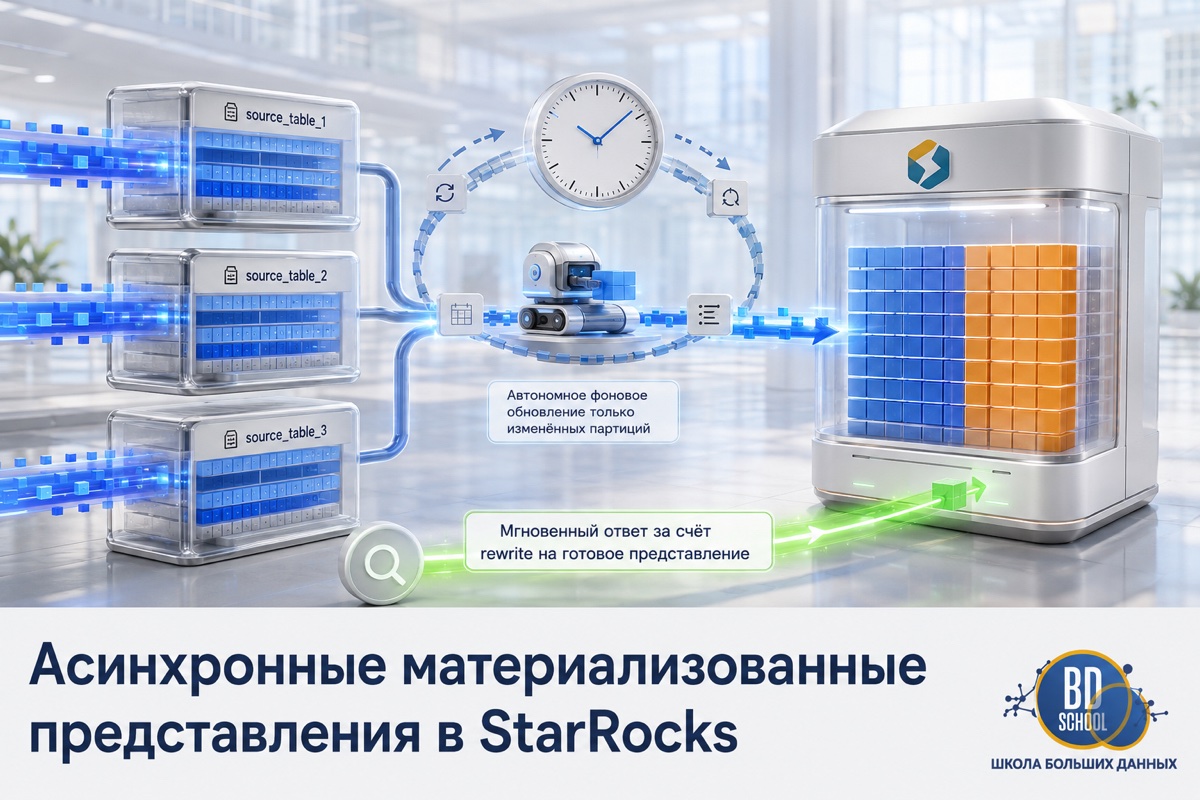
Типичное хранилище со временем обрастает зоопарком витрин. Десятки скриптов на cron пересчитывают агрегаты, гоняют одни и те же джойны по кругу и жгут процессорное время. Часть этой работы можно убрать внутрь самой СУБД. В StarRocks для этого есть асинхронные материализованные представления, которые обновляются по расписанию и инкрементально, по одной партиции....

Разберёмся, как подключить OpenRouter в n8n и собрать рабочий сценарий без единой строки кода. n8n это open-source платформа автоматизации, где логика собирается из узлов на визуальном холсте. OpenRouter отдаёт всё через OpenAI-совместимый API, поэтому подключается он в пару полей. В статье соберём контентный флоу, покажем, как через один ключ...
Аналитика реального времени начинается с того, что данные попадают в хранилище с минимальной задержкой после появления в источнике. Для StarRocks таким мостом из Apache Kafka служит Routine Load, встроенный механизм непрерывной загрузки потока прямо в таблицу. В этой статье соберем рабочий пайплайн: продюсер шлет JSON-события заказов в Kafka, а StarRocks...

Понять, как экономить токены в OpenRouter, важно ещё до того, как счёт за модели начнёт кусаться. Одна и та же задача может стоить в разы дешевле, если применить пару приёмов. В этой статье разберём четыре рычага: кэш промптов, липкую маршрутизацию, каскад моделей и субагентов. В конце добавим контроль расхода,...
Один и тот же SQL-запрос в StarRocks может выполниться за секунды или упасть по памяти. Разница не в железе, а в плане, который построил оптимизатор. За выбор плана отвечает Cost-Based Optimizer, а его точность целиком зависит от статистики данных. В этой статье разберем, как StarRocks собирает статистику, как читать...

Разобраться, как настроить маршрутизацию OpenRouter, стоит сразу после первого запроса. У одной модели обычно несколько провайдеров, и роутер по умолчанию сам решает, кому отдать вызов. Обычно это удобно, но иногда вам важнее цена, скорость или конкретный провайдер. В этой статье мы научимся управлять выбором: сортировать провайдеров, задавать свой порядок...
Наша школа проводит открытый вебинар по теме: "On‑line аналитика: как строить хранилище, которое пишет и считает одновременно" . Узнайте, как объединить потоковую загрузку и быстрые аналитические запросы без компромиссов, какие технологии реально работают в production и как строится потоковая архитектура (CDC → Kafka → Flink → StarRocks → BI). Приглашаем...
Инженеры данных часто спорят, какая колоночная СУБД быстрее. Спор бессмысленный без контекста нагрузки. ClickHouse и StarRocks решают разные задачи, хотя обе относятся к классу аналитических OLAP-движков. В этой статье мы разберем их архитектуру, покажем разницу в обработке соединений таблиц и соберем локальный стенд для честного нагрузочного теста на нормализованной...
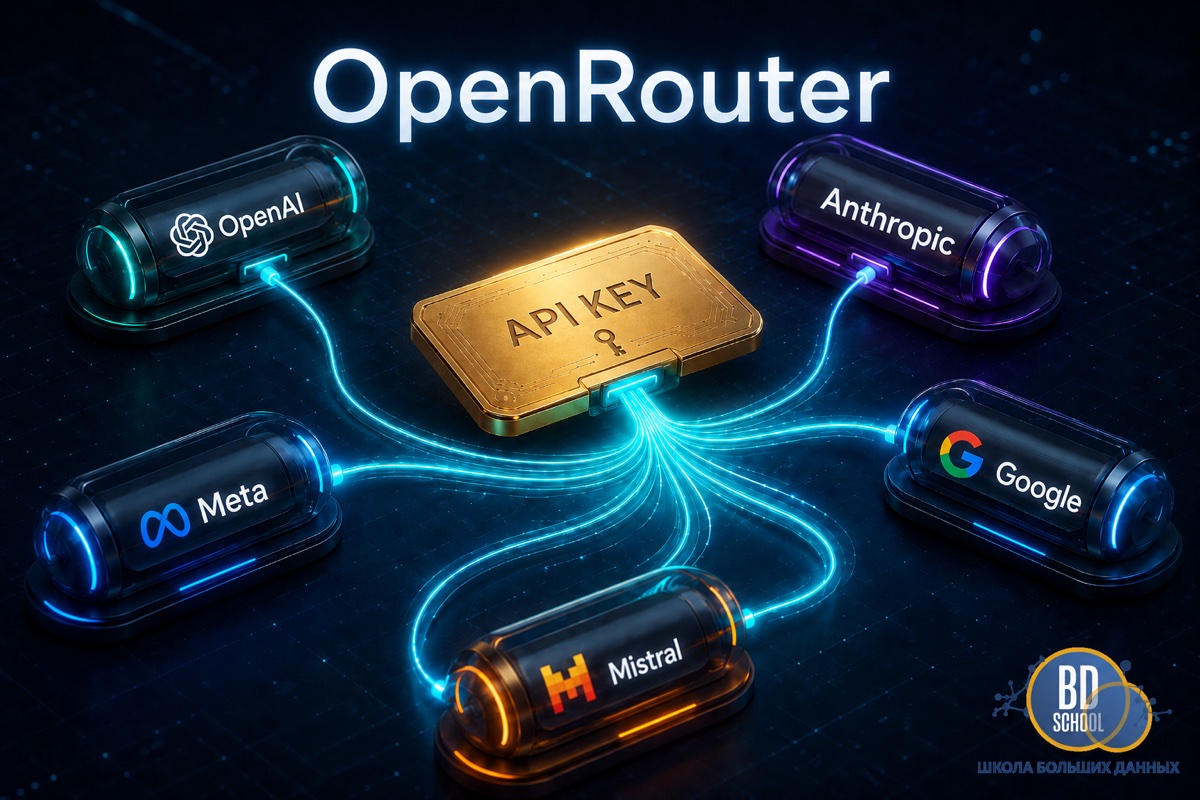
Чтобы понять, как начать работать с OpenRouter, хватит одного вечера и небольшого баланса. OpenRouter это единый OpenAI-совместимый роутер, где одним ключом доступны десятки моделей от разных провайдеров. В статье мы пройдём весь путь от регистрации до первого живого ответа модели. Отдельно и без прикрас разберём оплату из России. Именно...
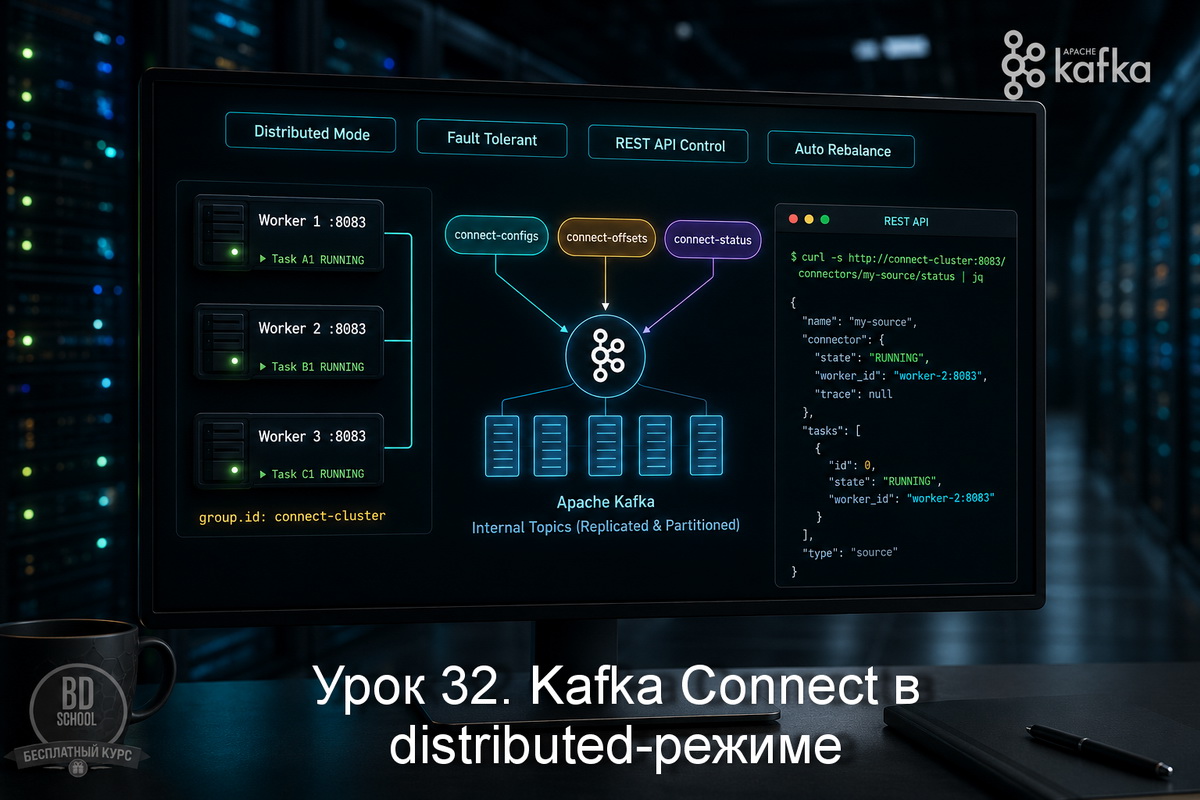
В уроке 31 мы разобрали standalone-режим Kafka Connect. Один процесс, конфигурация в файлах, офсеты на диске. Удобно для разработки, но в production такое не ставят: упал воркер — встали все коннекторы, и подхватить их некому. Distributed-режим решает именно это. Несколько воркеров объединяются в группу по group.id и синхронизируются через Kafka-топики....
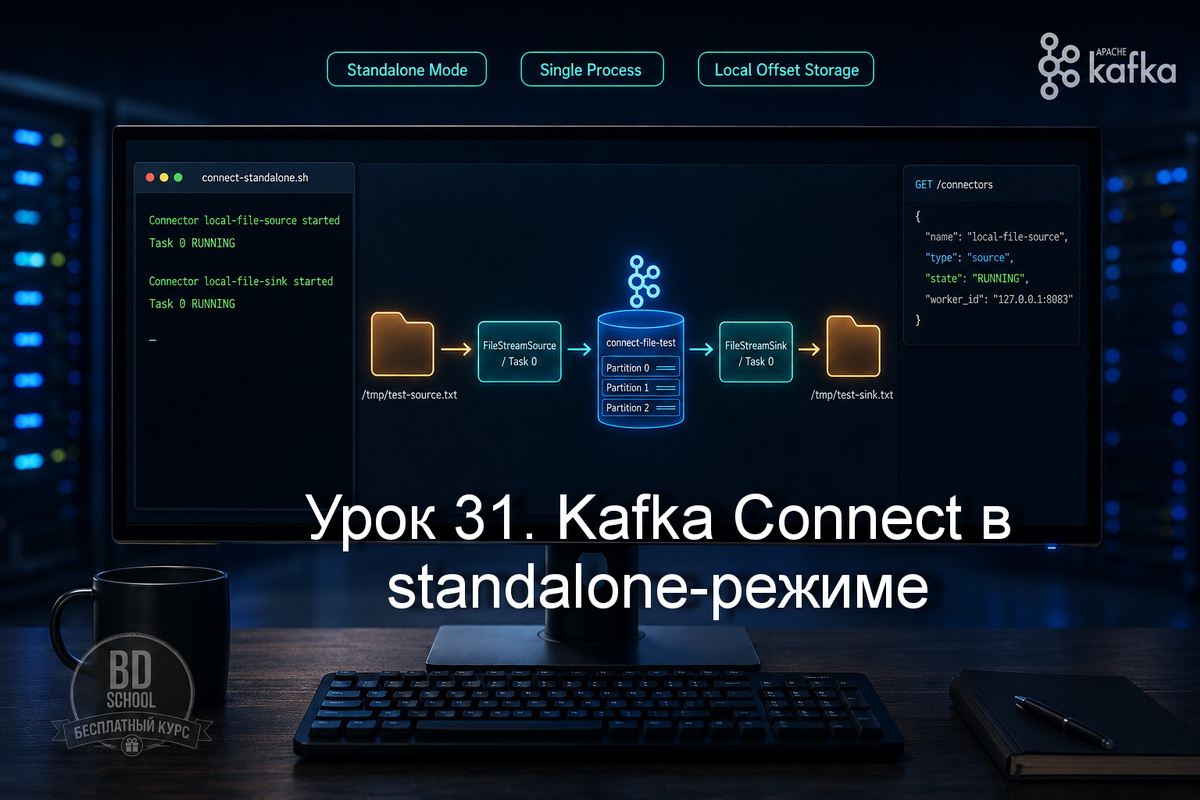
В уроке 30 разобрали MirrorMaker 2 - инструмент для репликации топиков между кластерами. Там мы мельком упоминали, что MM2 построен поверх Kafka Connect. Теперь пришло время разобраться с самим фреймворком. Kafka Connect - это слой интеграции, который берёт на себя всю рутину переноса данных между Kafka и внешними системами....
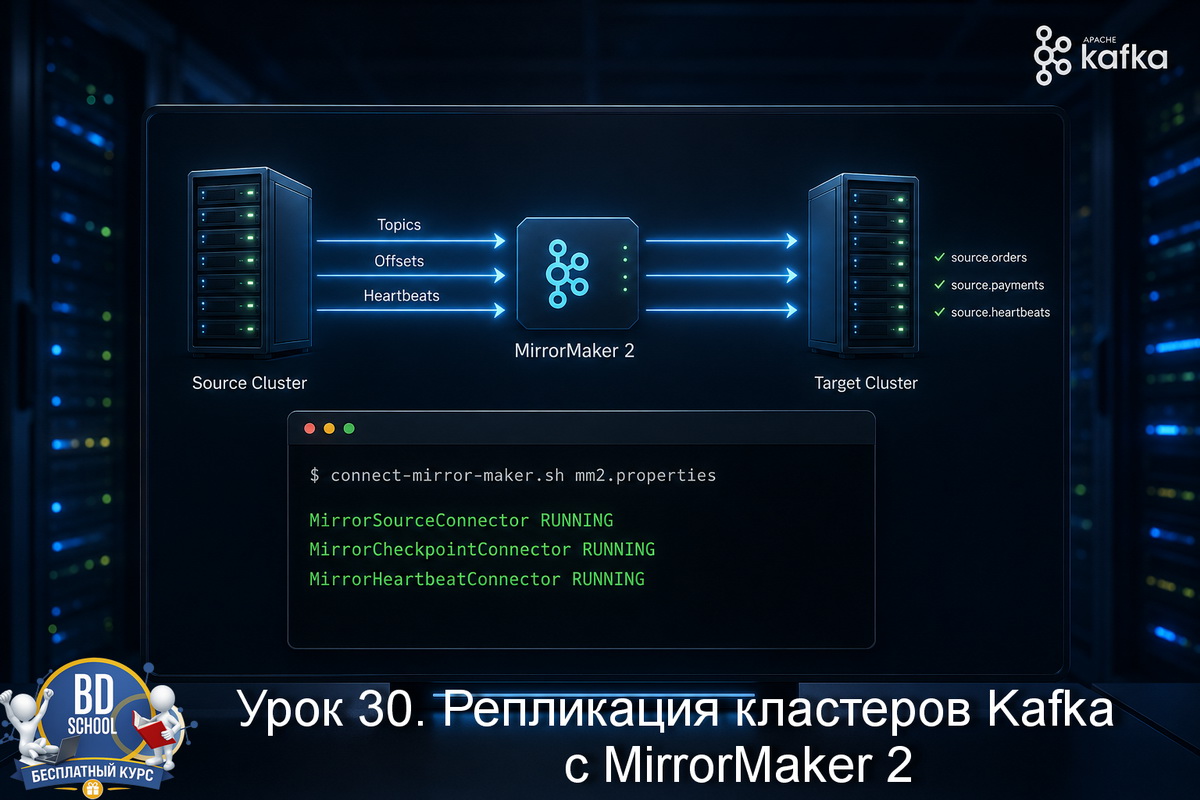
В уроке 29 мы разобрали kafka-consumer-perf-test.sh — как измерить скорость чтения, интерпретировать вывод и подбирать параметры консьюмера. Получили полную картину: есть цифры продюсера, есть цифры консьюмера, узкое место теперь видно. Следующий логичный вопрос: а что делать, если кластеров несколько? DR-окружение, географически распределённые датацентры, изоляция окружений prod и staging —...
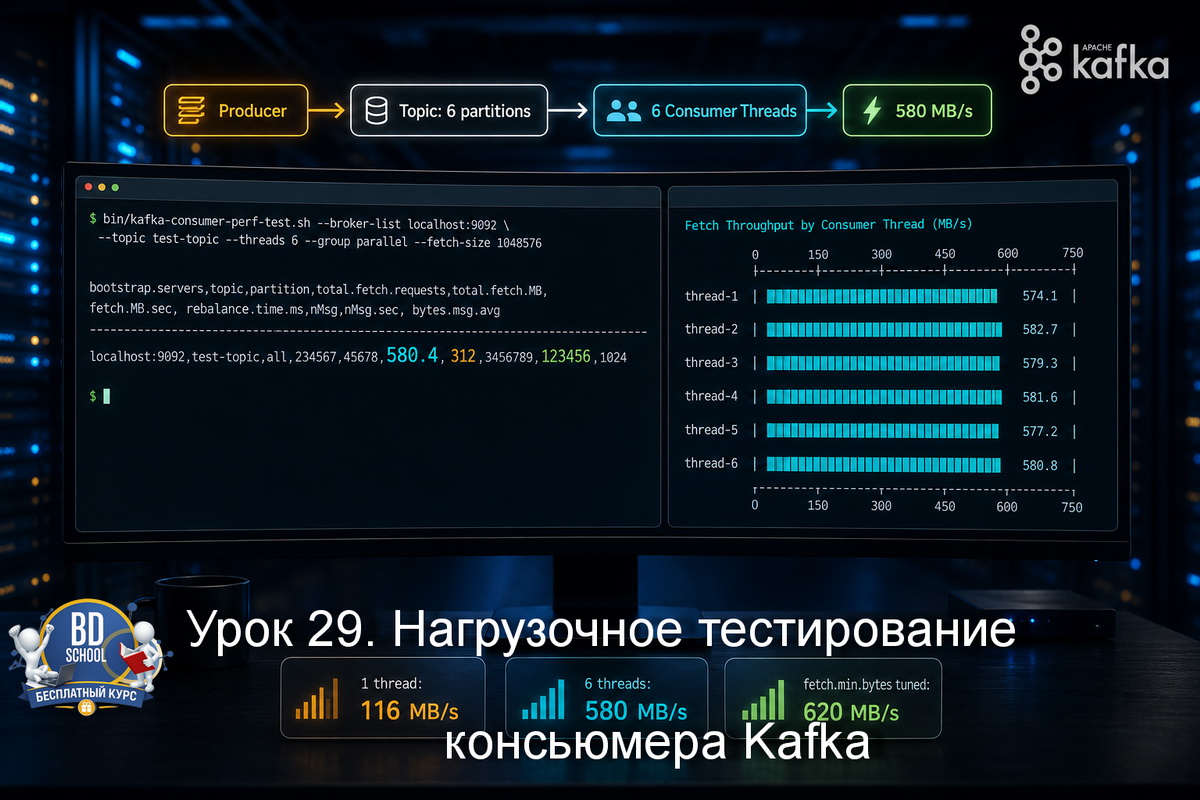
В уроке 28 мы разобрали kafka-producer-perf-test.sh: как гнать синтетическую нагрузку в топик, читать перцентили латентности и подбирать параметры продюсера. Получили цифры на стороне записи. Но у любого потока данных есть вторая сторона - чтение. И там своя картина. Узкое место системы не всегда продюсер. Часто потребитель не успевает за входящим...
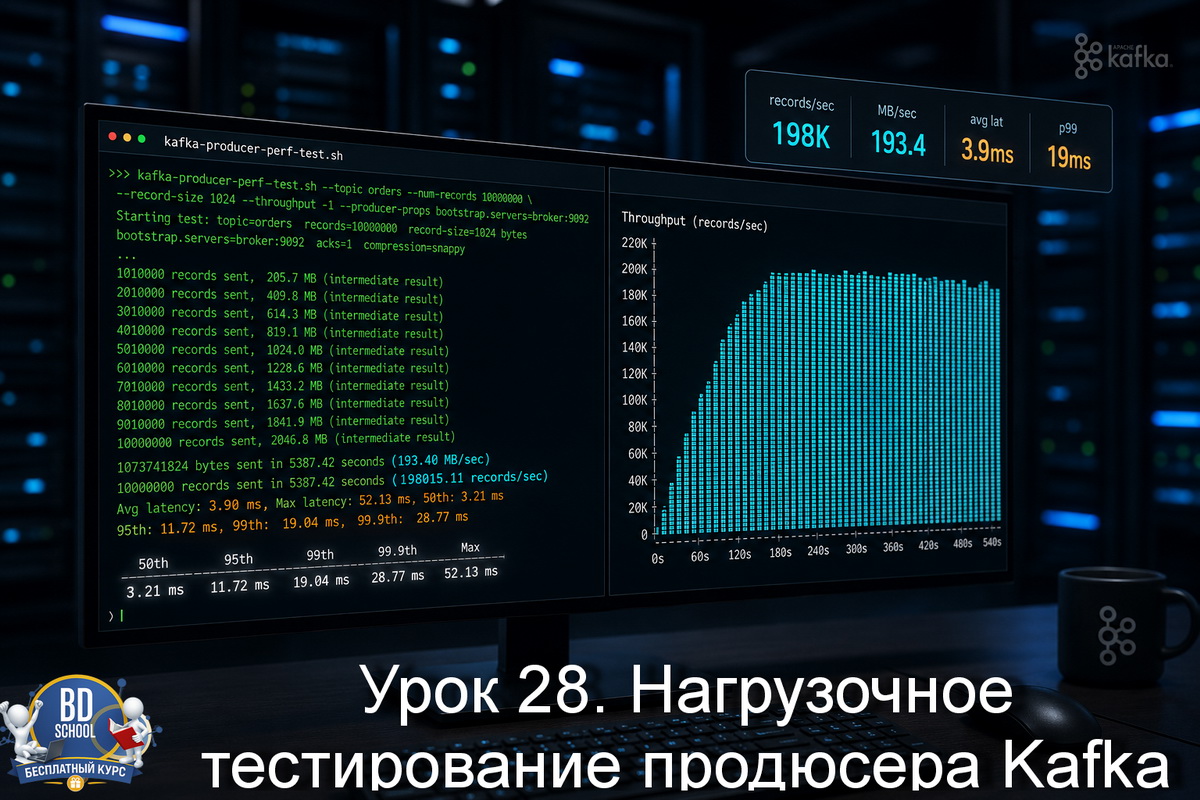
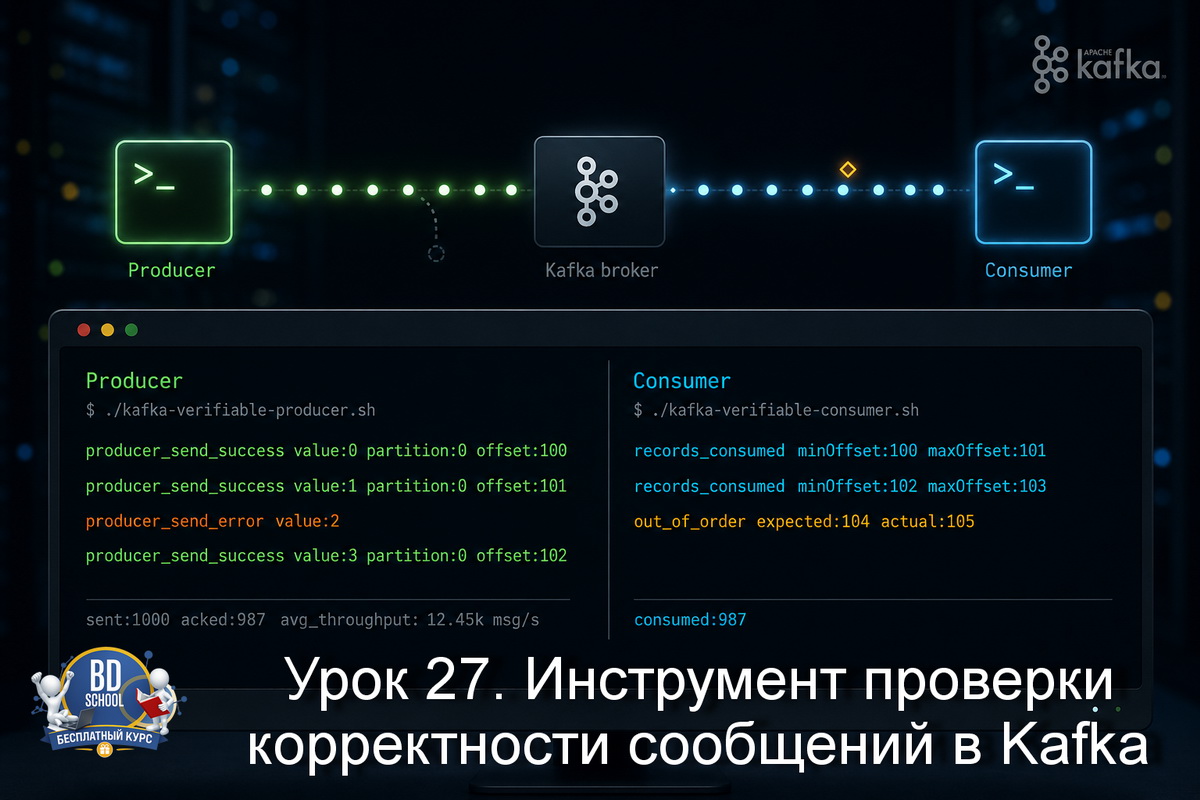
В уроке 27 мы разбирали kafka-verifiable-producer.sh и kafka-verifiable-consumer.sh - утилиты, которые показывают каждое отправленное и полученное сообщение в виде JSON. Они хороши для отладки: видно, что именно ушло, какой офсет получили, есть ли потери. Но если нужно понять не "что" отправляется, а "как быстро" и "с какой задержкой" -...
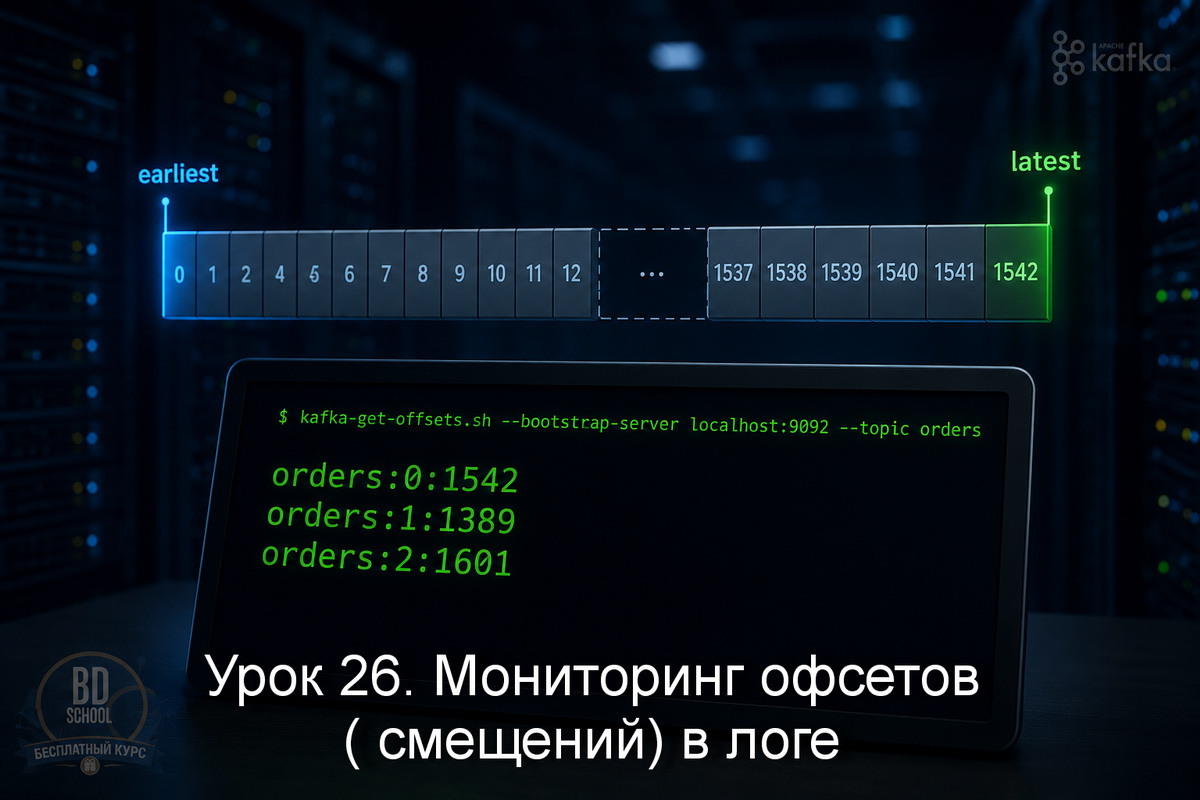
В уроке 26 мы работали с kafka-get-offsets.sh и разбирались, как читать офсеты топиков: где сейчас начало лога, где конец, сколько сообщений накопилось на каждой партиции. Офсеты дают общую картину, но не отвечают на вопрос, работает ли кластер так, как ожидается, когда по нему идёт реальный поток данных. Именно для...
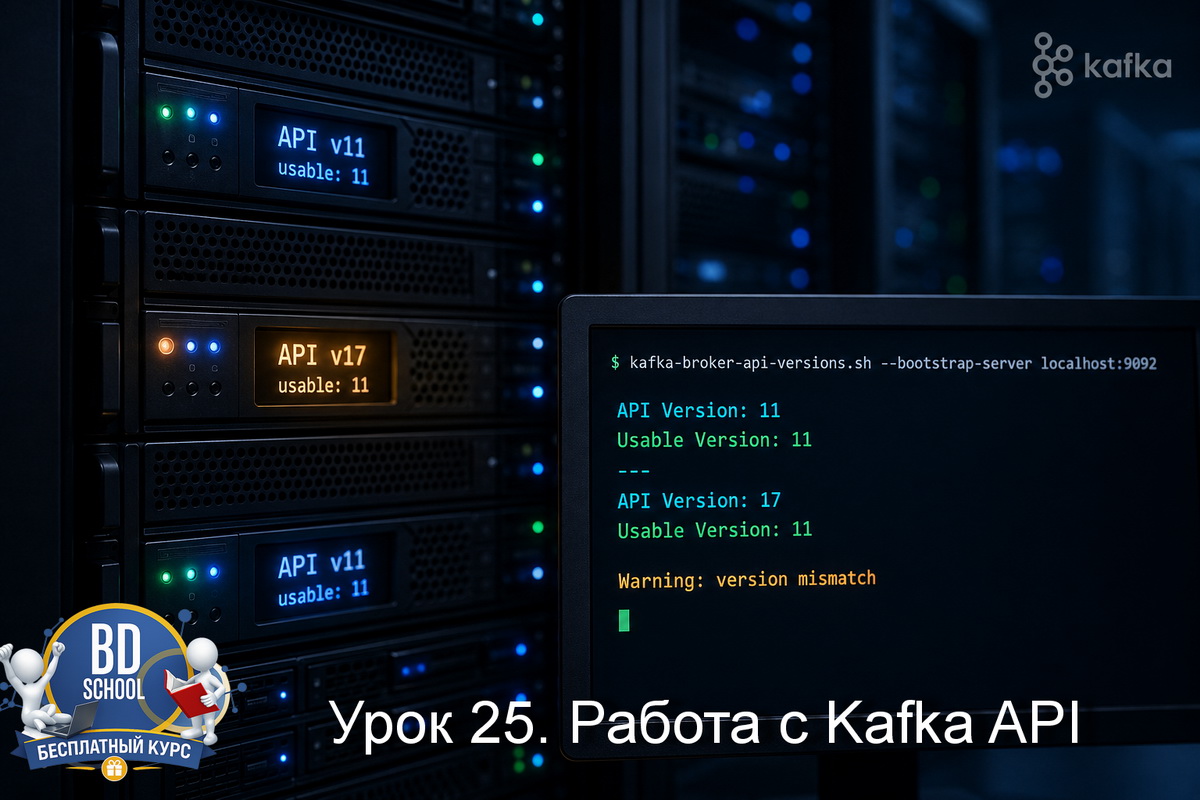
В уроке 25 мы разбирались с kafka-broker-api-versions.sh - смотрели, какие версии протокола поддерживает брокер, и учились диагностировать ошибки UNSUPPORTED_VERSION при rolling upgrade. Там речь шла о низкоуровневой совместимости на уровне API. Сегодня спускаемся на уровень ниже - не к протоколу, а к данным. Конкретно к офсетам. Любой, кто разбирается...
В уроке 24 мы разбирали kafka-acls.sh и работу со списками доступа: кто из клиентов что может делать с топиками, группами, кластером. Там же всплыл важный момент - аутентификация через SASL и флаг --command-config. Прежде чем клиент получит право что-то делать, он должен вообще договориться с брокером на уровне протокола....
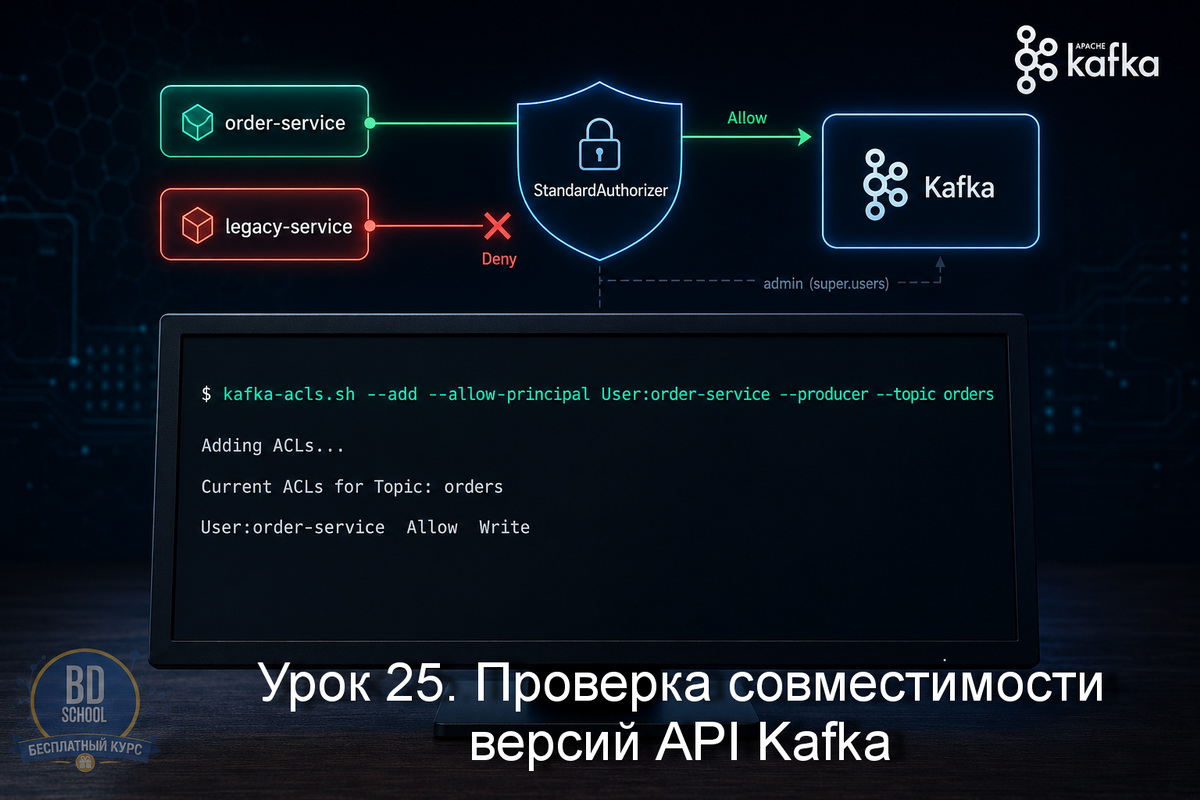
В уроке 23 мы разобрали kafka-replica-verification.sh - инструмент, который подключается к каждому брокеру напрямую и сравнивает смещения реплик. Там же мы отметили важную особенность: утилита общается с брокерами через Fetch API без каких-либо ограничений доступа. В реальном кластере это уже вопрос: а кто вообще имеет право подключаться? В production-окружениях...