
 10
Содержание
- О чём разбор Arenadata и что в нём не раскрыто
- Как работает классическая ребалансировка
- JoinGroup, SyncGroup и лидер группы
- Eager и cooperative-sticky
- Что меняет KIP-848
- Heartbeat вместо барьера
- Распределение на сервере и эпохи
- Что переехало с клиента на брокер
- Ребалансировка, fetch и фиксация оффсетов
- Четыре варианта в сравнении
- Практика, замер ребалансировки на стенде
- Стенд
- Пауза при масштабировании группы
- Миграция живой группы с classic на consumer
- Старые настройки с новым протоколом
- Ограничения и подводные камни
- Когда переходить на новый протокол
- Заключение
- Референсные ссылки
Вторая часть разбора Arenadata о пути сообщения в Apache Kafka от send() до фиксации оффсета задевает тему, которую обзоры чтения обычно проходят мимоходом, а именно протокол ребалансировки групп потребителей Kafka (Kafka consumer rebalance protocol). В Kafka 4.0 у классического протокола появился преемник по KIP-848, где партиции раздаёт брокер, а общей остановки группы больше нет. Звучит так, будто достаточно поменять одну настройку клиента, и паузы при масштабировании исчезнут. Мы проверили это на стенде из трёх узлов Kafka 4.3.2 с Python-клиентом confluent-kafka 2.16.0. Замерили паузу в чтении при входе, выходе, падении и рестарте потребителя для eager, cooperative-sticky, статического членства и нового протокола, перевели живую группу с classic на новый протокол поочерёдным перезапуском и посмотрели, что клиент делает со старыми настройками. Новый протокол выиграл не везде, и это, пожалуй, самое полезное в результатах.
О чём разбор Arenadata и что в нём не раскрыто
Arenadata, российский разработчик дистрибутивов платформ данных на основе open source, во второй части разбора «Под капотом Kafka» на Хабре идёт по стороне чтения. Разбор описывает pull-модель с Fetch-запросами, long polling через fetch.min.bytes и fetch.max.wait.ms, причины роста отставания (consumer lag) и согласование лимитов fetch.max.bytes с размером сообщений. Судя по нашему пересказу, группам потребителей там отведён короткий фрагмент о том, что координатор делит партиции между участниками, а при ребалансировке чтение затронутых партиций встаёт.
Наш пересказ лежит в новости о механизмах чтения в Kafka без перегрузки брокеров. Как именно останавливается чтение, сколько длится пауза и что с ней сделал KIP-848, в пересказе не раскрыто, и этим мы займёмся здесь. Тюнинг fetch в статье не повторяем, он подробно описан в уроке о производительности потребителя Kafka.
Как работает классическая ребалансировка
Группа потребителей (consumer group) это набор клиентов с общим group.id, которые делят партиции топика так, чтобы каждую читал ровно один участник. Ребалансировка (rebalance) запускается, когда меняется состав группы или число партиций. До Kafka 4.0 она шла по протоколу, который теперь называется classic, и его устройство объясняет почти все цифры нашего стенда.
JoinGroup, SyncGroup и лидер группы
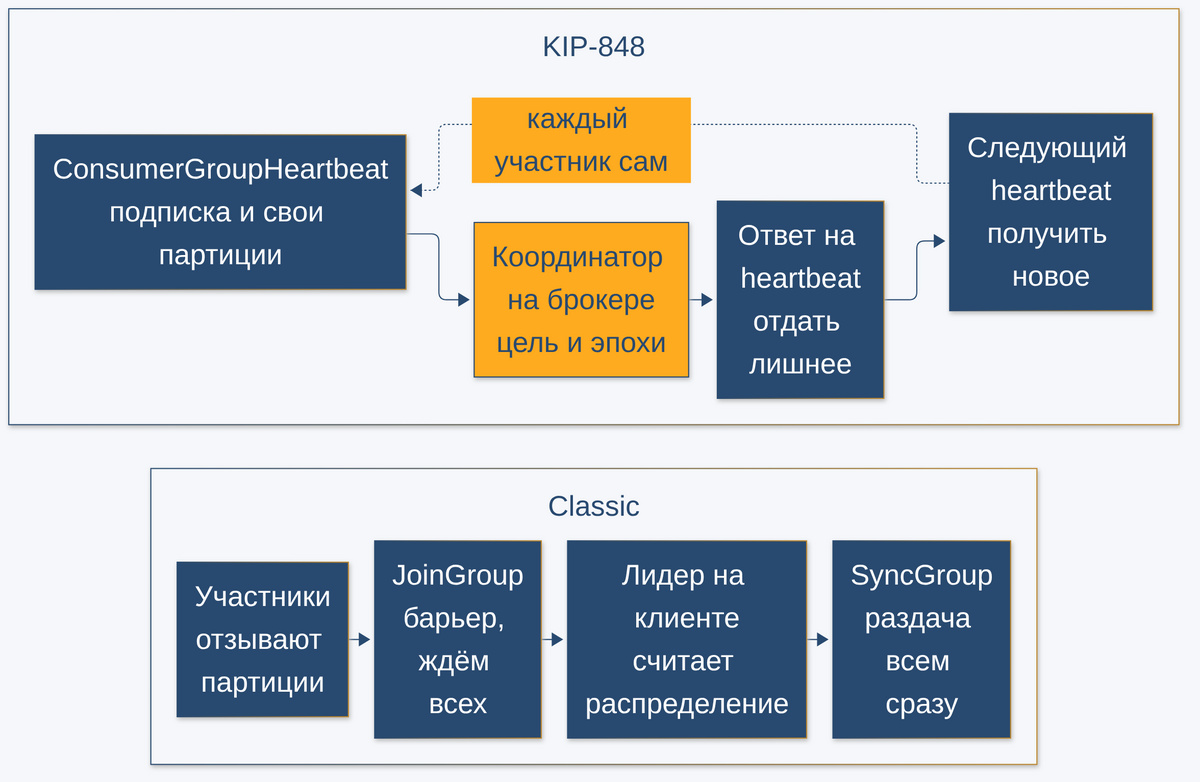
За группу отвечает координатор (group coordinator), один из брокеров кластера. Участник шлёт ему heartbeat, и когда координатор решает начать ребалансировку, в ответ приходит ошибка REBALANCE_IN_PROGRESS. Тогда каждый участник отправляет запрос JoinGroup со своей подпиской и списком поддерживаемых стратегий распределения (partition assignment strategy). Координатор дожидается всех, назначает одного из участников лидером группы и отдаёт ему полный список. Лидер прямо на клиенте считает, кому какие партиции достанутся, и присылает результат в запросе SyncGroup, а остальные получают свою долю в ответе на собственный SyncGroup.
Ключевое слово здесь барьер. Пока последний участник не прислал JoinGroup, новое распределение не посчитано, и один медленный клиент держит всю группу. Сколько координатор готов ждать, ограничивает max.poll.interval.ms, после чего отставший участник исключается. Логика распределения живёт целиком в клиенте, поэтому смена стратегии требует, чтобы её поддерживали все участники группы.
Eager и cooperative-sticky
Исходный режим ребалансировки называется eager. Перед JoinGroup каждый участник отзывает у себя все партиции, вызывает колбэк on_revoke и до конца SyncGroup не читает ничего. Это тот самый stop-the-world, ради которого о ребалансировке обычно и вспоминают. Стратегии range и roundrobin работают именно так.
Стратегия cooperative-sticky из KIP-429 делает ту же работу инкрементально. Участники ничего не отдают заранее, лидер считает новое распределение и сравнивает его со старым. Партиции, которые остаются на месте, продолжают читаться. Переезжающие отзываются у прежнего владельца, и нужен второй круг JoinGroup и SyncGroup, чтобы выдать их новому. Пауза касается только переезжающих партиций, но барьер никуда не делся, он просто стал короче. Авторы KIP-848 отдельно отмечают, что и при cooperative-протоколе фиксация оффсетов на время ребалансировки блокируется.
Статическое членство (static membership, KIP-345) решает другую задачу. Участник получает постоянный идентификатор group.instance.id, и при рестарте пода координатор узнаёт его и оставляет за ним прежние партиции без ребалансировки, если участник вернулся до истечения тайм-аута сессии. Подробно этот механизм разобран в статье о динамической и статической ребалансировке групп потребителей.
Что меняет KIP-848
KIP-848 описывает протокол ребалансировки следующего поколения. Он стал общедоступным (GA) в Kafka 4.0, где брокер включает новый движок групп автоматически. Клиент переходит на него одной настройкой group.protocol=consumer, а значение по умолчанию и у Java-клиента, и у librdkafka по-прежнему classic. librdkafka это библиотека-клиент Kafka на C, на которой построены клиенты для Python, Go и .NET. В librdkafka и построенном на ней confluent-kafka-python протокол объявлен GA с версии 2.12.0.
Heartbeat вместо барьера
Вместо пары JoinGroup и SyncGroup клиент шлёт один запрос ConsumerGroupHeartbeat. В нём участник сообщает подписку и партиции, которыми владеет сейчас, а в ответ получает своё целевое распределение. Если координатору нужно забрать партицию, он перестаёт включать её в ответ. Участник отзывает её, вызывает on_revoke и в следующем heartbeat подтверждает, что отдал. Только после этого партиция уходит новому владельцу в его собственном ответе на heartbeat.
Каждый участник сходится к своей цели независимо от остальных, поэтому общего барьера больше нет, и медленный клиент тормозит только те партиции, которые сам должен отдать. Обратная сторона в том, что всё движется шагами heartbeat. На стенде с интервалом по умолчанию это было видно невооружённым глазом. При старте группы из четырёх участников первый за 0.3 с получил все 12 партиций, на следующем heartbeat примерно через 5 с отдал девять, и только ещё через один heartbeat их получили остальные.
Распределение на сервере и эпохи
Распределение теперь считает брокер. Серверные стратегии (assignors) перечисляются в брокерном параметре group.consumer.assignors, по умолчанию это uniform и range. Uniform ведёт себя как sticky и старается не двигать партиции без нужды. Клиент может выбрать одну из включённых стратегий через group.remote.assignor, а клиентские стратегии новый протокол не поддерживает вовсе.
Согласованность держится на трёх эпохах (epoch). Эпоха группы (group epoch) растёт при каждом изменении состава или подписок. Эпоха назначения (assignment epoch) показывает, для какой версии группы посчитано целевое распределение. Эпоха участника (member epoch) говорит, до какого состояния дошёл конкретный клиент. Запрос с устаревшей эпохой участника брокер отклоняет ошибкой FENCED_MEMBER_EPOCH, и такой участник сбрасывает партиции и входит в группу заново. Той же эпохой отсекаются фиксации оффсетов от клиента, который партицию уже потерял. Вход в группу кодируется эпохой 0, выход эпохой -1, а временный выход статического участника эпохой -2.
Что переехало с клиента на брокер
Вместе с распределением на брокер переехали тайминги. При group.protocol=consumer клиентские session.timeout.ms, heartbeat.interval.ms и partition.assignment.strategy не работают. Вместо них действуют брокерные group.consumer.session.timeout.ms (по умолчанию 45 с) и group.consumer.heartbeat.interval.ms (5 с), и у каждого есть нижняя граница, по умолчанию равная тем же 45 с и 5 с. Значения можно переопределить для отдельной группы через IncrementalAlterConfigs на новый тип ресурса GROUP. Так на стенде у варианта consumer_hb1s интервал heartbeat снижен до 1 с без перезапуска брокера. Метод enforceRebalance() в новом протоколе ничего не делает.
Apache Kafka для инженеров данных
Код курса
DEVKI
Ближайшая дата курса
7 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Ребалансировка, fetch и фиксация оффсетов
Ребалансировка напрямую связана с циклом чтения, о котором писала Arenadata. Параметр max.poll.interval.ms остаётся клиентским в обоих протоколах. Если между вызовами poll прошло больше, клиент сам покидает группу, и его партиции переезжают. Долгая обработка пачки сообщений выглядит для группы как уход участника, и никакой протокол ребалансировки этого не исправит.
Второй стык это фиксация оффсетов. Колбэк on_revoke вызывается до того, как партиция уйдёт другому участнику, и это последнее место, где можно синхронно закоммитить обработанное. При падении процесса колбэк не вызывается вовсе, и новый владелец начинает с последнего зафиксированного оффсета. На стенде включён автокоммит раз в 5 с, поэтому после каждого SIGKILL группа перечитывала от 7 до 1370 сообщений во всех вариантах. Протокол на это число не влияет, на него влияет только частота фиксации. Размер пачки и тюнинг fetch разобраны в уроке 29, ссылка на него выше.
Четыре варианта в сравнении
Таблица сводит устройство протоколов и замер стенда. Пауза это медиана трёх повторов на группе из четырёх участников, 12 партициях и тайм-ауте сессии 10 с. Для нового протокола приведены две цифры, с интервалом heartbeat 5 с по умолчанию и с интервалом 1 с. Методика и полный вывод ниже, в практике.
| Критерий | Classic eager (range) | Classic cooperative-sticky | Static membership | Consumer (KIP-848) |
|---|---|---|---|---|
| Где считается распределение | Лидер группы на клиенте | Лидер группы на клиенте | Лидер группы на клиенте | Координатор на брокере |
| Останавливается ли вся группа | Да, все участники отдают все партиции | Нет, отзываются только переезжающие, но барьер JoinGroup и SyncGroup остаётся | Как у cooperative-sticky, рестарт в пределах сессии проходит без ребалансировки | Нет, каждый участник сходится к цели сам по heartbeat |
| Что настраивается на клиенте | Стратегия, session. |
То же | То же плюс group. |
group. |
| Что настраивается на брокере | Границы тайм-аута сессии, group. |
То же | То же | Стратегии, тайм-аут сессии и heartbeat, переопределение на группу |
| Поддержка в клиентах | Java-клиент, librdkafka | Java-клиент, librdkafka | Java-клиент, librdkafka | Java-клиент 4.x, librdkafka от 2.12.0 |
| Вход пятого участника, макс. пауза | 0.52 с, отозвано 12 партиций | 3.27 с, отозвано 2 | 3.14 с, отозвано 2 | 1.56 с и 0.70 с, отозвано 2 |
| Мягкий выход, макс. пауза | 1.38 с | 1.53 с | 12.99 с | 4.93 с и 1.04 с |
| Рестарт за 1 с, макс. пауза | 8.12 с, стоят 12 из 12 | 8.46 с, стоят 4 из 12 | 1.37 с, стоят 4 из 12 | 11.43 с и 10.34 с, стоят 6 и 4 из 12 |
| Падение без возврата, макс. пауза | 11.27 с | 11.15 с | 10.20 с | 10.76 с и 10.82 с |
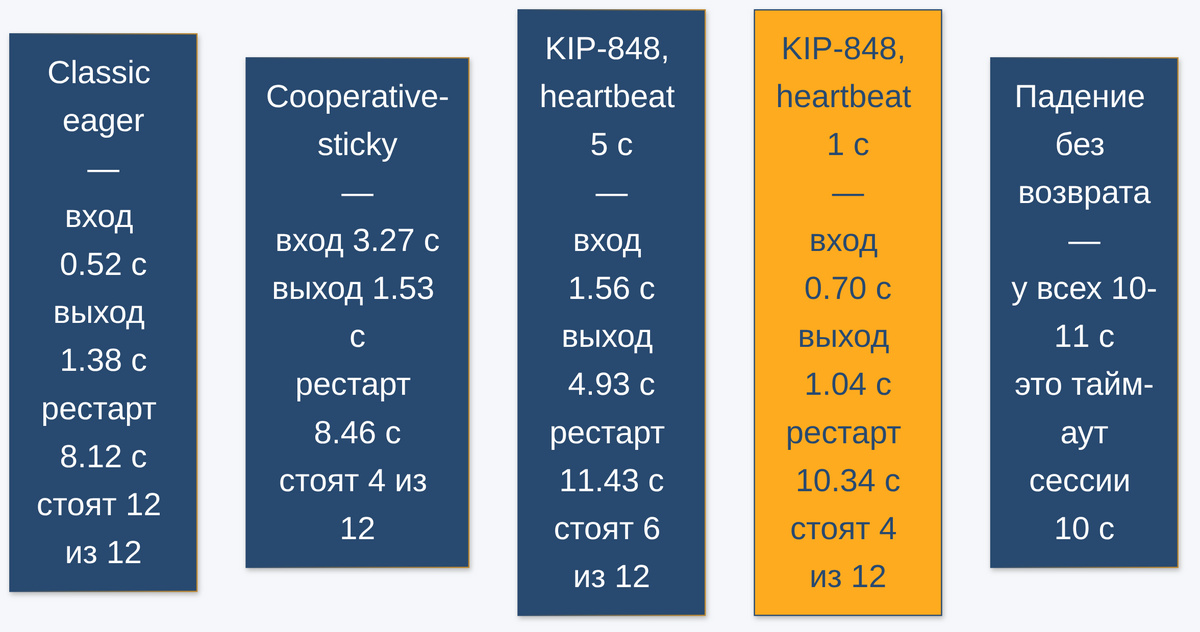
По устройству KIP-848 выглядит лучше всех, а замер эту картину заметно усложняет. Eager честно отзывает все партиции на любом событии, но на таком масштабе новое назначение приходит за доли секунды, и на входе пятого участника он оказался самым быстрым. Его слабое место это рестарт, когда группа ждёт тайм-аута пропавшего участника и все 12 партиций стоят около 8 с. Cooperative-sticky ровнее, но на входе платит за два круга ребалансировки. Статическое членство вне конкуренции на рестартах, 1.37 с против 8-11 с у остальных, зато мягкий выход у него худший, потому что статический участник при close() группу не покидает и его партиции ждут тайм-аута сессии.
Новый протокол с брокерными настройками по умолчанию быстрее cooperative-sticky на входе, но втрое медленнее на выходе, потому что отзыв и выдача партиции разнесены на разные heartbeat с интервалом 5 с. С интервалом 1 с тот же протокол на входе, как и eager, не останавливает ни одной партиции и становится лучшим на выходе. Падение у всех вариантов занимает около 10-11 с, потому что это тайм-аут сессии, а его новый протокол не сокращает.
Теперь о чужой цифре, которую часто цитируют. Instaclustr, компания, которая предоставляет управляемые кластеры Kafka, опубликовала замер, где после увеличения топика со 100 до 1000 партиций группа из 10 потребителей на classic перераспределилась за 103 с, а на новом протоколе за 5 с. Это один прогон на Kafka 4.0 без указания железа и стратегии classic, и сценарий там другой, добавление партиций, а не смена состава группы. Мы его не воспроизводили, поэтому в таблицу цифра не попала. Share groups из KIP-932 сюда тоже не входят, это отдельный режим чтения в духе очереди, а не новый способ делить партиции между участниками группы.
Практика, замер ребалансировки на стенде
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Сценарий такой. Поднимаем кластер, даём ровную нагрузку в топик на 12 партиций и меряем паузу в чтении при смене состава группы для пяти вариантов. Затем переводим живую группу с classic на новый протокол и в конце проверяем, как клиенты реагируют на старые настройки.
Стенд
Стенд состоит из трёх узлов Apache Kafka 4.3.2 в режиме KRaft (Kafka Raft, метаданные кластера хранит сама Kafka без ZooKeeper), где каждый узел одновременно брокер и контроллер, с лимитом памяти 1.5 ГБ на узел. Прогон шёл на сервере статей с 4 vCPU и 16 ГБ памяти под Ubuntu 24.04 и Python 3.12. В compose.yaml тайм-аут сессии для нового протокола опущен с 45 до 10 с, чтобы сравнивать варианты на равных, ведь classic-клиенты в демо выставляют session.timeout.ms=10000 сами. Нижняя граница heartbeat опущена до 1 с, а сам интервал остаётся 5 с по умолчанию.
# Apache Kafka 4.3.2, три узла KRaft (broker + controller), прогнано на стенде 2026-10-22
name: blog-kafka_consumer_rebalance_protocol

x-kafka-env: &kafka-env
  CLUSTER_ID: 4L6g3nShT-eMCtK--X86sw
  KAFKA_PROCESS_ROLES: broker,controller
  KAFKA_CONTROLLER_QUORUM_VOTERS: 1@kafka1:9093,2@kafka2:9093,3@kafka3:9093
  KAFKA_CONTROLLER_LISTENER_NAMES: CONTROLLER
  KAFKA_INTER_BROKER_LISTENER_NAME: INTERNAL
  KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: CONTROLLER:PLAINTEXT,INTERNAL:PLAINTEXT,HOST:PLAINTEXT
  KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 3
  KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR: 3
  KAFKA_TRANSACTION_STATE_LOG_MIN_ISR: 2
  KAFKA_HEAP_OPTS: -Xms768m -Xmx768m
  # Тайм-аут сессии для group.protocol=consumer задаёт брокер, не клиент.
  # По умолчанию 45 с и минимум тоже 45 с; опускаем до 10 с, как у classic-клиентов в демо.
  KAFKA_GROUP_CONSUMER_MIN_SESSION_TIMEOUT_MS: 6000
  KAFKA_GROUP_CONSUMER_SESSION_TIMEOUT_MS: 10000
  # Нижняя граница heartbeat тоже 5 с по умолчанию; опускаем, чтобы группа могла выставить 1 с
  KAFKA_GROUP_CONSUMER_MIN_HEARTBEAT_INTERVAL_MS: 1000
  # Сам интервал heartbeat по умолчанию остаётся 5000 мс, assignors тоже (uniform,range)

x-kafka: &kafka
  image: apache/kafka:4.3.2
  mem_limit: 1536m
  healthcheck:
    test: ["CMD-SHELL", "/opt/kafka/bin/kafka-broker-api-versions.sh --bootstrap-server localhost:19092 > /dev/null 2>&1"]
    interval: 5s
    timeout: 10s
    retries: 30
    start_period: 10s

services:
  kafka1:
    <<: *kafka
    hostname: kafka1
    ports: ["127.0.0.1:9092:9092"]
    environment:
      <<: *kafka-env
      KAFKA_NODE_ID: 1
      KAFKA_LISTENERS: INTERNAL://:19092,CONTROLLER://:9093,HOST://:9092
      KAFKA_ADVERTISED_LISTENERS: INTERNAL://kafka1:19092,HOST://localhost:9092

  kafka2:
    <<: *kafka
    hostname: kafka2
    ports: ["127.0.0.1:9094:9094"]
    environment:
      <<: *kafka-env
      KAFKA_NODE_ID: 2
      KAFKA_LISTENERS: INTERNAL://:19092,CONTROLLER://:9093,HOST://:9094
      KAFKA_ADVERTISED_LISTENERS: INTERNAL://kafka2:19092,HOST://localhost:9094

  kafka3:
    <<: *kafka
    hostname: kafka3
    ports: ["127.0.0.1:9096:9096"]
    environment:
      <<: *kafka-env
      KAFKA_NODE_ID: 3
      KAFKA_LISTENERS: INTERNAL://:19092,CONTROLLER://:9093,HOST://:9096
      KAFKA_ADVERTISED_LISTENERS: INTERNAL://kafka3:19092,HOST://localhost:9096
Python-зависимость одна, клиент confluent-kafka 2.16.0 со встроенной librdkafka той же версии.
confluent-kafka==2.16.0
Стенд поднимается одной командой, затем ставится клиент в отдельное виртуальное окружение.
# Docker Compose v2, Apache Kafka 4.3.2, Python 3.12, прогнано на стенде 2026-10-22
docker compose up -d --wait
docker compose exec -T kafka1 /opt/kafka/bin/kafka-topics.sh --version
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
 Network blog-kafka_consumer_rebalance_protocol_default  Creating
 Network blog-kafka_consumer_rebalance_protocol_default  Created
 Container blog-kafka_consumer_rebalance_protocol-kafka1-1  Creating
 Container blog-kafka_consumer_rebalance_protocol-kafka2-1  Creating
 Container blog-kafka_consumer_rebalance_protocol-kafka3-1  Creating
 Container blog-kafka_consumer_rebalance_protocol-kafka3-1  Created
 Container blog-kafka_consumer_rebalance_protocol-kafka2-1  Created
 Container blog-kafka_consumer_rebalance_protocol-kafka1-1  Created
 Container blog-kafka_consumer_rebalance_protocol-kafka2-1  Starting
 Container blog-kafka_consumer_rebalance_protocol-kafka3-1  Starting
 Container blog-kafka_consumer_rebalance_protocol-kafka1-1  Starting
 Container blog-kafka_consumer_rebalance_protocol-kafka2-1  Started
 Container blog-kafka_consumer_rebalance_protocol-kafka3-1  Started
 Container blog-kafka_consumer_rebalance_protocol-kafka1-1  Started
 Container blog-kafka_consumer_rebalance_protocol-kafka1-1  Waiting
 Container blog-kafka_consumer_rebalance_protocol-kafka2-1  Waiting
 Container blog-kafka_consumer_rebalance_protocol-kafka3-1  Waiting
 Container blog-kafka_consumer_rebalance_protocol-kafka2-1  Healthy
 Container blog-kafka_consumer_rebalance_protocol-kafka3-1  Healthy
 Container blog-kafka_consumer_rebalance_protocol-kafka1-1  Healthy
4.3.2
Нагрузку даёт producer_load.py. Он создаёт топик rebalance-bench на 12 партиций с фактором репликации 3 и пишет по 100 сообщений в секунду в каждую партицию. Ровный поток нужен, чтобы паузу можно было считать по времени создания сообщения (CreateTime).
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22
"""Ровная нагрузка в топик: по RATE сообщений в секунду в каждую партицию.

Задержку чтения потребитель считает по CreateTime сообщения, поэтому продюсер
пишет в каждую партицию равномерно и без пауз. Запуск отдельно:
    python producer_load.py            # пишет, пока не нажать Ctrl+C
"""

import os
import sys
import time

from confluent_kafka import Producer
from confluent_kafka.admin import AdminClient, NewTopic

BOOTSTRAP = os.environ.get("BOOTSTRAP", "localhost:9092,localhost:9094,localhost:9096")
TOPIC = "rebalance-bench"
PARTITIONS = 12
RATE = 100  # сообщений в секунду на партицию, всего 1200/с


def ensure_topic() -> None:
    """Создаёт топик на 12 партиций с RF=3, если его ещё нет."""
    admin = AdminClient({"bootstrap.servers": BOOTSTRAP})
    if TOPIC in admin.list_topics(timeout=10).topics:
        return
    fut = admin.create_topics([NewTopic(TOPIC, PARTITIONS, 3)])[TOPIC]
    fut.result()


def run(stop=None) -> None:
    """Пишет пачку «по одному сообщению в каждую партицию» каждые 1/RATE секунды."""
    ensure_topic()
    producer = Producer({"bootstrap.servers": BOOTSTRAP, "linger.ms": 5, "acks": 1})
    step = 1.0 / RATE
    next_t = time.time()
    sent = 0
    while stop is None or not stop.is_set():
        for p in range(PARTITIONS):
            producer.produce(TOPIC, value=b"x" * 100, partition=p)
        sent += PARTITIONS
        producer.poll(0)
        next_t += step
        delay = next_t - time.time()
        if delay > 0:
            time.sleep(delay)
    producer.flush(10)
    print(f"продюсер остановлен, отправлено {sent}", flush=True)


if __name__ == "__main__":
    try:
        run()
    except KeyboardInterrupt:
        sys.exit(0)
Каждый участник группы живёт в отдельном процессе, поэтому его можно убить SIGKILL так же, как падает под в Kubernetes. Модуль group_member.py описывает варианты, процесс участника и сборщик событий. Сначала идут конфигурации вариантов и сам участник. У classic-вариантов тайм-аут сессии задаёт клиент, у consumer его задаёт брокер.
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22
"""Участник группы потребителей и сборщик замеров для rebalance_bench.py и migrate_group.py.

Каждый участник живёт в своём процессе: так его можно честно убить SIGKILL, как падение
пода. Всё, что он видит, уходит в общую очередь: пачки сообщений и колбэки
on_assign / on_revoke / on_lost. Сборщик в главном процессе считает паузу по партициям.
"""

import multiprocessing as mp
import threading
import time
from collections import defaultdict

from producer_load import BOOTSTRAP, PARTITIONS, TOPIC

# Четыре варианта из статьи. Тайм-аут сессии у classic задаёт клиент (10 с),
# у consumer его задаёт брокер (group.consumer.session.timeout.ms=10000 в compose.yaml).
MODES = {
    "eager": {"group.protocol": "classic", "partition.assignment.strategy": "range",
              "session.timeout.ms": 10000},
    "cooperative": {"group.protocol": "classic", "partition.assignment.strategy": "cooperative-sticky",
                    "session.timeout.ms": 10000},
    "static": {"group.protocol": "classic", "partition.assignment.strategy": "cooperative-sticky",
               "session.timeout.ms": 10000},  # плюс group.instance.id, см. member()
    "consumer": {"group.protocol": "consumer"},  # тайминги и assignor (uniform) на брокере
    "consumer_hb1s": {"group.protocol": "consumer"},  # то же, heartbeat группы 1 с, см. GROUP_CONFIGS
}
# Настройки уровня группы (KIP-848): живут на брокере, клиент их не передаёт
GROUP_CONFIGS = {"consumer_hb1s": {"consumer.heartbeat.interval.ms": "1000"}}

STALL = 1.0  # партиция считается остановленной, если задержка чтения выше секунды


def member(mode: str, name: str, group: str, stop, q) -> None:
    """Процесс одного потребителя: читает и шлёт в очередь всё, что видит."""
    from confluent_kafka import Consumer

    conf = {"bootstrap.servers": BOOTSTRAP, "group.id": group, "client.id": name,
            "auto.offset.reset": "latest", **MODES[mode]}
    if mode == "static":
        conf["group.instance.id"] = name  # статическое членство: id переживает рестарт
    c = Consumer(conf)

    def cb(kind):
        return lambda _c, parts: q.put((kind, name, time.time(), [p.partition for p in parts]))

    c.subscribe([TOPIC], on_assign=cb("assign"), on_revoke=cb("revoke"), on_lost=cb("lost"))
    while not stop.is_set():
        msgs = c.consume(500, 0.1)
        now = time.time()
        batch = [(m.partition(), m.offset(), m.timestamp()[1]) for m in msgs if not m.error()]
        if batch:
            q.put(("batch", name, now, batch))
    c.close()  # мягкий выход: LeaveGroup у classic, heartbeat с epoch -1 у consumer
Функция set_group_config нужна только варианту consumer_hb1s. Она меняет интервал heartbeat для одной группы через IncrementalAlterConfigs, и это новая возможность, которую принёс KIP-848.
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22, продолжение group_member.py
def set_group_config(group: str, configs: dict) -> None:
    """IncrementalAlterConfigs для ресурса GROUP: так меняют тайминги без перезапуска брокера."""
    from confluent_kafka.admin import (AdminClient, AlterConfigOpType, ConfigEntry,
                                       ConfigResource, ResourceType)

    entries = [ConfigEntry(k, v, incremental_operation=AlterConfigOpType.SET) for k, v in configs.items()]
    res = ConfigResource(ResourceType.GROUP, group, incremental_configs=entries)
    admin = AdminClient({"bootstrap.servers": BOOTSTRAP})  # ссылка нужна до конца result()
    admin.incremental_alter_configs([res])[res].result()
Класс Group запускает и убивает участников и в фоновом потоке собирает их пачки сообщений и колбэки.
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22, продолжение group_member.py
class Group:
    """Набор участников-процессов одной группы и сборщик их событий."""

    def __init__(self, group: str):
        self.ctx = mp.get_context("spawn")
        self.q = self.ctx.Queue()
        self.group = group
        self.procs = {}  # имя -> (процесс, событие остановки)
        self.owned = defaultdict(set)  # имя -> партиции по колбэкам
        self.last_cb = time.time()
        self.max_off = {}  # партиция -> максимальный прочитанный offset
        self.events = []  # (время, вид, имя, данные)
        self.lock = threading.Lock()
        threading.Thread(target=self._drain, daemon=True).start()

    def start(self, mode: str, name: str) -> None:
        stop = self.ctx.Event()
        p = self.ctx.Process(target=member, args=(mode, name, self.group, stop, self.q), daemon=True)
        p.start()
        self.procs[name] = (p, stop)

    def leave(self, name: str) -> None:
        p, stop = self.procs.pop(name)
        stop.set()
        p.join(30)

    def kill(self, name: str) -> None:
        p, _ = self.procs.pop(name)
        p.kill()  # SIGKILL: ни LeaveGroup, ни колбэков, брокер узнает по тайм-ауту сессии
        p.join()
        with self.lock:
            self.owned.pop(name, None)

    def stop_all(self) -> None:
        for name in list(self.procs):
            self.leave(name)

    def _drain(self) -> None:
        while True:
            kind, name, t, data = self.q.get()
            with self.lock:
                if kind == "batch":
                    self.events.append((t, kind, name, data))
                    continue
                self.last_cb = t
                if kind == "assign":
                    self.owned[name] |= set(data)
                else:  # revoke и lost
                    self.owned[name] -= set(data)
                self.events.append((t, kind, name, data))
Последняя часть модуля решает, когда группа стабильна, и считает замер окна. Группа считается стабильной, если все 12 партиций розданы по одному разу, у каждого живого участника есть партиции и колбэков не было 3 с. Условие про каждого участника появилось после отладки, потому что в новом протоколе первый вошедший сначала забирает все 12 партиций.
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22, продолжение group_member.py
    def stable(self) -> bool:
        """Все 12 партиций розданы ровно по разу, у каждого живого участника есть партиции,
        колбэков 3 с не было."""
        with self.lock:
            alive = [self.owned[n] for n in self.procs]
            total = sum(len(s) for s in alive)
            union = set().union(*alive) if alive else set()
            return (total == PARTITIONS and len(union) == PARTITIONS and all(alive)
                    and time.time() - self.last_cb > 3)

    def wait_stable(self, timeout: float = 60) -> float:
        t0 = time.time()
        while not self.stable() and time.time() - t0 < timeout:
            time.sleep(0.2)
        return time.time() - t0

    def window(self, t0: float, t1: float) -> dict:
        """Замер окна [t0, t1]: пауза по партициям, отзывы и повторно прочитанные сообщения."""
        pause = defaultdict(float)
        dup = 0
        revoked, revokers, lost = 0, set(), 0
        cb_times = []
        with self.lock:
            evs = [e for e in self.events if e[0] >= t0 - 0.5]
            self.events = [e for e in self.events if e[0] >= t1]  # память не копим
        for t, kind, name, data in sorted(evs, key=lambda e: e[0]):
            if kind == "batch":
                for p, off, ts in data:
                    if off <= self.max_off.get(p, -1):
                        dup += t >= t0  # повтор после падения: offset ещё не был зафиксирован
                        continue
                    self.max_off[p] = off
                    if t0 <= t <= t1:
                        pause[p] = max(pause[p], t - ts / 1000)
                continue
            if not t0 <= t <= t1:
                continue
            cb_times.append(t)
            if kind == "revoke":
                revoked += len(data)
                revokers.add(name)
            elif kind == "lost":
                lost += len(data)
        stalled = {p: v for p, v in pause.items() if v > STALL}
        return {
            "stalled": len(stalled),
            "max_pause": round(max(pause.values(), default=0.0), 2),
            "stall_sum": round(sum(stalled.values()), 1),
            "revoked": revoked,
            "revokers": len(revokers),
            "lost": lost,
            "dup": dup,
            "cb_span": round(cb_times[-1] - cb_times[0], 2) if cb_times else 0.0,
        }
Пауза при масштабировании группы
Метрика у всех вариантов одна. Пауза партиции равна максимальной задержке между записью и чтением новых сообщений в окне события, а остановленной считается партиция с паузой больше 1 с. Бенч rebalance_bench.py прогоняет пять вариантов по три повтора. Группа из четырёх участников переживает четыре события подряд. Пятый участник входит (add), он же мягко выходит через close() (leave), один участник падает по SIGKILL без возврата (crash), и ещё один падает и через секунду стартует под тем же именем (restart).
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22
"""Замер паузы в чтении при ребалансировке: eager, cooperative-sticky, static и consumer (KIP-848).

consumer_hb1s это тот же KIP-848, но группе выставлен consumer.heartbeat.interval.ms=1000
вместо брокерных 5000 мс по умолчанию.

Группа из 4 потребителей читает топик на 12 партиций под ровной нагрузкой 1200 сообщений/с.
По очереди происходят четыре события:
  add     - пятый участник входит в группу;
  leave   - он же выходит мягко, через close();
  crash   - участник убит SIGKILL и больше не возвращается;
  restart - участник убит и через секунду запущен заново под тем же именем.
Пауза партиции это максимальная задержка «прочитано минус записано» новых сообщений
в окне события. Остановленной считается партиция с паузой больше 1 с.

Запуск: python rebalance_bench.py [повторов, по умолчанию 3]
"""

import json
import statistics
import sys
import threading
import time

import producer_load
from group_member import GROUP_CONFIGS, MODES, Group, set_group_config

REPEATS = int(sys.argv[1]) if len(sys.argv) > 1 else 3
# Минимальная длина окна события: тайм-аут сессии 10 с плюс запас на ребалансировку
WINDOW = {"add": 12, "leave": 12, "crash": 20, "restart": 20}
FIELDS = ["stalled", "max_pause", "stall_sum", "revoked", "revokers", "dup", "cb_span"]


def measure(g: Group, event: str, action) -> dict:
    t0 = time.time()
    action()
    time.sleep(WINDOW[event])
    g.wait_stable(60)
    time.sleep(2)  # даём дочитать задержанные сообщения
    res = g.window(t0, time.time())
    res["took"] = round(time.time() - t0, 1)
    return res


def one_run(mode: str, run: int) -> dict:
    g = Group(f"bench-{mode}-{run}-{int(time.time())}")
    if mode in GROUP_CONFIGS:
        set_group_config(g.group, GROUP_CONFIGS[mode])
    for i in range(1, 5):
        g.start(mode, f"m{i}")
    warm = g.wait_stable(90)
    time.sleep(3)
    g.window(0, time.time())  # прогрев не считаем, только запоминаем offsets
    out = {"warmup": round(warm, 1)}

    def restart():
        g.kill("m3")
        time.sleep(1)
        g.start(mode, "m3")

    out["add"] = measure(g, "add", lambda: g.start(mode, "m5"))
    out["leave"] = measure(g, "leave", lambda: g.leave("m5"))
    out["crash"] = measure(g, "crash", lambda: g.kill("m4"))
    out["restart"] = measure(g, "restart", restart)
    g.stop_all()
    return out


def main() -> None:
    stop = threading.Event()
    threading.Thread(target=producer_load.run, args=(stop,), daemon=True).start()
    time.sleep(3)
    results = {m: [] for m in MODES}
    for mode in MODES:
        for run in range(1, REPEATS + 1):
            r = one_run(mode, run)
            results[mode].append(r)
            print(f"\n[{mode} #{run}] прогрев до стабильной группы {r['warmup']} с", flush=True)
            for ev in WINDOW:
                e = r[ev]
                print(f"  {ev:8} остановлено {e['stalled']:2}/12, макс. пауза {e['max_pause']:6.2f} с, "
                      f"сумма {e['stall_sum']:6.1f} парт.·с, отозвано {e['revoked']:2} у {e['revokers']} "
                      f"участн., повторов {e['dup']}, колбэки за {e['cb_span']} с", flush=True)
    stop.set()

    print("\n=== МЕДИАНЫ ПО", REPEATS, "ПОВТОРАМ ===")
    print(f"{'вариант':14}{'событие':9}{'останов.':>9}{'макс.пауза,с':>14}{'сумма,парт.·с':>15}"
          f"{'отозвано':>10}{'повторов':>10}")
    summary = {}
    for mode, runs in results.items():
        for ev in WINDOW:
            med = {f: statistics.median(r[ev][f] for r in runs) for f in FIELDS}
            summary[f"{mode}/{ev}"] = med
            print(f"{mode:14}{ev:9}{med['stalled']:>9}{med['max_pause']:>14.2f}{med['stall_sum']:>15.1f}"
                  f"{med['revoked']:>10}{med['dup']:>10}")
    with open("bench_results.json", "w", encoding="utf-8") as f:
        json.dump({"runs": results, "median": summary}, f, ensure_ascii=False, indent=1)
    print("сырые данные: bench_results.json")


if __name__ == "__main__":
    main()
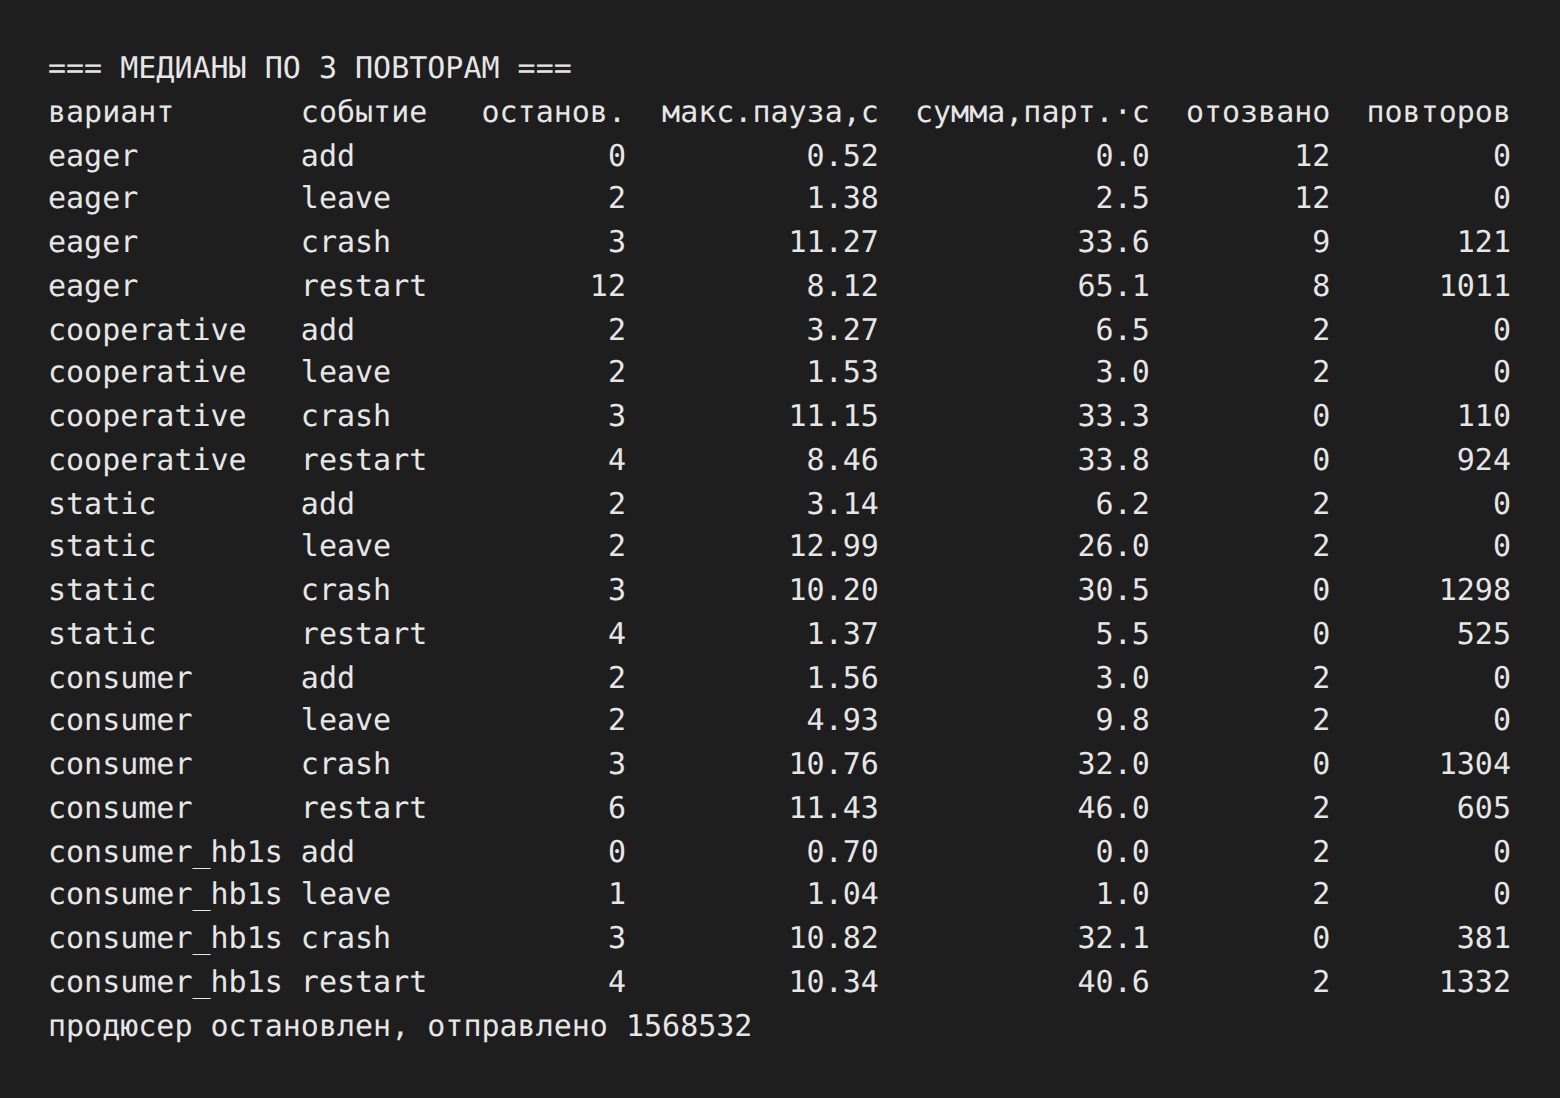
Полный бенч идёт около 25 минут. Ниже из вывода оставлены первый повтор eager, cooperative-sticky и обоих вариантов нового протокола, остальные повторы пропущены, таблица медиан приведена целиком.
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22
.venv/bin/python rebalance_bench.py 3
[eager #1] прогрев до стабильной группы 10.1 с
  add      остановлено  2/12, макс. пауза   1.01 с, сумма    2.0 парт.·с, отозвано 12 у 4 участн., повторов 0, колбэки за 0.19 с
  leave    остановлено  2/12, макс. пауза   1.38 с, сумма    2.7 парт.·с, отозвано 12 у 5 участн., повторов 0, колбэки за 1.13 с
  crash    остановлено  3/12, макс. пауза  11.39 с, сумма   33.6 парт.·с, отозвано  9 у 3 участн., повторов 121, колбэки за 0.04 с
  restart  остановлено 12/12, макс. пауза   8.19 с, сумма   65.1 парт.·с, отозвано  8 у 2 участн., повторов 1011, колбэки за 4.0 с

[... повторы eager #2 и #3 пропущены ...]

%4|1792655135.296|SESSTMOUT|m1#consumer-1| [thrd:main]: Consumer group session timed out (in join-state steady) after 10004 ms without a successful response from the group coordinator (broker 1, last error was Broker: Group rebalance in progress): revoking assignment and rejoining group
%4|1792655135.296|SESSTMOUT|m3#consumer-1| [thrd:main]: Consumer group session timed out (in join-state steady) after 10002 ms without a successful response from the group coordinator (broker 1, last error was Success): revoking assignment and rejoining group
%4|1792655135.297|SESSTMOUT|m4#consumer-1| [thrd:main]: Consumer group session timed out (in join-state steady) after 10003 ms without a successful response from the group coordinator (broker 1, last error was Success): revoking assignment and rejoining group
%4|1792655135.298|SESSTMOUT|m2#consumer-1| [thrd:main]: Consumer group session timed out (in join-state steady) after 10006 ms without a successful response from the group coordinator (broker 1, last error was Broker: Group rebalance in progress): revoking assignment and rejoining group

[cooperative #1] прогрев до стабильной группы 9.4 с
  add      остановлено  2/12, макс. пауза   3.08 с, сумма    6.1 парт.·с, отозвано  2 у 2 участн., повторов 0, колбэки за 3.02 с
  leave    остановлено 12/12, макс. пауза  21.70 с, сумма  259.2 парт.·с, отозвано  2 у 1 участн., повторов 0, колбэки за 14.82 с
  crash    остановлено  5/12, макс. пауза  10.00 с, сумма   32.0 парт.·с, отозвано  0 у 0 участн., повторов 149, колбэки за 0.0 с
  restart  остановлено  4/12, макс. пауза  10.28 с, сумма   41.0 парт.·с, отозвано  0 у 0 участн., повторов 1038, колбэки за 0.0 с

[... повторы cooperative #2 и #3 и static #1-#3 пропущены ...]

[consumer #1] прогрев до стабильной группы 13.4 с
  add      остановлено  2/12, макс. пауза   1.40 с, сумма    2.8 парт.·с, отозвано  2 у 2 участн., повторов 0, колбэки за 1.28 с
  leave    остановлено  2/12, макс. пауза   4.93 с, сумма    9.9 парт.·с, отозвано  2 у 1 участн., повторов 0, колбэки за 4.91 с
  crash    остановлено  3/12, макс. пауза  10.93 с, сумма   32.7 парт.·с, отозвано  0 у 0 участн., повторов 1241, колбэки за 0.1 с
  restart  остановлено  6/12, макс. пауза  13.88 с, сумма   55.4 парт.·с, отозвано  2 у 2 участн., повторов 563, колбэки за 10.06 с

[... повторы consumer #2 и #3 и служебная строка librdkafka пропущены ...]

[consumer_hb1s #1] прогрев до стабильной группы 5.8 с
  add      остановлено  0/12, макс. пауза   0.46 с, сумма    0.0 парт.·с, отозвано  2 у 2 участн., повторов 0, колбэки за 0.35 с
  leave    остановлено  0/12, макс. пауза   0.97 с, сумма    0.0 парт.·с, отозвано  2 у 1 участн., повторов 0, колбэки за 0.89 с
  crash    остановлено  3/12, макс. пауза  10.82 с, сумма   31.6 парт.·с, отозвано  0 у 0 участн., повторов 381, колбэки за 0.94 с
  restart  остановлено  4/12, макс. пауза  10.34 с, сумма   40.6 парт.·с, отозвано  2 у 2 участн., повторов 1332, колбэки за 8.43 с

[... повторы consumer_hb1s #2 и #3 пропущены ...]

=== МЕДИАНЫ ПО 3 ПОВТОРАМ ===
вариант       событие   останов.  макс.пауза,с  сумма,парт.·с  отозвано  повторов
eager         add              0          0.52            0.0        12         0
eager         leave            2          1.38            2.5        12         0
eager         crash            3         11.27           33.6         9       121
eager         restart         12          8.12           65.1         8      1011
cooperative   add              2          3.27            6.5         2         0
cooperative   leave            2          1.53            3.0         2         0
cooperative   crash            3         11.15           33.3         0       110
cooperative   restart          4          8.46           33.8         0       924
static        add              2          3.14            6.2         2         0
static        leave            2         12.99           26.0         2         0
static        crash            3         10.20           30.5         0      1298
static        restart          4          1.37            5.5         0       525
consumer      add              2          1.56            3.0         2         0
consumer      leave            2          4.93            9.8         2         0
consumer      crash            3         10.76           32.0         0      1304
consumer      restart          6         11.43           46.0         2       605
consumer_hb1s add              0          0.70            0.0         2         0
consumer_hb1s leave            1          1.04            1.0         2         0
consumer_hb1s crash            3         10.82           32.1         0       381
consumer_hb1s restart          4         10.34           40.6         2      1332
продюсер остановлен, отправлено 1568532
сырые данные: bench_results.json
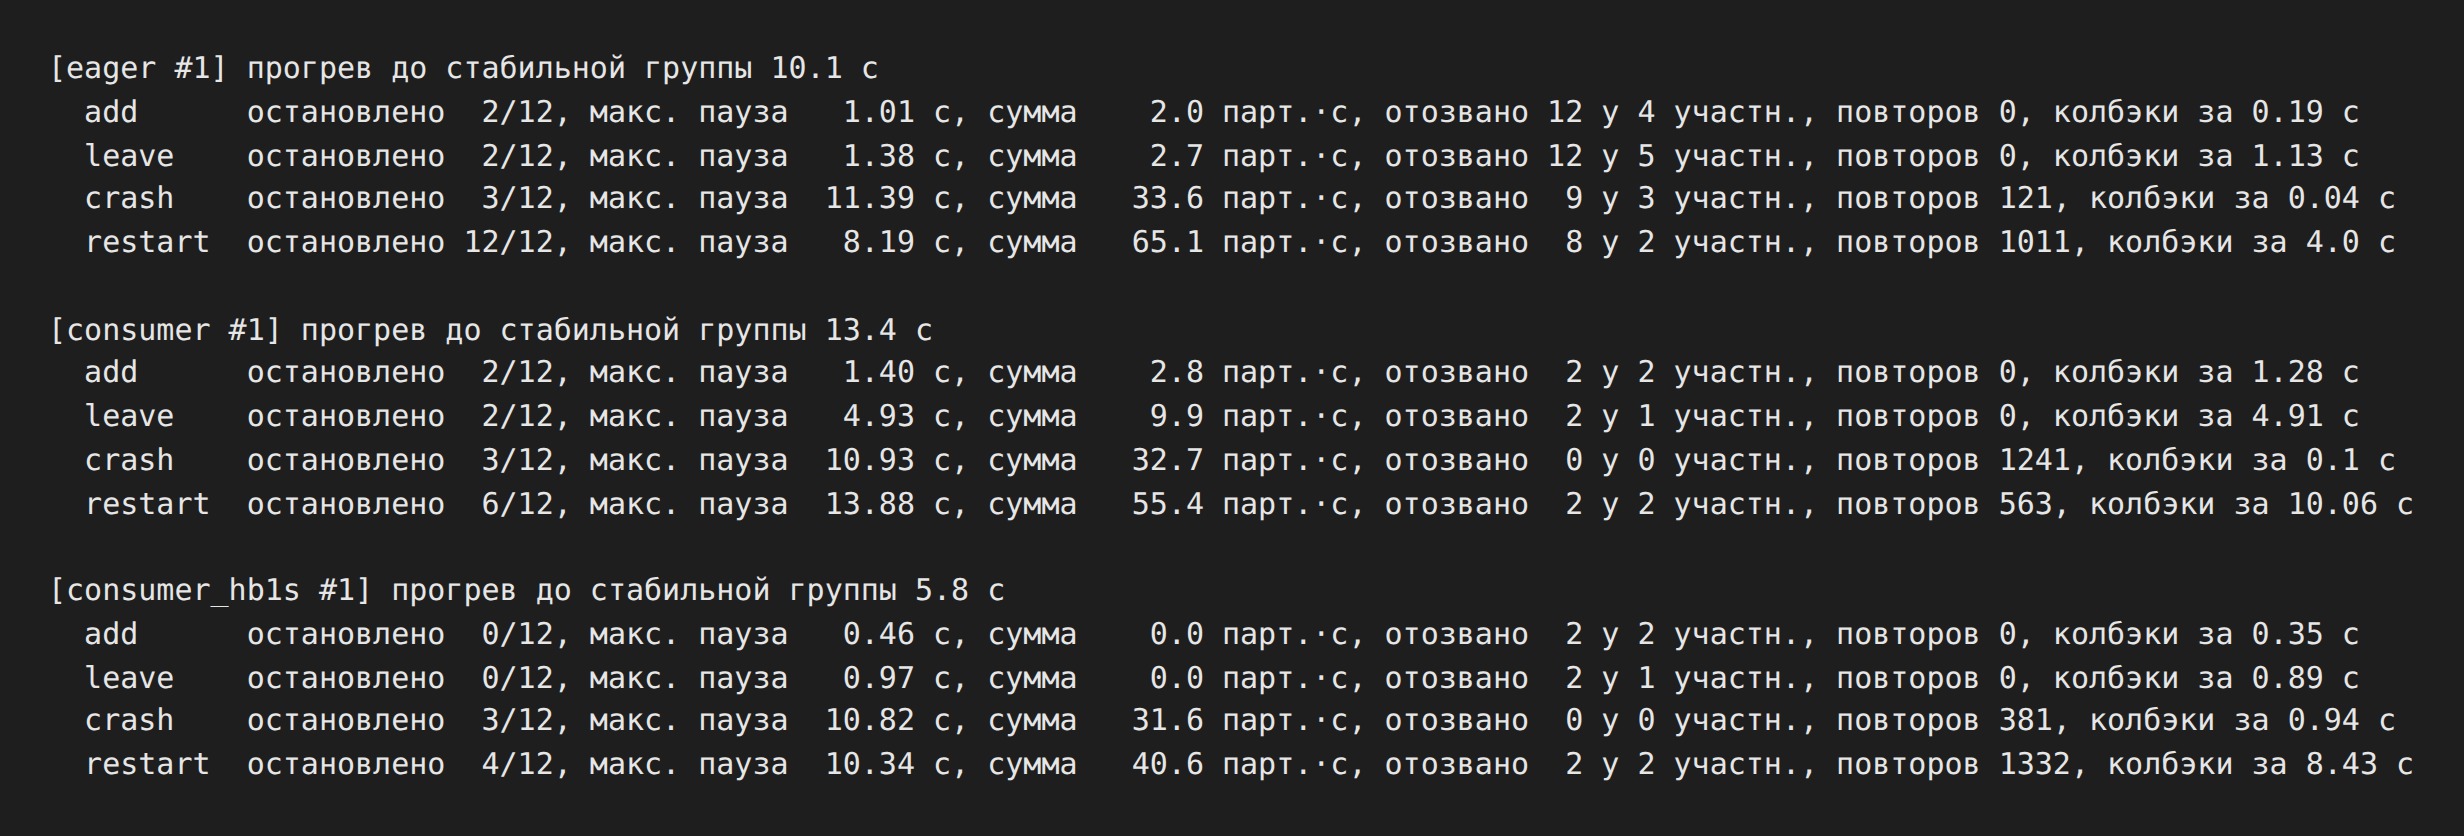
Колонка «отозвано» показывает разницу протоколов лучше всего. Eager на add и leave отбирает 12 партиций у всех участников, остальные варианты только две, которые реально переезжают. На restart у eager стоят все 12 партиций около 8 с. Убитый участник ещё числится в группе, классическая ребалансировка ждёт его JoinGroup до тайм-аута сессии, а остальные к этому моменту уже отдали свои партиции.
У нового протокола на restart стоят шесть партиций, и пауза 11.43 с хуже, чем у cooperative-sticky. Перезапущенный процесс без group.instance.id для брокера это новый участник, поэтому брокер ждёт истечения сессии старого, а потом раздаёт его партиции шагами по heartbeat. Колбэки этого события растянуты на 7.7-10.1 с. С heartbeat 1 с картина лучше лишь чуть-чуть, потому что основное время здесь съедает всё тот же тайм-аут сессии.
Прогрев группы из четырёх участников до стабильного назначения занял у classic-вариантов 9.4-10.1 с, у нового протокола с heartbeat 5 с от 8.6 до 13.8 с, с heartbeat 1 с от 4.8 до 6.0 с. Classic в начале ждёт group.initial.rebalance.delay.ms, на стенде это 3 с. В пилотном замере с одним потребителем на топике из трёх партиций classic получил первое назначение через 7.15 с, а новый протокол через 0.33 с.
Один повтор выбился из ряда. В первом прогоне cooperative-sticky на событии leave все четыре участника получили тайм-аут сессии посреди ребалансировки, это строки SESSTMOUT в выводе, и 12 партиций стояли до 21.7 с. В двух других повторах такого не было, медиана этот выброс отсекла, а причину мы на стенде не разбирали.
Миграция живой группы с classic на consumer
Брокер Kafka 4.x умеет держать в одной группе старых и новых участников. По умолчанию group.consumer.migration.policy равен bidirectional. Группа превращается в consumer-группу при входе первого участника с новым протоколом и возвращается в classic, когда уходит последний такой участник, а запросы старых клиентов брокер транслирует в новый движок. Условие одно, классическая стратегия не должна передавать собственные метаданные, и cooperative-sticky ему удовлетворяет. Скрипт migrate_group.py проверяет миграцию под нагрузкой. Группа из четырёх участников на cooperative-sticky по одному перезапускается с group.protocol=consumer, и после каждого шага печатаются тип группы и её участники.
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22
"""Онлайн-миграция живой группы с classic на consumer (KIP-848) поочерёдным перезапуском.

Группа из 4 участников classic с cooperative-sticky читает под нагрузкой. Участники по одному
выходят и возвращаются с group.protocol=consumer. После каждого шага печатаются тип группы
(kafka-groups.sh --list), участники с флагом UPGRADED и пауза в чтении на этом шаге.
Команды CLI выполняются в контейнере kafka1 через docker compose exec.

Запуск: python migrate_group.py
"""

import subprocess
import threading
import time

import producer_load
from group_member import Group


def cli(tool: str, *args: str) -> str:
    cmd = ["docker", "compose", "exec", "-T", "kafka1", f"/opt/kafka/bin/{tool}",
           "--bootstrap-server", "localhost:19092", *args]
    return subprocess.run(cmd, capture_output=True, text=True).stdout.rstrip()


def show(group: str) -> None:
    # Тип и протокол группы: Classic или Consumer
    lines = cli("kafka-groups.sh", "--list").splitlines()
    print("\n".join(ln for ln in lines if ln.startswith(("GROUP", group))))
    # Участники: у consumer-группы видно эпоху и кто уже на новом протоколе (UPGRADED)
    print(cli("kafka-consumer-groups.sh", "--describe", "--group", group, "--members", "--verbose"))


def step_report(name: str, res: dict) -> None:
    print(f"  пауза: остановлено {res['stalled']}/12, макс. {res['max_pause']} с, "
          f"сумма {res['stall_sum']} парт.·с, отозвано {res['revoked']}", flush=True)


def main() -> None:
    stop = threading.Event()
    threading.Thread(target=producer_load.run, args=(stop,), daemon=True).start()
    time.sleep(3)

    g = Group(f"migrate-{int(time.time())}")
    for i in range(1, 5):
        g.start("cooperative", f"m{i}")
    g.wait_stable(90)
    time.sleep(3)
    g.window(0, time.time())
    print("=== ШАГ 0: все четыре участника на classic, cooperative-sticky ===")
    show(g.group)

    for i in range(1, 5):
        name = f"m{i}"
        t0 = time.time()
        g.leave(name)                # мягкий выход старого клиента
        g.start("consumer", name)    # тот же код, но group.protocol=consumer
        time.sleep(12)
        g.wait_stable(60)
        time.sleep(2)
        print(f"\n=== ШАГ {i}: {name} перезапущен с group.protocol=consumer, "
              f"на новом протоколе {i} из 4 ===")
        step_report(name, g.window(t0, time.time()))
        show(g.group)

    g.stop_all()
    time.sleep(2)
    print("\n=== ПОСЛЕ ВЫХОДА ВСЕХ: пустая группа ===")
    show(g.group)
    stop.set()


if __name__ == "__main__":
    main()
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22
.venv/bin/python migrate_group.py
=== ШАГ 0: все четыре участника на classic, cooperative-sticky ===
GROUP                TYPE                 PROTOCOL
migrate-1792654657   Classic              consumer

GROUP              CONSUMER-ID                             HOST            CLIENT-ID       #PARTITIONS     CURRENT-EPOCH   CURRENT-ASSIGNMENT     TARGET-EPOCH    TARGET-ASSIGNMENT
migrate-1792654657 m2-54e7f0db-e66b-4cbe-ba55-12ebef93241a /172.18.0.1     m2              3               -               rebalance-bench:1,5,9  -               -
migrate-1792654657 m1-ed3553a4-ec43-4dc5-978d-e7f12e6dce3a /172.18.0.1     m1              3               -               rebalance-bench:0,4,8  -               -
migrate-1792654657 m4-0b0b65b2-ebd7-4de0-8b76-176b542cdcea /172.18.0.1     m4              3               -               rebalance-bench:3,7,11 -               -
migrate-1792654657 m3-89565edc-25f1-4dcc-a468-95f1c3db1702 /172.18.0.1     m3              3               -               rebalance-bench:2,6,10 -               -

=== ШАГ 1: m1 перезапущен с group.protocol=consumer, на новом протоколе 1 из 4 ===
  пауза: остановлено 5/12, макс. 1.36 с, сумма 6.7 парт.·с, отозвано 3
GROUP                TYPE                 PROTOCOL
migrate-1792654657   Consumer             consumer

GROUP              CONSUMER-ID                             HOST            CLIENT-ID       #PARTITIONS     CURRENT-EPOCH   CURRENT-ASSIGNMENT     TARGET-EPOCH    TARGET-ASSIGNMENT      UPGRADED
migrate-1792654657 m3-89565edc-25f1-4dcc-a468-95f1c3db1702 /172.18.0.1     m3              3               2               rebalance-bench:2,6,10 2               rebalance-bench:2,6,10 false
migrate-1792654657 m2-54e7f0db-e66b-4cbe-ba55-12ebef93241a /172.18.0.1     m2              3               2               rebalance-bench:1,5,9  2               rebalance-bench:1,5,9  false
migrate-1792654657 m4-0b0b65b2-ebd7-4de0-8b76-176b542cdcea /172.18.0.1     m4              3               2               rebalance-bench:3,7,11 2               rebalance-bench:3,7,11 false
migrate-1792654657 WvbgPHwTQEOnBPVgRU9YNg                  /172.18.0.1     m1              3               2               rebalance-bench:0,4,8  2               rebalance-bench:0,4,8  true

=== ШАГ 2: m2 перезапущен с group.protocol=consumer, на новом протоколе 2 из 4 ===
  пауза: остановлено 0/12, макс. 0.43 с, сумма 0 парт.·с, отозвано 3
[... тип группы и участники шага 2 пропущены ...]

=== ШАГ 3: m3 перезапущен с group.protocol=consumer, на новом протоколе 3 из 4 ===
  пауза: остановлено 0/12, макс. 0.46 с, сумма 0 парт.·с, отозвано 3
[... тип группы и участники шага 3 пропущены ...]

=== ШАГ 4: m4 перезапущен с group.protocol=consumer, на новом протоколе 4 из 4 ===
  пауза: остановлено 0/12, макс. 0.34 с, сумма 0 парт.·с, отозвано 3
GROUP                TYPE                 PROTOCOL
migrate-1792654657   Consumer             consumer

GROUP              CONSUMER-ID            HOST            CLIENT-ID       #PARTITIONS     CURRENT-EPOCH   CURRENT-ASSIGNMENT     TARGET-EPOCH    TARGET-ASSIGNMENT
migrate-1792654657 +xMBaCODR9aAVyXfvZnTaw /172.18.0.1     m4              3               8               rebalance-bench:3,7,11 8               rebalance-bench:3,7,11
migrate-1792654657 O/7XOqVUSf+uDIi0l/7D6g /172.18.0.1     m3              3               8               rebalance-bench:2,6,10 8               rebalance-bench:2,6,10
migrate-1792654657 qzkTQCZjTMah8wMKZMn/9Q /172.18.0.1     m2              3               8               rebalance-bench:1,5,9  8               rebalance-bench:1,5,9
migrate-1792654657 WvbgPHwTQEOnBPVgRU9YNg /172.18.0.1     m1              3               8               rebalance-bench:0,4,8  8               rebalance-bench:0,4,8

=== ПОСЛЕ ВЫХОДА ВСЕХ: пустая группа ===
GROUP                TYPE                 PROTOCOL
migrate-1792654657   Consumer             consumer

GROUP           CONSUMER-ID     HOST            CLIENT-ID       #PARTITIONS     CURRENT-EPOCH   CURRENT-ASSIGNMENT   TARGET-EPOCH    TARGET-ASSIGNMENT
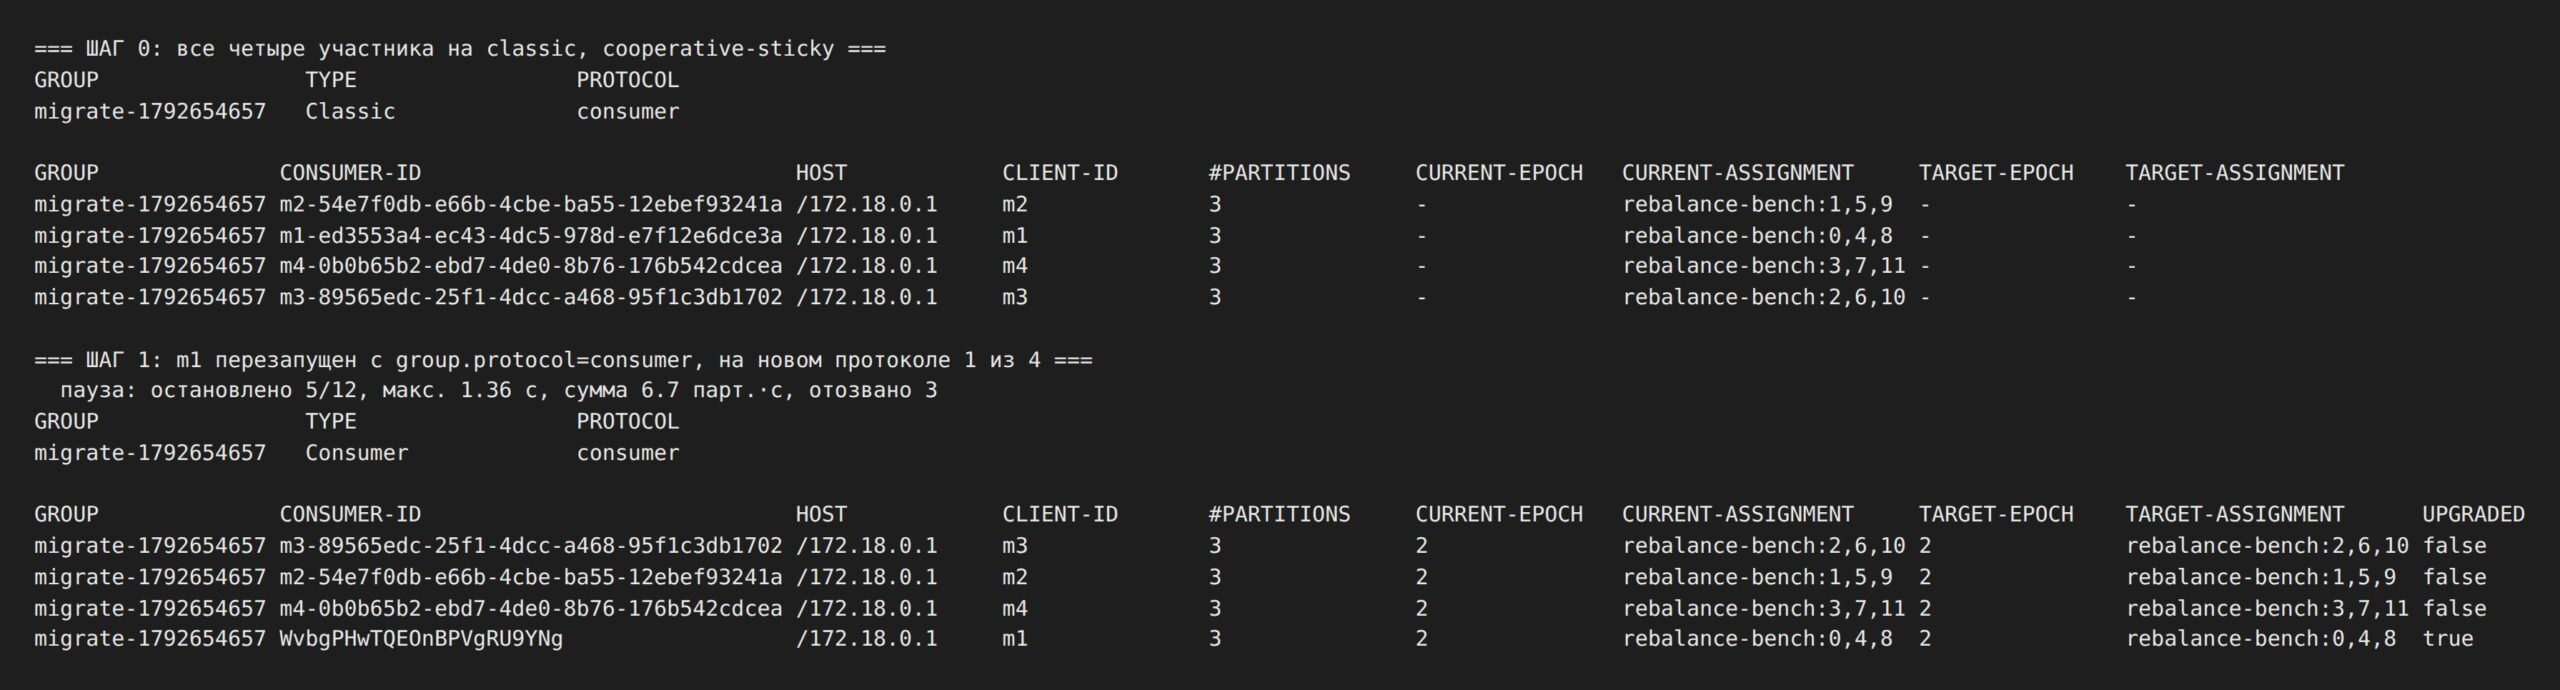
Тип группы сменился на первом же шаге. В выводе describe появились эпохи и целевое распределение, а колонка UPGRADED отмечает, кто уже работает по новому протоколу. Старые участники остались на своих партициях и получили эпоху 2, хотя сами продолжают говорить на JoinGroup и SyncGroup. Конвертация группы стоила одной заметной паузы, пять партиций простояли чуть больше секунды. На шагах 2-4 не встала ни одна партиция, худшая задержка 0.34-0.46 с. После четвёртого шага колонка UPGRADED пропала, потому что classic-участников в группе не осталось, а опустевшая группа так и осталась типа Consumer.
Одна ловушка при чтении вывода. Колонка PROTOCOL в kafka-groups.sh —list показывает consumer и у классической группы, это тип протокола группы, а не протокол ребалансировки. Смотреть нужно в колонку TYPE.
Старые настройки с новым протоколом
При миграции чаще всего забывают вычистить из конфигурации клиента параметры, которые переехали на брокер. Скрипт old_settings_trap.py создаёт потребителя с group.protocol=consumer и по очереди добавляет старые настройки, а затем повторяет два случая на Java-клиенте из образа Kafka.
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22
"""Что делает клиент со старыми настройками classic при group.protocol=consumer.

Для каждой настройки создаётся потребитель, подписывается и 8 секунд читает. Печатается,
упал ли конструктор, что пришло в error_cb и какие предупреждения написал librdkafka.
В конце то же для Java-клиента: kafka-console-consumer.sh внутри контейнера kafka1.

Запуск: python old_settings_trap.py
"""

import logging
import subprocess
import time

from confluent_kafka import Consumer, KafkaException

from producer_load import BOOTSTRAP, TOPIC, ensure_topic

CASES = [
    ("без лишних настроек", {}),
    ("session.timeout.ms=10000", {"session.timeout.ms": 10000}),
    ("heartbeat.interval.ms=1000", {"heartbeat.interval.ms": 1000}),
    ("partition.assignment.strategy=cooperative-sticky",
     {"partition.assignment.strategy": "cooperative-sticky"}),
    ("group.remote.assignor=range", {"group.remote.assignor": "range"}),
    ("group.remote.assignor=sticky (нет на брокере)", {"group.remote.assignor": "sticky"}),
]


class Collect(logging.Handler):
    """Собирает предупреждения librdkafka, которые клиент пишет в logger."""

    def __init__(self):
        super().__init__(logging.WARNING)
        self.lines = []

    def emit(self, record):
        self.lines.append(record.getMessage())


def try_python(title: str, extra: dict) -> None:
    print(f"\n--- python: {title}")
    log = logging.getLogger(f"rdkafka.{len(title)}.{time.time()}")
    handler = Collect()
    log.addHandler(handler)
    log.propagate = False
    errors = []
    conf = {"bootstrap.servers": BOOTSTRAP, "group.id": f"trap-{int(time.time() * 1000)}",
            "group.protocol": "consumer", "auto.offset.reset": "latest",
            "error_cb": lambda e: errors.append(str(e)), "logger": log, **extra}
    try:
        c = Consumer(conf)
    except KafkaException as e:
        print("  конструктор упал:", e.args[0])
        return
    assigned = []
    c.subscribe([TOPIC], on_assign=lambda _c, ps: assigned.extend(p.partition for p in ps))
    t = time.time()
    while time.time() - t < 8:
        msg = c.poll(0.2)
        if msg is not None and msg.error():
            errors.append(str(msg.error()))
    c.close()
    print(f"  назначено партиций: {len(set(assigned))}")
    for e in dict.fromkeys(errors):
        print("  ошибка:", e)
    for ln in dict.fromkeys(handler.lines):
        print("  лог:", ln[:220])


def try_java(title: str, props: list) -> None:
    print(f"\n--- java kafka-console-consumer: {title}")
    cmd = ["docker", "compose", "exec", "-T", "kafka1", "/opt/kafka/bin/kafka-console-consumer.sh",
           "--bootstrap-server", "localhost:19092", "--topic", TOPIC, "--group", f"trap-java-{int(time.time())}",
           "--timeout-ms", "6000", "--max-messages", "1", "--consumer-property", "group.protocol=consumer"]
    for p in props:
        cmd += ["--consumer-property", p]
    res = subprocess.run(cmd, capture_output=True, text=True)
    lines = [ln for ln in (res.stdout + res.stderr).splitlines()
             if any(w in ln for w in ("Exception", "ERROR", "WARN", "Processed"))]
    print(f"  код выхода {res.returncode}")
    for ln in lines[:4]:
        print("  ", ln[:220])


def main() -> None:
    ensure_topic()
    for title, extra in CASES:
        try_python(title, extra)
    try_java("session.timeout.ms=10000", ["session.timeout.ms=10000"])
    try_java("partition.assignment.strategy=CooperativeStickyAssignor",
             ["partition.assignment.strategy=org.apache.kafka.clients.consumer.CooperativeStickyAssignor"])


if __name__ == "__main__":
    main()
# confluent-kafka 2.16.0, Apache Kafka 4.3.2, прогнано на стенде 2026-10-22
.venv/bin/python old_settings_trap.py
--- python: без лишних настроек
  назначено партиций: 12

--- python: session.timeout.ms=10000
  конструктор упал: KafkaError{code=_INVALID_ARG,val=-186,str="Failed to create consumer: `session.timeout.ms` is not supported for `group.protocol=consumer` or share consumer. It is defined broker side"}

--- python: heartbeat.interval.ms=1000
  конструктор упал: KafkaError{code=_INVALID_ARG,val=-186,str="Failed to create consumer: `heartbeat.interval.ms` is not supported for `group.protocol=consumer` or share consumer. It is defined broker side"}

--- python: partition.assignment.strategy=cooperative-sticky
  конструктор упал: KafkaError{code=_INVALID_ARG,val=-186,str="Failed to create consumer: `partition.assignment.strategy` is not supported for `group.protocol=consumer`. Use `group.remote.assignor` instead"}

--- python: group.remote.assignor=range
  назначено партиций: 12

--- python: group.remote.assignor=sticky (нет на брокере)
  назначено партиций: 0
  ошибка: KafkaError{code=_FATAL,val=-150,str="Fatal error: Broker: The assignor or its version range is not supported by the consumer group: ConsumerGroupHeartbeat fatal error: Broker: The assignor or its version range is not supported by the consumer group"}
  лог: FATAL [rdkafka#consumer-4] [thrd:main]: Fatal error: Broker: The assignor or its version range is not supported by the consumer group: ConsumerGroupHeartbeat fatal error: Broker: The assignor or its version range is not

--- java kafka-console-consumer: session.timeout.ms=10000
  код выхода 1
   [2026-10-22 07:37:31,348] ERROR Unknown error when running consumer:  (org.apache.kafka.tools.consumer.ConsoleConsumer)
   org.apache.kafka.common.config.ConfigException: session.timeout.ms cannot be set when group.protocol=CONSUMER

--- java kafka-console-consumer: partition.assignment.strategy=CooperativeStickyAssignor
  код выхода 1
   [2026-10-22 07:37:33,836] ERROR Unknown error when running consumer:  (org.apache.kafka.tools.consumer.ConsoleConsumer)
   org.apache.kafka.common.config.ConfigException: partition.assignment.strategy cannot be set when group.protocol=CONSUMER
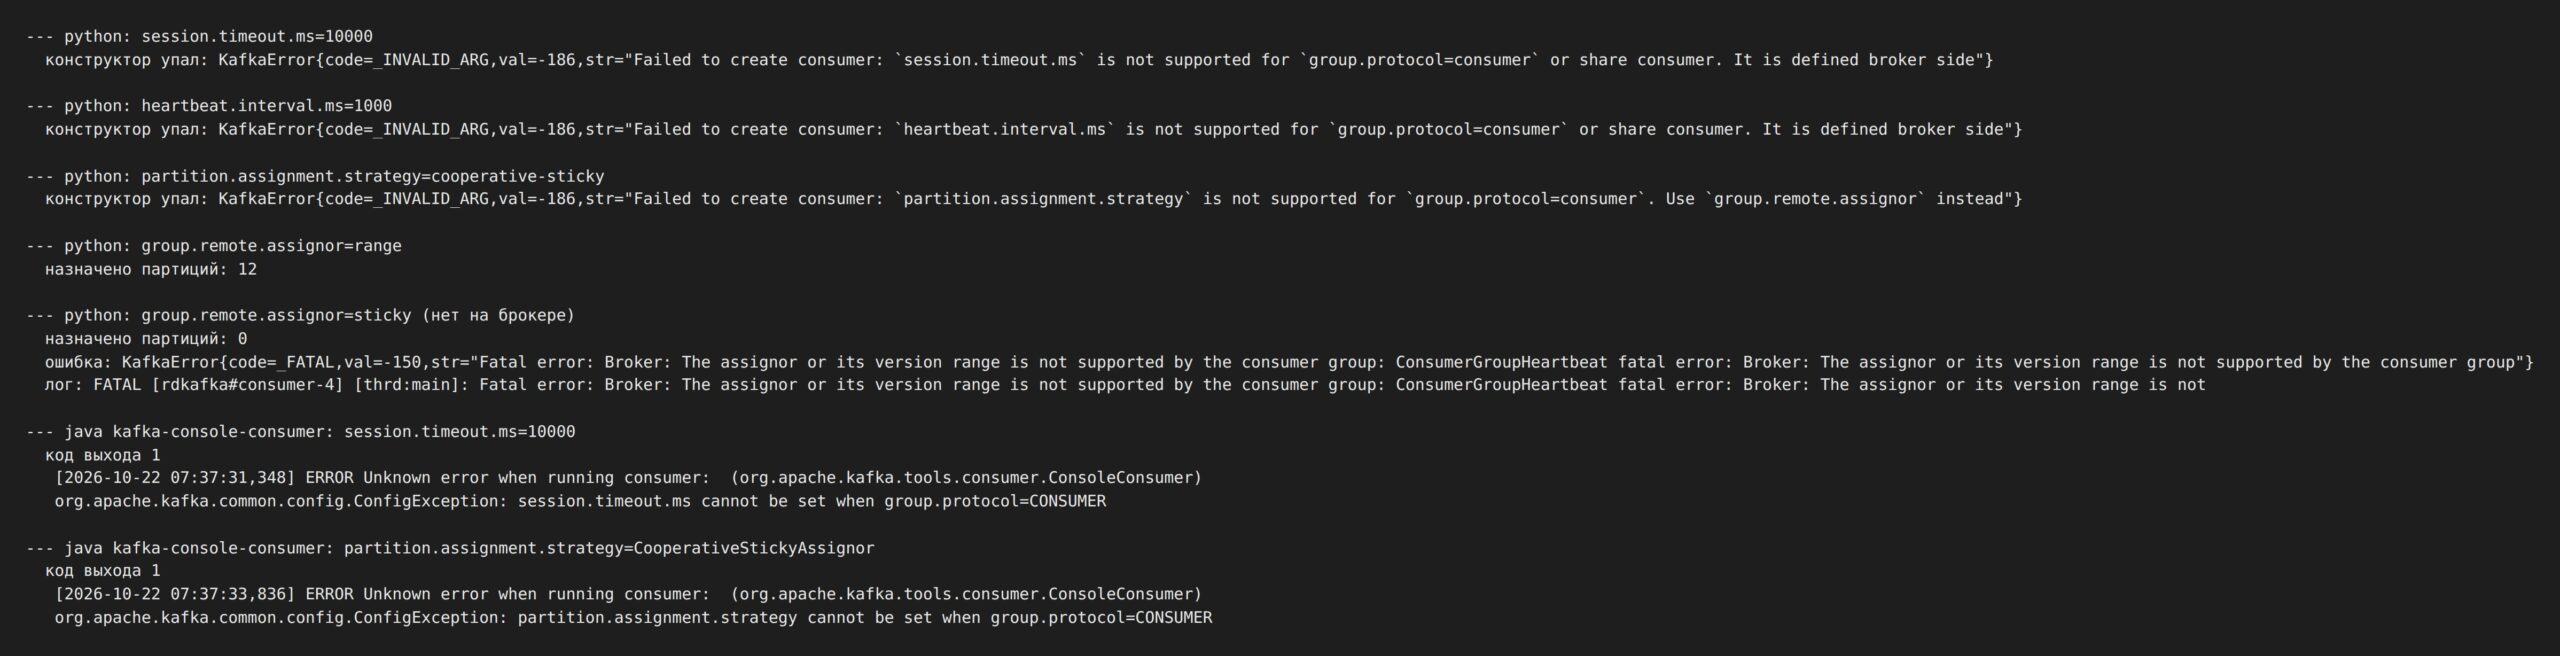
Оба клиента падают сразу и с понятным текстом. librdkafka отказывается создать потребителя и подсказывает замену для partition.assignment.strategy, Java-клиент бросает ConfigException и завершается с кодом 1. Это хорошая новость, потому что ошибку видно на первом же деплое. Хуже с group.remote.assignor, указывающим на стратегию, которой нет на брокере. Конструктор проходит, клиент подписывается, а через heartbeat получает фатальную ошибку и не читает ни одной партиции. Такую опечатку видно только в логах, поэтому значение стоит сверять со списком group.consumer.assignors брокера.
Ограничения и подводные камни
Часть ограничений описана в документации, часть всплыла на стенде.
- Тайм-аут сессии на брокере. По умолчанию он 45 с, и ниже без правки конфигурации брокера его не опустить, потому что нижняя граница тоже 45 с. Без этой правки падение участника стоит 45 с простоя его партиций.
- Шаг heartbeat. Согласование назначения (reconciliation), то есть схождение участника к целевому набору партиций, идёт по heartbeat, и с интервалом по умолчанию 5 с выход участника и прогрев группы по медиане медленнее, чем у cooperative-sticky.
- Только серверные стратегии. Клиентские стратегии не поддерживаются (KAFKA-18327), распределение с учётом стоек (rack-aware) поддержано не полностью (KAFKA-17747), Kafka Connect на новый протокол не переведён.
- Падения протокол не лечит. Пауза после падения равна тайм-ауту сессии, а число повторно прочитанных сообщений зависит от частоты фиксации оффсетов.
- Рестарт без статического членства. На стенде рестарт у нового протокола оказался хуже cooperative-sticky, 11.43 с и 6 партиций против 8.46 с и 4, а один повтор cooperative-sticky на выходе участника дал выброс до 21.7 с, причину которого мы не разбирали.
- Не все клиенты проверены. Поддержку KIP-848 в kafka-python и aiokafka мы не проверяли, а в тесте Instaclustr на новом протоколе встречались исключения StaleMemberEpochException, которых не было на classic.
Ни одно из ограничений не мешает переходу, но первые два надо закладывать в конфигурацию брокера заранее.
Apache Kafka: администрирование кластера
Код курса
KAFKA
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Когда переходить на новый протокол
Переходить стоит, когда группа большая, часто масштабируется или в ней встречаются медленные участники, которые в classic держат всю группу на барьере. Миграция проходит поочерёдным перезапуском, и на стенде заметная пауза была только на первом шаге, 5 из 12 партиций стояли 1.36 с. Откат обратно документация поддерживает той же политикой bidirectional, на стенде мы его не проверяли. Перед переходом стоит опустить брокерные тайм-аут сессии и интервал heartbeat до значений, к которым привыкли ваши classic-клиенты, иначе на мягком выходе и падении станет хуже, чем было. Если основная боль в рестартах подов при деплое, статическое членство в classic пока даёт лучший результат, 1.37 с против 10-11 с. Тем, кто только знакомится с группами потребителей и их настройкой в коде, пригодится курс Apache Kafka для разработчиков.
Заключение
KIP-848 убирает барьер и переносит распределение партиций на брокер, и в Kafka 4.x это рабочий протокол с онлайн-миграцией. Стенд показал, что выигрыш зависит от брокерных таймингов. С heartbeat 1 с новый протокол на входе участника не останавливает партиций и лучший на выходе, а с настройками по умолчанию он проигрывает cooperative-sticky на выходе. Падение и рестарт по-прежнему упираются в тайм-аут сессии, и здесь пока надёжнее статическое членство.