
Doris научился читать Lance-датасеты напрямую и выполнять векторный поиск вместе с фильтрами, join и агрегацией в одном запросе. Раньше инженерам приходилось выгружать кандидаты из отдельного векторного сервиса, переносить их в аналитическую СУБД и собирать итоговый результат вру
Команды начали терять контроль над ресурсами общего кластера Greenplum, когда тяжелые запросы стали влиять на работу всех пользователей, а закупка нового оборудования для расширения превратилась в отдельную проблему. В Лемана Тех решили разделить хранение и вычисления, перенеся с
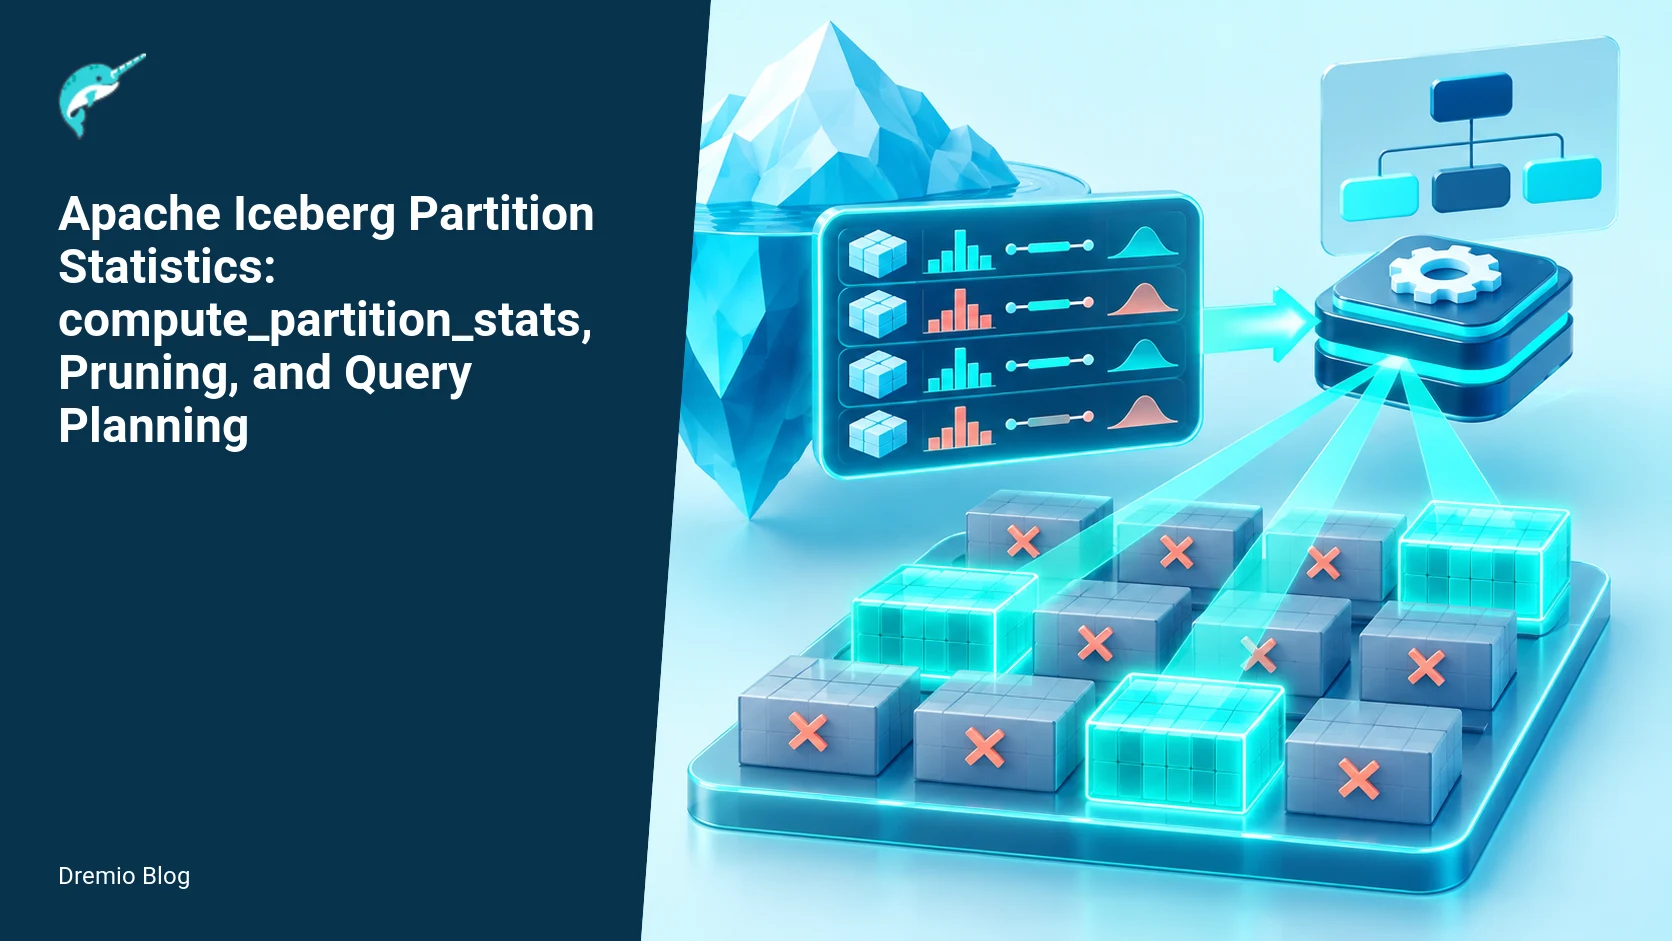
Apache Iceberg получил механизм инкрементального подсчёта статистики по партициям. Это позволяет движкам запросов точнее оценивать объём данных перед сканированием и сильнее сокращать объём чтения. Изменение особенно заметно при работе со Spark, где планировщик раньше опирался то
Apache Doris 5.0 добавил каталог Fluss, чтобы инженеры могли читать лог-таблицы и таблицы с первичным ключом напрямую. Запросы теперь совмещают свежие события из Fluss с историей, выгруженной в Paimon, без отдельного копирования. Это важно для задач, где нужно быстро сравнить тек
DuckDB представляет собой аналитическую базу данных, ориентированную на работу внутри процесса и не требующую отдельного сервера. Её интерфейс командной строки (CLI) в версии 2.0 получил специальный режим агента. Этот режим меняет формат вывода так, чтобы он лучше подходил для яз
StarTree добавила в Apache Pinot задачу Segment Purge Task, которая принимает обычный WHERE-условие и переписывает только затронутые сегменты. Это решает задачу точечного удаления событий в immutable-хранилище, где раньше приходилось либо пересобирать данные снаружи, либо удалять
Debezium Platform теперь показывает состояние развёрнутых пайплайнов прямо в интерфейсе и выводит сообщения об ошибках без просмотра логов сервера. Инженеры получают быстрый доступ к нужным разделам документации из контекста текущей страницы и могут выгружать готовую конфигурацию
Вторая часть разбора Arenadata о пути сообщения в Apache Kafka от send() до фиксации оффсета задевает тему, которую обзоры чтения обычно проходят мимоходом, а именно протокол ребалансировки групп потребителей Kafka (Kafka consumer rebalance protocol). В Kafka 4.0 у классического протокола появился преемник по KIP-848, где партиции раздаёт брокер, а...
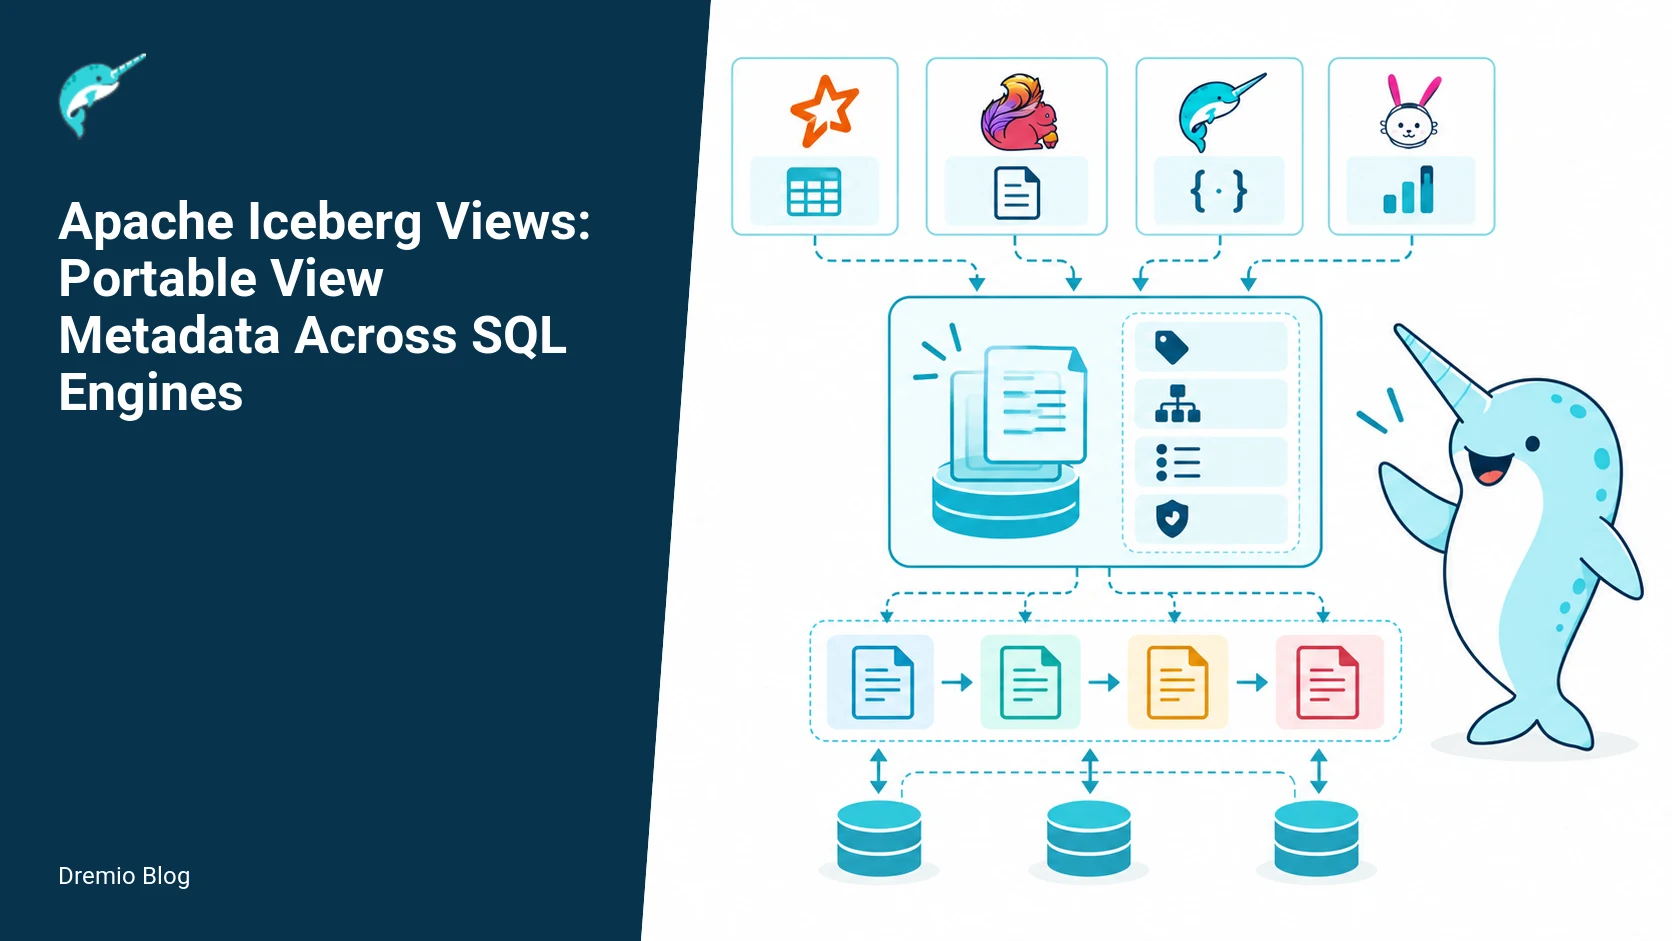
Apache Iceberg добавил в спецификацию поддержку представлений с хранением метаданных прямо в каталоге. Теперь SQL-запрос, схема, версии и зависимости описываются один раз и становятся доступны разным движкам без пересоздания. Это решает задачу совместного использования views в Sp
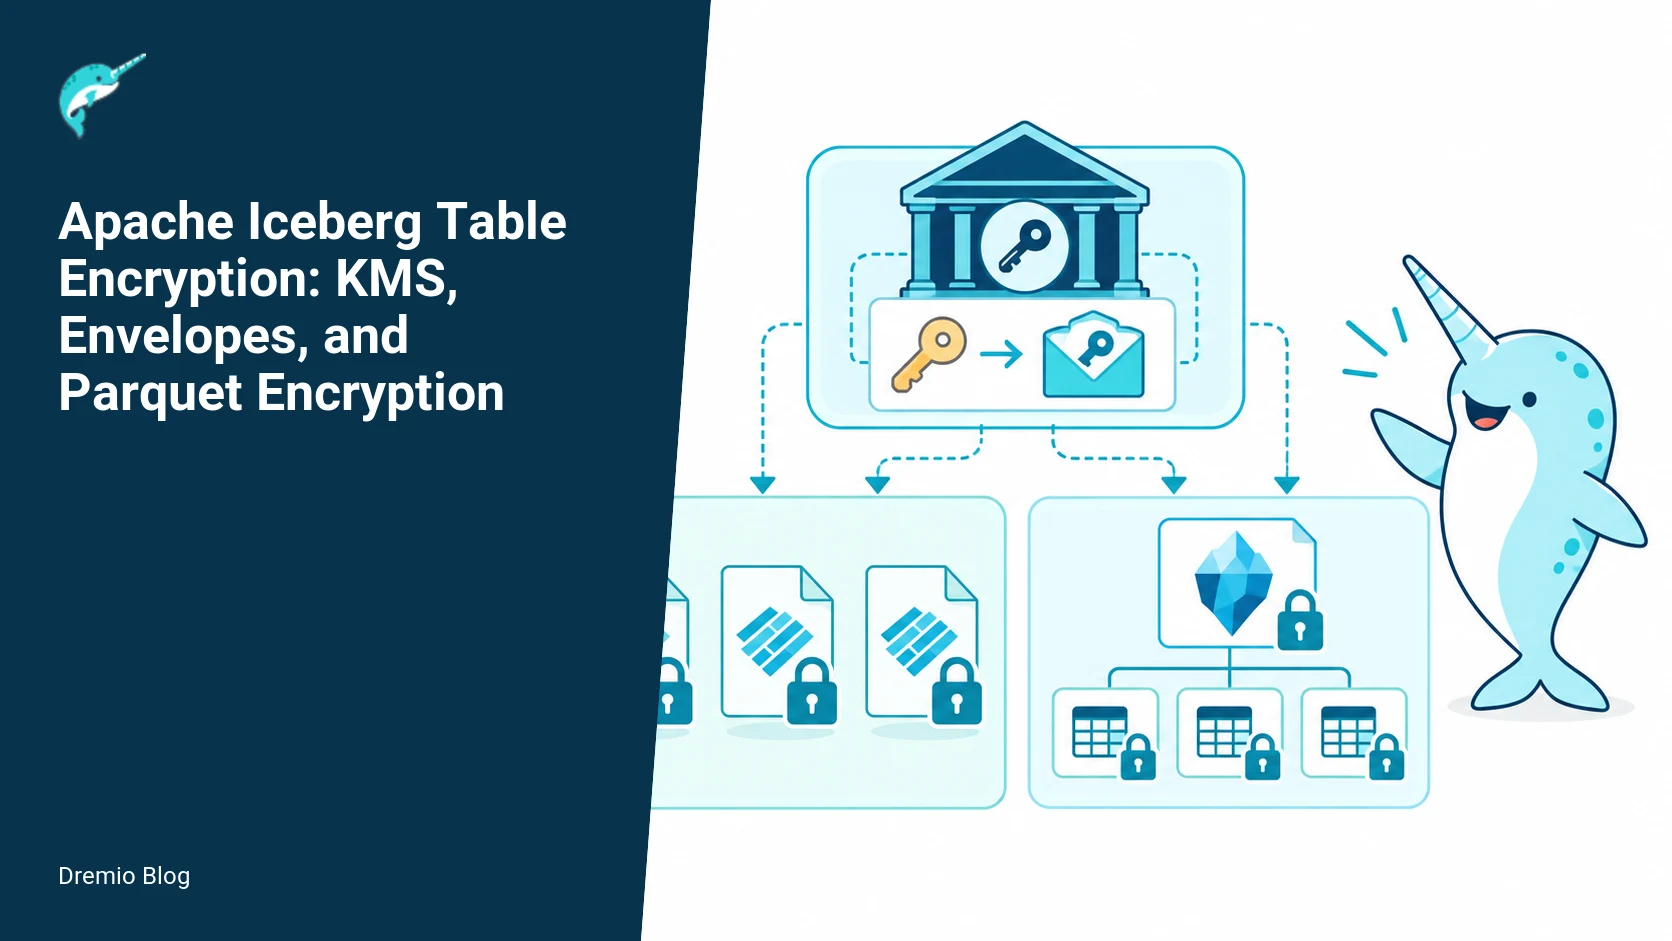
Dremio описала механизм шифрования таблиц Apache Iceberg на основе конвертного шифрования и модульного шифрования Parquet. Подход позволяет защитить данные на уровне таблицы без изменения прикладного кода. Для инженеров это означает возможность встраивать шифрование в существующи
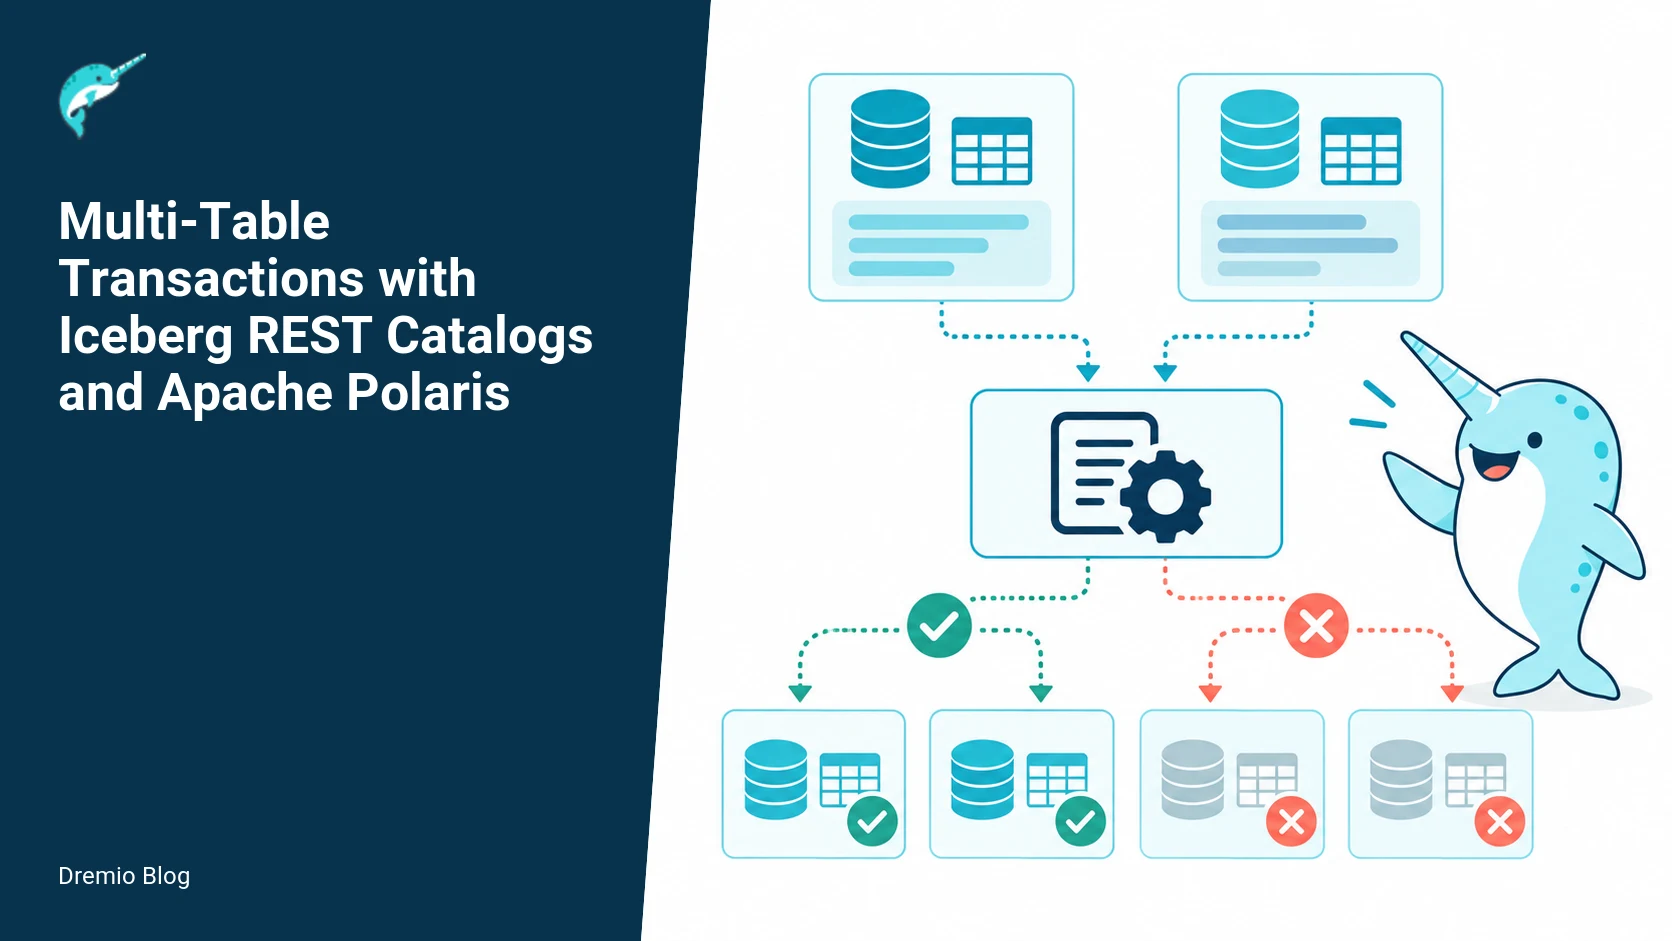
Dremio описал механизм многотабличных коммитов в Iceberg REST Catalog. Он позволяет менять несколько таблиц в одной атомарной операции, сохраняя一致ность данных при параллельной работе. Это важно для пайплайнов, где обновление фактов и измерений должно происходить без частичных сос
DuckDB начиная с версии 0.10.3 умеет обращаться к датасетам на Hugging Face Hub по схеме hf:// и выполнять запросы без предварительной загрузки файлов на диск. Интеграция построена поверх расширения httpfs и позволяет работать с CSV, JSONL и Parquet прямо в репозиториях, где данн
Dragonfly перешел с BSL 1.1 на новую source-available лицензию начиная с версии 2.1. BSL 1.1 - это Business Source License, которая раньше позволяла свободное использование с отложенным переходом в полностью открытый код. Теперь бесплатное использование в продакшене ограничено 10
JetBrains добавила в DataGrip возможность выполнять один SQL-запрос сразу по нескольким подключениям. Вместо разработки собственного движка кросс-базовых запросов команда встроила DuckDB и передала ему выполнение через собственные табличные функции. Такое решение позволило получи
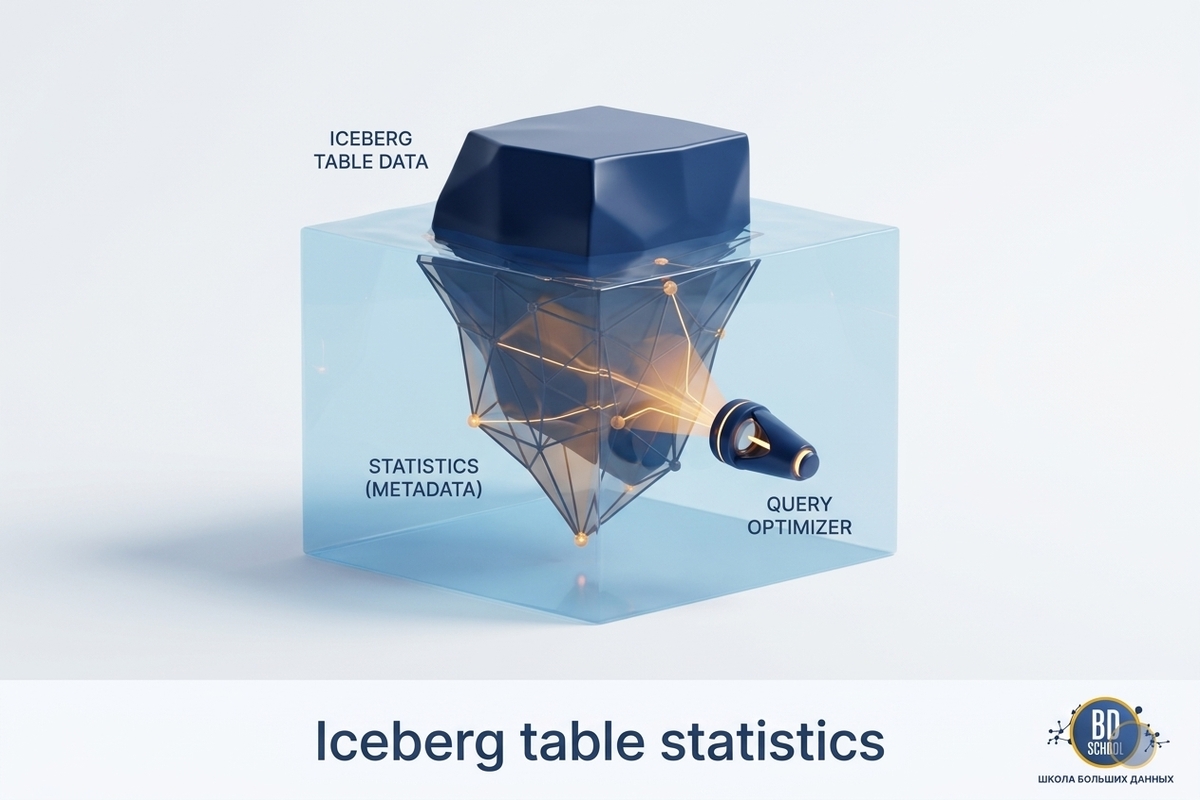
12 октября 2026 года в блоге Dremio, компании-разработчика lakehouse-платформы поверх Apache Iceberg, вышел обзор того, как устроена статистика таблиц Iceberg (Iceberg table statistics) и почему оптимизатор запросов без неё работает вслепую. Обзор перечисляет виды статистики, но оставляет за кадром три практических вопроса. Кто именно пишет число уникальных значений колонки...
В июле 2026 года в сообществе Apache Iceberg рассмотрели предложение добавить Vortex как четвертый формат данных. Автор разбил заявку на критерии и описание кандидата, чтобы сначала договориться о правилах, а потом обсуждать конкретный формат. Это важно потому, что любое расширен
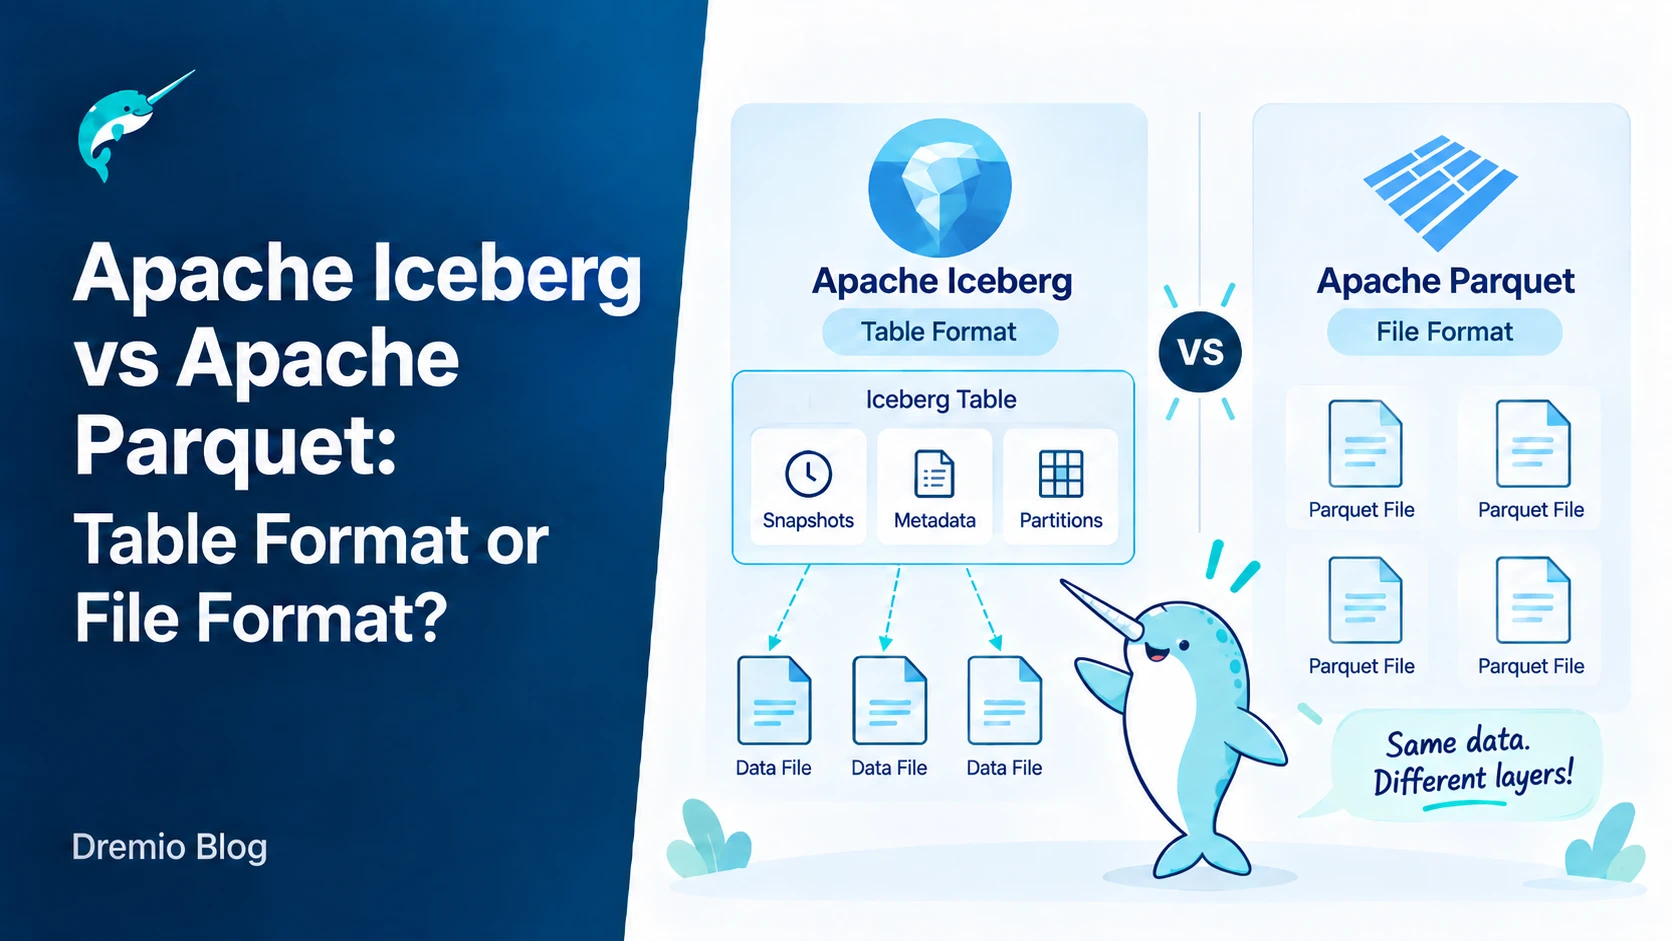
Dremio напомнила, что Apache Iceberg и Apache Parquet относятся к разным уровням стека и не конкурируют между собой. Iceberg описывает структуру таблицы, метаданные и правила доступа, а Parquet хранит сами данные в колонковом виде. Без понимания этой разницы инженеры часто выбира
Автор интегрировал колоночный движок MergeTree напрямую в PostgreSQL через table access method. Table access method - это интерфейс PostgreSQL, который позволяет подменять способ хранения и чтения данных в таблицах без изменения ядра СУБД. Решение работает на ванильном ядре 19 ве
Apache Kafka 4.4.0 вышла с 25 KIP и почти тысячей коммитов. Релиз добавляет поддержку dead-letter очередей для share-групп, новые метрики Linux I/O через JMX и механизм отложенной загрузки в tiered storage. Эти изменения влияют на мониторинг, обработку ошибок и затраты на хранени
GroeneAI - автономный агент на базе ИИ, который с марта 2026 года внёс в ClickHouse более трёх тысяч merged pull requests. Он сам выбирает задачи из результатов CI и fuzzing-отчётов, воспроизводит сбои, пишет исправления, запускает тесты и ведёт pull request до слияния. Такой под