 61
Содержание
- Архитектура регламента и классификация уровней риска
- Системы неприемлемого риска
- Системы высокого риска и обязательная сертификация
- Ограниченный и минимальный риск
- Принципы работы и требования к данным и архитектуре
- Data Governance и контроль смещения датасетов
- Регулирование базовых моделей и архитектур GPAI
- Сценарии использования ИИ в рамках новых строгих ограничений
- Инженерная адаптация Подготовка готового продукта к релизу
- Логирование MLOps и детальная техническая документация
- Заключение
- Референсы
AI Act — является комплексным нормативным регламентом Европейского союза. Данный документ формирует строгие правовые рамки. Эти рамки предназначены для безопасной разработки интеллектуальных систем. Закон полностью опирается на жесткий риск-ориентированный подход. Законодатели устанавливают прямую зависимость между потенциальной угрозой и техническими требованиями. Угроза оценивается с точки зрения безопасности обычных граждан. Строгость требований напрямую влияет на прозрачность разрабатываемых ML-моделей. Также предельно жестко регламентируется исходное качество обучающих датасетов. Внедрение документа фундаментально меняет процессы создания программного обеспечения. Инженеры обязаны учитывать строгие юридические ограничения на этапе проектирования.
Переход к новым стандартам требует полного пересмотра классических парадигм программирования. Разработчики должны интегрировать механизмы контроля прямо в исходный код. Таким образом, технический долг теперь включает серьезные юридические риски. Компании вынуждены экстренно адаптировать свои конвейеры доставки новых фич. Как следствие, возникает совершенно новая дисциплина на стыке технологий. Специалисты по работе с данными становятся ключевыми фигурами контроля. Они гарантируют отсутствие алгоритмической предвзятости в конечных продуктах. В результате отрасль переходит на качественно новый уровень технической зрелости.
Данный регламент вводит понятие презумпции опасности алгоритма. Каждая новая модель изначально считается потенциально вредоносной для пользователя. Инженерная команда обязана доказать обратное через серию строгих тестов. Процесс доказательства требует сохранения абсолютно всех промежуточных артефактов обучения. Следовательно, потребность в надежных хранилищах метаданных возрастает многократно. Инфраструктура проекта должна поддерживать тотальное версионирование информационных массивов. Любая неконтролируемая мутация данных внутри конвейера считается критическим инцидентом. Поэтому внедрение иммутабельных структур данных становится индустриальным стандартом.
Архитектура регламента и классификация уровней риска
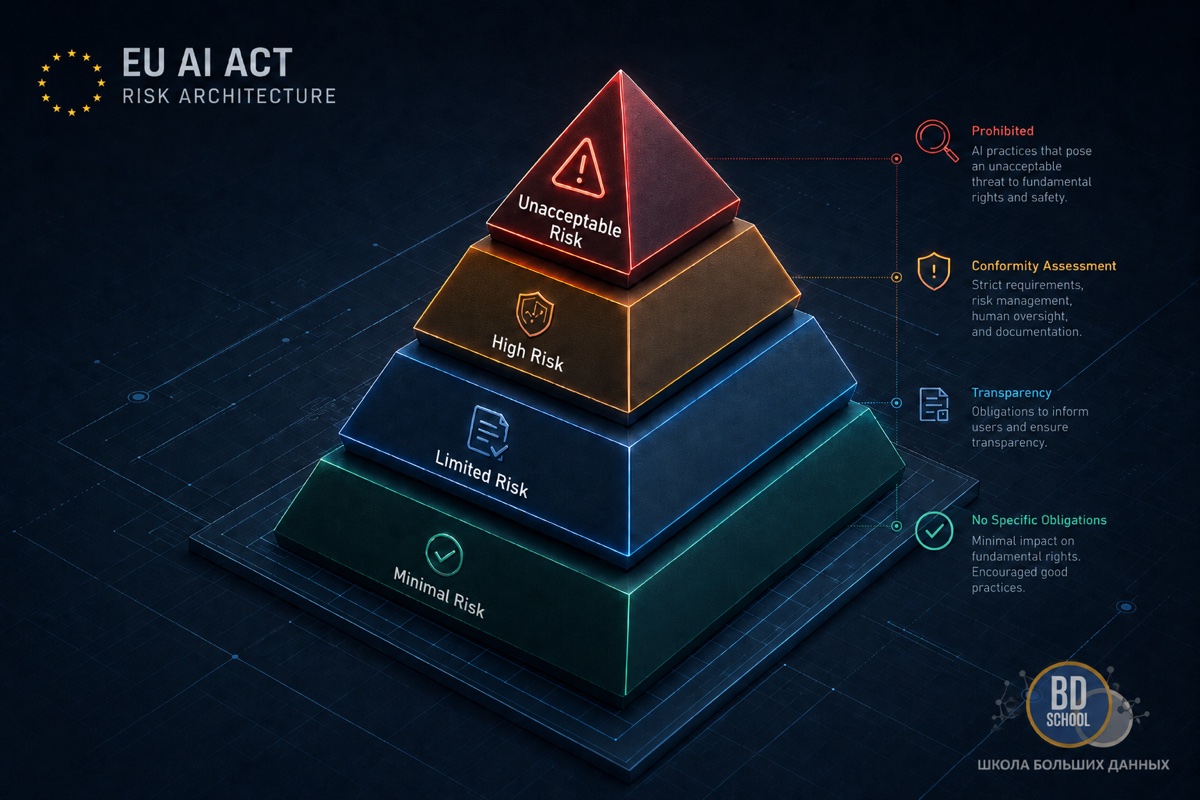
Европейский закон классифицирует алгоритмические продукты по степени алгоритмической опасности. Данная градация предельно жестко определяет объем последующих инженерных задач. Чем выше риск, тем сложнее процесс сертификации программного продукта. Законодательство четко выделяет четыре основные категории риска. Каждая категория требует специфического подхода к тестированию исходного кода. Разработчики должны интегрировать эти уровни в жесткие корпоративные стандарты. Системы оценки рисков должны работать полностью автоматически. Интеграция таких проверок в CI/CD пайплайны является критически важной. Следовательно, архитекторам необходимо закладывать избыточность проверяющих систем.
Определение уровня риска происходит на этапе сбора бизнес-требований. Технические руководители проектов обязаны заполнять специализированные опросники. На основе этих ответов формируется первичная правовая оценка архитектуры. Ошибка на этом этапе приводит к катастрофическим финансовым потерям. Неправильно классифицированный продукт может быть принудительно удален с рынка. Кроме того, регулятор имеет право выписать огромный оборотный штраф. Таким образом, юридический анализ становится первым шагом разработки. Разработчики больше не могут писать код без утвержденного правового статуса.
Системы неприемлемого риска
Регламент полностью и безоговорочно запрещает развертывание определенных категорий алгоритмов. К ним относятся системы массового социального скоринга граждан. Под строгий запрет попадают алгоритмы скрытого когнитивного манипулирования людьми. Запрещена предиктивная полиция на основе глубокого профилирования личности. Разработка подобных систем на территории Евросоюза является уголовным преступлением. Компании обязаны немедленно удалять такие модули из своих продуктов. Использование биометрической идентификации в реальном времени предельно строго ограничено. Исключения составляют только узкие специфические задачи национальной безопасности.
Инженерам необходимо аппаратно исключать подобные функции из вычислительных пайплайнов. Наличие таких модулей в кодовой базе приведет к блокировке продукта. Код для распознавания эмоций на рабочем месте подлежит физическому удалению. Разработчики обязаны проводить глубокий статический аудит устаревших систем. Следовательно, весь легаси-код требует срочного и вдумчивого рефакторинга. Любые попытки скрыть запрещенный функционал легко выявляются при аудите. В результате архитектура должна быть максимально прозрачной для внешних инспекторов. Использование запутанной логики будет расценено как попытка преднамеренного обмана.
Системы высокого риска и обязательная сертификация
Эта категория охватывает сложные продукты для физической критической инфраструктуры. Сюда входят медицинские устройства и продвинутые автоматизированные системы рекрутинга. Алгоритмы оценки кредитоспособности физических лиц также относятся к высокому риску. Системы управления биометрическими данными логично попадают в эту же группу. К данным программным продуктам предъявляются самые жесткие технические требования. Разработчики обязаны внедрять высоконадежные системы управления операционными рисками. Необходимо вести детальную техническую документацию в автоматическом режиме. Требуется непрерывное логирование всех этапов инференса используемой модели.
Человеческий контроль является абсолютно обязательным условием штатной промышленной эксплуатации. Модели должны демонстрировать экстремально высокую устойчивость к направленным кибератакам. Алгоритмы автоматической фильтрации резюме должны проходить регулярный статистический аудит. Необходимо внедрять продвинутые системы отслеживания качества входных сырых данных. Процесс финальной сертификации таких продуктов занимает значительное рабочее время. Развертывание требует использования высоконадежных операционных систем. Использование серверных дистрибутивов вроде Ubuntu 24.04 является надежным стандартом. Это гарантирует приемлемый базовый уровень безопасности среды исполнения алгоритмов.
Для наглядности принципы градации сведены в аналитическую структуру.
| Уровень риска | Степень регулирования | Инженерные требования | Пример использования |
|---|---|---|---|
| Неприемлемый | Полный запрет | Остановка разработки | Социальный рейтинг |
| Высокий | Строгий контроль | Сертификация и аудит | Модули HR-скрининга |
| Ограниченный | Средний уровень | Маркировка контента | Чат-боты поддержки |
| Минимальный | Отсутствие контроля | Базовые практики | Игровые алгоритмы |
Ограниченный и минимальный риск
Большинство современных массовых коммерческих приложений относятся к минимальному риску. Спам-фильтры и базовые рекомендательные системы не требуют сложной дорогостоящей сертификации. Системы ограниченного риска требуют лишь обеспечения прозрачности взаимодействия. Конечный пользователь должен абсолютно точно знать о факте общения с машиной. Разработчики обязаны аппаратно маркировать сгенерированный контент специальными невидимыми метаданными. К таким гибридным системам относятся чат-боты и современные генераторы изображений. Техническая реализация маркировки часто опирается на криптографические стандарты водяных знаков.
Архитектура такого приложения при этом усложняется весьма незначительно. Инженерам достаточно добавить модуль внедрения скрытых сигнатур в выходные файлы. Нагрузка на центральные вычислительные ресурсы сервера возрастает крайне минимально. Интеграция таких модулей защиты происходит исключительно на этапе постобработки данных. Таким образом, базовая математическая логика работы нейронной сети остается неизменной. Как следствие, адаптация существующих продуктов под этот уровень проходит быстро. Затраты на рефакторинг в этом случае остаются в разумных пределах.
Принципы работы и требования к данным и архитектуре
Новый закон уделяет поистине огромное внимание качеству обучающих информационных выборок. Плохие входные данные генерируют ошибочные и высоко дискриминационные предсказания. Инженерия данных становится самым главным фундаментом юридического комплаенса компании. Разработчики должны строго контролировать весь жизненный цикл используемых датасетов. Требуется внедрение надежных систем версионирования для каждого цифрового набора данных. Архитектура хранилищ должна поддерживать экстремально быстрый поиск исторических записей. Как следствие, правильный выбор СУБД становится самым критическим фактором успеха.
Машинное обучение больше не может опираться на неструктурированные файловые свалки. Каждая запись в базе должна иметь четко определенное происхождение. Инженеры внедряют строгие схемы валидации при загрузке новых батчей информации. Использование JSON схем позволяет отсеивать битые записи на этапе ingestion. Отклоненные данные помещаются в отдельный карантинный пул для ручного анализа. Таким образом, гарантируется исключительная чистота обучающей выборки для алгоритма. Только чистые данные позволяют построить надежную и справедливую модель.
Data Governance и контроль смещения датасетов
Процессы управления корпоративными данными требуют крайне строгой инженерной регламентации. Архитекторы баз данных должны обеспечивать полную прослеживаемость каждого отдельного атрибута. Необходим регулярный автоматический машинный аудит обучающих наборов на предмет смещений. Для выполнения этих строгих условий внедряются специализированные корпоративные инженерные практики. Эти надежные практики формируют максимально отказоустойчивый пайплайн обработки поступающей информации.
Данные практики включают следующие ключевые элементы инфраструктурного контроля.
- Проверка репрезентативности. Датасеты должны точно отражать реальное физическое распределение целевых групп пользователей.
- Изоляция выборок. Тестовые данные всегда физически строго отделяются от обучающих информационных массивов.
- Контроль версий. Использование специализированных объектных хранилищ гарантирует абсолютную воспроизводимость процесса обучения модели.
Внедрение данных жестких стандартов позволяет командам минимизировать юридические риски на ранних этапах.
Пайплайны обработки сырых данных требуют высоконадежных масштабируемых инструментов маршрутизации. Apache Kafka часто выступает центральной шиной обмена миллиардами сырых логов. Этот надежный инструмент обеспечивает гарантированную доставку критических событий внутреннего аудита. Использование кластеров Kafka гарантирует строгую неизменяемость всей истории системных транзакций. Это крайне важное условие для успешного прохождения внешней независимой сертификации. События записываются в распределенные партиции с настроенным высоким фактором репликации.
Потеря важных данных при физическом сбое отдельного брокера полностью исключается. Инженеры настраивают строгие внутренние политики удержания данных в топиках. Следовательно, система всегда хранит полный исторический контекст принятия алгоритмических решений. Потребители логов асинхронно вычитывают огромные батчи для последующего статистического анализа. Оркестрация процессов очистки поступающих данных выполняется через платформу Apache Airflow. DAG-скрипты позволяют легко автоматизировать сверхсложные проверки качества поступающих датасетов.
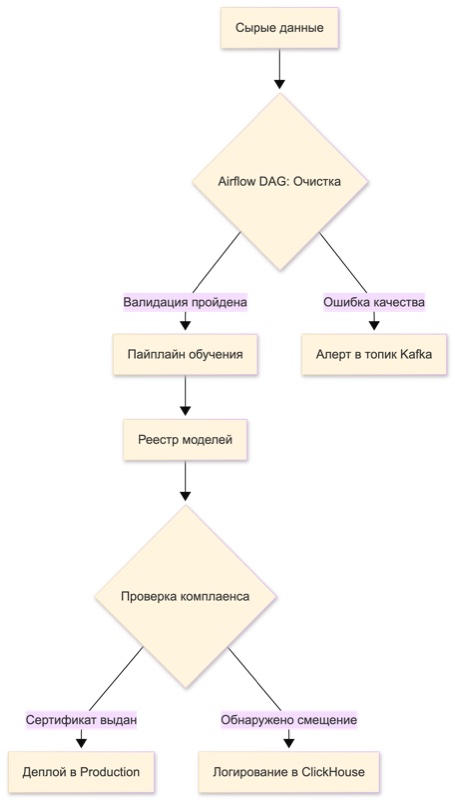
Архитекторы настраивают кастомные Airflow сенсоры для контроля резких статистических аномалий. При обнаружении значительных отклонений Airflow мгновенно полностью блокирует дальнейшее обучение. Предотвращается случайное фатальное попадание некачественных данных в production-среду алгоритма. Кроме того, инструмент централизованно управляет процессами автоматической ретренировки устаревших алгоритмов. Обеспечивается полная прозрачность и детерминированная повторяемость жизненного цикла ML-модели. В результате эффективно автоматизируется самая неприятная рутинная часть комплаенс-контроля.
Регулирование базовых моделей и архитектур GPAI
Аббревиатура GPAI обозначает сложные системы искусственного интеллекта широкого общего назначения. К ним относятся все современные сверхбольшие языковые модели и трансформеры. Регламент вводит отдельные крайне жесткие требования для создателей таких архитектур. Разработчики систем GPAI обязаны публиковать весьма подробные публичные технические отчеты. Они должны честно раскрывать суммарные вычислительные мощности процесса первоначального аппаратного обучения. Также требуется детальное формальное техническое описание используемой архитектуры нейронной сети.
Если математическая модель несет системные риски, регуляторные требования многократно ужесточаются. Системный риск всегда четко определяется огромным суммарным объемом вычислений при тренировке. Базовые модели всегда обучаются на гигантских объемах сырой неструктурированной информации. Это постоянно и неизбежно создает проблемы с соблюдением легальных авторских прав. Закон прямо жестко требует внедрения эффективных механизмов фильтрации обучающего текстового контента. Разработчики должны предоставить правообладателям надежные программные инструменты отказа от участия.
Внедрение таких блокирующих механизмов требует серьезной инженерной перестройки процессов веб-краулинга. Роботы-сборщики обязаны строго уважать директивы запрета парсинга на сканируемых сайтах. Оценка остаточных рисков требует обязательного создания независимых выделенных команд безопасности. Эти команды непрерывно атакуют собственную модель для выявления скрытых критических уязвимостей. В результате первичная разработка базовых моделей становится крайне дорогим инженерным процессом. Таким образом, финансовый порог входа на этот перспективный рынок существенно повышается.
Сценарии использования ИИ в рамках новых строгих ограничений
Разработка современного корпоративного программного обеспечения требует внедрения совершенно новых подходов. Рассмотрим типовой процесс создания системы автоматического скорингового анализа резюме кандидатов. Этот программный HR-продукт по закону однозначно классифицируется как система высокого риска. Сначала инженеры собирают огромные массивы неразмеченных исторических данных корпоративного найма. Затем дата-сайентисты программно жестко удаляют скрытые атрибуты пола, расы и возраста.
Это упреждающее действие кардинально снижает риск алгоритмической дискриминации потенциальных хороших кандидатов. После этого базовая ML-модель обучается исключительно на полностью очищенном наборе данных. В процессе штатной повседневной работы алгоритм надежно сохраняет логи каждого решения. Опытный живой HR-специалист обязательно проверяет результаты работы алгоритма перед окончательным отказом. Соблюдаются жесткие императивные требования прозрачности и обязательного ручного человеческого контроля. Система развертывается в строго физически изолированном контуре корпоративного дата-центра.
Это архитектурное решение обеспечивает максимальный уровень информационной безопасности всего продукта. Доступ к вычислительной инфраструктуре ограничивается строго через защищенные соединения. Кроме того, применяются самые строгие корпоративные политики ролевого доступа к хранилищам. Следовательно, полностью минимизируется риск несанкционированного изменения внутренней логики работы алгоритма. Каждый запрос к API скоринга валидируется через систему проверки подлинности токенов. При малейшем подозрении на компрометацию ключей доступ системы мгновенно блокируется.
Инженерная адаптация Подготовка готового продукта к релизу
Вывод технологически сложного продукта на рынок требует крайне глубокой инфраструктурной подготовки. Стандартные устоявшиеся процессы доставки кода значительно и неизбежно усложняются новыми проверками. Команды внедряют автоматизированное модульное тестирование алгоритмической справедливости перед каждым новым релизом. Глубокая интеграция требований закона в процесс развертки является абсолютно строго обязательной. Классические гибкие пайплайны развертывания полностью модифицируются под новые суровые юридические стандарты.
Внедряются новые промежуточные этапы строгой автоматической валидации конфигураций серверной инфраструктуры. Развертывание Docker контейнеров требует обязательной предварительной сканирующей проверки образов на уязвимости. Управление корпоративными секретами, паролями и ключами шифрования непрерывно и жестко регламентируется. Доступ администраторов к серверам логируется на базовом защищенном уровне операционной системы. Разработчики регулярно используют подсистему WSL для удобного локального тестирования серверных компонентов.
Это техническое решение позволяет эмулировать боевую серверную среду с высочайшей точностью. Устраняются неприятные проблемы программной совместимости при физическом переносе кода на бой. Как следствие, полностью исключается случайная непреднамеренная утечка чувствительных персональных данных пользователей. Специалисты по информационной безопасности проводят регулярные тесты на проникновение во внутреннюю сеть. Обнаруженные критические уязвимости закрываются в течение нескольких часов после детального отчета.
Логирование MLOps и детальная техническая документация
Современный инженерный подход требует глубокой интеграции комплаенс-проверок прямо в пайплайны. Система обязана автоматически и предельно надежно фиксировать все значимые события инференса. Инструменты технического мониторинга отслеживают постепенную деградацию точности модели полностью непрерывно. Хранение гигантского массива логов требует использования крайне производительных аналитических колоночных баз. СУБД ClickHouse идеально и безальтернативно подходит для агрегации метрик работающих моделей.
Колоночная внутренняя архитектура позволяет моментально выполнять самые сложные аналитические запросы аудита. Инженеры активно создают специализированные материализованные представления для расчета статистических отклонений. Это изящно технически обеспечивает мониторинг деградации датасетов в строгом режиме реального времени. Настройка интеграции микросервисов выполняется с учетом самых актуальных отраслевых стандартов безопасности. Код математической валидации качества обучающего датасета обычно пишется на языке Python.
# протестировано для версии apache-airflow 2.9.0 и pandas 2.2.0
from airflow.decorators import task
import pandas as pd
import logging

logging.basicConfig(level=logging.INFO)

@task
def validate_dataset_bias(file_path: str, protected_col: str, threshold: float) -> bool:
    df = pd.read_csv(file_path)
    variance = df[protected_col].var()

    if variance < threshold:
        logging.error("Критическое смещение датасета. Остановка пайплайна.")
        raise ValueError("Смещение превышает допустимый порог AI Act.")

    logging.info("Распределение атрибута находится в пределах нормы.")
    return True
Ведение сложной технической документации становится полностью непрерывным и глубоко автоматизированным процессом. Документы генерируются специальными скриптами автоматически на основе метаданных обученных нейронных моделей. Инженеры используют современные программные библиотеки для удобного извлечения накопленных системных метрик. Ручной скучный труд при составлении сложных регуляторных отчетов сводится к абсолютному минимуму. Вся сгенерированная подробная техническая документация надежно хранится вместе с исходным кодом.
Изменения в сгенерированной документации легко отслеживаются через стандартные системы контроля версий Git. Следовательно, внешние аудиторы всегда имеют беспрепятственный доступ к актуальной информации о системе. Как прямое следствие, процесс прохождения сложной сертификации становится максимально прозрачным и предсказуемым. Команды разработки больше не тратят ценные недели на ручную подготовку толстых отчетов. Вся бюрократическая нагрузка элегантно перекладывается на плечи специализированных автоматизированных MLOps инструментов.
Заключение
Европейский регламент кардинально и абсолютно навсегда меняет ландшафт разработки сложных интеллектуальных систем. Новое суровое законодательство задает абсолютно беспрецедентный глобальный стандарт высокого технического качества. Основной инженерный фокус смещается с абстрактной метрической точности на полную прозрачность алгоритмических решений. Инженеры теперь обязаны глубоко и неразрывно интегрировать юридические требования в базовую архитектуру систем. Практики жесткого и непрерывного автоматизированного мониторинга становятся самым базовым обязательным стандартом индустрии.
Переход к новым невероятно строгим правилам неизбежно потребует весьма значительных инфраструктурных инвестиций. Компании первыми внедрившие высокоэффективные процессы технической оценки рисков получат огромное конкурентное преимущество. Строгий правовой системный комплаенс становится абсолютно неотъемлемой важной частью современной инженерной культуры. Квалифицированные архитекторы данных становятся самыми ключевыми фигурами в обеспечении доказательной законности программного продукта. Разработка алгоритмов окончательно превращается в высокодисциплинированный и жестко контролируемый предсказуемый инженерный процесс.
Референсы
- Текст регламента AI Act: https://artificialintelligenceact.eu/
- Спецификации MLOps: https://ml-ops.org/
- Документация Apache Airflow (Версия 2.9.0): https://airflow.apache.org/docs/apache-airflow/2.9.0/
- Документация ClickHouse: https://clickhouse.com/docs/ru/