 71
Содержание
- Что такое контекстное окно и почему модель ничего не помнит
- Из чего складывается бюджет окна
- Как работает механизм внимания
- Query, Key и Value
- Позиционное кодирование и RoPE
- KV-кэш и требования к памяти
- Заявленное окно против эффективного
- Как расширяют окно уже обученной модели
- Практика на локальной модели
- Когда увеличивать окно, а когда идти в RAG
- Заключение
- Референсные ссылки
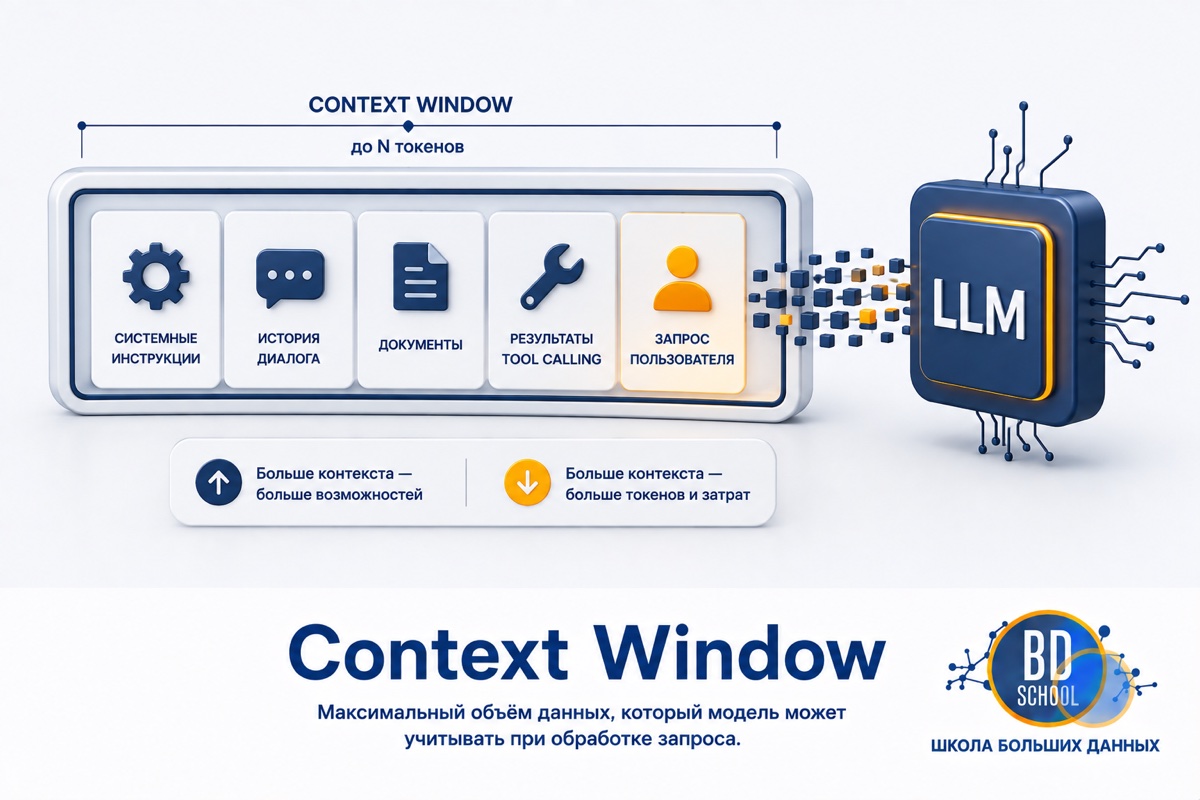
Context window (Контекстное окно) это максимальное число токенов, которое языковая модель обрабатывает за один вызов. В этот бюджет входит всё сразу, а именно системный промпт, история переписки, подложенные документы и сам ответ, который модель ещё только собирается написать. Отсюда два следствия, о которых чаще всего забывают. Заявленный размер окна это лимит на один ход, а не память модели. И держать качество на всей заявленной длине модель никому не обещала.
Что такое контекстное окно и почему модель ничего не помнит
Языковая модель не хранит состояние между вызовами, каждый запрос она получает как один цельный текст и обрабатывает с нуля. Ощущение памяти в чат-интерфейсе создаёт не модель, а обёртка вокруг неё, которая на каждом ходу склеивает переписку и отправляет заново. Контекстное окно ограничивает длину этой склейки.
Меряется окно в токенах, а не в символах и не в словах. Токен это кусок текста, который токенизатор выделил как единицу словаря, обычно от одного символа до целого короткого слова. Курс обмена символов на токены сильно зависит от языка, и для русского он заметно хуже, чем для английского. На нашем прогоне одна и та же по смыслу фраза дала 34 токена на русском против 17 на английском. По плотности это 2,68 символа на токен против 5,06, то есть коэффициент 0,53. Слово «Контекстное» токенизатор cl100k_base разобрал на пять кусков, а слово Context уложил в один.
Из чего складывается бюджет окна
Окно делят между собой четыре потребителя, и все они конкурируют за один и тот же лимит.
- Системный промпт. Инструкции, роль, формат ответа, описания доступных инструментов. В агентных сценариях описания инструментов легко занимают тысячи токенов ещё до первой реплики пользователя.
- История диалога. Все предыдущие реплики пользователя и модели. Растёт линейно с длиной разговора и первой упирается в потолок.
- Подложенные данные. Фрагменты документов из поиска, содержимое файлов, результаты вызова инструментов. Самая объёмная и самая непредсказуемая часть.
- Генерируемый ответ. Место под ответ резервируется внутри того же окна. Если вход занял всё, писать модели уже некуда.
Последний пункт регулярно становится сюрпризом. Параметр вроде num_predict или max_tokens не добавляет объём сверх окна, а отрезает кусок от него.
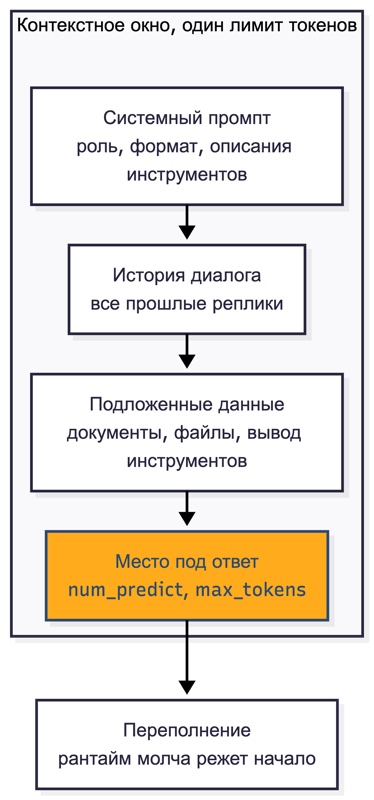
Когда сумма всех четырёх частей превышает лимит, поведение зависит от рантайма. API вендоров чаще отклоняют такой запрос ошибкой, а локальный рантайм вроде Ollama на нашем прогоне молча выбросил лишнее с начала и отдал модели остаток. Модель об усечении не знает и отвечает по тому, что до неё дошло, уверенно и неправильно.
Как работает механизм внимания
Из устройства внимания растут и возможности длинного контекста, и его цена.
Query, Key и Value
Self-attention это операция, в которой каждый токен последовательности сопоставляется с каждым другим токеном, включая самого себя. Для этого из вектора токена получают три проекции, а именно запрос (query), ключ (key) и значение (value). Запрос одного токена скалярно перемножается с ключами всех остальных, полученные оценки нормируются, и по ним взвешенно складываются значения. Разбор механизма с формулами есть в материале IBM про self-attention.
Отсюда сразу видно главную проблему масштаба. Каждый с каждым означает n в квадрате пар при длине последовательности n, поэтому вычисления и память под матрицу внимания растут квадратично. Поэтому окно в миллион токенов не сделать простой сменой константы в конфиге.
Позиционное кодирование и RoPE
Внимание само по себе не различает порядок, для него последовательность это мешок токенов. Порядок доносит отдельный механизм позиционного кодирования. В современных моделях это чаще всего RoPE (Rotary Position Embedding), который поворачивает векторы запроса и ключа на угол, зависящий от позиции токена. Приём удобен тем, что относительное расстояние между позициями получается прямо из скалярного произведения.
У RoPE есть неприятное свойство, и оно определяет всю тему расширения окна. Модель видела при обучении позиции только до определённой длины, а за её пределами углы поворота выходят в неизученный диапазон, и качество там разваливается довольно резко. Поэтому просто попросить модель принять вдвое более длинный вход нельзя, позиционное кодирование придётся чинить.
KV-кэш и требования к памяти
При генерации ответа модель выдаёт токены по одному, и пересчитывать ключи и значения для всего уже обработанного текста на каждом шаге было бы расточительно. Их складывают в KV-кэш, объём которого растёт линейно с длиной контекста и умножается на число слоёв, число голов внимания и размер батча. На длинном окне KV-кэш становится отдельной крупной статьёй расхода видеопамяти наряду с весами модели.
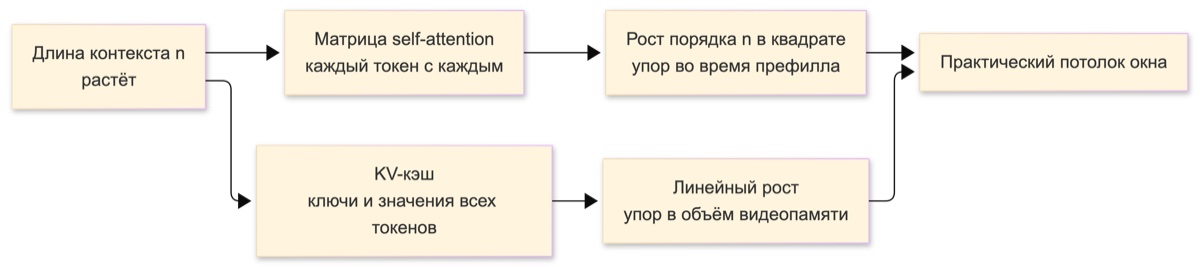
Две кривые роста упираются в разное. Квадратичный рост внимания бьёт по времени обработки промпта, линейный рост KV-кэша бьёт по памяти. Оптимизации вроде flash-attention и grouped-query attention сбивают константы и профиль обращения к памяти, но саму асимптотику не отменяют.
Нейронные сети на Python
Код курса
PYNN
Ближайшая дата курса
12 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Заявленное окно против эффективного
Число в спецификации модели говорит, сколько токенов рантайм согласится принять без усечения. Оно не говорит, на какой длине модель ещё пользуется всем, что ей дали, а расходятся эти свойства заметно.
Стандартный способ проверить второе свойство называется поиском иголки в стоге сена (needle in a haystack). В длинный неинформативный текст вставляют один конкретный факт, а потом спрашивают модель именно про него, меняя длину текста и позицию факта внутри. Замеры такого рода регулярно показывают, что деградация начинается сильно раньше формального потолка окна.
Заявленный размер окна годится для планирования лимитов и стоимости, а рабочая длина контекста подбирается замером на своей задаче.
Как расширяют окно уже обученной модели
Раз узкое место в позиционном кодировании, то и чинят его. Сложились три подхода, каждый следующий вырос из недостатков предыдущего.
- Position Interpolation. Позиционные индексы линейно сжимают, чтобы новый длинный диапазон уложился в тот, на котором модель обучалась. Приём работает, но равномерное сжатие портит различение соседних токенов.
- NTK-aware scaling. Частоты RoPE масштабируют неравномерно, высокие меньше, низкие больше. Высокочастотная информация о ближних соседях сохраняется лучше, чем при линейной интерполяции.
- YaRN. Развитие предыдущего подхода с разделением частот по диапазонам и поправкой на температуру внимания. Метод описан в статье YaRN про расширение контекстного окна.
Цифры из работы по YaRN хорошо показывают, зачем всё это затевалось. Авторы сообщают о дообучении менее чем на 0,1 процента объёма исходного предобучения, о десятикратной экономии токенов и о сокращении числа шагов обучения в 2,5 раза относительно прежних методов, при расширении окна до 128 тысяч токенов. Оговорка в том, что 128 тысяч это результат конкретного эксперимента, а не универсальная граница.
Практика на локальной модели
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Прогон сделан на macOS 26.5.2 с Apple Silicon, модель qwen2.5:7b поднята локально в Ollama 0.32.13, вызовы идут через python-клиент ollama 0.6.2. Размер окна задаётся параметром num_ctx прямо в вызове.
Первый скрипт считает курс обмена символов на токены токенизатором tiktoken, к модели он не обращается.
# tiktoken 0.13.0, кодировка cl100k_base, прогнано на стенде 2026-08-24
# Считаем, во сколько токенов обходится один и тот же текст на русском и на английском.
# Бюджет контекстного окна меряется в токенах, а не в символах, и курс обмена у языков разный.

import tiktoken

# cl100k_base это токенизатор семейства GPT-4/GPT-3.5, взят как общедоступный ориентир
enc = tiktoken.get_encoding("cl100k_base")

PAIRS = [
    ("русский", "Контекстное окно это максимальное число токенов, которое модель обрабатывает за один вызов."),
    ("english", "The context window is the maximum number of tokens a model processes in a single call."),
    ("код", "def count(text: str) -> int:\n    return len(enc.encode(text))"),
    ("числа", "2026-08-24 12:30:59 latency=4.31s tokens=1024"),
]

print("| текст | символов | токенов | символов на токен |")
print("|---|---|---|---|")
for label, text in PAIRS:
    chars = len(text)
    tokens = len(enc.encode(text))
    print(f"| {label} | {chars} | {tokens} | {chars / tokens:.2f} |")

# Разбор одного слова по токенам: видно, что редкое кириллическое слово рубится на куски
word = "Контекстное"
ids = enc.encode(word)
parts = [enc.decode([i]) for i in ids]
print(f"\nСлово '{word}' -> {len(ids)} токенов: {parts}")

word_en = "Context"
ids_en = enc.encode(word_en)
print(f"Слово '{word_en}' -> {len(ids_en)} токенов: {[enc.decode([i]) for i in ids_en]}")

# Практический вывод для планирования бюджета окна
ru = PAIRS[0][1]
en = PAIRS[1][1]
ratio = (len(ru) / len(enc.encode(ru))) / (len(en) / len(enc.encode(en)))
print(f"\nПлотность русского текста относительно английского: {ratio:.2f}")
print("Один и тот же смысл на русском съедает заметно больше бюджета окна.")
| текст | символов | токенов | символов на токен |
|---|---|---|---|
| русский | 91 | 34 | 2.68 |
| english | 86 | 17 | 5.06 |
| код | 61 | 16 | 3.81 |
| числа | 45 | 22 | 2.05 |
Худший курс у строки с числами, всего два символа на токен, поэтому логи и метрики съедают окно быстрее обычной прозы.
Второй скрипт показывает, что происходит с фактом, который в окно не поместился. Кодовое слово стоит первой строкой длинного промпта, вопрос про него задаётся в конце, а размер окна меняется от 1024 до 8192 токенов.
# ollama 0.32.13, python-клиент ollama 0.6.2, модель qwen2.5:7b, прогнано на стенде 2026-08-24
# Что происходит с фактом, который не поместился в контекстное окно.
# Кладём «иголку» в самое начало длинного промпта и гоняем один и тот же запрос
# при разных значениях num_ctx. Рантайм режет то, что не влезло, и модель отвечает
# уверенно и неправильно, а не сообщает об ошибке.

import time
import ollama

MODEL = "qwen2.5:7b"
NEEDLE = "Кодовое слово проекта: ГРАНАТ-77."
QUESTION = "Какое кодовое слово проекта названо в тексте выше? Ответь только словом и числом."

# Наполнитель: осмысленный, но бесполезный для ответа текст
FILLER_UNIT = (
    "Отдел эксплуатации ведёт журнал регламентных работ. "
    "Записи содержат дату, ответственного и краткое описание операции. "
    "Журнал хранится в общей папке и еженедельно выгружается в архив. "
)


def build_prompt(units: int) -> str:
    """Иголка в начале, за ней много наполнителя, в конце вопрос."""
    return NEEDLE + "\n\n" + FILLER_UNIT * units + "\n\n" + QUESTION


client = ollama.Client()
prompt = build_prompt(55)
print(f"Длина промпта: {len(prompt)} символов")

# Замер длины промпта в токенах: гоняем его с заведомо большим окном
probe = client.chat(model=MODEL, messages=[{"role": "user", "content": prompt}],
                    options={"num_ctx": 16384, "num_predict": 4, "temperature": 0})
full_tokens = probe.get("prompt_eval_count")
print(f"Промпт целиком: {full_tokens} токенов")

print("\n| num_ctx | токенов промпта учтено | время, с | ответ модели | иголка найдена |")
print("|---|---|---|---|---|")

for num_ctx in (1024, 2048, 4096, 8192):
    t = time.time()
    resp = client.chat(
        model=MODEL,
        messages=[{"role": "user", "content": prompt}],
        options={"num_ctx": num_ctx, "num_predict": 32, "temperature": 0},
    )
    elapsed = time.time() - t
    answer = resp["message"]["content"].strip().replace("\n", " ")[:60]
    # prompt_eval_count это то, сколько токенов промпта рантайм реально посчитал
    counted = resp.get("prompt_eval_count")
    found = "да" if "ГРАНАТ" in answer.upper() and "77" in answer else "нет"
    print(f"| {num_ctx} | {counted} | {elapsed:.1f} | {answer} | {found} |")

print("\nПояснение: при маленьком num_ctx рантайм отбрасывает начало промпта,")
print("вместе с ним пропадает иголка, и модель отвечает по остатку текста.")
print("Смотрите на колонку учтённых токенов: пока промпт влезает в окно, он идёт целиком.")
print("Как только не влезает, Ollama оставляет примерно половину окна, и обрезается начало.")
Промпт вышел на 10 183 символа, что дало 3758 токенов. Результат по четырём окнам собран в таблицу.
| num_ctx | токенов промпта учтено | время, с | ответ модели | иголка найдена |
|---|---|---|---|---|
| 1024 | 514 | 8.6 | Журнал регламентных работ | нет |
| 2048 | 1026 | 12.8 | Журнал регламентных работ | нет |
| 4096 | 3758 | 37.6 | ГРАНАТ-77 | да |
| 8192 | 3758 | 40.2 | ГРАНАТ-77 | да |
Смотреть здесь надо на вторую колонку. Пока промпт влезает в окно, рантайм считает все 3758 токенов и модель отвечает верно. Как только не влезает, учтённых токенов остаётся примерно половина окна, а отброшено при этом начало вместе с кодовым словом. Ни ошибки, ни предупреждения не появляется, модель просто отвечает про журнал регламентных работ. Отличить такой ответ от честного без отдельной проверки невозможно, и для приложения это худший сценарий.
Третий скрипт меряет цену длинного контекста. Окно зафиксировано на 8192, длина ответа тоже, растёт только вход, а замеряется префилл, то есть обработка промпта до первого токена ответа.
# ollama 0.32.13, python-клиент ollama 0.6.2, модель qwen2.5:7b, прогнано на стенде 2026-08-24
# Сколько стоит длинный контекст. Меряем префилл, то есть обработку промпта до первого
# токена ответа, на растущей длине входа. Длина ответа зафиксирована, меняется только вход.

import time
import ollama

MODEL = "qwen2.5:7b"
NUM_CTX = 8192  # окно фиксировано, чтобы рантайм не резал промпт по-разному

FILLER_UNIT = (
    "Регламент обслуживания предписывает проверять узел раз в квартал. "
    "Результат проверки заносится в журнал и подписывается ответственным. "
)
TASK = "\n\nОдним словом: о чём этот текст?"

client = ollama.Client()

# Прогрев: первый вызов после смены num_ctx перезагружает модель и меряет не то
client.chat(model=MODEL, messages=[{"role": "user", "content": "привет"}],
            options={"num_ctx": NUM_CTX, "num_predict": 4, "temperature": 0})

print("| единиц наполнителя | токенов промпта | префилл, с | токенов/с на префилле | полный ответ, с |")
print("|---|---|---|---|---|")

rows = []
for units in (10, 40, 80, 120):
    prompt = FILLER_UNIT * units + TASK
    t = time.time()
    resp = client.chat(
        model=MODEL,
        messages=[{"role": "user", "content": prompt}],
        options={"num_ctx": NUM_CTX, "num_predict": 8, "temperature": 0},
    )
    total = time.time() - t
    # ollama отдаёт длительности в наносекундах
    prefill_s = resp.get("prompt_eval_duration", 0) / 1e9
    tokens = resp.get("prompt_eval_count", 0)
    speed = tokens / prefill_s if prefill_s else 0
    rows.append((tokens, prefill_s))
    print(f"| {units} | {tokens} | {prefill_s:.2f} | {speed:.0f} | {total:.2f} |")

# Во сколько раз выросли вход и время его обработки
(t0, p0), (t1, p1) = rows[0], rows[-1]
print(f"\nВход вырос в {t1 / t0:.1f} раза, время префилла в {p1 / p0:.1f} раза.")
print("Префилл обрабатывает промпт целиком на каждый вызов: длинное окно платится на каждом ходу.")
| токенов промпта | префилл, с | токенов/с на префилле | полный ответ, с |
|---|---|---|---|
| 422 | 3.58 | 118 | 4.34 |
| 1562 | 10.91 | 143 | 11.69 |
| 3082 | 15.32 | 201 | 16.13 |
| 4602 | 16.39 | 281 | 17.26 |
Результат вышел неудобный, и он честнее красивого. Вход вырос в 10,9 раза, а время префилла всего в 4,6 раза. Квадратичного роста на этих длинах не видно вовсе, наоборот, пропускная способность префилла поднялась со 118 до 281 токена в секунду. Дело в масштабе. На нескольких тысячах токенов время съедают накладные расходы на вызов и загрузку, а не сама матрица внимания, и рост длины размазывает их по большему числу токенов. Квадратичность это свойство механизма, которое проявляется на длинах в десятки и сотни тысяч токенов, а не на пяти тысячах на ноутбуке.
Линейная часть счёта при этом видна отчётливо. Префилл обрабатывает промпт целиком при каждом вызове, поэтому лишние две тысячи токенов в системном промпте оплачиваются на каждом ходу, а не один раз.
Когда увеличивать окно, а когда идти в RAG
Большое окно и RAG (retrieval-augmented generation), то есть генерация с опорой на найденные в базе фрагменты, решают одну задачу по-разному. Выбор между ними сводится к нескольким понятным критериям.
| Критерий | Длинный контекст | RAG |
|---|---|---|
| Объём данных | десятки страниц | от тысяч документов и выше |
| Стоимость вызова | растёт с каждым токеном входа | почти постоянная, в окно идут только найденные фрагменты |
| Обновление данных | переклейка промпта целиком | переиндексация изменившихся документов |
| Связность материала | модель видит документ целиком | видны только извлечённые куски |
| Проверяемость ответа | источник неочевиден | найденные фрагменты можно показать |
| Риск потери факта | деградация в середине окна | промах поиска на этапе извлечения |
Рабочая практика обычно смешанная. Поиск отбирает десяток релевантных фрагментов, они кладутся в окно вместе с инструкцией, и длинный контекст нужен ровно настолько, чтобы эти фрагменты поместились без давки. Как такой конвейер собирается на векторном индексе поверх графовой базы, разбирали в статье про RAG для LLM с векторной индексацией в Neo4j.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Заключение
Контекстное окно это бюджет на один вызов модели, в котором системный промпт, история, документы и будущий ответ делят один лимит и вытесняют друг друга. Заявленный размер окна и длина, на которой модель ещё работает надёжно, различаются, поэтому рабочий предел определяется замером на своей задаче. Переполнение опасно своей бесшумностью, и наш прогон показал это буквально. На окне 1024 токена модель уверенно ответила не про то, что у неё спрашивали. Управление контекстом на практике, вместе с памятью агентов и подбором фрагментов под запрос, разбираем на курсе ИИ-агенты для оптимизации бизнес-процессов в нашем лицензированном учебном центре в Москве.
Референсные ссылки
- YaRN, Efficient Context Window Extension of Large Language Models, метод расширения окна через модификацию RoPE и цифры экономии при дообучении.
- Материал IBM про self-attention, механизм внимания и роль проекций Query, Key и Value.
- Документация Anthropic про контекстные окна, состав окна и поведение при работе с длинным контекстом.
- Документация Google про длинный контекст в Gemini API, подход вендора к работе с большими окнами.
- Описание API Ollama, параметр num_ctx и поля счётчиков токенов в ответе.