В рамках обучения аналитиков Big Data и разработчиков Apache Spark и Kafka, сегодня рассмотрим кейс ИТ-компании Southworks по онлайн-обработке потокового видео как наглядный пример эффективного сочетания этих потоковых фреймворков с пакетными задачами. Читайте далее, как реализовать лямбда-архитектуру масштабируемой Big Data системы на базе Apache Kafka, Spark Structured Streaming и NoSQL-СУБД...
Продолжая разговор про практическое обучение разработчиков Apache Spark, сегодня рассмотрим пример повышения скорости выполнения SQL-запросов к большому датафрейму. Читайте далее, как определить и исправить асимметрию распределения данных по разделам, зачем добавлять контрольные точки в длинные DAG и в чем здесь опасность, чем хороша широковещательная трансляция, для чего фильтровать данные перед...
Сегодня рассмотрим преимущества потоковой обработки данных с Apache Kafka и Flink над пакетными Big Data технологиями в виде Hadoop, Spark и Oozie. В качестве примера разберем реальный кейс аналитики больших данных по пользовательским сеансам в музыкальном онлайн-сервисе Spotify, а также возможность замены Apache Flink на Spark Structured Streaming. От рекламы...
Сегодня рассмотрим, что такое Data Build Tool, как этот ETL-инструмент связан с корпоративным хранилищем и озером данных, а также чем полезен дата-инженеру. В качестве практического примера разберем кейс подключения DBT к Apache Spark, чтобы преобразовать данные в таблице Spark SQL на Amazon Glue со схемой поверх набора файлов в AWS...
В этой статье разберем несколько популярных сценариев потоковой аналитики больших данных на Kafka, CDC-платформе Debezium и быстром OLAP-хранилище Apache Pinot. Читайте далее, почему все эти Big Data технологии отлично подходят для консолидации и интеграции данных из разных источников в реальном времени, включая аналитический аудит изменений, отслеживание событий в распределенном домене...
Чтобы сделать курсы Hadoop и Spark для инженеров данных еще более интересными, сегодня мы рассмотрим кейс фудтех-компании iFood - лидера рынка доставки еды в странах Латинской Америки. Читайте далее, в чем проблема быстрых операций со множеством файлов в облачном хранилище Amazon S3 и как ее решить с помощью префиксов корзины...
Продолжая разговор про оптимизацию приложений Apache Spark в Kubernetes, сегодня разберем, как сократить расходы на облачный кластер с помощью спотовых узлов. А в качестве практического примера рассмотрим кейс компании Weather2020, дата-инженеры которой смогли всего за 3 недели развернуть террабайтные ETL-конвейеры в AWS с AirFlow и Spark на Kubernetes без глубокой...
Сегодня рассмотрим особенности ухода с коммерческого дистрибутива Hadoop к версии сообщества на примере американской рекламной платформы Outbrain. Читайте далее, зачем дата-инженеры компании приняли такое решение, почему им не подошли альтернативы от MapR, Cloudera и Google Cloud Platform (DataProc), как проходила миграция на Apache Hadoop и что получилось в итоге. Предыстория:...
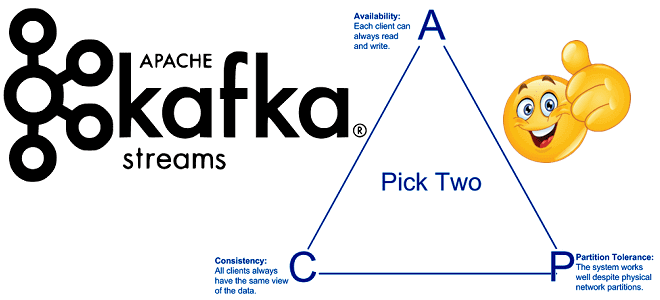
Продолжая включать интересные практические примеры в наши курсы Apache Kafka для разработчиков, сегодня поговорим о согласованности в распределенных системах с высокой доступностью. Читайте далее, что такое eventual consistency, почему это важно для микросервисной архитектуры, при чем здесь ограничения CAP-теоремы и как решить проблемы обеспечения конечной согласованности с Kafka Streams. ...
Чтобы сделать наши курсы по Apache Kafka еще более полезными, сегодня мы поговорим про базовые и расширенные возможности обеспечения информационной безопасности этой Big Data платформы. А в качестве практического примера разберем кейс международной финтех-компании BlackRock, которая разработала собственное security-решение для Kafka на базе протокола OAuth и серверов единого доступа KeyCloak....
В продолжение вчерашней статьи о победителях российского ИТ-конкурса «Проект Года» от профессионального сообщества GlobalCIO в номинации «Аналитика и Big Data», сегодня мы рассмотрим корпоративную платформу управления данными ПАО «Газпром нефть», реализованную на базе продуктов отечественного разработчика Big Data решений: Arenadata Hadoop и MPP-СУБД Arenadata DB (Greenplum). Зачем ПАО «Газпром нефть»...
Мы уже рассказывали о проектах-победителях российского ИТ-конкурса «Проект Года» профессионального сообщества GlobalCIO, представивших корпоративные решения на базе продуктов Arenadata. В 2020 году клиенты Arenadata также вошли в тройку лидеров. Читайте далее, как «Газпром нефть» и ВТБ улучшили свои процессы управления данными с помощью отечественных технологий хранения и аналитики Big Data....
Сегодня рассмотрим пример построения системы аналитики больших данных для мониторинга финансовых транзакций в реальном времени на базе облачного Delta Lake и конвейера распределенных приложений Apache Kafka, Spark Structured Streaming и других технологий Big Data. Читайте далее о преимуществах облачного Delta Lake от Databricks над традиционным Data Lake. Постановка задачи: финансовая...
Дополняя наши курсы дата-инженеров полезными примерами, сегодня рассмотрим, как упростить разработку и мониторинг ETL-конвейеров с помощью дополнительных технологий Big Data, совместимых с Apache Spark. Читайте далее, когда и зачем инженеру данных пригодятся SaaS-продукт Prophecy.io, движок StreamSets Transformer и REST-интерфейс Apache Livy, а также как все они связаны со Spark. 3...
В этой статье рассмотрим типичные проблемы топиков Apache Kafka, с которыми сталкивается каждый администратор Big Data кластера. Читайте далее, почему топики чрезмерно разрастаются, как работает очистка логов, когда старые сообщения могут остаться в почищенных сегментах и какие параметры конфигураций помогут справиться со всем этим. Брокеры и разделы: как устроены топики...
В рамках обучения администраторов Apache Hadoop и инженеров Big Data, сегодня поговорим про стоимость аналитики больших данных с помощью Spark-приложений в облачном кластере Amazon Web Services и способы снижения этих затрат за счет конфигурирования заданий и настройки узлов. Читайте в этой статье, как число процессорных ядер в исполнителях Spark-заданий формирует...
В этой статье поговорим про KSQL на примере кейса компании американской компании Pluralsight, которая предлагает различные обучающие видео-курсы для разработчиков ПО, ИТ-администраторов и творческих профессионалов. Читайте далее, как использовать Apache Kafka с Kubernetes для построения надежных систем потоковой аналитики больших данных, а также чем ksqlDB отличается от KSQL. Apache Kafka...
Хорошие курсы инженеров данных – это не просто обучение отдельной Big Data технологии, такой как Apache Hadoop, Spark или Kafka, а жизненные примеры их практического использования в реальном бизнесе. Поэтому сегодня мы приготовили для вас кейс оптимизации стоимости и скорости OLAP-аналитики больших данных в облачном Delta Lake на Amazon Web...
В этой статье рассмотрим, как сделать SQL-запросы к колоночному хранилищу больших данных с поддержкой ACID-транзакций Delta Lake еще быстрее с помощью Apache Presto. Читайте далее про синергию совместного использования Apache Spark и Presto в Delta Lake для ускорения OLAP-процессов при работе с Big Data. Еще раз об OLAP: схема звезды...
Продвигая наши курсы для разработчиков Spark с примерами реальных систем аналитики больших данных, сегодня рассмотрим библиотеку для чтения файлов формата DICOM от индийской компании Abzooba. Читайте далее, как автоматизировать поиск по миллиардам медицинских изображений с помощью машинного обучения и технологий Big Data: Apache Spark, Hadoop, Kafka, Elasticsearch и Kibana. Что...